

Hallo iedereen, mijn naam is Alexander en ik ben een Data Quality engineer die zich bezighoudt met het controleren van gegevens op kwaliteit. In dit artikel gaat het over hoe ik hierin ben terechtgekomen en waarom deze tak van testen in 2020 op de voorgrond kwam.
Wereldwijde trend
De wereld ondergaat vandaag de dag een nieuwe technologie revolutie, waarvan een aspect is dat verschillende bedrijven gebruikmaken van verzamelde gegevens om hun verkoop-, winst- en PR-cyclus aan te stuwen. Het lijkt erop dat de beschikbaarheid van goede (kwaliteits-)gegevens en bekwame mensen die deze kunnen omzetten in geld (juist verwerken, visualiseren, machine learning-modellen opbouwen, enzovoort) de sleutel tot succes zijn geworden voor velen. Waar 15-20 jaar geleden voornamelijk grote bedrijven zich bezighielden met het verzamelen van gegevens en het monetiseren ervan, is dit tegenwoordig de verantwoordelijkheid van bijna alle verstandige bedrijven.
Daarom zijn enkele jaren geleden alle portals die wereldwijd vacatures aanbieden overspoeld geraakt met vacatures voor Data Scientists, omdat iedereen ervan overtuigd was dat het aannemen van zo'n specialist ervoor zou zorgen dat ze een super machine learning-model konden bouwen, de toekomst konden voorspellen en een 'quantum leap' voor het bedrijf konden maken. Na verloop van tijd beseften mensen dat deze aanpak bijna nergens werkt, omdat lang niet alle gegevens die de handen van dergelijke specialisten bereiken, geschikt zijn voor het trainen van modellen.
En de verzoeken van Data Scientists begonnen: 'Laten we meer gegevens kopen van deze en gene...', 'We hebben niet genoeg gegevens...', 'We hebben nog wat gegevens nodig, bij voorkeur kwalitatief...'. Op basis van deze verzoeken ontstonden er talloze interacties tussen bedrijven die over verschillende datasets beschikten. Dit vereiste uiteraard een technische organisatie van dit proces — verbinding maken met de gegevensbron, ze downloaden, controleren of ze in volle omvang zijn geladen, enzovoort. Het aantal van dergelijke processen is toegenomen, en tot op heden hebben we een enorme vraag gekregen naar een ander soort specialisten — Data Quality engineers — degenen die toezicht hielden op de gegevensstromen in het systeem (data pipelines), op de kwaliteit van de gegevens aan de in- en uitgangen, en die conclusies trokken over hun voldoende hoeveelheid, integriteit en andere kenmerken.
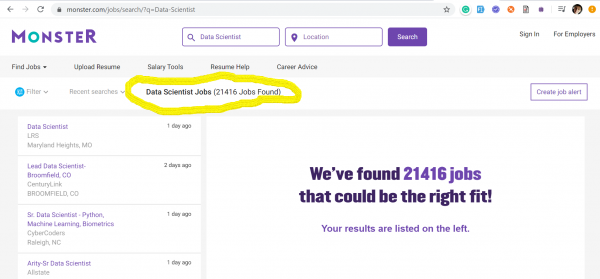
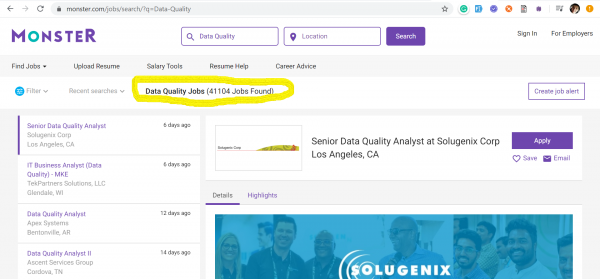
De trend van Data Quality-engineers is naar ons gekomen uit de VS, waar niemand bereid is de strijd om data te verliezen te midden van de bloeiende kapitalistische era. Hieronder heb ik screenshots gepresenteerd van twee van de populairste vacaturewebsites in de VS: en — waarop gegevens zijn weergegeven van 17 maart 2020 met betrekking tot het aantal geposte vacatures, gevonden op de sleutelwoorden: Data Quality en Data Scientist.
Data Scientists – 21416 vacatures
Data Quality – 41104 vacatures
Data Scientists – 404 vacatures
Data Quality – 2020 vacatures
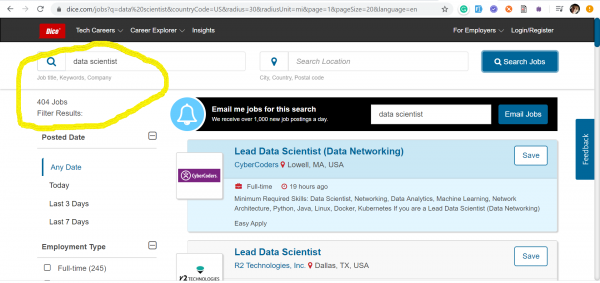
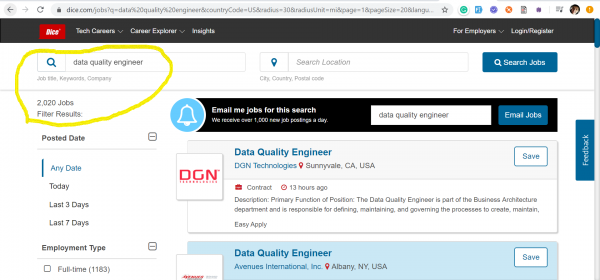
Het is duidelijk dat deze beroepen op geen enkele manier met elkaar concurreren. Met de screenshots wilde ik eenvoudig de huidige situatie op de arbeidsmarkt illustreren met betrekking tot de vraag naar Data Quality-engineers, van wie er nu veel meer nodig zijn dan Data Scientists.
In juni 2019 heeft EPAM, in reactie op de behoeften van de moderne IT-markt, de Data Quality richting als een aparte praktijk ingesteld. Data Quality-engineers beheren in hun dagelijkse werkzaamheden gegevens, controleren hun gedrag in nieuwe omstandigheden en systemen, en controleren de relevantie, voldoende hoeveelheid en actualiteit van gegevens. Dit gezegd hebbende, besteden Data Quality-engineers in praktische zin inderdaad iets van hun tijd aan klassiek functioneel testen, JA dit hangt sterk af van het project (deze voorbeeld zal ik later geven).
De verantwoordelijkheden van een Data Quality-engineer beperken zich niet tot routinematige handmatige/automatische controles op "nulls, count en sums" in databases, maar vereisen een diepgaand begrip van de zakelijke behoeften van de klant en dus de vaardigheden om bestaande gegevens om te zetten in bruikbare bedrijfsinformatie.
De theorie van Data Quality
Om de rol van zo'n engineer volledig te begrijpen, laten we bekijken wat Data Quality in theorie is.
Data Quality — is een van de fasen van Data Management (een hele wereld die we voor jezelf laten om zelfstandig te verkennen) en is verantwoordelijk voor de analyse van gegevens op basis van de volgende criteria:
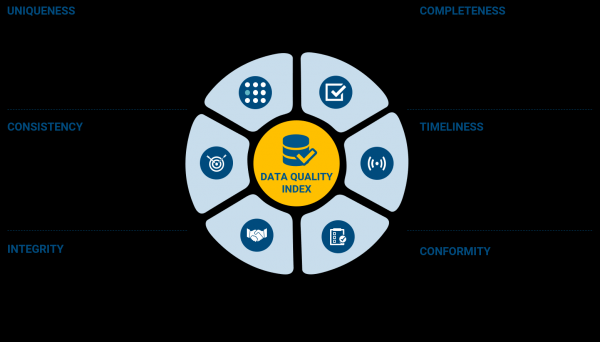
Ik denk niet dat het nodig is om elk van de punten (theoretisch aangeduid als 'data dimensions') te verklaren; ze zijn vrij goed beschreven in de afbeelding. Maar het testproces zelf vereist niet dat deze kenmerken strikt worden gekopieerd naar testcases en gecontroleerd. Bij Data Quality, zoals bij elke andere vorm van testen, moet je vooral uitgaan van de kwaliteitsvereisten die zijn afgestemd met de projectdeelnemers die zakelijke beslissingen nemen.
Afhankelijk van het project kan een Data Quality engineer verschillende functies vervullen: van een gewone geautomatiseerde tester met een oppervlakkige beoordeling van de datakwaliteit tot iemand die een diepgaande profilering uitvoert op de bovengenoemde kenmerken.
Een zeer gedetailleerde beschrijving van de processen Data Management, Data Quality en aanverwante onderwerpen is uitstekend beschreven in het boek met de titel ‘DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition’. Ik raad dit boek ten zeerste aan als inleiding tot dit onderwerp (de link naar het boek vind je aan het einde van het artikel).
Mijn verhaal
In de IT-industrie heb ik de weg afgelegd van Junior tester in productbedrijven tot Lead Data Quality Engineer bij EPAM. Al na ongeveer twee jaar werken als tester was ik er van overtuigd dat ik absoluut alle soorten testing had uitgevoerd: regressie-, functionele, stress-, stabiliteits-, beveiligings- en UI-testen, en ik had een groot aantal testtools uitgeprobeerd, waarbij ik op drie programmeertalen had gewerkt: Java, Scala, Python.
Terugkijkend begrijp ik waarom mijn professionele vaardighedenset zo divers is geworden – ik heb deelgenomen aan projecten die gericht waren op dataverwerking, groot en klein. Dit heeft me geleid naar een wereld vol tools en groeimogelijkheden.
Om de diversiteit van tools en mogelijkheden voor het verkrijgen van nieuwe kennis en vaardigheden te waarderen, is het genoeg om gewoon naar de afbeelding hieronder te kijken, waarop de meest populaire daarvan in de wereld van ‘Data & AI’ zijn afgebeeld.
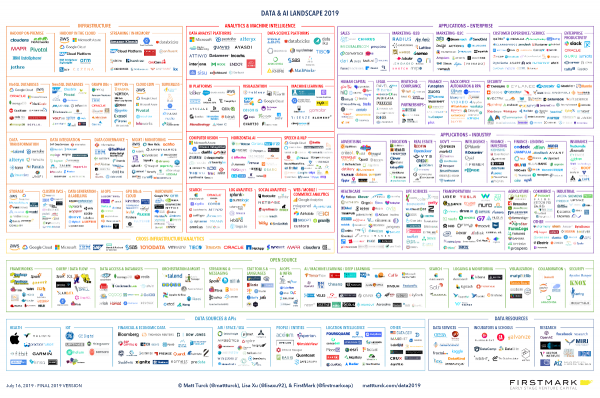
Dergelijke illustraties worden jaarlijks gemaakt door een bekende durfkapitalist Matt Turck, die afkomstig is uit softwareontwikkeling. Hier is zijn blog en , waar hij als partner werkt.
Ik ben vooral snel professioneel gegroeid toen ik de enige tester op het project was, of in ieder geval aan het begin van het project. Op dat moment ben je verantwoordelijk voor het gehele testproces, en heb je geen mogelijkheid om terug te deinsen, alleen vooruit. Aanvankelijk was dit beangstigend, maar inmiddels zie ik alle voordelen van deze uitdaging.
- Je begint met het volledige team te communiceren zoals nooit eerder, omdat er geen proxy is voor communicatie: geen testmanager, geen andere testers.
- De onderdompeling in het project wordt ongelooflijk diep, en je hebt informatie over alle componenten, zowel in het algemeen als in detail.
- Ontwikkelaars kijken niet naar je als 'de tester die niet duidelijk weet wat hij doet', maar eerder als een gelijkwaardige, die ongelooflijke waarde toevoegt aan het team met zijn geautomatiseerde tests en het vooruitzien van bugs in specifieke delen van het product.
- Het resultaat is dat je effectiever bent, beter gekwalificeerd en meer waard bent.
Naarmate het project uitgroeide, was ik in 100% van de gevallen mentor voor de nieuwkomers in het testteam, waarbij ik hen opleidde en de kennis overbracht die ik zelf had opgedaan. Afhankelijk van het project ontving ik van het management niet altijd hooggekwalificeerde specialisten in geautomatiseerd testen en was het nodig om hen te leren automatiseren (voor degenen die dat wilden), of om tools te creëren voor hun dagelijks gebruik (gegevensgeneratietools en het uploaden van die gegevens in het systeem, tools voor het uitvoeren van stress testing / stabiliteitstests 'snelle' en dergelijke).
Voorbeeld van een specifiek project
Helaas kan ik vanwege geheimhouding niet in detail vertellen over de projecten waaraan ik heb gewerkt, maar ik zal voorbeelden geven van typische taken van een Data Quality Engineer bij een van de projecten.
De essentie van het project was het realiseren van een platform voor gegevensvoorbereiding voor het trainen van machine learning modellen. De opdrachtgever was een groot farmaceutisch bedrijf uit de VS. Technisch gezien was het een cluster , opgetrokken op -instanties, met meerdere microservices en een Open Source project van het bedrijf EPAM erachter — , aangepast aan de specifieke behoeften van de opdrachtgever (het project is nu getransformeerd naar ). ETL-processen waren georganiseerd met behulp van en verplaatsten gegevens van het systeem van de klant naar Buckets. Vervolgens werd een Docker-image van een machine learning-model op het platform gedeployed, dat werd getraind op actuele gegevens en via de REST API-interface voorspellingen deed die relevant zijn voor het bedrijf en specifieke problemen oplosten.
Visueel zag het er ongeveer zo uit:
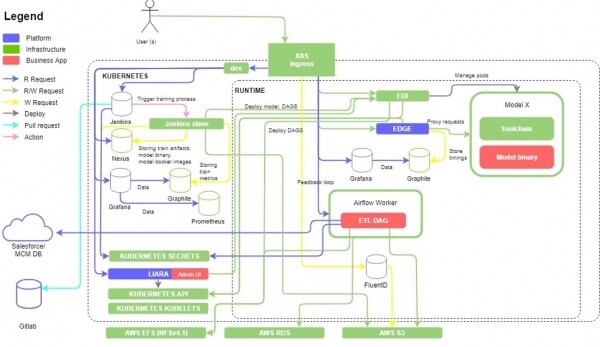
Functioneel testen was in dit project ruim voldoende, en gezien de snelheid van de ontwikkeling van functies en de noodzaak om het tempo van de releasecyclus (tweede wekelijkse sprints) te handhaven, moest er meteen nagedacht worden over de automatisering van de test van de meest kritieke knooppunten van het systeem. Een groot deel van het platform, gebaseerd op Kubernetes, werd gedekt door geautomatiseerde tests, uitgevoerd met behulp van + Python, maar het was ook noodzakelijk om deze te onderhouden en uit te breiden. Bovendien werd er voor het gemak van de klant een GUI gemaakt voor het beheren van machine learning-modellen die op het cluster waren gedeployed, en een mogelijkheid om aan te geven van waar en naar waar gegevens moesten worden verplaatst voor de training van de modellen. Deze uitgebreide aanvulling leidde tot een uitbreiding van de geautomatiseerde functionele controles, die grotendeels werden uitgevoerd via REST API-aanroepen en een klein aantal end-to-end UI-tests. Ongeveer halverwege deze beweging voegde een handmatige tester zich bij ons, die uitstekend omging met de acceptatietests van productversies en de communicatie met de klant over de acceptatie van de volgende release. Bovendien konden we dankzij de komst van deze nieuwe specialist onze werkzaamheden documenteren en verschillende zeer belangrijke handmatige controles toevoegen die moeilijk onmiddellijk te automatiseren waren.
En uiteindelijk, nadat we stabiliteit van het platform en de GUI-koppeling hadden bereikt, zijn we begonnen met het bouwen van ETL-pijplijnen met behulp van Apache Airflow DAGs. De geautomatiseerde kwaliteitscontrole van de gegevens werd uitgevoerd door speciale Airflow DAGs te schrijven die de gegevens controleerden op basis van de resultaten van het ETL-proces. In het kader van dit project hadden we geluk, en de opdrachtgever gaf ons toegang tot geanonimiseerde datasets waarop we testten. We controleerden de gegevens regel voor regel op typeconsistentie, aanwezigheid van fouten, het totale aantal records voor en na de bewerkingen, en vergeleken de door het ETL-proces uitgevoerde transformaties, zoals aggregatie, naamwijzigingen van kolommen en meer. Bovendien werden deze controles geschaald naar verschillende gegevensbronnen, bijvoorbeeld, naast SalesForce ook naar MySQL.
De eindkwaliteitscontroles van de gegevens werden al uitgevoerd op het S3-niveau, waar ze werden opgeslagen en klaar waren voor gebruik voor het trainen van machine learning-modellen. Voor het verkrijgen van gegevens uit het eindige CSV-bestand dat in de S3-bucket was opgeslagen en voor hun validatie, werd code geschreven met behulp van .
Er was ook een vereiste van de opdrachtgever om een deel van de gegevens in één S3-bucket op te slaan en een deel in een andere. Hiervoor waren ook aanvullende controles nodig om de juistheid van deze sortering te bewaken.
Algemene ervaring van andere projecten.
Voorbeeld van de meest algemene lijst van activiteiten van een Data Quality-engineer:
- Testgegevens voorbereiden (valide, ongeldige, grote, kleine) via een geautomatiseerd hulpmiddel.
- De voorbereide dataset in de oorspronkelijke bron uploaden en controleren of deze klaar is voor gebruik.
- ETL-processen starten om de dataset uit de oorspronkelijke opslag naar de definitieve of tussenoplossingen te verwerken met behulp van een specifieke set instellingen (indien mogelijk configurabele parameters voor de ETL-taak op te geven).
- Verifiëren of de door het ETL-proces verwerkte gegevens voldoen aan de kwaliteitsnormen en de zakelijke eisen.
De belangrijkste focus van controles moet niet alleen liggen op het feit dat de datastroom in het systeem in het algemeen correct is uitgevoerd en is voltooid (wat deel uitmaakt van functioneel testen), maar vooral op de controle en validatie van gegevens om te voldoen aan de verwachte vereisten, het identificeren van anomalieën en andere aspecten.
Hulpmiddelen
Een van de technieken voor deze gegevenscontrole kan het opzetten van ketencontroles zijn in elke fase van de gegevensverwerking, wat in de literatuur ook wel 'data chain' wordt genoemd — controle van gegevens van de bron tot het punt van eindgebruik. Dergelijke controles worden meestal gerealiseerd door het schrijven van controlerende SQL-query's. Het is duidelijk dat deze query's zo licht mogelijk moeten zijn en afzonderlijke stukken gegevenskwaliteit moeten controleren (metadata van tabellen, lege regels, NULL's, syntaxisfouten — andere vereiste controles van attributen).
In het geval van regressietesten, waarbij al bestaande (niet wijzigbare of nauwelijks wijzigbare) datasets worden gebruikt, kunnen in de code van de autotests al kant-en-klare sjablonen voor gegevenscontrole worden opgeslagen om aan kwaliteitsnormen te voldoen (beschrijvingen van verwachte metadata van tabellen; exemplaren van laagdrempelige objecten die willekeurig tijdens de test kunnen worden geselecteerd, en meer).
Tijdens het testen wordt het ook nodig gevonden om test-ETL-processen te schrijven, met behulp van frameworks zoals Apache Airflow, of volledig black-box cloudtools zoals , enzovoort. Deze omstandigheden dwingen de testingenieur om zich te verdiepen in de werkprincipes van de hierboven genoemde tools en om nog efficiënter zowel functioneel testen uit te voeren (bijvoorbeeld van bestaande ETL-processen in het project), als deze te gebruiken voor datavalidatie. Voor Apache Airflow zijn er al kant-en-klare operators beschikbaar voor populaire analytische databases, bijvoorbeeld . Het meest basale voorbeeld van het gebruik is reeds uiteengezet , daarom zal ik niet herhalen.
Naast kant-en-klare oplossingen staat het niemand verboden om zijn eigen technieken en tools te implementeren. Dit zal niet alleen nuttig zijn voor het project, maar ook voor de Data Quality Engineer zelf, die op deze manier zijn technische kennis en programmeervaardigheden zal uitbreiden.
Hoe dit werkt in een echt project
Een goed voorbeeld van de laatste paragrafen over "data chain", ETL en alomtegenwoordige controles is het volgende proces van een van de echte projecten:
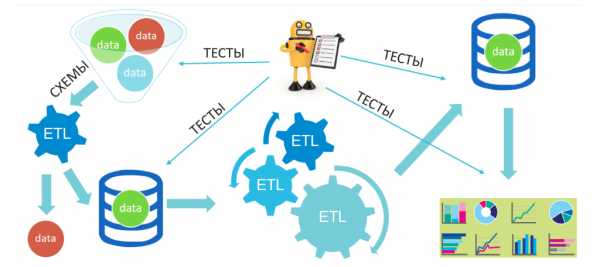
Hier komen verschillende gegevens (natuurlijk voorbereid door ons) binnen in de invoervunnel van ons systeem: geldige, ongeldige, gemengde, enzovoort, daarna worden ze gefilterd en gaan naar een tussenopslag, waarna ze weer een aantal transformaties ondergaan en in de eindopslag worden geplaatst, van waaruit de analyse, datavisualisatie en het zoeken naar zakelijke inzichten zal plaatsvinden. In een dergelijk systeem, zonder de functionele werking van de ETL-processen te controleren, concentreren we ons op de datakwaliteit vóór en na de transformaties, evenals op de output naar de analyse.
Samenvattend, ongeacht de plaatsen waar ik heb gewerkt, was ik overal betrokken bij Data-projecten die de volgende kenmerken deelden:
- Alleen door automatisering kunnen sommige cases worden gecontroleerd en kan een voor het bedrijf acceptabele releasecyclus worden bereikt.
- Een tester in een dergelijk project is een van de meest gerespecteerde leden van het team, omdat hij enorme voordelen biedt voor elk van de deelnemers (versnelling van tests, goede gegevens voor Data Scientists, opsporing van defecten in de vroege stadia).
- Het maakt niet uit of je op je eigen hardware werkt of in de cloud — alle middelen zijn geabstraheerd in een cluster zoals Hortonworks, Cloudera, Mesos, Kubernetes, enz.
- Projecten zijn opgebouwd op een microservices-aanpak, met een overheersing van gedistribueerde en parallelle berekeningen.
Ik wil opmerken dat, terwijl ik aan de Data Quality-testen werk, de testprofessional zijn professionele focus verschuift naar de code van het product en de gebruikte tools.
Kenmerken van Data Quality-testen
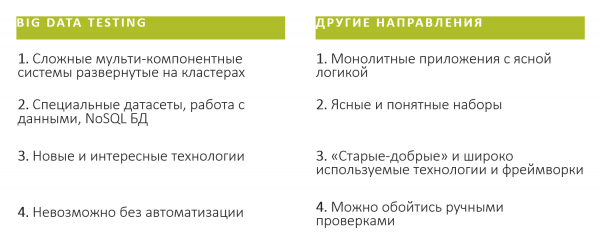
Bovendien heb ik de volgende (ik waarschuw direct, ZEER algemene en uitsluitend subjectieve) onderscheidende kenmerken van testen in Data (Big Data) projecten (systemen) en andere richtingen benadrukt:
Nuttige links
- Theorie: .
- EPAM
- Aanbevolen materialen voor beginnende Data Quality-engineers:
- Gratis cursus op Stepik: .
- Cursus op LinkedIn Learning: .
- Artikelen:
- ;
- ;
- ;
- Video:
- ;
- ;
Conclusie
Data Quality — dit is een zeer jong en veelbelovend vakgebied, deel uitmaken hiervan betekent deel uitmaken van een soort startup. Als je in Data Quality komt, zal je ondergedompeld worden in een grote verscheidenheid aan moderne engevraagde technologieën, maar het belangrijkste is dat er enorme mogelijkheden voor je open zullen gaan om je ideeën te genereren en uit te voeren. Je kunt het principe van voortdurende verbetering niet alleen op het project toepassen, maar ook voor jezelf, terwijl je jezelf continu ontwikkelt als specialist.
Bron: habr.com
