

De vertaling van het artikel is speciaal voorbereid voor studenten van de cursus .
— softwareontwikkelaar, Go-fan en liefhebber van het oplossen van complexe vraagstukken. Hij is ook de maintainer van Prometheus en medeoprichter van Kubernetes SIG instrumentation. Daarvoor was hij production engineer bij SoundCloud en leidde hij het monitoringteam bij CoreOS. Momenteel werkt hij bij Google.
— infrastructuuringenieur bij Improbable. Hij houdt zich bezig met nieuwe technologieën en uitdagingen in gedistribueerde systemen. Heeft ervaring met low-level programmeren bij Intel, is contributor bij Mesos en heeft wereldwijd production ervaring als SRE bij Improbable. Hij werkt aan het verbeteren van de wereld van microservices. Zijn drie passies: Golang, open source en volleybal.
Als je naar ons vlaggenschipproduct SpatialOS kijkt, kun je raden dat Improbable een zeer dynamische cloudinfrastructuur nodig heeft van wereldformaat met tientallen Kubernetes-clusters. Wij waren een van de eersten die het monitoring systeem gebruikten. Prometheus kan miljoenen metrics in real time volgen en wordt geleverd met een krachtige query-taal waarmee je de benodigde informatie kunt ophalen.
De eenvoud en betrouwbaarheid van Prometheus is een van zijn belangrijkste voordelen. Echter, na een bepaalde schaling stuiten we op verschillende nadelen. Om deze problemen aan te pakken, hebben we ontwikkeld — een open source-project, gemaakt door Improbable, om bestaande Prometheus-clusters naadloos te transformeren in één monitoring systeem met onbeperkte opslag van historische data. Thanos is beschikbaar op Github .
Onze doelen met Thanos
Bij een bepaalde schaling ontstaan er problemen die de capaciteiten van vanilla Prometheus overschrijden. Hoe sla je petabytes aan historische gegevens betrouwbaar en kosteneffectief op? Is het mogelijk om dit te doen zonder de responstijd van aanvragen te schaden? Kun je toegang krijgen tot alle metrics die zich op verschillende Prometheus-servers bevinden met één API-aanroep? Is het op de een of andere manier mogelijk om gereplicateerde gegevens, verzameld met Prometheus HA, samen te voegen?
Om deze vragen te beantwoorden, hebben we Thanos gecreëerd. In de volgende secties beschrijven we hoe we deze uitdagingen zijn aangegaan en de doelen die we voor ogen hadden.
Data aanvragen van meerdere Prometheus-instanties (global query)
Prometheus biedt een functionele benadering van sharding. Zelfs één Prometheus-server biedt voldoende schaalbaarheid om gebruikers te verlossen van de complexiteiten van horizontaal sharden in vrijwel alle gebruikstoepassingen.
Hoewel dit een uitstekende implementatiemodel is, is het vaak nodig om toegang te krijgen tot gegevens op verschillende Prometheus-servers via één API of UI — global view. Natuurlijk is er de mogelijkheid om meerdere verzoeken in één Grafana-panel weer te geven, maar elk verzoek kan alleen op één Prometheus-server worden uitgevoerd. Aan de andere kant kun je met Thanos gegevens opvragen en aggregeren van meerdere Prometheus-servers, omdat ze allemaal vanaf één eindpunt toegankelijk zijn.
Eerder, om een global view in Improbable te verkrijgen, hebben we onze Prometheus-instanties in een gelaagde . Dit betekende het creëren van één meta-server van Prometheus die een deel van de metrics verzamelt van elke "blad"-server.
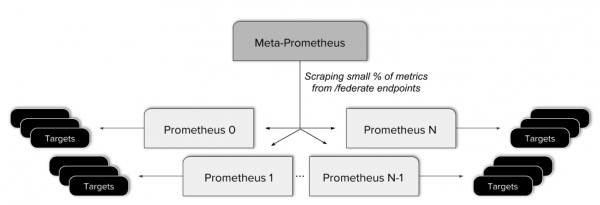
Deze aanpak bleek problematisch te zijn. Het leidde tot een gecompliceerdere configuratie, de toevoeging van een extra potentiële noodstop en het toepassen van complexe regels om de federated eindpunt alleen de benodigde gegevens te bieden. Bovendien maakt deze soort federatie het niet mogelijk om een echte global view te verkrijgen, aangezien niet alle gegevens beschikbaar zijn vanuit één API-aanroep.
Dit is nauw verbonden met een uniforme weergave van gegevens, verzameld op hoge beschikbaarheid (high-availability, HA) Prometheus-servers. Het HA-model van Prometheus verzamelt gegevens onafhankelijk twee keer, wat zo eenvoudig is dat het niet eenvoudiger kan. Het zou echter veel handiger zijn om een gecombineerde en gededupliceerde weergave van beide stroomgegevens te gebruiken.
Natuurlijk is er behoefte aan hoge beschikbaarheid in Prometheus-servers. Bij Improbable nemen we gegevensmonitoring per minuut zeer serieus, maar het hebben van één Prometheus-instantie per cluster is een enkelvoudig punt van falen. Elke configuratiefout of hardwarestoring kan potentieel leiden tot het verlies van belangrijke gegevens. Zelfs een eenvoudige implementatie kan leiden tot kleine onderbrekingen in het verzamelen van metrics, aangezien een herstart aanzienlijk langer kan duren dan de scrapesnelheid.
Betrouwbare opslag van historische gegevens
Goedkope, snelle en duurzame metricopslag is onze droom (die door de meeste gebruikers van Prometheus wordt gedeeld). Bij Improbable waren we gedwongen om de opslagduur van metrics in te stellen op negen dagen (voor Prometheus 1.8). Dit legt duidelijke beperkingen op hoe ver we terug kunnen kijken.
Prometheus 2.0 is hierin verbeterd, omdat het aantal time series niet langer invloed heeft op de algehele serverprestaties (zie ). Desondanks slaat Prometheus gegevens lokaal op. Hoewel hoogwaardige gegevenscompressie het gebruik van lokale SSD's aanzienlijk kan verminderen, blijft er uiteindelijk een limiet op de hoeveelheid opgeslagen historische data.
Bij Improbable geven we bovendien om betrouwbaarheid, eenvoud en kosten. Grote lokale schijven zijn moeilijker te beheren en te back-uppen. Ze zijn duurder en vereisen meer tools voor back-up, wat leidt tot overbodige complexiteit.
Downsampling
Zodra we begonnen te werken met historische gegevens, realiseerden we ons dat er fundamentele complicaties zijn met O-groot, die queries steeds trager maken als we werken met gegevens over weken, maanden en jaren.
De standaardoplossing voor dit probleem is — het verlagen van de samplingfrequentie van een signaal. Door de samplingfrequentie te verlagen kunnen we het 'schalen' naar een grotere tijdsperiode en het aantal monsters behouden, waardoor de responstijd van de queries behouden blijft.
Downsampling van oude gegevens is een onvermijdelijke vereiste voor elke oplossing voor langdurige opslag en gaat verder dan vanilla Prometheus.
Aanvullende doelen
Een van de oorspronkelijke doelen van het Thanos-project was een naadloze integratie met bestaande Prometheus-installaties. Het tweede doel was eenvoudige operationele mogelijkheden met een minimale instapdrempel. Alle afhankelijkheden moeten gemakkelijk voldoen aan zowel kleine als grote gebruikers, wat ook betekent dat de basis kosten laag moeten zijn.
Architectuur van Thanos
Nadat we in de vorige sectie onze doelen hebben opgesomd, laten we ze aanpakken en bekijken hoe Thanos deze problemen oplost.
Globaal overzicht
Om een global view te verkrijgen bovenop bestaande Prometheus-instanties, moeten we een enkele toegangspunt voor verzoeken verbinden aan alle servers. Dat is precies wat het Thanos-component doet. . Het wordt naast elke Prometheus-server uitgerold en fungeert als proxy die lokale Prometheus-gegevens levert via de gRPC-interface van de Store API, waarmee time series-gegevens op basis van labels en een tijdsbereik kunnen worden opgehaald.
Aan de andere kant is er een horizontaal schaalbaar, stateless component genaamd Querier, dat iets meer doet dan alleen reageren op PromQL-verzoeken via de standaard Prometheus HTTP API. De componenten Querier, Sidecar en andere Thanos-onderdelen communiceren via .
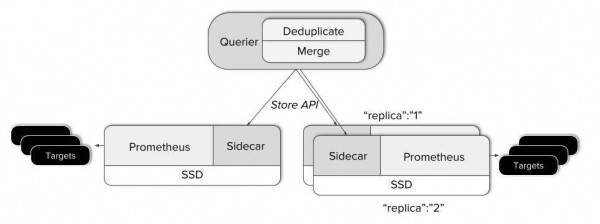
- Wanneer Querier een verzoek ontvangt, verbindt hij zich met de overeenkomstige Store API-server, dat wil zeggen met onze Sidecars, en ontvangt hij time series-gegevens van de bijbehorende Prometheus-servers.
- Daarna combineert hij de antwoorden en voert PromQL-verzoeken uit. Querier kan zowel niet-overlappende als duplicaatgegevens van HA-Prometheus-servers combineren.
Dit lost het grootste deel van onze puzzel op — het combineren van gegevens van geïsoleerde Prometheus-servers in een uniforme weergave. In feite kan Thanos alleen al voor deze functionaliteit worden gebruikt. Er zijn geen wijzigingen nodig aan bestaande Prometheus-servers!
Onbeperkte opslagduur!
Maar vroeg of laat willen we gegevens opslaan die de gebruikelijke opslagperiode van Prometheus overschrijden. Voor het opslaan van historische gegevens hebben we objectopslag gekozen. Deze is breed beschikbaar in elke cloud en ook in lokale datacentra, en is zeer kosteneffectief. Bovendien is vrijwel elke objectopslag toegankelijk via de goed bekende S3 API.
Prometheus schrijft gegevens ongeveer elke twee uur van het RAM naar de schijf. Een blok met opgeslagen gegevens bevat alle gegevens voor een vaste tijdsperiode en is onveranderlijk. Dit is erg handig, omdat Thanos Sidecar simpelweg de gegevenscatalogus van Prometheus kan bekijken en, naarmate er nieuwe blokken verschijnen, deze in de buckets van de objectopslag kan laden.
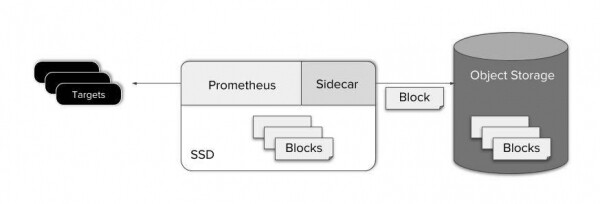
Het laden in objectopslag direct na het schrijven naar de schijf maakt ook de eenvoud van de 'scraper' (Prometheus en Thanos Sidecar) mogelijk. Dit vereenvoudigt onderhoud, kosten en het ontwerp van het systeem.
Zoals u kunt zien, wordt het maken van een back-up van gegevens heel eenvoudig gerealiseerd. Maar hoe zit het met het opvragen van gegevens in de objectopslag?
De Thanos Store-component fungeert als een proxy voor het ophalen van gegevens uit de objectopslag. Net als de Thanos Sidecar maakt hij deel uit van een gossip-cluster en implementeert hij de Store API. Hierdoor kunnen bestaande Querier deze beschouwen als Sidecar, als een extra bron van time series-gegevens—er is geen speciale configuratie nodig.
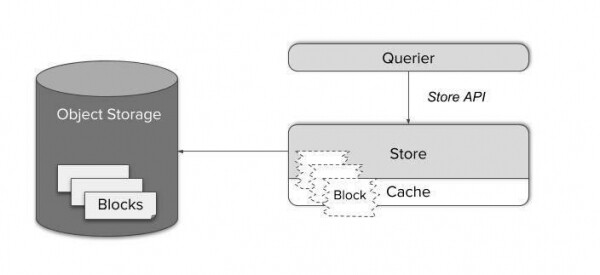
Blocks van time series-gegevens bestaan uit enkele grote bestanden. Het on-demand laden ervan zou behoorlijk inefficiënt zijn, en lokaal cachen zou enorme hoeveelheden geheugen en schijfruimte vereisen.
In plaats daarvan weet de Store Gateway hoe om te gaan met het opslagformaat van Prometheus. Dankzij een slimme query-planner en het cachen van alleen de benodigde indexdelen van de blocks, is het nu mogelijk om complexe queries te verkorten tot een minimaal aantal HTTP-verzoeken naar bestanden in de objectopslag. Op deze manier kan het aantal verzoeken met vier tot zes ordes worden verminderd en kan een responstijd worden bereikt die in wezen moeilijk te onderscheiden is van verzoeken naar gegevens op lokale SSD's.
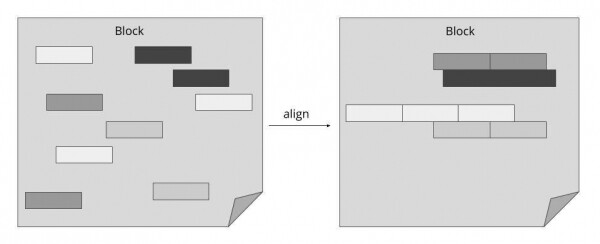
Zoals weergegeven in de bovenstaande diagram, vermindert de Thanos Querier aanzienlijk de kosten van één verzoek om gegevens in de objectopslag, door het opslagformaat van Prometheus te gebruiken en gerelateerde gegevens dicht bij elkaar te plaatsen. Met deze aanpak kunnen we talrijke enkele verzoeken combineren in een minimaal aantal bulk-operaties.
Compacteren en downsampling
Nadat een nieuw block van time series-gegevens succesvol in de objectopslag is geladen, beschouwen we het als 'historische' gegevens die direct beschikbaar zijn via de Store Gateway.
Echter, na verloop van tijd stapelen blocks van dezelfde bron (Prometheus met Sidecar) zich op en benutten ze al niet meer het volledige potentieel van de indexering. Om dit probleem op te lossen, hebben we een andere component geïntroduceerd genaamd Compactor. Deze past simpelweg het lokale compaction-mechanisme van Prometheus toe op historische gegevens in de objectopslag en kan worden uitgevoerd als een eenvoudige periodieke batchtaak.
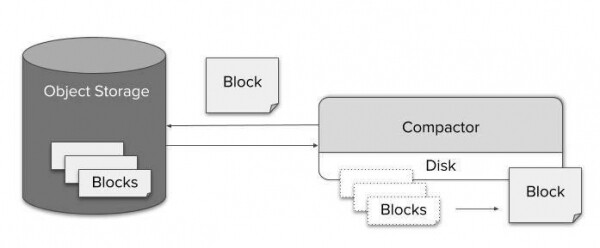
Dankzij efficiënte compressie vormt een verzoek aan de opslag gedurende langere tijd geen probleem qua datagrootte. Echter, de potentiële kosten van het decomprimeren van een miljard waarden en het doorvoeren van deze door de queryverwerker zullen onvermijdelijk leiden tot een aanzienlijke toename van de query-uitvoeringstijd. Aan de andere kant, aangezien er honderden datapunten per pixel op het scherm zijn, wordt het zelfs onmogelijk om de gegevens in volledige resolutie te visualiseren. Daarom is downsampling niet alleen mogelijk, maar zal het ook niet leiden tot merkbare verlies van nauwkeurigheid.
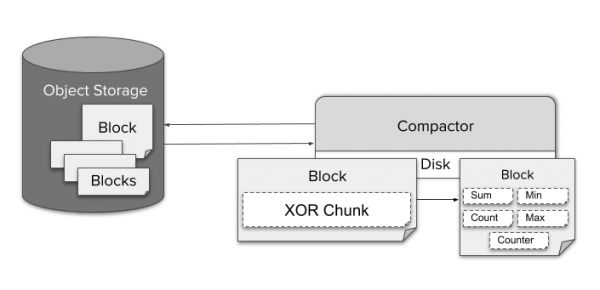
Voor het downsampled gegevens verzamelt Compactor continu gegevens met een resolutie van vijf minuten en één uur. Voor elk onbewerkte fragment, gecodeerd met behulp van TSDB XOR-compressie, worden verschillende soorten geaggregeerde gegevens opgeslagen, zoals min, max of sum voor één blok. Dit stelt de Querier in staat om automatisch de aggregaat te kiezen die geschikt is voor de gegeven PromQL-query.
Voor het gebruik van gegevens met verminderde nauwkeurigheid hoeft de gebruiker geen speciale configuratie uit te voeren. De Querier schakelt automatisch tussen verschillende resoluties en onbewerkte gegevens naarmate de gebruiker in- en uitzoomt. Indien gewenst kan de gebruiker dit direct beheren via de parameter “step” in de query.
Aangezien de kosten voor het opslaan van één GB laag zijn, slaat Thanos standaard de oorspronkelijke gegevens en gegevens met een resolutie van vijf minuten en één uur op. Er is geen noodzaak om de oorspronkelijke gegevens te verwijderen.
Recording rules
Zelfs met Thanos zijn recording rules een essentieel onderdeel van de monitoringstack. Ze verminderen de complexiteit, vertraging en kosten van queries. Ze zijn ook handig voor gebruikers om geaggregeerde gegevens op metrics te ontvangen. Thanos is gebaseerd op de vanilla instapversies van Prometheus, dus het is volkomen legitiem om recording rules en alerting rules op de bestaande Prometheus-server op te slaan. In sommige gevallen kan dit echter onvoldoende zijn:
- Global alert en rule (bijvoorbeeld een waarschuwing wanneer de service niet draait op meer dan twee van de drie clusters).
- Rule voor gegevens buiten de lokale opslag.
- De ambitie om alle rules en alerts op één plek te bewaren.
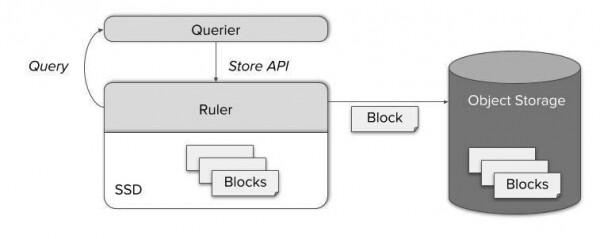
Voor al deze situaties bevat Thanos een aparte component, genaamd Ruler, die regels en waarschuwingen berekent via Thanos Queries. Door gebruik te maken van de goed bekende StoreAPI kan de Query-knoop toegang krijgen tot vers berekende metrics. Later worden deze ook opgeslagen in objectopslag en worden ze toegankelijk via de Store Gateway.
De kracht van Thanos
Thanos is flexibel genoeg om aan uw eisen te voldoen. Dit is vooral handig bij de migratie van een eenvoudige Prometheus. Laten we snel door een klein voorbeeld herinneren wat we hebben geleerd over de componenten van Thanos. Zo kunt u uw vanilla Prometheus naar de wereld van 'onbeperkte opslag van metrics' brengen:
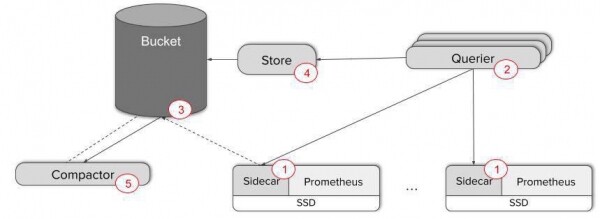
- Voeg Thanos Sidecar toe aan uw Prometheus-servers - bijvoorbeeld als een naastgelegen container in een Kubernetes-pod.
- Déployeer meerdere replica's van Thanos Querier voor dataweergave. Op dit punt is het eenvoudig om gossip tussen Scraper en Querier in te stellen. Gebruik de metric ‘thanos_cluster_members’ om de interactie van de component te controleren.
Slechts deze twee stappen zijn voldoende om een global view en naadloze deduplicatie van gegevens van potentiële HA-replica's van Prometheus te waarborgen! Verbind eenvoudig uw dashboards met het HTTP-eindpunt van Querier of gebruik de Thanos UI direct.
Als u echter een back-up van metrics en langdurige opslag nodig heeft, moet u nog drie stappen uitvoeren:
- Maak een AWS S3- of GCS-bucket aan. Configureer de Sidecar om gegevens naar deze buckets te kopiëren. Nu kunt u de lokale opslag van gegevens minimaliseren.
- Déployeer de Store Gateway en koppel deze aan de bestaande gossip-cluster. Nu kunt u verzoeken indienen voor gegevens in de back-ups!
- Déployeer de Compactor om de efficiëntie van verzoeken voor lange tijdsintervallen te verbeteren, door te compacteren en te downsample.
Als u meer wilt leren, neem gerust een kijkje op onze en !
In slechts vijf stappen hebben we Prometheus omgevormd tot een betrouwbare monitoringssysteem met een global view, onbeperkte opslagduur en potentiële hoge beschikbaarheid van metrics.
Pull request: we hebben u nodig!
vanaf het begin was een open-sourceproject. Naadloze integratie met Prometheus en de mogelijkheid om slechts een deel van Thanos te gebruiken, maakt het een uitstekende keuze voor het schalen van uw monitoringsysteem zonder al te veel moeite.
We zijn altijd blij met GitHub Pull Requests en Issues. Aarzel ook niet om contact met ons op te nemen via GitHub Issues of Slack., als je vragen of feedback hebt, of je wilt je ervaringen met ons delen! Als je vindt dat we goed werk leveren bij Improbable, aarzel dan niet om contact met ons op te nemen — !
Bron: habr.com
