

Mijn naam is Yuri, ik ben de leider van het systeembeheerteam bij Citymobil. Vandaag deel ik mijn ervaringen met de technologie van thin provisioning in Linux-bestandssystemen en hoe deze kan worden toegepast in de CI/CD-processen van ons bedrijf. We zullen de situatie bespreken waarbij we voor het automatisch testen van code bij de levering naar productie zo snel mogelijk kopieën van MySQL-databases nodig hebben, die zo dicht mogelijk bij de ‘live’ versie liggen, beschikbaar voor lezen en schrijven.
Inleiding: Waarom schadelijke adviezen geven?
Een logische vraag, want er zijn gevestigde mechanismen voor het migreren van databaseschema's naar testomgevingen. Waarom zouden we de primaire, niet-ge shardde database tot zulke volumes opdrijven? En niet alle gegevens zijn nodig voor testen. Ik zal proberen het uit te leggen.
Ongeveer een jaar geleden, te midden van de actieve groei van onze tax aggregatie (in 2018 stegen we met ongeveer 15 keer in voltooide ritten), stegen de gegevensvolumes, de belasting op de servers en de frequentie van uitrol. We bevonden ons in de volgende situatie:
- De primaire MySQL-database was gegroeid tot ongeveer 1000 tabellen met een totaalvolume van 2,5 TB en bleef groeien.
- Er was geen mogelijkheid om snel te sharden en de database te verspreiden. De oude benadering van ‘ik schrijf in de database wat ik wil en zoals ik wil’, met veel JOIN's en interne afhankelijkheden tussen tabellen, stond dit niet toe.
- Er was geen mechanisme voor schema-migraties van de database naar testomgevingen.
- Er was geen automatische code-testen bij uitrol naar productie.
Deze laatste problemen wilde ik zo snel mogelijk oplossen. Er waren al Postman-tests geschreven om de belangrijkste PHP-monolith te controleren, maar we hadden geen actuele database. Tegelijkertijd konden we 's nachts geen replica maken, deze tot master maken en overdag ter beschikking stellen: het enorme aantal uitrols en wijzigingen, zowel in de gegevens als in het databaseschema, zou de omgeving al halverwege de dag onbruikbaar maken. Bovendien zou het inefficiënt zijn om uitrols alleen tijdens kantooruren te beperken.
Desondanks was de taak volbracht: we kregen de eerste werkende omgeving al binnen twee weken. De afgelopen jaar heeft deze veel veranderingen ondergaan en wordt deze nog steeds gebruikt.
Hierna zal ik alle stappen en fasen van de ontwikkeling van onze oplossing in detail beschrijven. Je zult zien dat deze methode recht op bestaan verdient.
Wat is ‘thin provisioning’?
Dit is een hardware- of softwaretechnologie (ook wel sparse volumes genoemd) die het mogelijk maakt om meer van de vereiste bronnen toe te wijzen dan beschikbaar zijn. De toegewezen capaciteit moet voldoen aan de criteria van just-enough (exact wat nodig is) en just-in-time (binnen de vereiste tijd). Over het algemeen wordt thin provisioning gebruikt in verschillende opslagsystemen om schijfruimte in benodigde hoeveelheden te bieden die de feitelijk beschikbare ruimten overschrijden. De technologie wordt ondersteund door verschillende bestandssystemen, zoals LVM2, ZFS, BTRFS. Het wordt veel gebruikt in virtualisatie-hypervisors. Met thin provisioning konden we snel vanuit snapshots van de primaire gegevenspartitie zoveel kopieën van die partitie maken als we nodig hadden (data-directory van de MySQL-database).
De eerste omgeving, technologie Thin LVM
Dit hoofdstuk kan ook worden getiteld "Hoe je snel grote datavolumes kunt snapshotten met behulp van , waarbij de stabiliteit van het bestandssysteem en de MySQL-database tot onacceptabele niveaus wordt verlaagd."
Aangezien we al LVM gebruikten voor het opzetten van de primaire besturingssysteempartities, besloten we hiermee te beginnen. We hadden in eerste instantie een aparte fysieke machine nodig - een replica van onze primaire MySQL-database, waarop we op aanvraag een snapshot van de replica konden maken en deze naast een aparte MySQL-instantie konden oprichten. Tijdens de testfase stond ik toe dat op deze instantie wijzigingsoperaties werden uitgevoerd, en na afloop van de testen werd deze zonder problemen verwijderd. De serverconfiguratie was als volgt:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD in RAID-controller Adaptec in RAID-10
Over de keuze tussen een RAID-controller en software-RAID MD kan een apart artikel worden geschreven. Ik zal alleen zeggen dat twee factoren onze keuze beïnvloedden:
- Ten tijde van het stellen van de taak installeerden we alle databases op RAID-controllers, dus het kan worden gezegd dat dit historisch zo is ontstaan.
- Het verschil in prestaties bij synthetische tests van het bestandssysteem en tests met verschillende bewerkingen in MySQL was minimaal.
We hebben de resulterende RAID-10 verdeeld: een enkele Volume Group (VG) gemaakt voor het totale volume (met overhead van ongeveer 6,7 GB) en een logische partitie (Logical Volume, LV) voor het systeem van 50 GB gemaakt. In normale situaties gebruiken we de rest van de ruimte voor de partitie met MySQL. Maar we hadden een dunne back-up nodig, dus hebben we eerst een zogenaamde pool gecreëerd, waarin we een partitie voor /var/lib/mysql van 3,5 TB hebben gemaakt (uitgaande van de verwachte databasegroottes):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
We hebben de partitie geformatteerd in ext4, deze aangekoppeld, een replicaat geschreven en de oorspronkelijke setup verkregen. Vervolgens hebben we een API-wrapper gemaakt die snapshots moet creëren, een MySQL-database-exemplaar op een opgegeven poort moet opstarten en het gemaakte exemplaar moet verwijderen. Omdat hiervoor uitsluitend systeemaanroepen worden gebruikt, hebben we voor het schrijven van scripts gewone bash gekozen, en voor de API-koppeling HTTP → bash hebben we een open source-oplossing uitgerold. , geschreven in Go.
Ooit zullen we onze bash-scripts open source delen, maar voor nu beschrijf ik gewoon het basale algoritme:
Creëren van de hoofd-snapshot snapmain:
- We stoppen de hoofd-replicaat.
- We plaatsen een blokkade op de operaties met de snapshot snapmain.
- We creëren een nieuwe snapshot snapmain.
- We starten MySQL en verwijderen de blokkade.
Creëren van een database op een willekeurige poort vanuit snapmain:
- We plaatsen een blokkade op het specifieke database-exemplaar (poort).
- We controleren of er een blokkade is op het creëren van de hoofd-snapshot. Als deze er is, wachten we en controleren we elke 5 seconden opnieuw.
- We controleren of er een oude LV-partitie van het exemplaar is.
3.1 Als deze er is, stoppen we het MySQL-exemplaar met kill -9 en verwijderen we de LV-partitie. - We creëren uit snapmain een nieuw exemplaar.
- We bereiden de directories voor dit exemplaar voor en monteren ze.
- We verwijderen de aanwijzingen van een slave (bestanden) en starten het MySQL-exemplaar.
- We maken er een master van.
- We verwijderen de blokkade.
Verwijderen van een database op een willekeurige poort:
- We plaatsen een blokkade op het specifieke database-exemplaar (poort).
- We doden het MySQL-exemplaar met kill -9.
- We unmounten de directories.
- We verwijderen de LV-partitie en verwijderen de blokkade.
Voorbeeldcommando's voor het klonen van de partities van het nieuwe database-exemplaar:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Ik zal nu de belangrijkste probleem beschrijven waarmee we werden geconfronteerd bij het gebruik van thin provisioning. We stuitten op de SSD-prestaties. Dit kwam door de eigenschappen van Thin LVM: het werkt op basisniveau met low-level chunks van standaard 4 MB. Zo zag het eruit:
- We maken een snapshot van de hoofdpartitie /var/lib/mysql.
- We starten de replicatie om de master in te halen.
- Elke wijziging in de tabellen van de replica dwingt om oude, onveranderde data chunks in het snapshotdeel op te slaan.
- Elke wijziging in de opgeheven testinstantie dwingt om oude, onveranderde data chunks in het gedeelte van de gekloonde snapshot voor deze instantie op te slaan.
- We krijgen een I/O-operatiebelasting van 100% op het apparaat, wat alle operaties vertraagt en leidt tot een geleidelijke achterstand van de replica.
- Aan het einde van de werkdag hebben we een stand die enkele uren achterloopt.
Hoe we dit hebben aangepakt om een meer acceptabel resultaat te krijgen (belangrijke punten):
RAID-controller:
- We hebben alle vormen van caching standaard uitgeschakeld.
- We hebben writeback ingesteld (wanneer gegevens in de buffer komen, wordt de schrijfopdracht voltooid voordat de werkelijke opslag op schijf wordt uitgevoerd).
Bestandssysteem:
- Op het mountpunt /var/lib/mysql hebben we ingesteld noatime,nodiratime,data=writeback
- We hebben journaling voor ext4 uitgeschakeld met tune2fs.
MySQL:
- We hebben ingesteld innodb_flush_method = O_DSYNC (wat de schrijfsnelheid verhoogt en dus de betrouwbaarheid verlaagt).
- We hebben journaling uitgeschakeld, we hebben geen logs nodig.
- We hebben ingesteld innodb_buffer_pool_size = 4G (hoe kleiner de InnoDB-pool, hoe sneller MySQL zal uitvallen bij stoppingen, en hoe sneller we een snapshot kunnen maken).
Dit is lang niet een volledige lijst, vooral wat betreft MySQL. De overige wijzigingen zijn echter secundair en vaak niet altijd of precies toepasbaar. Bijvoorbeeld, in een poging om de schijven te ontlasten, hebben we zelfs innodb_parallel_doublewrite_path verplaatst naar /dev/shm, wat in sommige gevallen tot 5 seconden tijd kan besparen bij de opstart van een incorrect afgesloten instantie.
Waarom stoppen we MySQL voordat we een snapshot maken? We zouden het toch van een actieve replica kunnen nemen. Klopt, maar een nieuwe DB-instantie op deze snapshot wordt standaard als beschadigd beschouwd en vereist een volledige scanning bij opstarten. Het stoppen van de replica is zeker sneller, hoewel dit uiteindelijk de langste operatie in het hele proces is.
Uiteindelijk kregen we meer acceptabele timings en een werkende setup. Toch, zoals te zien is aan de meest sprekende grafiek van de replicatievertraging van de primaire replica, is de situatie nog ver van ideaal:
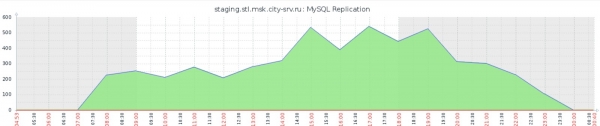
Vanuit andere tekortkomingen moet de praktische onmogelijkheid om de Thin LVM-pool te monitoren worden opgemerkt: naast de standaard systeemfuncties zoals iostat, is het onmogelijk om te begrijpen welk onderdeel van de pool momenteel de meeste belasting op het bestandssysteem veroorzaakt.
Een groot nadeel van de eerder beschreven optimalisatie moet afzonderlijk worden vermeld: we hebben een YOLO-stand gekregen. Ongeveer eens in de één à twee maanden hield ext4 het niet meer vol onder dergelijke misbruik en crashte het onherroepelijk, wat een herformattering en opnieuw uploaden van de replica vereiste. Door snelheid te winnen, hebben we hopeloos de stabiliteit verspeeld.
Welke metrics moeten worden gevolgd tijdens het gebruik van Thin LVM:
- Percentage data van de Thin pool
- Percentage metadata van de Thin pool
Als onze setup het gebrek aan data-opslag overleeft (het is voldoende om de schijven op te schonen), dan zal een gebrek aan opslag voor metadata leiden tot een volledige crash van de pool en de noodzaak om deze opnieuw vanaf nul op te bouwen.
Het bestandssysteem binnen de pool raakt in de loop der tijd sterk gefragmenteerd. Ik raad aan om elke dag via cron het commando uit te voeren: fstrim -v /var/lib/mysql.
Tussenresultaten:
- De technologie is gemakkelijk toepasbaar, net als LVM zelf, en vereist geen bijzondere kwalificatie van de ingenieur.
- Het is zeer geschikt voor databases van kleine omvang en met niet te hoge belasting. Hoe kleiner de database, hoe minder chunks er door het bestandssysteem binnen de pool worden verplaatst en hoe lager de belasting op de schijven.
- Voor onze taak gingen we op zoek naar andere oplossingen, waarover in de volgende sectie zal worden gesproken.
De tweede setup, technologie ZFS
Lang geleden had ik te maken met het ZFS-bestandssysteem, maar toen werkte ZFS echt goed op zijn oorspronkelijke besturingssysteem Solaris. Er was een geportte versie voor FreeBSD met een behoorlijk goed niveau van implementatie. Er was ook een onafgemaakte port voor Linux, die door weinigen werd gebruikt. Door de B-tree datastructuur (overigens dezelfde datastructuur als in InnoDB MySQL) presteerde ZFS slecht op installaties met een zeer groot aantal bestanden. Alles samen met de noodzaak om de technische details te leren, heeft deze filesystem lang uit mijn praktijk verwijderd. Ext4 en XFS verschenen, die de standaard werden. Maar gezien het feit dat ZFS meer dan geschikt is voor onze taak, en de Linux-versie, zo lijkt het uit beoordelingen, is uitgegroeid tot een behoorlijk product (hoewel niet volledig ondersteund, waardoor de installatie vanaf nul met ZFS alleen mogelijk is door verschillende tovenarij), besloten we het te proberen.
Om begrijpelijke redenen kozen we een stand met een vergelijkbare configuratie (tenzij de RAID-controller). We installeerden acht SSD-schijven van 1920 GB. We wilden geen eigen netwerkimage schrijven voor het laden van de server op een kale ZFS, dus we sneden 50 GB van elke schijf af en maakten er een MD RAID-10 van voor het systeem. De resterende 1950 GB op elke schijf combineerden we in een ZFS-analoog van RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2We maakten partities voor MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Let op dat we de standaard gzip-datacompressie hebben ingeschakeld. We hebben veel verwerkingsbronnen op de server en die worden niet volledig benut. Als resultaat is onze database van 3 TB gereduceerd tot 1,6 TB, en aangezien de zwakke schakel, zoals in het vorige geval, de maximale schijfprestaties is, hoe minder gegevens — hoe beter, krijgen we vanaf het begin een geweldige bonus van ZFS! Tijdens piekuren gaat er bij volle belasting tot 4 cores verloren om gzip draaiende te houden, maar daar zijn we niet rouwig om.
Daarna ging de implementatie sneller. We hebben de instellingen van de MySQL-replicastand op exact dezelfde manier overgenomen. We moesten enige tijd besteden aan het herschrijven van scripts naar ZFS-commando's, maar in grote lijnen bleven de algoritmes hetzelfde. Voorbeeld van het maken van een snapshot:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Vanuit de extra tuning: we hebben ZFS-segmenten met metadata en logs l2arc en zil in het geheugen geplaatst. Voor onze taak bleek dit later overbodig, maar voor nu hebben we deze optimalisatie behouden, het is niet moeilijk om dit later te veranderen. Negatieve effecten — na het herstarten van de server moeten de betreffende geheugenoplossingen opnieuw worden aangemaakt. Uittreksel van zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
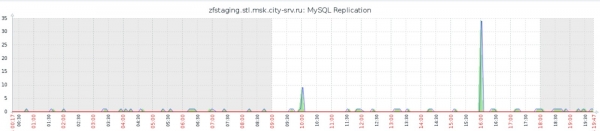
In deze configuratie zijn we de stand begonnen te testen en kregen we geweldige resultaten: met twee tegelijkertijd werkende DB-instanties (en een actieve primaire replica) op snapshots, kregen we een schijfbelasting van 50-60%.
We hebben ons belangrijkste probleem opgelost, wat zichtbaar is in de grafiek van de replicatievertraging (vergelijk met de vorige grafiek in de sectie Thin LVM):
Bovendien hebben we, dankzij deze aanpassing, alle operaties sterk versneld: het volledige aanmaken van een snapshot met het stoppen en starten van de replica duurt tot 40 seconden, het uitrollen van een nieuwe MySQL-instantie uit een snapshot duurt tot 20 seconden. Wat meer dan voldoende is voor zowel ons als onze softwarecode-tests.
Tussenresultaten:
- De resultaten voldeden volledig aan onze behoefte aan een kopie van de productie-DB voor het testen van de code.
- De technologie vereist inwerkingtreding: men moet begrijpen wat ZFS is en hoe ermee te werken.
- We hebben de huidige status van ZFS met een groot aantal (meer dan 1 miljoen) kleine bestanden niet gecontroleerd. Maar we vermoeden dat het probleem aanhoudt, daarom zou ik dit bestandssysteem niet aanraden voor enige opslagoplossingen.
Wat nu?
Binnen de stand hoeven we verder niets te doen; we zijn tevreden met het resultaat. Mogelijk zullen we in de toekomst uitzonderingen voor tabellen die niet nodig zijn voor testen aan de replicatie-instellingen toevoegen, wat de databasegrootte verder zal verminderen. We hebben het BTRFS-systeem en de implementatie van de technologie voor thin provisioning niet getest. Maar deze taak staat al niet meer op de agenda, omdat het belangrijkste doel bereikt is. In het algemeen willen we natuurlijk af van de hierboven beschreven aanpak — werkende database-migraties naar de testomgeving implementeren, een aparte testdatabase opzetten en ons bezig houden met sharding van de hoofddatabase. Veel hiervan realiseren we al, waarover we zeker in toekomstige artikelen zullen berichten.
Conclusies
De oorspronkelijke taak is opgelost, zij het op een ongebruikelijke manier. In de tussentijdse conclusies zijn de voordelen en nadelen van elke gebruikte technologie beschreven, laten we daarom bepalen welke technologie en wanneer gebruikt kan worden:
- Thin LVM — voor kleine databases en wanneer je ZFS niet wilt of geen tijd hebt om het te leren.
- ZFS — als je ervaring hebt met het werken ermee of als je de tijd kunt besteden aan leren in elke situatie.
Op een hoger niveau is dit artikel niet slechts een vergelijking van twee bestandssystemen. De belangrijkste boodschap die ik wil overbrengen en versterken, is dat je niet bang moet zijn om buiten de gebaande paden te denken in kritische zakelijke situaties en alleen de bestaande recepten te volgen. Ooit zouden we als technisch departement ons hoofd geschud hebben en gezegd hebben dat de taak om drie terabyte database-back-ups in minder dan een minuut te maken onuitvoerbaar is, en dat we geen risicovolle technologieën nodig hebben; laten we het gewoon goed doen. Dat was mogelijk, maar we zouden ongeveer een half jaar tot een jaar verloren hebben en veel klantreizen (reizen zijn onze belangrijkste commerciële indicator) zonder testen en tijdens de implementatie. Door op een niet-standaard manier te handelen, hebben we niet veel tijd verloren met de implementatie, hebben we ervaring opgedaan met nieuwe en vergeten oude technologieën, en hebben we testing aangeboden precies op het moment dat we het heel hard nodig hadden. Dit heeft ongetwijfeld een positieve invloed gehad op al onze prestaties. De keuze is altijd aan jou, en wij zullen aan onze kant blijven vertellen over interessante huidige en toekomstige prestaties in onze blog.
Bron: habr.com
