

 De database InterSystems IRIS ondersteunt interessante structuren voor gegevensopslag - globalen. Dit zijn in wezen gelaagde sleutels met verschillende extra functionaliteiten, zoals transacties, snelle functies voor het doorlopen van gegevensbomen, vergrendelingen en de eigen ObjectScript-taal.
Meer over globalen in de serie artikelen "Globalen - zwaarden en schatten voor gegevensopslag":
Ik was benieuwd hoe transacties in globalen zijn geïmplementeerd en wat de bijzonderheden zijn. Het is tenslotte een geheel andere structuur voor gegevensopslag dan de gebruikelijke tabellen. Veel meer low-level.
Zoals bekend uit de theorie van relationele databases moet een goede implementatie van transacties voldoen aan de vereisten :
A - Atomiciteit. Alle wijzigingen in de transactie worden vastgelegd of er worden helemaal geen wijzigingen vastgelegd.
C - Consistentie. Na de afronding van de transactie moet de logische toestand van de database intern consistent zijn. Dit vereiste is voor het grootste deel van toepassing op de programmeur, maar in het geval van SQL-databases betreft het ook externe sleutels.
I - Isolatie. Parallel lopende transacties mogen geen invloed op elkaar uitoefenen.
D - Duurzaamheid. Na een succesvolle afronding van de transactie mogen problemen op lagere niveaus (bijvoorbeeld stroomuitval) geen invloed hebben op de gegevens die door de transactie zijn gewijzigd.
Globalen zijn niet-relationele gegevensstructuren. Ze zijn ontworpen voor zeer snelle werking op zeer beperkte hardware. Laten we de implementatie van transacties in globalen onderzoeken met behulp van .
Voor het ondersteunen van transacties in IRIS worden de volgende commando's gebruikt: , , .
1. Atomiciteit
Het is het gemakkelijkst om de atomiciteit te controleren. We controleren vanuit de databaseconsole.
Kill ^a
TSTART
Set ^a(1) = 1
Set ^a(2) = 2
Set ^a(3) = 3
TCOMMIT
Dan maken we de volgende conclusie:
Write ^a(1), “ ”, ^a(2), “ ”, ^a(3)We krijgen:
1 2 3Alles is in orde. De atomiciteit is gewaarborgd: alle wijzigingen zijn vastgelegd.
Laten we de uitdaging vergroten, een fout in te voeren en te kijken hoe de transactie behouden blijft, gedeeltelijk of helemaal niet.
Laten we de atomiciteit nogmaals controleren:
Kill ^A
TSTART
Set ^a(1) = 1
Set ^a(2) = 2
Set ^a(3) = 3
Vervolgens stoppen we geforceerd de container, starten deze opnieuw en kijken we.
docker kill my-irisDit commando is praktisch gelijk aan een geforceerde stroomonderbreking, omdat het een onmiddellijke stop-signaal voor het proces SIGKILL verstuurt.
Kan het zijn dat de transactie gedeeltelijk is opgeslagen?
WRITE ^a(1), ^a(2), ^a(3)
^
 ^a(1)
— Nee, het is niet opgeslagen.
Laten we het rollback-commando testen:
Kill ^A
TSTART
Set ^a(1) = 1
Set ^a(2) = 2
Set ^a(3) = 3
TROLLBACK

WRITE ^a(1), ^a(2), ^a(3)
^
 ^a(1)
Er is ook niets opgeslagen.
2. Consistentie
Aangezien in globalen de sleutels ook op globalen worden gemaakt (ik herinner eraan dat een global een lager niveau structuur voor gegevensopslag is dan een relationele tabel), moet voor het voldoen aan de consistentie-eis de wijziging van de sleutel in dezelfde transactie worden opgenomen als de wijziging van de global.
Bijvoorbeeld, we hebben de global ^person, waarin we persoonsgegevens opslaan en als sleutel gebruiken we het belastingnummer.
^person(1234567, ‘firstname’) = ‘Sergey’
^person(1234567, ‘lastname’) = ‘Kamenev’
^person(1234567, ‘phone’) = ‘+74995555555
...
Om snel te kunnen zoeken op achternaam en voornaam hebben we de sleutel ^index gemaakt.
^index(‘Kamenev’, ‘Sergey’, 1234567) = 1Om de database consistent te houden, moeten we de persoonsgegevens als volgt toevoegen:
TSTART
^person(1234567, ‘firstname’) = ‘Sergey’
^person(1234567, ‘lastname’) = ‘Kamenev’
^person(1234567, ‘phone’) = ‘+74995555555
^index(‘Kamenev’, ‘Sergey’, 1234567) = 1
TCOMMIT
Bij het verwijderen moeten we ook een transactie gebruiken:
TSTART
Kill ^person(1234567)
ZKill ^index(‘Kamenev’, ‘Sergey’, 1234567)
TCOMMIT
Met andere woorden, de uitvoering van de consistentie-eis ligt volledig op de schouders van de programmeur. Maar als het gaat om globalen, is dat normaal, gezien hun low-level aard.
3. Isolatie
Hier beginnen de complicaties. Veel gebruikers werken tegelijkertijd aan dezelfde database, wijzigen dezelfde gegevens.
De situatie is te vergelijken met veel gebruikers die tegelijkertijd met dezelfde code repository werken en proberen tegelijkertijd wijzigingen in veel bestanden in te voegen.
De database moet dit alles in real-time oplossen. Gezien het feit dat er zelfs in grote bedrijven een speciale persoon is die verantwoordelijk is voor versiebeheer (voor het samenvoegen van takken, het oplossen van conflicten, enz.), en dat de database dit alles in real-time moet doen, wordt de complexiteit van de taak en de juistheid van het ontwerp van de database en de code die deze ondersteunt duidelijk.
Een database kan de betekenis van de handelingen van gebruikers niet begrijpen om conflicten te voorkomen als ze met dezelfde gegevens werken. Het kan alleen één transactie die in strijd is met een andere annuleren of ze achtereenvolgens uitvoeren.
Een ander probleem is dat tijdens het uitvoeren van een transactie (voor de commit), de staat van de database inconsistent kan zijn. Daarom is het wenselijk dat andere transacties geen toegang hebben tot de inconsistente staat van de database, wat op verschillende manieren in relationele databases wordt bereikt: door snapshots te maken, door multiversion concurrency control, enzovoort.
Bij het gelijktijdig uitvoeren van transacties is het belangrijk dat ze elkaar niet storen. Dit is de eigenschap van isolatie.
SQL definieert 4 niveaus van isolatie:
- READ UNCOMMITTED
- READ COMMITTED
- REPEATABLE READ
- SERIALIZABLE
Laten we elk niveau afzonderlijk bekijken. De kosten van de implementatie van elk niveau nemen vrijwel exponentieel toe.
READ UNCOMMITTED — dit is het laagste niveau van isolatie, maar ook het snelste. Transacties kunnen wijzigingen lezen die door elkaar zijn aangebracht.
READ COMMITTED — dit is het volgende isolatieniveau, dat een compromis is. Transacties kunnen wijzigingen die door elkaar zijn aangebracht niet lezen tot na de commit, maar kunnen alle wijzigingen lezen die na de commit zijn aangebracht.
Als we een lange transactie T1 hebben, waartijdens commits in transacties T2, T3 … Tn plaatsvinden, die met dezelfde gegevens werken als T1, dan zullen we bij het verzoek om gegevens in T1 elke keer een ander resultaat ontvangen. Dit fenomeen wordt niet-herhaalbare lezing genoemd.
REPEATABLE READ — op dit isolatieniveau hebben we geen fenomeen van niet-herhaalbare lezing, doordat voor elke leesaanroep een snapshot van de gegevensresultaten wordt gemaakt en bij herhaald gebruik in dezelfde transactie de gegevens uit de snapshot worden gebruikt. Echter, op dit isolatieniveau is het mogelijk om fantoomdata te lezen. Dit verwijst naar het lezen van nieuwe rijen die zijn toegevoegd door parallelle, gecommitteerde transacties.
SERIALIZABLE — het hoogste niveau van isolatie. Het wordt gekenmerkt doordat gegevens die op een of andere manier in de transactie worden gebruikt (lezen of wijzigen) pas toegankelijk worden voor andere transacties na afloop van de eerste transactie.
Laten we eerst uitzoeken of er isolatie is van transactiebewerkingen van de hoofdthread. We openen 2 terminalvensters.
Kill ^t

Write ^t(1)
2
TSTART
Set ^t(1)=2
Er is geen isolatie. Eén thread ziet wat de tweede die de transactie heeft geopend doet.
Laten we kijken of de transacties van verschillende threads zien wat er binnen hen gebeurt.
We openen 2 terminalvensters en starten 2 transacties parallel.
kill ^t
TSTART
Write ^t(1)
3
TSTART
Set ^t(1)=3
Parallelle transacties zien de gegevens van elkaar. Dus, we hebben het eenvoudigste, maar ook snelste isolatieniveau READ UNCOMMITTED verkregen.
In principe was dit te verwachten voor globale variabelen, waarbij prestaties altijd voorop stonden.
Wat als we een hoger isolatieniveau nodig hebben voor bewerkingen op globale variabelen?
Hier moeten we nadenken over waarom isolatieniveaus überhaupt nodig zijn en hoe ze werken.
Het hoogste isolatieniveau SERIALIZE betekent dat het resultaat van parallel uitgevoerde transacties gelijkwaardig is aan hun sequentiële uitvoering, wat collisions garandeert.
Dit kunnen we doen met behulp van slimme locks in ObjectScript, die tal van verschillende toepassingsmethoden hebben: je kunt een gewone, incrementele, of meervoudige lock uitvoeren met het commando .
Lagere isolatieniveaus zijn compromissen die bedoeld zijn om de snelheid van de database te verhogen.
Laten we bekijken hoe we verschillende isolatieniveaus kunnen bereiken met behulp van locks.
Deze operator maakt het mogelijk om niet alleen exclusieve locks te verkrijgen, die nodig zijn voor het wijzigen van gegevens, maar ook zogenaamde shared locks, die gelijktijdig door meerdere threads kunnen worden verkregen wanneer ze gegevens moeten lezen die niet door andere processen mogen worden gewijzigd tijdens het lezen.
Meer over de tweefasige lockmethode in het Russisch en Engels:
→
→
De moeilijkheid ligt in het feit dat de status van de database tijdens de transactie inconsistent kan zijn, maar deze inconsistente gegevens zichtbaar zijn voor andere processen. Hoe voorkomen we dit?
We creëren met behulp van locks zichtvensters waarin de status van de database consistent zal zijn. En alle toegang tot dergelijke zichtvensters van consistente toestand zal gecontroleerd worden door locks.
Shared-locks voor dezelfde gegevens zijn herbruikbaar — meerdere processen kunnen ze nemen. Deze locks verhinderen andere processen om de gegevens te wijzigen, dat wil zeggen dat ze worden gebruikt voor het vormen van vensters met een consistente staat van de database.
Uitsluitende locks worden gebruikt voor gegevenswijzigingen — zo'n lock kan alleen door één proces worden genomen. Een exclusieve lock kan worden genomen door:
- Elk proces, als de gegevens beschikbaar zijn.
- Alleen dat proces dat een shared lock op deze gegevens heeft en als eerste een exclusieve lock heeft aangevraagd.
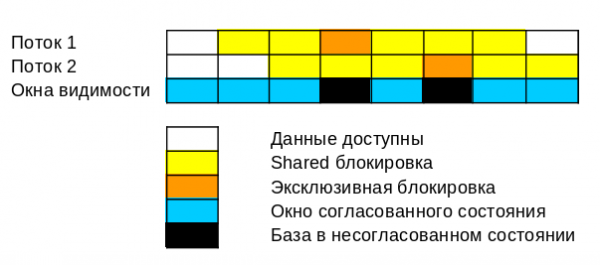
Hoe smaller het zichtvenster, hoe langer andere processen moeten wachten, maar hoe consistenter de staat van de database daarin kan zijn.
READ_COMMITED — de essentie van dit niveau is dat we alleen gecommitteerde gegevens uit andere stromen zien. Als de gegevens in een andere transactie nog niet zijn gecommitteerd, zien we hun oude versie.
Dit stelt ons in staat om het werk parallel uit te voeren in plaats van te wachten op de vrijgave van de lock.
Zonder speciale kunstgrepen kunnen we de oude versie van gegevens in IRIS niet zien, dus moeten we ons behelpen met locks.
Daarom moeten we met behulp van shared locks lezen van gegevens alleen toestaan tijdens momenten van consistentie.
Stel dat we een gebruikersdatabase ^person hebben, die geld naar elkaar overmaken.
Het moment van de overdracht van persoon 123 naar persoon 242:
LOCK +^person(123), +^person(242)
Set ^person(123, amount) = ^person(123, amount) - amount
Set ^person(242, amount) = ^person(242, amount) + amount
LOCK -^person(123), -^person(242)
Het moment van het opvragen van het bedrag bij persoon 123 voordat het afgeschreven wordt, moet vergezeld gaan van een exclusieve lock (standaard):
LOCK +^person(123)
Write ^person(123)
En als het nodig is om de balans in het persoonlijke account weer te geven, kan een shared lock of helemaal geen lock worden gebruikt:
LOCK +^person(123)#”S”
Write ^person(123)
Echter, als we aannemen dat databaseoperaties praktisch onmiddellijk plaatsvinden (laat ik jullie herinneren dat globalen een veel lager niveau structuur zijn dan een relationele tabel), dan verdwijnt de noodzaak voor dit niveau.
REPEATABLE READ — op dit isolatieniveau wordt toegestaan dat er meerdere leesbewerkingen van gegevens zijn die kunnen worden gewijzigd door parallele transacties.
Daarom moeten we een shared lock instellen voor het lezen van gegevens die we wijzigen en exclusieve locks voor de gegevens die we veranderen.
De LOCK-operator stelt ons in staat om in één operator gedetailleerd alle noodzakelijke vergrendelingen op te sommen, die er heel veel kunnen zijn.
LOCK +^person(123, amount)#”S”
lezen ^person(123, amount)
andere operaties (terwijl parallelle stromen proberen ^person(123, amount) te wijzigen, maar dat niet kunnen)
LOCK +^person(123, amount)
wijziging ^person(123, amount)
LOCK -^person(123, amount)

lezen ^person(123, amount)
LOCK -^person(123, amount)#”S”
Bij het opsommen van vergrendelingen met een komma worden deze sequentieel genomen, maar als je het zo doet:
LOCK +(^person(123),^person(242))dan worden ze allemaal atomair tegelijk genomen.
SERIALIZE — we moeten vergrendelingen instellen zodat uiteindelijk alle transacties die gemeenschappelijke gegevens hebben, sequentieel worden uitgevoerd. Voor deze aanpak moeten de meeste vergrendelingen exclusief zijn en over de kleinste gebieden in de globale worden genomen voor prestaties.
Als we het hebben over het afschrijven van middelen in de globale ^person, dan is alleen het SERIALIZE-isolatieniveau acceptabel, aangezien het geld strikt sequentieel moet worden besteed, anders kan dezelfde hoeveelheid meerdere keren worden uitgegeven.
4. Duurzaamheid
Ik heb tests uitgevoerd met het abrupt uitschakelen van de container via
docker kill my-irisDe database droeg het goed. Er zijn geen problemen vastgesteld.
Conclusie
Voor globals in InterSystems IRIS is er ondersteuning voor transacties. Ze zijn echt atomair, betrouwbaar. Voor het waarborgen van de consistentie van de database in globals zijn de inspanningen van de programmeur en het gebruik van transacties vereist, omdat er geen complexe ingebouwde constructies zoals externe sleutels zijn.
Het isolatieniveau in globals zonder vergrendelingen is READ UNCOMMITED, en met gebruik van vergrendelingen kan dit worden gewaarborgd tot het SERIALIZE-niveau.
De correctheid en snelheid van transacties in globals hangt sterk af van de vaardigheden van de programmeur: hoe breder shared-vergrendelingen worden gebruikt bij het lezen, hoe hoger het isolatieniveau, en hoe nauwer exclusieve vergrendelingen worden genomen, hoe sneller de prestaties.
Bron: habr.com
