

Het principe van de onzekerheid van Heisenberg stelt dat het onmogelijk is om tegelijkertijd de positie van een object en zijn snelheid te meten. Als een object in beweging is, heeft het geen specifieke positie. En als er een positie is, dan betekent dat dat het geen snelheid heeft.
Wat betreft microservices op het Red Hat OpenShift-platform (en beheerd door Kubernetes), kunnen ze dankzij de bijbehorende open-source software tegelijkertijd rapporteren over zowel hun prestaties als hun functionaliteit. Dit weerlegt natuurlijk de oude man Heisenberg niet, maar het elimineert de onzekerheid bij het werken met cloudapplicaties. Istio maakt het gemakkelijk om tracering en monitoring van dergelijke applicaties te organiseren, zodat alles onder controle blijft.
Laten we de terminologie vaststellen
Onder tracering (Tracing) verstaan we het loggen van systeemactiviteit. Het klinkt vrij algemeen, maar een van de belangrijkste regels hier is om traceergegevens in de juiste opslag te dumpen, zonder je zorgen te maken over hun opmaak. Het volledige werk van het zoeken en analyseren van gegevens ligt bij de gebruiker ervan. In Istio wordt het traceringssysteem Jaeger gebruikt, dat het OpenTracing-datamodel implementeert.
Traceringen (Traces, en het woord "traceringen" wordt hier gebruikt in de betekenis van "sporen", zoals bijvoorbeeld in ballistische expertises) noemen we de gegevens die volledig beschrijven hoe een verzoek of een werkunit verloopt, zeg maar, “van begin tot eind”. Bijvoorbeeld, alles wat er gebeurt vanaf het moment dat een gebruiker op een knop op een webpagina drukt tot het moment dat gegevens worden teruggestuurd, inclusief alle microservices die daarbij betrokken zijn. Je zou kunnen zeggen dat één tracering volledig beschrijft (of modelleert) hoe een verzoek heen en terug gaat. In de Jaeger-interface worden traceringen opgedeeld in componenten langs de tijdas, zoals je een ketting in aparte schakels kunt opdelen. Maar in plaats van schakels bestaat een tracering uit zogenaamde span's.
Span – dit is het interval van het begin van de uitvoering van een werkunit tot de voltooiing ervan. Blijft de analogie behouden, dan kun je zeggen dat elke span een afzonderlijke schakel van de ketting vertegenwoordigt. Een span kan (of kan geen) een of meerdere kindspan's hebben. Als gevolg hiervan zal de span van het hoogste niveau (root span) dezelfde totale duur hebben als de tracering waartoe hij behoort.
Monitoring – is, in fact, the observation of your system – through the UI or via automation tools. Monitoring is based on tracing data. In Istio, monitoring is implemented using Prometheus and has a corresponding UI. Prometheus supports automatic monitoring with alert notifications and Alert Managers.
We make notches
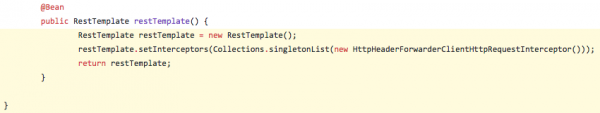
For tracing to be possible, the application must create a collection of spans. These must then be exported to Jaeger, which in turn creates a visual representation of the trace. Among other things, these spans mark the operation name and the timestamps of its start and end. The transfer of spans is done by redirecting HTTP headers intended for Jaeger from incoming requests to outgoing requests. Depending on the programming language used, this may require slight modifications to the application source code. Below is an example of code in Java (using the Spring Boot framework) that adds B3 (Zipkin-style) headers to your request in the Spring configuration class:
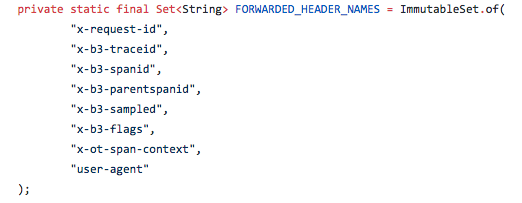
The following header settings are used:
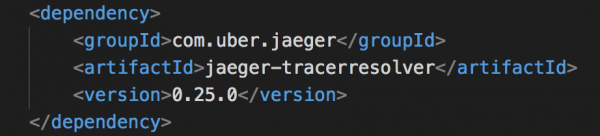
If you are using Java, you don't need to change the code; just add a few lines in the Maven POM file and set environment variables. Here are the lines that need to be added to the POM.XML file to implement the Jaeger Tracer Resolver:
And the corresponding environment variables are set in the Dockerfile:
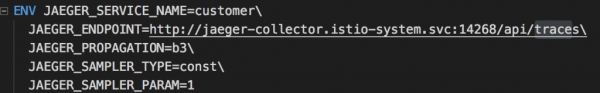
That's it, everything is set up, and our microservices will start generating trace data.
Looking at the big picture
Istio includes a simple control panel based on Grafana. When everything is set up and running on the Red Hat OpenShift PaaS platform (in our example, Red Hat OpenShift and Kubernetes are deployed on minishift), this panel is launched with the following command:
open "$(minishift openshift service grafana -u)/d/1/istio-dashboard?refresh=5⩝Id=1"
The Grafana panel allows for a quick assessment of the system's performance. A fragment of this panel is shown in the image below:
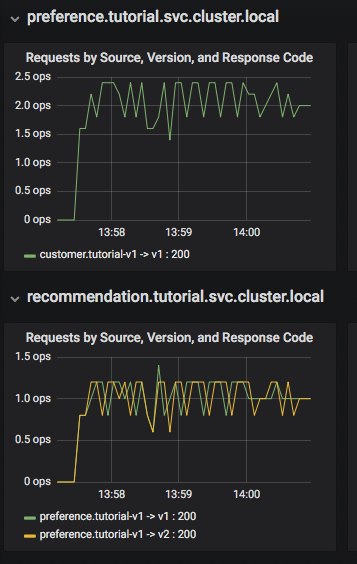
Hier zien we dat de microservice customer de microservice preference v1 aanroept, en deze op zijn beurt roept de microservices recommendation v1 en v2 aan. Op het Grafana-paneel is er een Dashboard Row-blok voor high-level metrics, zoals het totale aantal verzoeken (Global Request Volume), het percentage succesvolle verzoeken (success rates) en fouten 4xx. Daarnaast is er een weergave van Server Mesh met grafieken voor elke service en een blok Services Row voor het bekijken van gedetailleerde informatie over elke container voor elke service.
Laten we dieper graven
Bij correct ingestelde tracing van Istio, wat eigenlijk direct uit de doos beschikbaar is, kan je dieper ingaan op de prestatie-analyse van het systeem. In de Jaeger UI kun je traceringen bekijken en zien hoe ver en diep ze gaan, en visueel knelpunten in de prestaties lokaliseren. Wanneer je Red Hat OpenShift op het minishift-platform gebruikt, start je de Jaeger UI met de volgende opdracht:
minishift openshift service jaeger-query --in-browser
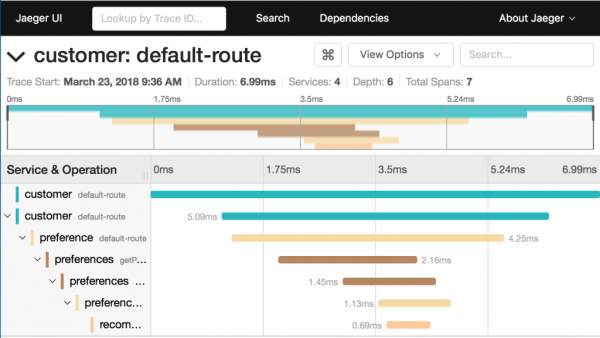
Wat kunnen we zeggen over de tracing op deze afbeelding:
- Het is verdeeld in 7 spans.
- De totale uitvoeringstijd bedraagt 6,99 ms.
- De microservice recommendation, die de laatste in de keten is, verbruikt 0,69 ms.
Dit type diagrammen maakt het mogelijk om snel te begrijpen wanneer de prestaties van het complete systeem lijden onder een enkel dienst die niet goed functioneert.
Laten we de taak nu complexer maken en twee exemplaren van de microservice recommendation:v2 opstarten met het commando oc scale --replicas=2 deployment/recommendation-v2. Dit is wat we daarna aan pods zullen hebben:
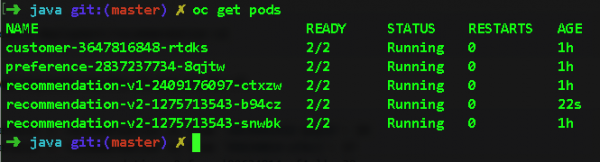
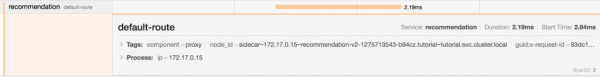
Als we nu terugschakelen naar Jaeger en de span voor de service recommendation uitvouwen, zien we naar welke pod de verzoeken worden gerouteerd. Hierdoor kunnen we eenvoudig vertragingen lokaliseren op het niveau van een specifieke pod. Kijk hierbij naar het veld node_id:
Waarheen en hoe alles loopt
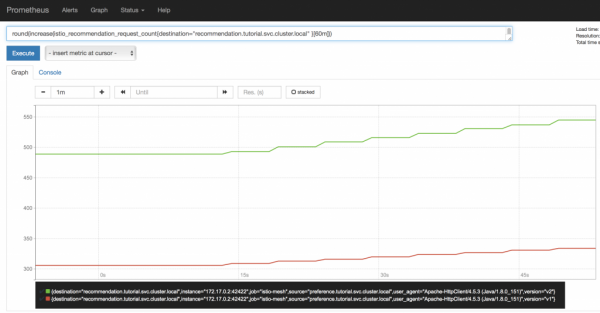
We gaan nu naar de Prometheus-interface en zien daar, zoals verwacht, dat de verzoeken tussen de tweede en eerste versies van de service recommendation worden verdeeld in een verhouding van 2:1, strikt op basis van het aantal werkende pods. Dit grafiek zal dynamisch veranderen bij het opschalen van pods omhoog of omlaag, wat bijzonder nuttig zal zijn bij Canary Deployment (we zullen deze implementatiestrategie in de volgende sessie beter bekijken).
Alles begint pas
Eigenlijk hebben we vandaag slechts oppervlakkig een schat aan nuttige informatie over Jaeger, Grafana en Prometheus aangestipt. Dit was ook ons doel – u in de juiste richting leiden en de mogelijkheden van Istio onthullen.
En onthoud, dit is allemaal al ingebouwd in Istio. Bij het gebruik van bepaalde programmeertalen (zoals Java) en frameworks (zoals Spring Boot) kan dit allemaal worden gerealiseerd zonder de applicatiecode aan te raken. Ja, de code moet enigszins worden aangepast als u andere talen gebruikt, met name Node.js of C#. Maar aangezien traceerbaarheid (lees: ‘tracering’) een van de vereisten is voor het creëren van betrouwbare cloudsystemen, zult u in ieder geval de code moeten aanpassen, of u nu Istio gebruikt of niet. Waarom de inspanning dan niet effectiever inzetten?
Laten we zeggen: om altijd met 100% zekerheid de vragen 'waar?' en 'hoe snel?' te kunnen beantwoorden.
Chaos-engineering in Istio: zoals het bedoeld was
Het vermogen om dingen kapot te maken helpt ervoor te zorgen dat ze niet kapotgaan.
Softwaretesten is niet alleen een complexe taak, maar ook een belangrijke. Tegelijkertijd is testen op correctheid (bijvoorbeeld of een functie het juiste resultaat teruggeeft) iets anders dan testen onder onbetrouwbare netwerkconditions – dit wordt vaak verondersteld dat het netwerk altijd zonder onderbrekingen werkt, en dat is het eerste van de acht misvattingen over gedistribueerde computing. Een van de moeilijkheden bij het aanpakken van deze taak is hoe systeemstoringen te simuleren of deze opzettelijk te introduceren door middel van zogenaamde fault injection. Dit kan gedaan worden door de oorspronkelijke code van de applicatie te wijzigen. Maar dan test u niet uw oorspronkelijke code, maar een versie die speciaal is ontworpen om storingen te simuleren. Het resultaat is dat u het risico loopt om in de dodelijke omhelzing van fault injection te belanden en te maken te krijgen met Heisenbugs – storingen die verdwijnen wanneer men probeert ze te ontdekken.
En nu laten we zien hoe Istio helpt deze complicaties snel op te lossen.
Hoe alles eruitziet wanneer alles perfect werkt.
Laten we het volgende scenario bekijken: we hebben twee pod’s voor onze recommendation microservice, die we uit de Istio-handleiding hebben gehaald. De ene pod is gemarkeerd als v1 en de andere als v2. Zoals we zien, werkt alles prima tot nu toe:
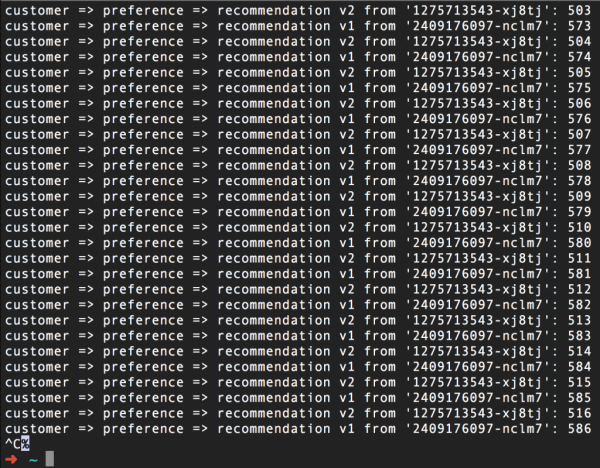
(Trouwens, het nummer aan de rechterkant is gewoon een teller voor elke pod.)
Maar we hebben dit echt niet nodig, toch? Laten we proberen alles kapot te maken, zonder de oorspronkelijke code aan te raken.
We veroorzaken storingen in de microservice.
Hieronder staat een yaml-bestand voor de Istio-routeringregel, die in de helft van de gevallen een fout zal geven (foutmelding). de server 503):
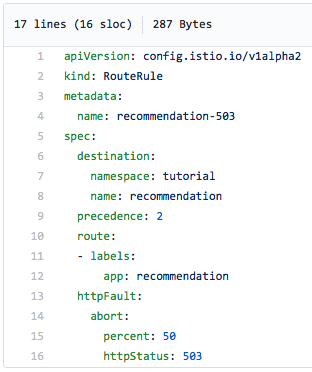
Let op, we geven expliciet aan dat in de helft van de gevallen een fout 503 moet worden teruggegeven.
Zo ziet een screenshot eruit van de curl-opdracht die in een loop draait, nadat we deze regel hebben geactiveerd om storingen te simuleren. Zoals te zien is, geeft de helft van de aanvragen een fout 503 terug, ongeacht op welke pod – v1 of v2 – ze worden verzonden.
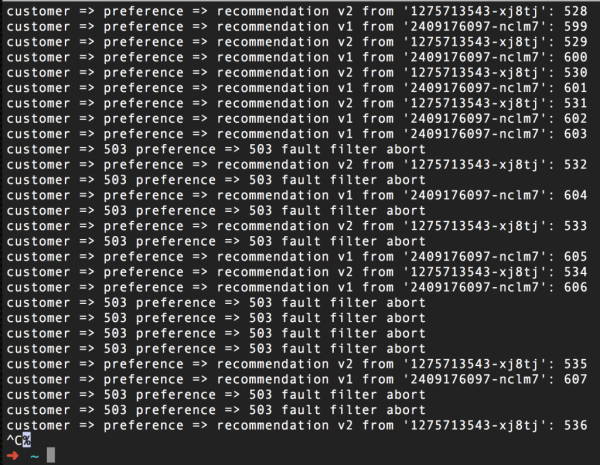
Om de normale werking te herstellen, hoeft u alleen maar deze regel te verwijderen, in ons geval met het commando istioctl delete routerule recommendation-503 -n tutorial. Hier is Tutorial de naam van het Red Hat OpenShift-project waarin onze Istio-tutorial draait.
We brengen kunstmatige vertragingen aan.
Kunstmatige fouten 503 helpen om het systeem op veerkracht tegen storingen te testen, maar het vermogen om vertragingen te voorspellen en ermee om te gaan, zou u nog meer moeten imponeren. Vertragingen komen in het echte leven namelijk vaker voor dan storingen. Een traag werkende microservice is een vergif waar het hele systeem onder lijdt. Met Istio kunnen we de code die met vertragingen omgaat testen, zonder deze te wijzigen. We zullen eerst laten zien hoe dit werkt bij kunstmatig ingevoerde netwerkvertragingen.
Let op, na zo'n test moet u mogelijk (of wilt u) uw code aanpassen. Het goede nieuws is dat u in dit geval proactief zult handelen, in plaats van reactief. Dit is hoe de ontwikkelingscyclus moet worden gebouwd: coderen-testen-feedback-coderen-testen…
Dit is hoe de regel eruitziet, die... Maar weet u wat? Istio is zo eenvoudig, en dit yaml-bestand is zo duidelijk, dat alles in dit voorbeeld voor zich spreekt. Kijk maar:
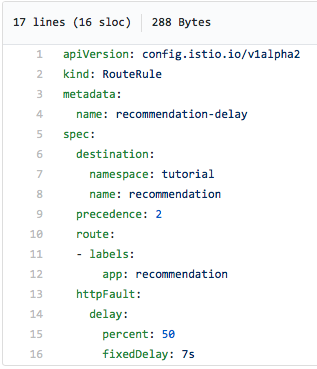
In de helft van de gevallen zullen we een vertraging van 7 seconden ervaren. Dit is absoluut niet hetzelfde als wanneer we een sleep-commando in de originele code zouden invoegen, omdat Istio daadwerkelijk de aanvraag 7 seconden vertraagt. Aangezien Istio Jaeger-tracering ondersteunt, is deze vertraging duidelijk zichtbaar in de Jaeger UI, zoals te zien is in de onderstaande screenshot. Let op het lange verzoek in de rechterbovenhoek van de grafiek – de duur is 7,02 seconden:
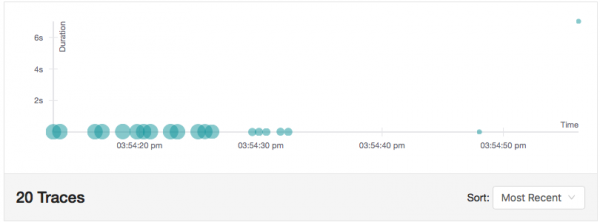
Dit scenario maakt het mogelijk om de code te testen onder netwerklatenties. En het is duidelijk dat als we deze regel weghalen, we de kunstmatige vertraging zullen verwijderen. Laten we herhalen dat we dit alles hebben gedaan zonder de originele code aan te raken.
Niet afwijken en niet opgeven
Een andere nuttige functie van chaos engineering in Istio is de mogelijkheid om meerdere keren een verzoek naar de service te doen binnen een bepaald aantal keren. Het idee hier is om niet te stoppen als de eerste aanvraag eindigt met een foutmelding 503 – en dan, misschien, hebben we geluk bij de N-de poging. Misschien ligt de service tijdelijk plat om een of andere reden. Ja, deze reden moet worden uitgezocht en opgelost. Maar dat later, laten we nu proberen om het systeem operationeel te houden.
Dus we willen dat de service van tijd tot tijd een fout 503 teruggeeft, en Istio daarna opnieuw probeert contact te maken. En we hebben duidelijk een manier nodig om een fout 503 te genereren zonder de code zelf aan te raken…
Wacht, even wachten! We deden dit net.
Dit bestand zorgt ervoor dat de service recommendation-v2 in de helft van de gevallen een fout 503 zal geven:
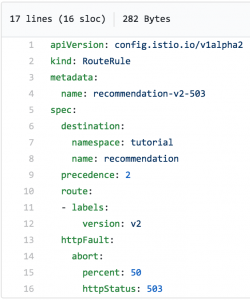
Het is duidelijk dat een deel van de verzoeken zal falen:
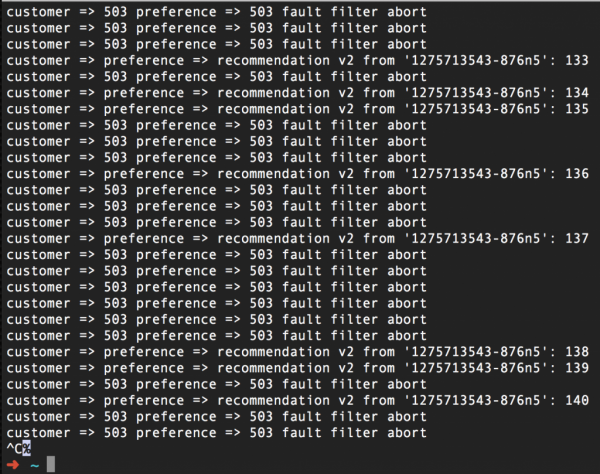
Laten we nu de Istio Retry-functie inschakelen:
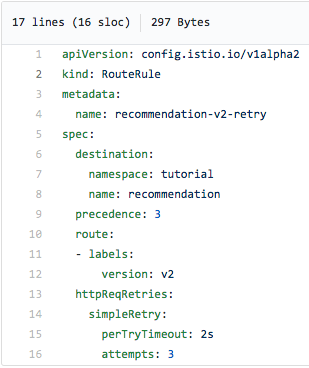
Deze routeringsregel maakt drie opnieuw pogingen met tussenpozen van twee seconden en zou de 503-fouten moeten verminderen (en idealiter volledig van de radar moeten verwijderen):
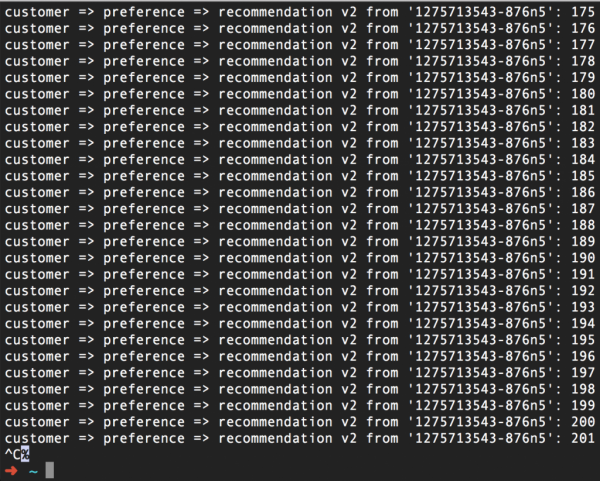
Samenvattend: we hebben ervoor gezorgd dat Istio, ten eerste, een fout 503 genereert voor de helft van de verzoeken. Ten tweede, dezelfde Istio probeert drie keer opnieuw contact te maken met de service bij een fout 503. Als gevolg daarvan werkt alles gewoon uitstekend. Door de Retry-functie te gebruiken, hebben we ons beloofde om niet af te wijken en niet op te geven, nagekomen.
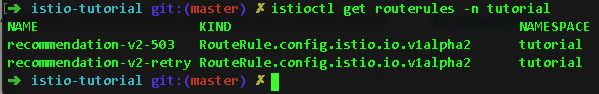
En ja, we hebben het opnieuw gedaan, zonder de code aan te raken. Alles wat we nodig hadden, waren twee Istio routeringsregels:
Hoe je de gebruiker niet in de steek laat of zeven mensen wachten.
Laten we de situatie omdraaien en het scenario bekijken waarin het alleen gedurende een bepaalde tijd de moeite waard is om niet op te geven of zich niet over te geven. Daarna moeten we gewoon stoppen met het proberen om het verzoek te verwerken, om te voorkomen dat iedereen moet wachten op één vertraagde service. Met andere woorden, we zullen de verloren positie niet verdedigen, maar ons terugtrekken naar een alternatieve lijn om de gebruiker van de site niet in het ongewisse te laten zitten.
In Istio kun je een timeout voor het uitvoeren van een verzoek instellen. Als de service deze timeout overschrijdt, wordt er een fout 504 (Gateway Timeout) geretourneerd - dit alles gebeurt weer via de configuratie van Istio. Maar we moeten een slaapcommando aan de broncode van de service toevoegen (en vervolgens natuurlijk de rebuild en redeploy uitvoeren), om de trage werking van de service te simuleren. Helaas, anders kan het niet.
Dus, we hebben een drie seconden durende slaap in de code van de service recommendation v2 geplaatst, het bijbehorende image opnieuw opgebouwd en de container opnieuw gedeployed, en nu gaan we een timeout toevoegen met behulp van de volgende Istio-routingregel:
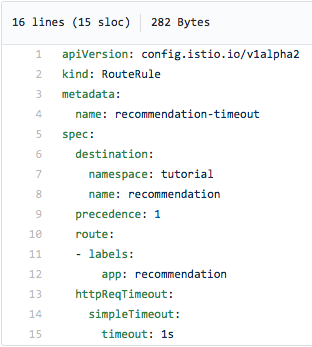
Op de bovenstaande screenshot is te zien dat we stoppen met het proberen om verbinding te maken met de service recommendation, als we binnen één seconde geen antwoord krijgen, dat wil zeggen nog voordat de fout 504 optreedt. Na het toepassen van deze routingregel (en het toevoegen van de drie seconden durende slaap in de code van de service recommendation:v2), krijgen we dit:
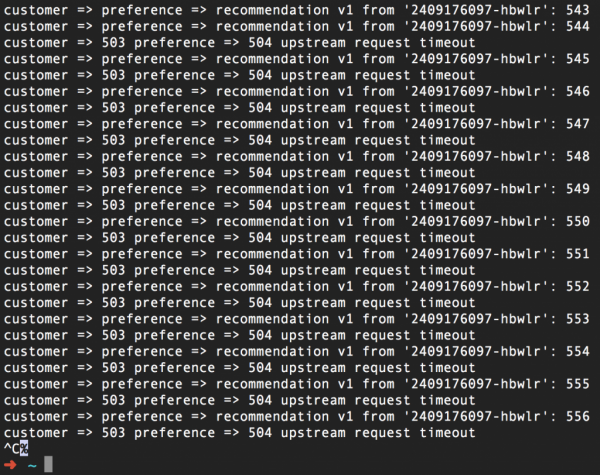
We herhalen het opnieuw, maar de timeout kan worden ingesteld zonder de broncode aan te raken. En het extra voordeel hier is dat je nu je code kunt aanpassen zodat deze reageert op de timeout, en deze aanpassingen eenvoudig kunt testen met behulp van Istio.
En nu alles samen
Een beetje chaos introduceren met behulp van Istio is een geweldige manier om je code en de betrouwbaarheid van je systeem als geheel te testen. Fallback-, bulkhead- en circuit breaker-patronen, mechanismen voor het creëren van kunstmatige storingen en vertragingen, evenals herhaalde aanroepen en timeouts zullen zeer nuttig zijn bij het creëren van veerkrachtige cloudsystemen. In combinatie met Kubernetes en Red Hat OpenShift zullen deze tools helpen om zelfverzekerd de toekomst tegemoet te treden.
Bron: habr.com
