

Voor een volledige beheersing van Kubernetes moet je verschillende manieren van het schalen van clusterresources kennen: volgens , is dit een van de belangrijkste taken van Kubernetes. We hebben een hoog niveau overzicht voorbereid van de mechanismen voor horizontale en verticale autoscaling en het aanpassen van clusterformaten, evenals aanbevelingen over hoe ze effectief kunnen worden gebruikt.
Het artikel is vertaald door het team dat autoscaling heeft geïmplementeerd in .
Waarom het belangrijk is om over schaling na te denken
— een tool voor resourcebeheer en orkestratie. Natuurlijk is het leuk om te experimenteren met de coole functies van implementatie, monitoring en podbeheer (een pod-module is een groep containers die wordt uitgevoerd als reactie op een verzoek).
Echter, je moet ook nadenken over zaken als:
- Hoe schaal je modules en applicaties?
- Hoe houd je containers operationeel en efficiënt?
- Hoe reageer je op constante veranderingen in de code en gebruikerslasten?
Het configureren van Kubernetes-clusters voor resource- en prestatiebalancering kan een complexe taak zijn, die expertise over de interne werking van Kubernetes vereist. De belasting op je applicatie of diensten kan gedurende de dag of zelfs in een enkel uur fluctueren, daarom moet je balancering zien als een continu proces.
Niveaus van Kubernetes-autoscaling
Effectieve autoscaling vereist coördinatie tussen twee niveaus:
- Het pod-niveau, dat horizontale (Horizontal Pod Autoscaler, HPA) en verticale autoscaling (Vertical Pod Autoscaler, VPA) omvat. Dit betreft het schalen van de bestaande resources voor je containers.
- Het cluster-niveau, dat wordt beheerd door het cluster-autoscaling systeem (Cluster Autoscaler, CA), dat het aantal knooppunten binnen het cluster vergroot of vermindert.
De module voor horizontale autoscaling (HPA)
Zoals de naam al aangeeft, schaalt HPA het aantal pod-replicas. Als triggers voor het wijzigen van het aantal replicas gebruiken de meeste DevOps-specialisten de CPU- en geheugendruk. Het is echter ook mogelijk om het systeem te schalen op basis van , hun of zelfs .
Hoog-niveau schema van de werking van HPA:
- HPA controleert continu de waarden van de gemeten metrics die bij de installatie zijn opgegeven, met een standaardinterval van 30 seconden.
- HPA probeert het aantal modules te verhogen wanneer de opgegeven drempel is bereikt.
- HPA actualiseert het aantal replicas binnen de deployment/replicatiecontroller.
- De deployment/replicatiecontroller implementeert vervolgens alle benodigde extra modules.
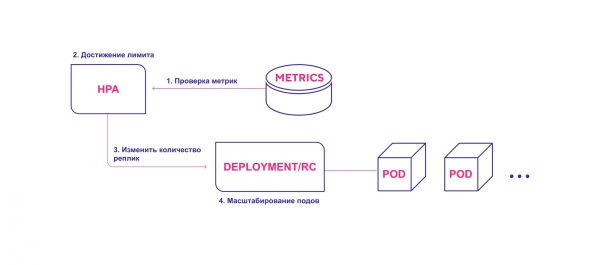
HPA start het proces van module-implementatie wanneer de drempelwaarde van de metrics is bereikt.
Houd rekening met het volgende bij het gebruik van HPA:
- Het standaard controle-interval van HPA is 30 seconden. Dit wordt ingesteld met de vlag horizontal-pod-autoscaler-sync-period in de controller manager.
- De relatieve foutmarge bedraagt standaard 10%.
- Na de laatste verhoging van het aantal modules wacht HPA drie minuten op de stabilisatie van de metrics. Dit interval wordt ingesteld met de vlag horizontal-pod-autoscaler-upscale-delay.
- Na de laatste verlaging van het aantal modules wacht HPA vijf minuten op stabilisatie. Dit interval wordt ingesteld met de vlag horizontal-pod-autoscaler-downscale-delay.
- HPA werkt het beste met deployment-objecten en niet met replicatiecontrollers. Horizontale autoscaling is niet compatibel met rolling updates die direct manipuleren met replicatiecontrollers. Bij deployment hangt het aantal replicas direct af van de deployment-objecten.
Verticale autoscaling van pods
Verticale autoscaling (VPA) wijst meer (of minder) CPU- of geheugenresources toe aan bestaande pods. Dit is geschikt voor zowel stateful als stateless pods, maar is voornamelijk bedoeld voor stateful services. Je kunt echter VPA ook toepassen op stateless modules als je automatisch de oorspronkelijk toegewezen middelen wilt aanpassen.
VPA reageert ook op OOM-evenementen (out of memory, onvoldoende geheugen). Voor het wijzigen van CPU- en geheugentijd is het nodig om pods opnieuw op te starten. Bij het herstarten houdt VPA zich aan het distributiebudget () om een minimaal aantal modules te waarborgen.
U kunt het minimale en maximale aantal resources voor elke module instellen. Zo kunt u de maximale hoeveelheid toegewezen geheugen beperken tot 8 GB. Dit is nuttig als de huidige knooppunten niet meer dan 8 GB geheugen per container kunnen toewijzen. Gedetailleerde specificaties en de werking worden beschreven in .
Daarnaast heeft VPA een interessante functie voor aanbevelingen (VPA Recommender). Het volgt het gebruik van resources en OOM-gebeurtenissen van alle modules om nieuwe geheugen- en CPU-tijdwaarden voor te stellen op basis van een intelligent algoritme dat historische metrics in overweging neemt. Er is ook een API die een pod-descriptor accepteert en aanbevolen resourcewaarden retourneert.
Het is vermeldenswaard dat VPA Recommender de 'limiet' van resources niet volgt. Dit kan ertoe leiden dat een module resources binnen de knooppunten monopoliseert. Het is beter om een maximum te stellen op het niveau van de namespace om grote geheugengebruik of CPU-tijd te vermijden.
Hoog niveau werkschema van VPA:
- VPA controleert voortdurend de gemeten waarden zoals ingesteld, met een standaardinterval van 10 seconden.
- Als de ingestelde drempel is bereikt, probeert VPA de toegewezen hoeveelheid resources aan te passen.
- VPA werkt het aantal resources bij binnen de deployment-/replicatiecontroller.
- Bij het herstarten van modules worden alle nieuwe resources toegepast op de gemaakte instanties.
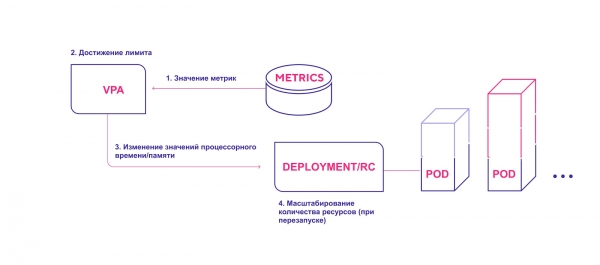
VPA voegt de benodigde hoeveelheid resources toe
Houd rekening met de volgende punten bij het gebruik van VPA:
- Schaalvergroting vereist dat de pod verplicht wordt herstart. Dit is nodig om onbetrouwbaar gedrag na wijzigingen te voorkomen. Voor de betrouwbaarheid herstarten modules en verdelen ze over knooppunten op basis van de nieuwe toegewezen resources.
- VPA en HPA zijn momenteel niet compatibel met elkaar en kunnen niet op dezelfde pod's functioneren. Als u beide schaalsystemen in hetzelfde cluster toepast, zorg er dan voor dat de instellingen hen niet toestaan om op dezelfde objecten te activeren.
- VPA configureert de containerverzoeken voor middelen uitsluitend op basis van hun eerdere en huidige gebruik. Het stelt geen gebruikslimieten in. Dit kan leiden tot problemen met de werking van applicaties die steeds meer middelen beginnen te verbruiken, wat ertoe kan leiden dat Kubernetes deze pod uitschakelt.
- VPA is momenteel nog in een vroege ontwikkelingsfase. Wees bereid dat het systeem in de nabije toekomst enkele wijzigingen kan ondergaan. Je kunt lezen over en . De plannen omvatten de implementatie van samenwerking tussen VPA en HPA, evenals de uitrol van modules samen met een beleid voor verticale autoscaling voor hen (bijvoorbeeld een speciale label ‘requires VPA’).
Autoscaling van de Kubernetes-cluster
Cluster autoscaler (CA) past het aantal nodes aan op basis van het aantal in afwachting zijnde pods. Het systeem controleert periodiek op in afwachting zijnde pods en vergroot de cluster als er meer middelen nodig zijn en als de cluster binnen de vastgestelde limieten blijft. CA werkt samen met de cloudprovider om extra nodes aan te vragen of inactieve nodes vrij te geven. De eerste publieke versie van CA werd geïntroduceerd in Kubernetes 1.8.
Hoog-niveau werkdiagram van CA:
- CA controleert elke 10 seconden op betrokken pods in afwachting.
- Als een of meerdere pods in afwachting zijn omdat er onvoldoende beschikbare middelen in de cluster zijn, probeert het één of meerdere extra nodes voor te bereiden.
- Wanneer de cloudprovider de benodigde node toewijst, voegt deze zich bij de cluster en is klaar om te dienen voor de pods.
- De Kubernetes-scheduler verdeelt de in afwachting zijnde pods over de nieuwe node. Als sommige pods daarna nog steeds in afwachting blijven, herhaalt het proces zich — en worden nieuwe nodes aan de cluster toegevoegd.
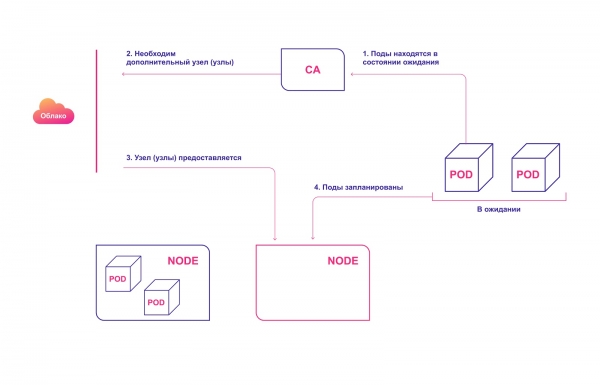
Automatische toewijzing van cluster nodes in de cloud
Houd het volgende in gedachten bij het gebruik van CA:
- CA garandeert dat alle pods in de cluster ruimte hebben om te draaien, ongeacht de CPU-belasting. Bovendien probeert het te garanderen dat de cluster geen onnodige nodes bevat.
- CA registreert de noodzaak voor schaling ongeveer elke 30 seconden.
- Nadat een knooppunt overbodig wordt, wacht CA standaard 10 minuten voordat het systeem schaalbaar maakt.
- In het automatisch schaling systeem zijn er uitbreiders (expanders). Dit zijn verschillende strategieën voor het selecteren van een groep knooppunten waaraan nieuwe zullen worden toegevoegd.
- Toepasselijke opties verantwoordelijk gebruiken cluster-autoscaler.kubernetes.io/safe-to-evict (true). Als je veel pods instelt of als ze verspreid zijn over verschillende knooppunten, verlies je in grote mate de mogelijkheid om het cluster te verkleinen.
- Gebruik , om te voorkomen dat pods worden verwijderd, waardoor een deel van je applicatie volledig kan falen.
Hoe Kubernetes automatisch schaling systemen met elkaar omgaan
Voor ideale harmonie moeten zowel pod-niveau (HPA/VPA) als cluster-niveau schaling worden toegepast. Ze interageren relatief eenvoudig met elkaar:
- HPA of VPA werken de replicaten van pods of de middelen die aan bestaande pods zijn toegewezen bij.
- Als er niet genoeg knooppunten zijn voor de geplande schaalvergroting, merkt CA pods op die in afwachting zijn.
- CA wijst nieuwe knooppunten toe.
- Modules worden verdeeld over nieuwe knooppunten.
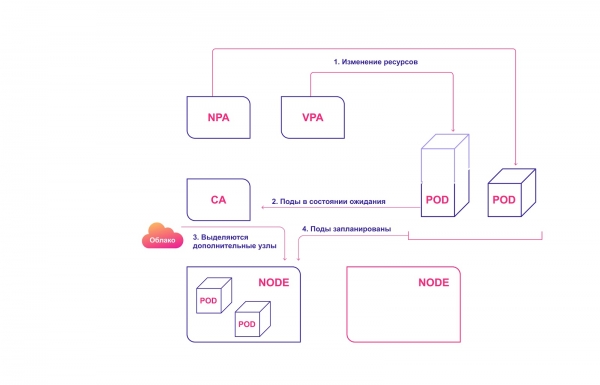
Gecoördineerd systeem van Kubernetes schaalbaarheidssystemen
Typische fouten bij Kubernetes automatische schaling
Er zijn verschillende veel voorkomende problemen waarmee DevOps-teams worden geconfronteerd bij het proberen te implementeren van automatische schaling.
HPA en VPA zijn afhankelijk van metrics en bepaalde historische gegevens. Als er onvoldoende middelen zijn toegewezen, zullen de modules worden ingeklapt en kunnen ze geen metrics genereren. In dat geval zal automatische schaling nooit plaatsvinden.
De eigen schaling operatie is tijdgevoelig. We willen dat modules en clusters snel schalen - voordat gebruikers problemen of storingen opmerken. Daarom moet rekening worden gehouden met de gemiddelde schalingstijd van pods en clusters.
Ideaal scenario - 4 minuten:
- 30 seconden. Bijwerken van doelmetrics: 30−60 seconden.
- 30 seconden. HPA controleert de metricwaarden: 30 seconden.
- Minder dan 2 seconden. Pods zijn aangemaakt en gaan in wachtoestand: 1 seconde.
- Minder dan 2 seconden. CA ziet de wachtende modules en doet oproepen om knooppunten gereed te maken: 1 seconde.
- 3 minuten. De cloudprovider wijst knooppunten toe. K8s wacht totdat ze gereed zijn: tot 10 minuten (afhankelijk van verschillende factoren).
Het slechtste (meer realistische) scenario is 12 minuten:
- 30 seconden. Doelmetingen worden bijgewerkt.
- 30 seconden. HPA controleert de meetwaarden.
- Minder dan 2 seconden. Pod-modules zijn gemaakt en gaan naar de status in afwachting.
- Minder dan 2 seconden. CA ziet de in afwachting zijnde modules en doet oproepen om de knooppunten voor te bereiden.
- 10 minuten. De cloudprovider wijst knooppunten toe. K8s wacht totdat ze gereed zijn. De wachttijd is afhankelijk van verschillende factoren, zoals leveranciervertraging, OS-vertraging, en de werking van hulpprogramma's.
Verwijs niet naar de schaalmechanismen van cloudproviders als onze CA. De laatste werkt binnen de Kubernetes-cluster, terwijl het mechanisme van de cloudprovider werkt op basis van knooppuntdistributie. Het weet niet wat er met je pod’s of applicatie gebeurt. Deze systemen werken parallel.
Hoe schaling in Kubernetes te beheren
- Kubernetes is een hulpmiddel voor resourcebeheer en orkestratie. De operaties voor het beheren van pod’s en de resources van de cluster zijn cruciale mijlpalen in het beheersen van Kubernetes.
- Begrijp de logica van de schaalbaarheid van pod’s met HPA en VPA.
- CA moet worden gebruikt alleen als je goed begrijpt wat de behoeften van je pod’s en containers zijn.
- Voor een optimale clusterconfiguratie moet je begrijpen hoe verschillende schaalmechanismen samen werken.
- Houd bij het beoordelen van de schaalduur rekening met het slechtste en beste scenario.
Bron: habr.com
