

Goedendag, in eerdere artikelen hebben we de werking van de ELK Stack leren kennen. Laten we nu de mogelijkheden bespreken die een IB-specialist kan implementeren bij het gebruik van deze systemen. Welke logs kunnen en moeten worden opgeslagen in Elasticsearch? We bekijken welke statistieken we kunnen verkrijgen door dashboards in te stellen en of er voordelen aan verbonden zijn. Hoe kunnen we de automatisering van IB-processen invoeren met de ELK-stack? We zullen de architectuur van het systeem opstellen. Alles bij elkaar is de implementatie van alle functionaliteiten een zeer grote en zware taak, daarom hebben we de oplossing onder een aparte naam gebracht — TS Total Sight.
Op dit moment winnen oplossingen die incidenten in IB consolideren en analyseren op één logische plek steeds meer aan populariteit. Hierdoor krijgt de specialist statistieken en een actievoorkeurslijst voor het verbeteren van de IB-status in de organisatie. Deze taak hebben we ons gesteld met het gebruik van de ELK-stack, en we hebben de belangrijkste functionaliteiten onderverdeeld in 4 secties:
- Statistieken en visualisatie;
- Detectie van IB-incidenten;
- Prioritering van incidenten;
- Automatisering van IB-processen.
Laten we de verschillende onderdelen nu uitgebreider bekijken.
Detectie van IB-incidenten
De belangrijkste taak bij het gebruik van Elasticsearch in ons geval is het verzamelen van alleen IB-incidenten. IB-incidenten kunnen worden verzameld van alle beveiligingsmiddelen, zolang ze ten minste enkele logverzendingsmethoden ondersteunen, het standaard is syslog of het opslaan naar een bestand via SCP.
We kunnen enkele standaardvoorbeelden van beveiligingsmiddelen geven waarvan de logverzending moet worden ingesteld:
- Alle middelen voor NGFW (Check Point, Fortinet);
- Alle kwetsbaarheidsscan-tools (PT Scanner, OpenVas);
- Web Application Firewall (PT AF);
- Netflow-analyseapparaten (Flowmon, Cisco StealthWatch);
- AD-server.
Nadat we de verzending van logs en configuratiebestanden naar Logstash hebben ingesteld, kunnen we deze correleren en vergelijken met de incidenten die uit verschillende beveiligingsmiddelen komen. Hiervoor is het handig om de indices te gebruiken waarin we alle incidenten met betrekking tot een specifiek apparaat opslaan. Met andere woorden, één index bevat alle incidenten die betrekking hebben op één apparaat. Deze verdeling kan op 2 manieren worden gerealiseerd.
De eerste optie Dit is om de Logstash-configuratie in te stellen. Hiervoor moet je de logs op bepaalde velden dupliceren naar een aparte eenheid met een ander type. En dan kun je dit type in de toekomst gebruiken. In het voorbeeld worden de logs gekloond volgens de blade van de Check Point firewalls.
filter {
    als [product] == "SmartDefense" {
        clone {
	    clones => ["CloneSmartDefense"]
	    add_field => {"system" => "checkpoint"}
	}
    }
}
Om zulke gebeurtenissen in een aparte index op te slaan, afhankelijk van de logvelden, bijvoorbeeld zoiets als Destination IP van de aanvalssignatuur. Je kunt een dergelijke constructie gebruiken:
output {
    als [type] == "CloneSmartDefense" {
    {
         elasticsearch {
    	 hosts => [",:9200"]
    	 index => "smartdefense-%{dst}"
    	 user => "admin"
    	 password => "password"
  	 }
    }
}
En zo kan de opslag in de index van alle incidenten worden gedaan, bijvoorbeeld op IP-adres of op de domeinnaam van de machine. In dit geval slaan we op in de index «smartdefense-%{dst}», op het IP-adres van de signatuur.
Echter, verschillende producten hebben verschillende velden voor logs, wat zal leiden tot chaos en onnodig geheugenverbruik. En hier moet je ofwel zorgvuldig de velden in de Logstash-configuratie instellen naar de vooraf bedachte velden die voor alle types incidenten hetzelfde zijn, wat ook een moeilijke taak is.
De tweede implementatieoptie is het schrijven van een script of proces dat in real-time verbinding maakt met de Elasticsearch-database, de benodigde incidenten eruit haalt en ze al in een nieuwe index opslaat. Dit is een zware taak, maar het stelt je in staat om met logs te werken zoals je wilt en direct te correlateren met incidenten van andere beveiligingsmiddelen. Deze optie maakt het mogelijk om logwerken zo nuttig mogelijk voor jouw geval in te stellen met maximale flexibiliteit, maar hier ontstaat het probleem om een specialist te vinden die dit kan realiseren.
En natuurlijk is de belangrijkste vraag, wat kan er eigenlijk gecorreleerd en ontdekt worden.?
Hier kunnen verschillende opties zijn, en het hangt ervan af welke beveiligingsmiddelen in jouw infrastructuur worden gebruikt, een paar voorbeelden:
- De meest voor de hand liggende en voor mijn gevoel de meest interessante optie voor degenen die NGFW-oplossingen en kwetsbaarheidsscanprogramma's hebben, is het vergelijken van logs van IPS en de resultaten van kwetsbaarheidsscans. Als er een aanval is gedetecteerd (en niet geblokkeerd) door het IPS-systeem, en deze kwetsbaarheid niet is verholpen op de eindmachine op basis van de scanresultaten — dan moet er alarm geslagen worden, aangezien de kans groot is dat de kwetsbaarheid is geëxploiteerd.
- Veel inlogpogingen van één machine naar verschillende locaties kunnen wijzen op kwaadwillende activiteiten.
- Het downloaden van virale bestanden door een gebruiker door het bezoeken van een groot aantal potentieel gevaarlijke websites.
Statistiek en visualisering
De meest voor de hand liggende en begrijpelijke reden voor het gebruik van de ELK Stack is het opslaan en visualiseren van logs. is getoond hoe logs van verschillende apparaten kunnen worden verzameld met behulp van Logstash. Nadat de logs naar Elasticsearch zijn gestuurd, kunnen er dashboards worden ingesteld, die ook eerder zijn genoemd , met de informatie en statistieken die u nodig heeft via visualisatie.
Voorbeelden:
- Dashboard voor Threat Prevention-gebeurtenissen met de meest kritieke voorvallen. Hier kan worden weergegeven welke IPS-handtekeningen zijn gedetecteerd en waar ze geografisch vandaan komen.
- Dashboard voor het gebruik van de meest kritische applicaties waarvoor informatie kan lekken.
- Scanresultaten van elke beveiligingsscanner.
- Logs van Active Directory per gebruiker.
- Dashboard voor VPN-verbindingen.
In dit geval, als de dashboards zijn ingesteld om elke paar seconden te vernieuwen, kan er een behoorlijk handige systeem voor realtime gebeurtenismonitoring worden verkregen, dat verder kan worden gebruikt voor een snellere reactie op beveiligingsincidenten, als de dashboards op een apart scherm worden geplaatst.
Prioritering van incidenten
In een grote infrastructuur kunnen het aantal incidenten overweldigend zijn, en specialisten kunnen niet op tijd alle incidenten rustig verwerken. In dit geval is het noodzakelijk om eerst alleen die incidenten te identificeren die een grote bedreiging vormen. Het systeem moet daarom incidenten prioriteren op basis van hun gevaar voor uw infrastructuur. Het is raadzaam om een waarschuwing in de e-mail of Telegram voor deze gebeurtenissen in te stellen. Prioritering kan worden gerealiseerd met de standaardtools van Kibana door visualisatie aan te passen. Maar het instellen van waarschuwingen is moeilijker; standaard is deze functionaliteit niet opgenomen in de basisversie van Elasticsearch, alleen in de betaalde versie. Dus ofwel de betaalde versie kopen, of opnieuw zelf een proces schrijven dat specialisten in real-time op de hoogte stelt via e-mail of Telegram.
Automatisering van beveiligingsprocessen
En een van de interessantste onderdelen is de automatisering van acties bij beveiligingsincidenten. Eerder hebben we deze functionaliteit geïmplementeerd voor Splunk, iets uitgebreider kunt u daarover lezen in deze . Het belangrijkste idee is dat het IPS-beleid nooit wordt gecontroleerd of geoptimaliseerd, terwijl het in sommige gevallen een cruciaal onderdeel is van de processen rond informatiebeveiliging. Bijvoorbeeld, een jaar na de implementatie van NGFW en zonder optimalisatiemaatregelen, heeft u een groot aantal handtekeningen met de actie Detect, die niet worden geblokkeerd, wat de beveiligingstoestand in de organisatie aanzienlijk vermindert. Hieronder enkele voorbeelden van wat geautomatiseerd kan worden:
- Het wijzigen van de IPS-handtekening van Detect naar Prevent. Als voor kritische handtekeningen de Prevent-actie niet werkt, dan is dat niet goed en een ernstige zwakte in het beveiligingssysteem. We wijzigen de actie in het beleid voor dergelijke handtekeningen. Deze functionaliteit kan worden gerealiseerd als het NGFW-apparaat beschikt over REST API-functionaliteit. Dit is mogelijk alleen met programmeervaardigheden; informatie moet uit Elasticsearch worden gehaald en API-aanroepen naar de beheerserver van de NGFW worden uitgevoerd.
- Als er vanuit één IP-adres in het netwerkverkeer veel handtekeningen zijn gedetecteerd of geblokkeerd, is het zinvol om dat IP-adres tijdelijk in de Firewall-beleid te blokkeren. De realisatie bestaat ook uit het gebruik van de REST API.
- Voer een hostcontrole uit met een kwetsbaarheidsscanner als deze host een groot aantal handtekeningen heeft volgens IPS of andere beveiligingsmiddelen. Als het OpenVas betreft, kunt u een script schrijven dat via SSH verbinding maakt met de beveiligingsscanner en het scannen start.
TS Total Sight
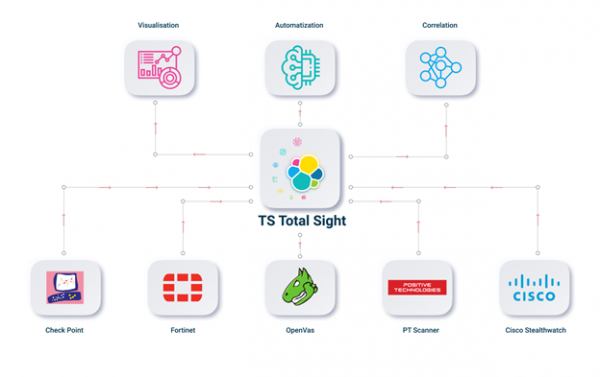
Het implementeren van alle functionaliteit is een zeer grote en zware taak. Zonder programmeervaardigheden kunt u de minimale functionaliteit instellen, die misschien voldoende is voor gebruik in productie. Maar als u geïnteresseerd bent in de volledige functionaliteit, kunt u kijken naar TS Total Sight. U kunt meer gedetailleerde informatie vinden op onze . Als resultaat zal het hele schema van werking en architectuur er ongeveer zo uitzien:
Conclusie
We hebben bekeken wat er mogelijk is met de ELK Stack. In toekomstige artikelen zullen we de functionaliteit van TS Total Sight uitgebreider bespreken!
Dus houd de updates in de gaten (, , , ), .
Bron: habr.com
