

Een kleine inleiding
Ik geloof dat we veel meer kunnen bereiken als we stap-voor-stap instructies krijgen die ons zeggen wat we moeten doen en hoe we het moeten doen. Ik herinner me ook momenten in mijn leven waar ik niet kon beginnen aan iets omdat het gewoon moeilijk te begrijpen was waar te beginnen. Misschien heb je ooit het woord 'Data Science' op internet gezien en dacht je dat dit ver van je bed was, terwijl mensen die hiermee bezig zijn hier vlakbij zijn. En misschien ben je dankzij mensen uit dit vakgebied op dit artikel gestuit. Er zijn veel cursussen die je kunnen helpen om dit vak te leren, en hier zal ik je helpen om je eerste stap te zetten.
Ben je er klaar voor? Ik zeg het meteen: je moet Python 3 kennen, want dat ga ik hier gebruiken. Daarnaast raad ik aan om van tevoren Jupyter Notebook te installeren of te bekijken hoe je Google Colab kunt gebruiken.
Stap één
Kaggle is een belangrijke hulp voor dit doel. In principe kun je zonder, maar daarover zal ik in een ander artikel spreken. Het is een platform waar wedstrijden in Data Science plaatsvinden. In elk van deze wedstrijden zul je in het begin een enorme hoeveelheid ervaring opdoen in het oplossen van verschillende soorten problemen, in ontwikkeling en in teamwork, wat tegenwoordig erg belangrijk is.
We nemen onze taak daarvandaan. Deze heet: 'Titanic'. De uitdaging is als volgt: voorspel of elke afzonderlijke persoon zal overleven. Over het algemeen bestaat de taak van iemand die zich met DS bezighoudt uit het verzamelen van gegevens, deze verwerken, een model trainen, voorspellen, enzovoort. Op Kaggle kunnen we de gegevensverzameling overslaan - ze zijn beschikbaar op het platform. We moeten ze downloaden en we kunnen aan de slag!
Dit kan op de volgende manier:
in het tabblad Data bevinden zich de bestanden met de gegevens


Gegevens gedownload, onze Jupyter-notities voorbereid en…
Stap twee
Hoe kunnen we deze gegevens nu laden?
Ten eerste importeren we de benodigde bibliotheken:
import pandas as pd
import numpy as np
Pandas stelt ons in staat om .csv-bestanden te laden voor verdere verwerking.
Numpy is nodig om onze gegevens in een matrix met getallen weer te geven.
Laten we verder gaan. Laten we het bestand train.csv nemen en het laden:
dataset = pd.read_csv('train.csv')
We zullen naar onze sample train.csv gegevens verwijzen via de variabele dataset. Laten we eens kijken wat daar staat:
dataset.head()
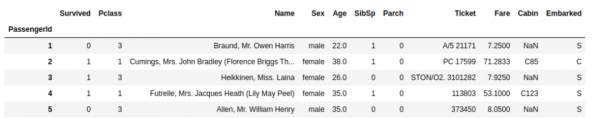
De functie head() stelt ons in staat om de eerste paar rijen van de DataFrame te bekijken.
De kolom Survived zijn namelijk onze resultaten die in deze DataFrame bekent zijn. Wat betreft de taak moeten we de kolom Survived voorspellen voor de gegevens in test.csv. In deze gegevens is informatie opgeslagen over andere passagiers van de Titanic, voor wie de uitkomsten ons onbekend zijn.
Laten we onze tabel dus splitsen in afhankelijke en onafhankelijke gegevens. Dit is eenvoudig. Afhankelijke gegevens zijn die gegevens die afhankelijk zijn van onafhankelijke, dat wil zeggen wat in de uitkomsten staat. Onafhankelijke gegevens zijn de gegevens die invloed hebben op de uitkomst.
Bijvoorbeeld, we hebben zo'n dataset:
“Vova heeft informatica geleerd — nee.
Vova kreeg een 2 voor informatica.”
De beoordeling voor informatica hangt af van het antwoord op de vraag: heeft Vova informatica geleerd? Begrijp je? Laten we verdergaan, we zijn al dichterbij het doel!
De traditionele variabele voor onafhankelijke gegevens is X. Voor afhankelijke is het y.
We doen het volgende:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Wat is dit? Met de functie iloc[:, 2:] zeggen we tegen Python: ik wil de gegevens in variabele X zien, beginnend vanaf de tweede kolom (inclusief, met de veronderstelling dat telling begint bij nul). In de tweede regel zeggen we dat we in y de gegevens van de eerste kolom willen zien.
[ a:b, c:d ] — dit is de constructie die we in haakjes gebruiken. Als we bepaalde variabelen niet opgeven, worden ze als standaardwaarden behouden. We kunnen bijvoorbeeld [:,: d] aangeven en dan krijgen we in de DataFrame alle kolommen, behalve die welke beginnen bij nummer d en verder. De variabelen a en b bepalen de rijen, maar we hebben ze allemaal nodig, dus laten we dit als standaard behouden.
Laten we eens kijken wat we hebben gekregen:
X.head() 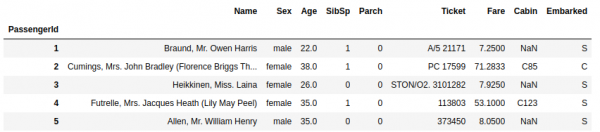
y.head() 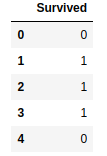
Om deze kleine les te vereenvoudigen, verwijderen we de kolommen die speciale 'zorg' vereisen, of die helemaal geen invloed hebben op overleving. Deze bevatten gegevens van het type str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Geweldig! Laten we naar de volgende stap gaan.
Stap drie
Hier moeten we onze gegevens coderen, zodat de machine beter begrijpt hoe deze gegevens de uitkomst beïnvloeden. Maar we coderen niet alles, alleen de str-gegevens die we hebben achtergelaten. De kolom 'Geslacht'. Hoe willen we dit coderen? Laten we de geslachtsinformatie van een persoon voorstellen als een vector: 10 - mannelijk, 01 - vrouwelijk.
Laten we als eerste onze tabellen omzetten in een NumPy-matrix:
X = np.array(X)
y = np.array(y)
En nu kijken we:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
De sklearn-bibliotheek is zo'n geweldige bibliotheek die ons in staat stelt om volledige taken in Data Science uit te voeren. Het bevat een groot aantal interessante machine learning-modellen en stelt ons ook in staat om gegevens voor te bereiden.
OneHotEncoder zal ons in staat stellen om het geslacht van een persoon te coderen op de manier zoals we hebben beschreven. Er zullen 2 klassen worden gemaakt: mannelijk en vrouwelijk. Als de persoon een man is, wordt er een 1 in de 'mannelijk' kolom geschreven, en een 0 in de 'vrouwelijk' kolom.
Na OneHotEncoder() staat [1] - dit betekent dat we kolom nummer 1 (geteld vanaf nul) willen coderen.
Super. Laten we verder gaan!
Het komt vaak voor dat sommige gegevens niet zijn ingevuld (d.w.z. NaN - not a number). Bijvoorbeeld, er is informatie over een persoon: zijn naam en geslacht. Maar er ontbreken gegevens over zijn leeftijd. In dat geval passen we een methode toe: we berekenen het gemiddelde van alle kolommen en vullen de lege plekken in met het gemiddelde.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Laten we nu rekening houden met het feit dat er situaties zijn waarin gegevens sterk verspreid zijn. Sommige gegevens liggen in het bereik [0:1], terwijl andere in de honderden of duizenden kunnen komen. Om zulke spreiding uit te sluiten en ervoor te zorgen dat de computer nauwkeuriger rekent, zullen we de gegevens schalen, schalen. Laten we ervoor zorgen dat alle getallen niet boven de drie uitkomen. Hiervoor gebruiken we de functie StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Nu zien onze gegevens er zo uit:

Geweldig. We zijn al dichtbij ons doel!
Stap vier
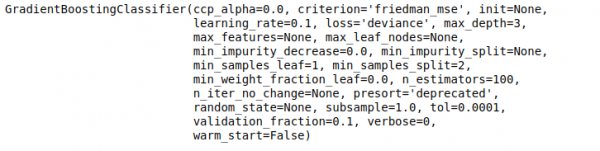
Laten we ons eerste model trainen! In de sklearn-bibliotheek kunnen we een enorme hoeveelheid interessante tools vinden. Voor deze taak heb ik het Gradient Boosting Classifier-model toegepast. We gebruiken een classifier, omdat onze taak een classificatieprobleem is. We moeten een voorspelling maken of het resultaat 1 (overleefd) of 0 (niet overleefd) is.
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
De fit-functie zegt tegen Python: Laat het model de afhankelijkheden tussen X en y zoeken.
Minder dan een seconde en het model is klaar.
Hoe gaan we het toepassen? Dat zullen we nu zien!
Stap vijf. Conclusie
Nu moeten we de tabel met onze testgegevens laden, waarvoor we een voorspelling moeten maken. We zullen met deze tabel dezelfde stappen doorlopen als we met X deden.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Laten we ons model toepassen!
gbc_predict = gbc.predict(X_test)
Dat is alles. We hebben een voorspelling gedaan. Nu moeten we dit in een csv-bestand opslaan en naar de website sturen.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Klaar. We hebben een bestand ontvangen met daarin de voorspellingen voor elke passagier. Het enige wat nog rest, is deze oplossingen op de website te uploaden en de nauwkeurigheid van de voorspelling te beoordelen. Deze eenvoudige oplossing levert niet alleen 74% nauwkeurigheid in de openbare ruimte op, maar geeft ook een bepaalde impuls in Data Science. De meest nieuwsgierigen kunnen op elk moment een persoonlijk bericht sturen en een vraag stellen. Bedankt allemaal!
Bron: habr.com
