

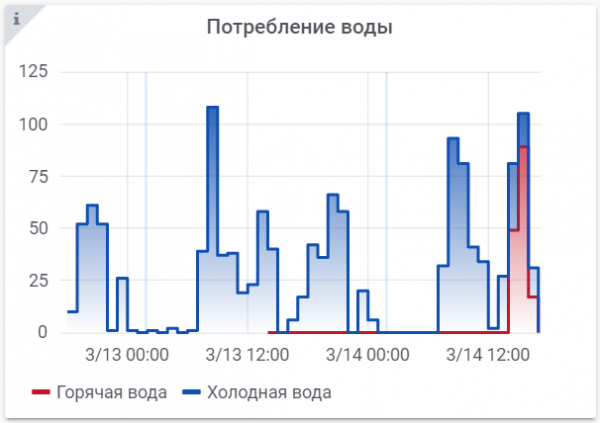
Iedere keer als ik de rekening voor elektriciteit en water ontvang, vraag ik me af – verbruikt mijn gezin écht zo veel? Natuurlijk, er is vloerverwarming en een boiler in de badkamer, maar die draaien toch niet constant. We proberen ook water te besparen (hoewel we het ook leuk vinden om in bad te relaxen). Enkele jaren geleden heb ik al en op het slimme huis, maar sindsdien is het daarmee stil blijven staan. Het analyseren van het verbruik is pas nu aan de orde gekomen, waar deze artikel over gaat.
Onlangs ben ik overgestapt op Home Assistant als slim huis systeem. Een van de redenen was juist de mogelijkheid om een grote hoeveelheid data te verzamelen met de optie om verschillende soorten grafieken eenvoudig op te stellen.
De informatie die in dit artikel wordt beschreven is niet nieuw, al deze zaken zijn al op verschillende manieren op internet behandeld. Maar elke artikel beschrijft meestal slechts één benadering of aspect. Het vergelijken van al deze benaderingen en het kiezen van de meest geschikte was aan mij. Het artikel biedt geen uitputtende informatie over dataverzameling, maar is een soort samenvatting van hoe ik het heb gedaan. Constructieve kritiek en suggesties voor verbetering zijn welkom.
Taakstelling
Dus, het doel van de vandaag oefening is om mooie grafieken van water- en elektriciteitsverbruik te krijgen:
- Uurgegevens over 2 dagen
- Daggegevens over 2 weken
- (optioneel) week- en maandgegevens
Daarin schuilt enige moeilijkheid:
- Standaard grafiekcomponenten zijn meestal behoorlijk beperkt. In het beste geval kan je een lijngrafiek opbouwen met punten.
Als je goed zoekt, kun je externe componenten vinden die de mogelijkheden van standaard grafieken uitbreiden. Voor Home Assistant is de component , maar ook deze is enigszins beperkt:
- Het is moeilijk om de parameters van een kolomgrafiek in te stellen over lange intervallen (de breedte van de kolom wordt ingesteld in fracties van een uur, wat betekent dat intervallen langer dan een uur in decimalen moeten worden ingesteld)
- Je kunt geen verschillende entiteiten op één grafiek toevoegen (bijvoorbeeld temperatuur en luchtvochtigheid, of een kolomgrafiek combineren met een lijn)
- Niet alleen gebruikt Home Assistant standaard een zeer primitieve SQLite-database (en ik, met mijn klunzige vaardigheden, kon MySQL of Postgres niet installeren), maar de gegevens worden ook niet op de meest optimale manier opgeslagen. Zo wordt bijvoorbeeld bij elke wijziging van zelfs de kleinste digitale parameter een enorme JSON van ongeveer een kilobyte in de database opgeslagen.
{"entity_id": "sensor.water_cold_hourly", "old_state": {"entity_id": "sensor.water_cold_hourly", "state": "3", "attributes": {"source": "sensor.water_meter_cold", "status": "collecting", "last_period": "29", "last_reset": "2020-02-23T21:00:00.022246+02:00", "meter_period": "hourly", "unit_of_measurement": "l", "friendly_name": "water_cold_hourly", "icon": "mdi:counter"}, "last_changed": "2020-02-23T19:05:06.897604+00:00", "last_updated": "2020-02-23T19:05:06.897604+00:00", "context": {"id": "aafc8ca305ba4e49ad4c97f0eddd8893", "parent_id": null, "user_id": null}}, "new_state": {"entity_id": "sensor.water_cold_hourly", "state": "4", "attributes": {"source": "sensor.water_meter_cold", "status": "collecting", "last_period": "29", "last_reset": "2020-02-23T21:00:00.022246+02:00", "meter_period": "hourly", "unit_of_measurement": "l", "friendly_name": "water_cold_hourly", "icon": "mdi:counter"}, "last_changed": "2020-02-23T19:11:11.251545+00:00", "last_updated": "2020-02-23T19:11:11.251545+00:00", "context": {"id": "0de64b8af6f14bb9a419dcf3b200ef56", "parent_id": null, "user_id": null}}}Ik heb best veel sensoren (temperatuursensoren in elke kamer, water- en elektriciteitsmeters), en sommige daarvan genereren behoorlijk veel gegevens. Zo genereert alleen de elektriciteitsmeter SDM220 ongeveer een tiental waarden elke 10-15 seconden, en van zulke meters zou ik er graag acht willen installeren. Daarnaast zijn er een heleboel parameters die op basis van andere sensoren worden berekend. Al deze waarden kunnen de database gemakkelijk dagelijks met 100-200 MB laten groeien. Na een week zal het systeem nauwelijks meer functioneren, en na een maand zal de flash-geheugenkaart (in het geval van een typische installatie van Home Assistant op een Raspberry Pi) kapot zijn, laat staan dat er een jaar aan gegevens kan worden opgeslagen.
- Als je geluk hebt, kan je meter zelf het verbruik bijhouden. Je kunt op elk moment de meter raadplegen en vragen naar de cumulatieve waarde van het verbruik. Over het algemeen bieden alle elektriciteitsmeters met een digitale interface (RS232/RS485/Modbus/Zigbee) deze mogelijkheid.
Slechter is het als het apparaat gewoon een bepaalde onmiddellijke parameter kan meten (zoals onmiddellijke kracht of stroom), of gewoon impulsen kan genereren elke X watt-uur of liters. Dan moet je nadenken over hoe en waarmee je dit kunt integreren en waar je de waarde kunt opslaan. Er is een risico om een rapport te missen om welke reden dan ook, en de nauwkeurigheid van het systeem als geheel roept vragen op. Natuurlijk kan je dit allemaal toevertrouwen aan een smart home-systeem zoals Home Assistant, maar het punt over het aantal records in de database is niet komen te vervallen, en het is niet mogelijk om de sensoren vaker dan één keer per seconde uit te lezen (beperkingen van de architectuur van Home Assistant).
Aanpak 1
Laten we eerst kijken wat Home Assistant standaard biedt. Het meten van het verbruik over een periode is een zeer gewilde functionaliteit. Uiteraard is dit al lang geleden gerealiseerd in de vorm van een gespecialiseerde component: utility_meter.
De essentie van de component is dat deze intern een variabele current_accumulated_value introduceert, die wordt gereset na afloop van de opgegeven periode (uur/week/maand). De component monitort zelf de inkomende variabele (de waarde van een bepaalde sensor), abonneert zich op waarde wijzigingen — jij ontvangt simpelweg het eindresultaat. Dit wordt beschreven met slechts een paar regels in het configuratiebestand.
utility_meter:
  water_cold_hour_um:
    source: sensor.water_meter_cold
    cycle: hourly
  water_cold_day_um:
    source: sensor.water_meter_cold
    cycle: daily
Hier is sensor.water_meter_cold de huidige waarde van de meter in liters, die ik ontvang via MQTT. De constructie creëert 2 nieuwe sensoren water_cold_hour_um en water_cold_day_um, die uurlijks en dagelijks demetingen accumuleren en deze resetten na afloop van de periode. Hier is de grafiek van de uurlijk accumulator voor een halve dag.
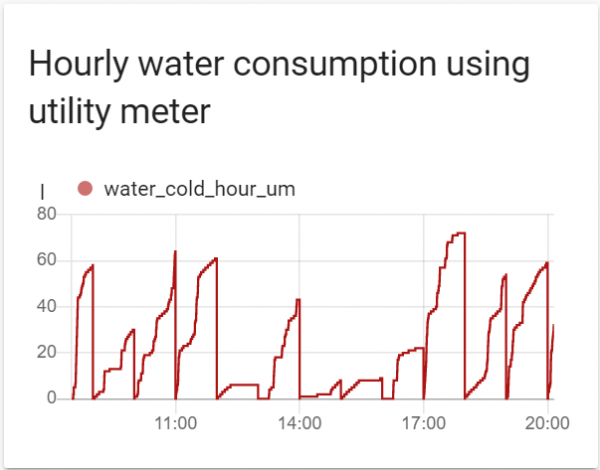
De code voor de uur- en daggrafieken voor de Lovelace-UI ziet er als volgt uit:
      - type: history-graph
        title: 'Uurlijkse waterconsumptie met behulp van variabelen'
        hours_to_show: 48
        entities:
          - sensor.water_hour

      - type: history-graph
        title: 'Dagelijkse waterconsumptie met behulp van variabelen'
        hours_to_show: 360
        entities:
          - sensor.water_day
Eigenlijk ligt het probleem van deze aanpak in dit algoritme. Zoals ik al eerder zei, wordt voor elke binnenkomende waarde (de huidige meterstand voor elke volgende liter) 1 KB aan gegevens in de database gegenereerd. Elke utility meter genereert ook een nieuwe waarde die in de database wordt opgeslagen. Als ik uurlijks/dagelijks/weekelijks/maandelijks gegevens wil verzamelen, en ook nog eens voor meerdere waterleidingen, plus een aantal elektriciteitsmeters wil toevoegen - dan wordt dit een enorme hoeveelheid gegevens. Data is misschien niet veel, maar omdat de home assistant veel overbodige informatie in de database schrijft, zal de databasegrootte exponentieel toenemen. Ik durf zelfs niet te schatten hoe groot de database zou zijn voor wekelijkse en maandelijkse grafieken.
Bovendien lost de utility meter op zich de gestelde taak niet op. De grafiek van waarden die de utility meter biedt is een monotonisch toenemende functie die elke uur op 0 wordt gezet. We hebben een begrijpelijke grafiek nodig voor de gebruiker, hoeveel liters er zijn verbruikt in een bepaalde periode. De standaard component history-graph kan dat niet, maar de externe component mini-graph-card kan ons helpen.
Dit is de code voor de kaart in lovelace-UI:
      - aggregate_func: max
        entities:
          - color: var(--primary-color)
            entity: sensor.water_cold_hour_um
        group_by: hour
        hours_to_show: 48
        name: "Uurlijks waterverbruik geaggregeerd door utility meter"
        points_per_hour: 1
        show:
          graph: bar
        type: 'custom:mini-graph-card'
Naast de standaardinstellingen zoals de naam van de sensor, het type grafiek en de kleur (de standaard oranje vond ik niet leuk) is het belangrijk om 3 instellingen op te merken:
- group_by:hour — de grafiek wordt gegenereerd met uitlijning van de balken aan het begin van het uur
- points_per_hour: 1 — één balk per uur
- En het belangrijkste, aggregate_func: max — neem de maximale waarde binnen elk uur. Deze parameter transformeert de zaagtandgrafiek in balken.
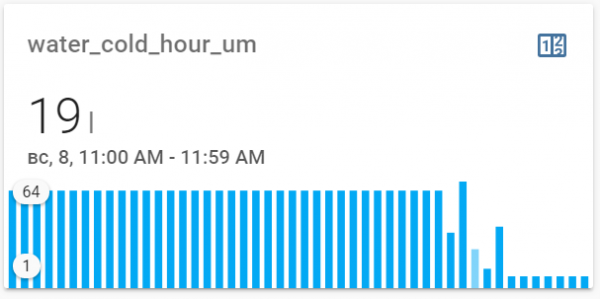
Let niet op de reeks balken aan de linkerkant — dit is het standaardgedrag van de component als er geen gegevens zijn. En er waren geen gegevens — ik heb pas een paar uur geleden het verzamelen van gegevens via de utility meter geactiveerd, alleen voor dit artikel (mijn huidige aanpak zal ik iets lager toelichten).
In deze afbeelding wilde ik laten zien dat het weergeven van gegevens soms zelfs goed werkt en de kolommen daadwerkelijk de juiste waarden weerspiegelen. Maar niet alles. De gemarkeerde kolom voor de periode van 11 uur tot 12 uur geeft om een of andere reden 19 liter weer, terwijl we op de steile grafiek hierboven voor dezelfde periode van dezelfde sensor een verbruik van 62 liter zien. Of het is een bug, of het is slecht gedaan. Waarom de gegevens aan de rechterkant ontbreken, begrijp ik tot nu toe niet — het verbruik daar was normaal, wat ook zichtbaar is op de steile grafiek.
Over het geheel genomen is het me niet gelukt om geloofwaardigheid met deze aanpak te bereiken — de grafiek toont bijna altijd onzin.
Vergelijkbare code voor de dag-sensor.
      - aggregate_func: max
        entities:
          - color: var(--primary-color)
            entity: sensor.water_cold_day_um
        group_by: interval
        hours_to_show: 360
        name: "Dagelijks waterverbruik samengevoegd per utility meter"
        points_per_hour: 0.0416666666
        show:
          graph: bar
        type: 'custom:mini-graph-card'
Let op dat de parameter group_by is ingesteld op interval, en dat alles wordt aangestuurd door de parameter points_per_hour. Dit is ook een ander probleem van deze component — points_per_hour werkt goed op grafieken voor een uur of minder, maar verschrikkelijk voor grotere tijdsintervallen. Om dus één kolom voor één dag te krijgen, moest ik de waarde 1/24=0.04166666 invullen. Ik zeg al niet eens iets over wekelijkse en maandelijkse grafieken.
Aanpak 2
Terwijl ik me nog aan het verdiepen was in Home Assistant, kwam ik deze video tegen:
Een vriend verzamelt verbruiksgegevens van verschillende soorten Xiaomi-stopcontacten. Zijn taak is iets eenvoudiger — gewoon de verbruikwaarde van vandaag, gisteren en voor de maand tonen. Er zijn geen grafieken nodig.
Laten we de overpeinzingen over het handmatig integreren van onmiddellijke vermogenswaarden even terzijde schuiven — over de 'nauwkeurigheid' van deze aanpak heb ik hierboven al geschreven. Het is onduidelijk waarom hij geen gebruik heeft gemaakt van de accumulatieve verbruikwaarden die al door hetzelfde stopcontact worden verzameld. Naar mijn mening zal integreren binnen de hardware beter functioneren.
Van de video nemen we het idee van handmatige berekening van het verbruik over een periode over. De man berekent alleen de waarden van vandaag en gisteren, maar wij gaan verder en proberen een grafiek te maken. De essentie van de voorgestelde methode in mijn geval is als volgt.
We definiëren de variabele waarde_begin_uur, waarin we de huidige meterstand opslaan.
Aan het einde van het uur (of aan het begin van het volgende) berekenen we het verschil tussen de huidige waarde en de waarde die aan het begin van het uur is opgeslagen. Dit verschil is het verbruik voor het huidige uur — we slaan de waarde op in de sensor, en in de toekomst zullen we op basis van deze waarde een grafiek opbouwen.
We moeten ook de variabele waarde_begin_uur 'resetten' door daar de huidige waarde van de teller in te schrijven.
Dit kan allemaal via de middelen van Home Assistant zelf gedaan worden.
Er moet iets meer code geschreven worden dan in de vorige aanpak. Laten we beginnen met het aanmaken van deze 'variabelen'. Standaard hebben we geen entiteit 'variabele', maar we kunnen de diensten van de MQTT-broker gebruiken. We zullen waarden verzenden met de vlag retain=true — dit behoudt de waarde binnen de broker, en je kunt deze op elk moment eruit halen, zelfs bij een herstart van Home Assistant. Ik heb meteen uurlijkse en dagelijkse tellers gemaakt.
- platform: mqtt
  state_topic: "test/water/hour"
  name: water_hour
  unit_of_measurement: l

- platform: mqtt
  state_topic: "test/water/hour_begin"
  name: water_hour_begin
  unit_of_measurement: l

- platform: mqtt
  state_topic: "test/water/day"
  name: water_day
  unit_of_measurement: l

- platform: mqtt
  state_topic: "test/water/day_begin"
  name: water_day_begin
  unit_of_measurement: l
De hele magie gebeurt in de automatisering, die elk uur en elke nacht respectievelijk wordt uitgevoerd.
- id: water_new_hour
  alias: water_new_hour
  initial_state: true
  trigger:
    - platform: time_pattern
      minutes: 0
  action:
    - service: mqtt.publish
      data:
        topic: "test/water/hour"
        payload_template: >
          {{ (states.sensor.water_meter_cold.state|int) - (states.sensor.water_hour_begin.state|int) }}
        retain: true
    - service: mqtt.publish
      data:
        topic: "test/water/hour_begin"
        payload_template: >
          {{ states.sensor.water_meter_cold.state }}
        retain: true

- id: water_new_day
  alias: water_new_day
  initial_state: true
  trigger:
    - platform: time
      at: "00:00:00"
  action:
    - service: mqtt.publish
      data:
        topic: "test/water/day"
        payload_template: >
          {{ (states.sensor.water_meter_cold.state|int) - (states.sensor.water_day_begin.state|int) }}
        retain: true
    - service: mqtt.publish
      data:
        topic: "test/water/day_begin"
        payload_template: >
          {{ states.sensor.water_meter_cold.state }}
        retain: true
Beide automatiseringen voeren 2 acties uit:
- Berekenen de waarde voor het interval als het verschil tussen de begin- en eindwaarde
- Bijwerken van de basiswaarde voor het volgende interval
Het opbouwen van grafieken wordt in dit geval opgelost door een gewone history-graph:
      - type: history-graph
        title: 'Uurlijkse waterconsumptie met behulp van variabelen'
        hours_to_show: 48
        entities:
          - sensor.water_hour

      - type: history-graph
        title: 'Dagelijkse waterconsumptie met behulp van variabelen'
        hours_to_show: 360
        entities:
          - sensor.water_day
Het ziet er zo uit:
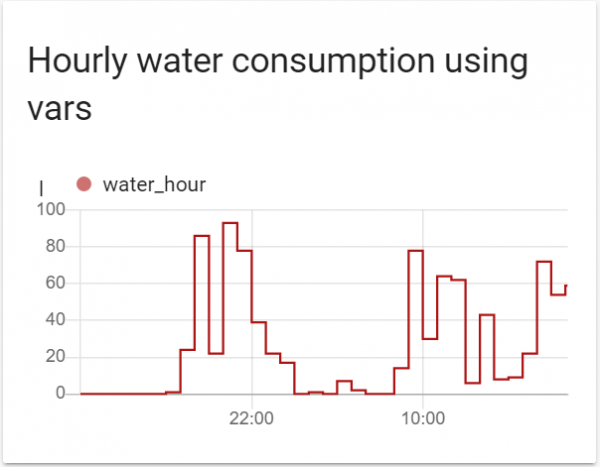
In principe is dit al wat nodig is. Een voordeel van deze methode is dat de gegevens één keer per interval worden gegenereerd. Dat wil zeggen, in totaal 24 records per dag voor de uurlijke grafiek.
Helaas lost het de algemene kwestie van de groeiende database nog steeds niet op. Als ik een grafiek van het maandelijkse verbruik wil, moet ik de gegevens minstens een jaar opslaan. Aangezien Home Assistant slechts één opslagduurinstelling voor de hele database biedt, betekent dit dat ALLE gegevens in het systeem een heel jaar moeten worden opgeslagen. Bijvoorbeeld, in een jaar verbruik ik 200 kubieke meter water, wat betekent dat er 200.000 records in de database komen. En als we ook andere sensoren meerekenen, wordt het cijfer werkelijk onfatsoenlijk.
Benadering 3
Gelukkig hebben slimme mensen dit probleem al opgelost door de database InfluxDB te schrijven. Deze database is speciaal geoptimaliseerd voor het opslaan van tijdgebonden gegevens en is ideaal voor het opslaan van waarden van verschillende sensoren. Het systeem biedt ook een SQL-achtige querytaal waarmee je waarden uit de database kunt halen en ze op verschillende manieren kunt aggregeren. Ten slotte kunnen verschillende gegevens verschillende opslagtijden hebben. Bijvoorbeeld, vaak veranderende waarden zoals temperatuur of luchtvochtigheid kunnen slechts een paar weken worden opgeslagen, terwijl dagelijkse waterverbruiksgegevens een jaar kunnen worden bewaard.
Naast InfluxDB hebben slimme mensen ook Grafana uitgevonden - een systeem voor het tekenen van grafieken met gegevens uit InfluxDB. Grafana kan verschillende soorten grafieken tekenen, deze gedetailleerd aanpassen en, het belangrijkste, deze grafieken kunnen worden “ingestoken” in de Lovelace-interface van Home Assistant.
Inspireren en . De artikelen beschrijven uitvoerig het installatieproces en de koppeling van InfluxDB en Grafana aan Home Assistant. Ik zal me echter richten op het oplossen van mijn specifieke probleem.
Laten we dus eerst beginnen met het opslaan van de waarden van de meter in InfluxDB. Een stuk configuratie van Home Assistant (in dit voorbeeld ga ik me zowel met koud als met warm water vermaken):
influxdb:
  host: localhost
  max_retries: 3
  default_measurement: state
  database: homeassistant
  include:
    entities:
      - sensor.water_meter_hot
      - sensor.water_meter_cold
We schakelen het opslaan van deze gegevens in de interne database van Home Assistant uit om deze niet onnodig op te blazen:
recorder:
  purge_keep_days: 10
  purge_interval: 1
  exclude:
    entities:
      - sensor.water_meter_hot
      - sensor.water_meter_cold
Laten we nu naar de InfluxDB-console gaan en onze database instellen. We moeten namelijk bepalen hoe lang bepaalde gegevens bewaard moeten blijven. Dit wordt geregeld door de zogenaamde retention policy — dit is vergelijkbaar met databases binnen de hoofd-database, waarbij elke interne database zijn eigen instellingen heeft. Standaard worden alle gegevens opgeslagen in de retention policy genaamd autogen, en deze gegevens worden een week bewaard. Ik zou willen dat de uurgegevens een maand worden bewaard, wekelijkse gegevens een jaar en maandelijkse gegevens nooit worden verwijderd. Laten we de bijbehorende retention policies creëren.
CREATE RETENTION POLICY "month" ON "homeassistant" DURATION 30d REPLICATION 1
CREATE RETENTION POLICY "year" ON "homeassistant" DURATION 52w REPLICATION 1
CREATE RETENTION POLICY "infinite" ON "homeassistant" DURATION INF REPLICATION 1
Nu, het belangrijkste trucje — de aggregatie van gegevens met behulp van een continuous query. Dit is een mechanisme dat automatisch een query uitvoert op ingestelde tijdsintervallen, de gegevens aggregeert op basis van deze query, en het resultaat in een nieuwe waarde opslaat. Laten we het aan de hand van een voorbeeld bekijken (ik schrijf het met een kolom voor de leesbaarheid, maar in werkelijkheid moest ik deze opdracht als één regel invoeren).
CREATE CONTINUOUS QUERY cq_water_hourly ON homeassistant
BEGIN
  SELECT max(value) AS value
  INTO homeassistant.month.water_meter_hour
  FROM homeassistant.autogen.l
  GROUP BY time(1h), entity_id fill(previous)
END
Deze opdracht:
- Creëert een continuous query met de naam cq_water_cold_hourly in de database homeassistant.
- De query wordt elk uur uitgevoerd (time(1h)).
- De query haalt alle gegevens op uit de measurement homeassistant.autogen.l (liter), inclusief de metingen van koud en warm water.
- Geaggregeerde gegevens worden gegroepeerd op entity_id, wat ons aparte waarden voor koud en warm water oplevert.
- Aangezien de meter in liters een monotoon stijgende reeks is, moet voor elk uur de maximale waarde worden genomen, dus de aggregatie wordt uitgevoerd met de functie max(value).
- De nieuwe waarde wordt opgeslagen in homeassistant.month.water_meter_hour, waarbij month de naam is van de retention policy met een bewaartermijn van een maand. De gegevens voor koud en warm water zullen in aparte records worden verspreid met de bijbehorende entity_id en waarde in het veld value.
S nachts of wanneer er niemand thuis is, is er geen waterverbruik, en dus zijn er ook geen nieuwe records in homeassistant.autogen.l. Om te voorkomen dat er hiaten in de waarden zijn bij reguliere queries kan men fill(previous) gebruiken. Dit zorgt ervoor dat InfluxDB de waarde van het vorige uur gebruikt.
Helaas heeft de continuous query een eigenschap: de truc fill(previous) werkt niet en de records worden eenvoudigweg niet aangemaakt. Dit is een onoverkomelijk probleem dat . We zullen later met dit probleem omgaan, en laat fill(previous) in de continuous query maar staan — het hindert niet.
Laten we controleren wat we hebben gekregen (natuurlijk moeten we een paar uurtjes wachten):
> select * from homeassistant.month.water_meter_hour group by entity_id
...
name: water_meter_hour
tags: entity_id=water_meter_cold
time                 value
----                 -----
...
2020-03-08T01:00:00Z 370511
2020-03-08T02:00:00Z 370513
2020-03-08T05:00:00Z 370527
2020-03-08T06:00:00Z 370605
2020-03-08T07:00:00Z 370635
2020-03-08T08:00:00Z 370699
2020-03-08T09:00:00Z 370761
2020-03-08T10:00:00Z 370767
2020-03-08T11:00:00Z 370810
2020-03-08T12:00:00Z 370818
2020-03-08T13:00:00Z 370827
2020-03-08T14:00:00Z 370849
2020-03-08T15:00:00Z 370921
Let op dat de waarden in de database in UTC worden opgeslagen, daarom verschillen ze in deze lijst met 3 uur — de waarden van 7 uur 's ochtends in de InfluxDB-output komen overeen met de waarden van 10 uur 's ochtends in de grafieken hierboven. Merkt u ook op dat er tussen 2 en 5 uur 's ochtends gewoon geen records zijn — dat is die specifieke eigenschap van continuous query.
Zoals u ziet, is de geaggregeerde waarde ook een monotonisch toenemende volgorde, maar de records komen minder vaak voor — eenmaal per uur. Maar dat is geen probleem — we kunnen een andere query schrijven die de juiste gegevens voor de grafiek haalt.
SELECT difference(max(value))
FROM homeassistant.month.water_meter_hour
WHERE entity_id='water_meter_cold' and time >= now() -24h
GROUP BY time(1h), entity_id
fill(previous)
Ik zal het uitleggen:
- We halen gegevens op uit de database homeassistant.month.water_meter_hour voor entity_id='water_meter_cold' van de afgelopen 24 uur (time >= now() -24h).
- Zoals ik al eerder vermeldde, kunnen er enkele records ontbreken in de reeks homeassistant.month.water_meter_hour. Deze gegevens zullen we opnieuw genereren door de query met GROUP BY time(1h) uit te voeren. Deze keer zal fill(previous) werken zoals het hoort, door ontbrekende gegevens te genereren (de functie neemt de vorige waarde).
- Het belangrijkste in deze query is de functie difference, die het verschil tussen de uurmarkeringen berekent. Op zichzelf werkt deze niet en heeft een aggregatiefunctie nodig. Laten we het max() gebruiken zoals eerder gedaan.
De uitvoer ziet er als volgt uit
name: water_meter_hour
tags: entity_id=water_meter_cold
time                 difference
----                 ----------
...
2020-03-08T02:00:00Z 2
2020-03-08T03:00:00Z 0
2020-03-08T04:00:00Z 0
2020-03-08T05:00:00Z 14
2020-03-08T06:00:00Z 78
2020-03-08T07:00:00Z 30
2020-03-08T08:00:00Z 64
2020-03-08T09:00:00Z 62
2020-03-08T10:00:00Z 6
2020-03-08T11:00:00Z 43
2020-03-08T12:00:00Z 8
2020-03-08T13:00:00Z 9
2020-03-08T14:00:00Z 22
2020-03-08T15:00:00Z 72
Van 2 tot 5 uur 's ochtends (UTC) was er geen verbruik. Desondanks retourneert de aanvraag dezelfde waarde voor verbruik dankzij fill(previous), en de functie difference trekt deze waarde zelf van zichzelf af, waardoor we 0 krijgen, wat eigenlijk vereist is.
Het enige dat nu nog rest is het maken van de grafiek. Hiervoor openen we Grafana, openen een bestaande (of creëren een nieuwe) dashboard, en maken een nieuw paneel aan. De instellingen voor de grafieken zullen als volgt zijn.
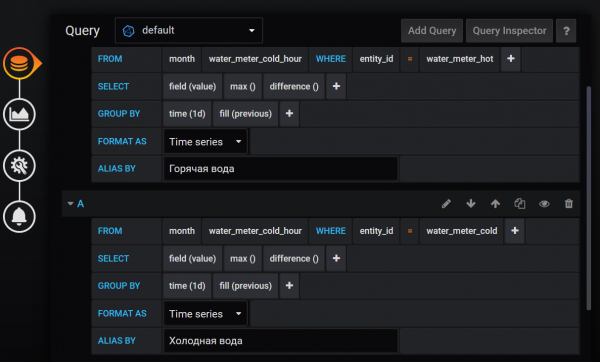
Ik zal de gegevens over koude en warme water op één grafiek weergeven. De aanvraag is precies hetzelfde als ik hierboven heb beschreven.
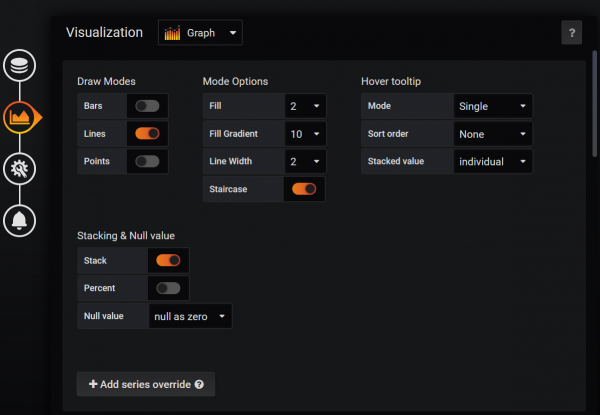
De weergave-instellingen worden als volgt gedefinieerd. Voor mij zal dit een lijngrafiek (lines) zijn, die in stappen loopt (stairs). De parameter Stack zal ik hieronder uitleggen. Er zijn hieronder nog een paar weergaveparameters, maar die zijn niet zo interessant.
Om de verkregen grafiek aan het home assistant toe te voegen, moet je:
- uit de bewerkingsmodus van de grafiek komen. Om de een of andere reden worden de juiste instellingen voor het delen van grafieken alleen aangeboden vanaf de dashboardpagina.
- Klik op de driehoek naast de naam van de grafiek en kies in het menu voor delen.
- Ga in het geopende venster naar het tabblad embed.
- Verwijder het vinkje bij huidige tijdsperiode — de tijdsperiode zullen we via de URL instellen.
- Kies het gewenste thema. In mijn geval is dat licht.
- Kopieer de verkregen URL naar de lovelace-UI instellingskaart.
      - type: iframe
        id: graf_water_hourly
        url: "http://192.168.10.200:3000/d-solo/rZARemQWk/water?orgId=1&panelId=2&from=now-2d&to=now&theme=light"
Let op dat de tijdsperiode (de laatste 2 dagen) hier wordt ingesteld, en niet in de dashboardinstellingen.
De grafiek ziet er als volgt uit. Ik heb het warme water de laatste 2 dagen niet gebruikt, dus er wordt alleen de grafiek van het koude water weergegeven.
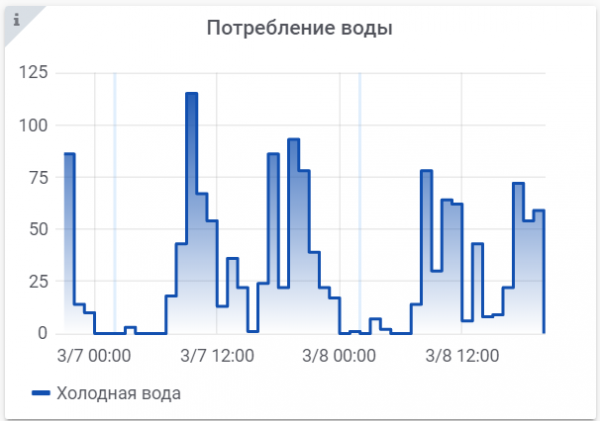
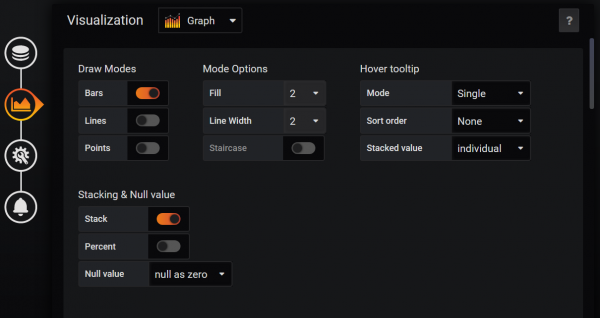
Ik heb nog niet besloten welke grafiek ik leuker vind, de lijn-stap of de echte kolommen. Daarom geef ik gewoon een voorbeeld van een dagelijkse verbruiksgrafiek, maar dit keer in kolommen. De aanvragen worden op dezelfde manier opgebouwd als hierboven beschreven. De weergaveparameters zijn als volgt:
Deze grafiek ziet er zo uit:
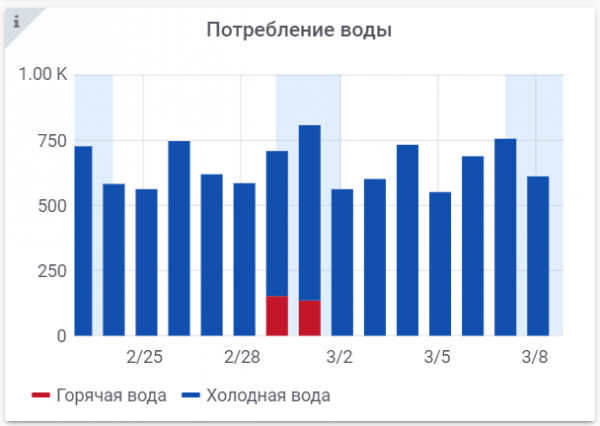
Laten we het nu over de parameter Stack hebben. In deze grafiek wordt de kolom voor koud water bovenop de kolom voor warm water getekend. De totale hoogte komt overeen met het totale verbruik van koud en warm water gedurende de periode.
Alle getoonde grafieken zijn dynamisch. Je kunt met de muis over een interessant punt bewegen en de details en waarde op dat specifieke punt bekijken.
Helaas zijn er zonder een paar tegenslagen geen voordelen. Op de staafgrafiek (in tegenstelling tot de stapgrafiek) ligt het midden van de staaf niet in het midden van de dag, maar om 00:00 uur. Dat wil zeggen, de linkse helft van de staaf is getekend op de plaats van de vorige dag. De grafieken voor zaterdag en zondag zijn dus iets naar links getekend in vergelijking met het blauwe gebied. Tot nu toe heb ik nog geen oplossing gevonden om dit te verhelpen.
Een ander probleem is de onmogelijkheid om correct met maandintervallen te werken. Het punt is dat de duur van een uur/dag/week vast is, maar de lengte van de maand elke keer anders is. InfluxDB kan alleen met gelijke intervallen werken. Tot nu toe heb ik mijn best gedaan om een vast interval van 30 dagen in te stellen. Ja, de grafiek zal gedurende het jaar een beetje verschuiven en de staven zullen niet helemaal overeenkomen met de maanden. Maar omdat ik dit gewoon interessant vind als een soort meter, kan ik daar mee leven.
Ik zie ten minste twee oplossingen:
- Vergeet maandgrafieken en beperk je tot weekgrafieken. 52 weekstaven per jaar zien er best goed uit.
- De maandelijkse consumptie beschouwen als methode nummer 2, en Grafana alleen gebruiken voor mooie grafieken. Dat resulteert in een vrij nauwkeurige oplossing. Je kunt zelfs de grafieken van vorig jaar overlappen voor vergelijking — Grafana kan dat ook.
Conclusie
Ik weet niet waarom, maar ik ben dol op dit soort grafieken. Ze laten zien dat het leven bruisend is en dat alles verandert. Gisteren was er veel, vandaag is er weinig, morgen zal het weer anders zijn. We moeten nog werken met de huisgenoten over het onderwerp consumptie. Maar zelfs met de huidige appetijt verandert simpelweg een grote en onduidelijke cijfer op de rekening al in een vrij duidelijk beeld van het verbruik.
Ondanks bijna 20 jaar carrière als programmeur, heb ik nauwelijks met databases gewerkt. Daarom leek het opzetten van een externe database iets heel ingewikkelds en onduidelijks. Alles veranderde — het bleek dat het aansluiten van de juiste tool in een paar klikken kan, en met een gespecialiseerde tool wordt de taak van het bouwen van grafieken een stuk eenvoudiger.
In de titel heb ik het elektriciteitsverbruik genoemd. Helaas kan ik op dit moment geen enkele grafiek tonen. Eén SDM120 meter is kapot en de andere heeft problemen bij het gebruik van Modbus. Dit beïnvloedt echter de inhoud van dit artikel niet - de grafieken zullen op dezelfde manier worden gemaakt als voor water.
In dit artikel heb ik de methoden opgesomd die ik zelf heb uitgeprobeerd. Er zijn vast nog andere manieren om data te verzamelen en te visualiseren waar ik niet van op de hoogte ben. Laat het me weten in de reacties, ik ben er zeer in geïnteresseerd. Ik sta open voor constructieve kritiek en nieuwe ideeën. Ik hoop dat het materiaal ook anderen van dienst zal zijn.
Bron: habr.com
