

De aanleiding voor het schrijven van dit artikel is een overvloed aan materialen over statische analyse die steeds vaker mijn pad kruisen. Ten eerste is er de , dat zichzelf actief promoot op Habr door middel van analyses van fouten die hun tool in open-sourceprojecten heeft gevonden. Onlangs heeft PVS-studio , en natuurlijk konden de ontwikkelaars van IntelliJ IDEA, wiens ingebouwde analyser tegenwoordig waarschijnlijk de meest geavanceerde voor Java is, .
Bij het lezen van zulke analyses krijg je de indruk dat het gaat om een magische elixir: druk op de knop en daar is het — een lijst met defecten voor je ogen. Het lijkt alsof naarmate analyzers verbeterd worden, er automatisch steeds meer bugs gevonden zullen worden, en de producten die door deze robots worden gescand, beter en beter zullen worden, zonder enige inspanning van onze kant.
Maar magische elixirs bestaan niet. Ik wil het hebben over de zaken die doorgaans niet worden besproken in berichten zoals ‘dit zijn de dingen die onze robot kan vinden’: wat analyzers niet kunnen, wat hun echte rol en plaats is in het softwareleveringsproces, en hoe je ze op de juiste manier implementeert.
De rateltafel (bron: ).
)
Wat statische analyzers nooit zullen kunnen
Wat houdt broncode-analyse praktisch in? We dienen sommige bronbestanden in, en binnen korte tijd (veel korter dan het uitvoeren van tests) krijgen we bepaalde informatie over ons systeem terug. Een principieel en mathematisch onoverkomelijk beperking is dat we op deze manier slechts een vrij smalle klasse van informatie kunnen verkrijgen. stopproblemen: dit is een stelling die aantoont dat het onmogelijk is om een algemeen algoritme te ontwikkelen dat op basis van de broncode van een programma bepaalt of het in een lus terechtkomt of in een eindige tijd eindigt. Een uitbreiding van deze stelling is de , die voor elke niet-triviale eigenschap van computationele functies stelt dat de bepaling of een willekeurig programma een functie met die eigenschap berekent, een algoritmisch onoplosbare taak is. Bijvoorbeeld, het is onmogelijk om een parser te schrijven die, aan de hand van willekeurige broncode, bepaalt of het geanalyseerde programma een implementatie is van een algoritme dat, laten we zeggen, het kwadraat van een geheel getal berekent.
Daarom heeft de functionaliteit van statische analysatoren onoverkomelijke beperkingen. Een statische analyser kan nooit in alle gevallen bepalen wat bijvoorbeeld het optreden van een ‘null pointer exception’ in talen die null mogelijk maken, of in alle gevallen het optreden van ‘attribute not found’ in dynamisch getypeerde talen is. Het enige wat de meest geavanceerde statische analyser kan, is het isoleren van specifieke gevallen, waarvan het aantal onder alle mogelijke problemen met uw broncode, zonder overdrijving, een druppel op een hete plaat is.
Statische analyse is geen bugdetectie.
Hieruit volgt de conclusie: statische analyse is geen middel om het aantal defecten in een programma te verminderen. Ik durf te beweren: wanneer het voor het eerst op uw project wordt toegepast, zal het ‘interessante’ plekken in de code vinden, maar waarschijnlijk geen defecten die van invloed zijn op de kwaliteit van uw programma.
De voorbeelden van defecten die automatisch door analysatoren zijn gevonden, zijn indrukwekkend, maar men moet niet vergeten dat deze voorbeelden zijn gevonden door het scannen van een grote set van grote codebases. Op dezelfde manier vinden hackers, die meerdere eenvoudige wachtwoorden op een groot aantal accounts kunnen testen, uiteindelijk die accounts waar een eenvoudig wachtwoord is ingesteld.
Betekent dit dat statische analyse niet toegepast hoeft te worden? Natuurlijk niet! En precies om dezelfde reden waarom elke nieuwe wachtwoord moet worden gecontroleerd op opname in de lijst van ‘eenvoudige’ wachtwoorden.
Statische analyse is meer dan alleen bugdetectie.
Eigenlijk zijn de vragen die door de analyse kunnen worden opgelost veel breder. Statische analyse is in wezen elke controle van de bronbestanden die plaatsvindt voordat ze worden uitgevoerd. Hier zijn enkele dingen die je kunt doen:
- Controle van de codeerstijl in de brede zin van het woord. Dit omvat zowel het controleren van de opmaak als het zoeken naar het gebruik van overtollige of onnodige haakjes, het instellen van drempels voor metrics zoals het aantal regels of cyclomatische complexiteit van een methode, enzovoort — alles wat de leesbaarheid en onderhoudbaarheid van de code potentieel bemoeilijkt. In Java is een dergelijk hulpmiddel Checkstyle, in Python is dat flake8. Programma's van deze klasse worden meestal 'linters' genoemd.
- Niet alleen uitvoerbare code kan worden geanalyseerd. Hulpbestanden zoals JSON, YAML, XML, .properties kunnen (en moeten!) automatisch op validiteit worden gecontroleerd. Het is immers beter om vroeg in het automatische controleproces van een Pull Request te leren dat de JSON-structuur is aangetast door ongelijke aanhalingstekens, dan tijdens het uitvoeren van tests of in runtime? De juiste hulpmiddelen zijn beschikbaar: bijvoorbeeld, , .
- Compilatie (of parsing voor dynamische programmeertalen) is ook een vorm van statische analyse. Compilers kunnen over het algemeen waarschuwingen geven die wijzen op kwaliteitsproblemen van de bronscode, en deze moeten niet worden genegeerd.
- Soms is compilatie niet alleen de compilatie van uitvoerbare code. Bijvoorbeeld, als je documentatie hebt in het formaat , dan kan de AsciiDoctor-verwerker () waarschuwingen geven, bijvoorbeeld over verbroken interne links, op het moment dat je het omzet naar HTML/PDF. Dit is een zwaarwegende reden om een Pull Request met wijzigingen in de documentatie niet te accepteren.
- Spellingscontrole is ook een vorm van statische analyse. Het hulpprogramma kan de spelling niet alleen in de documentatie controleren, maar ook in de bronscode van programma's (in opmerkingen en literals) in verschillende programmeertalen, waaronder C/C++, Java en Python. Een spelfout in de gebruikersinterface of documentatie is ook een defect!
- Configuratietests (wat dit is — zie en verslagen), hoewel ze worden uitgevoerd in de runtime-omgeving van unit tests zoals pytest, zijn in feite ook een soort statische analyse, omdat ze de bronscode niet uitvoeren tijdens hun uitvoering.
Zoals we zien, speelt het zoeken naar bugs in deze lijst de minste rol, terwijl alles wat overblijft kan worden bereikt door gebruik te maken van gratis open source hulpmiddelen.
Welke van deze soorten statische analyse moeten in uw project worden toegepast? Natuurlijk allemaal, hoe meer, hoe beter! Het belangrijkste is om dit goed te implementeren, waar we het hier verder over zullen hebben.
De leveringspijp als een meertrapsfilter en statische analyse als de eerste cascade.
Een klassieke metafoor voor continue integratie is de pijplijn (pipeline) waar wijzigingen doorheen stromen — van de wijziging van de broncode tot de levering in productie. De standaard volgorde van de fasen in deze pijplijn ziet er als volgt uit:
- statische analyse
- compilatie
- moduletests
- integratietests
- UI-tests
- handmatige controle
Wijzigingen die op stap N in de pijplijn worden afgekeurd, worden niet doorgegeven aan stap N+1.
Waarom precies zo en niet anders? In dat deel van de pijplijn dat betrekking heeft op testen, leren testers de algemeen bekende testpiramide.
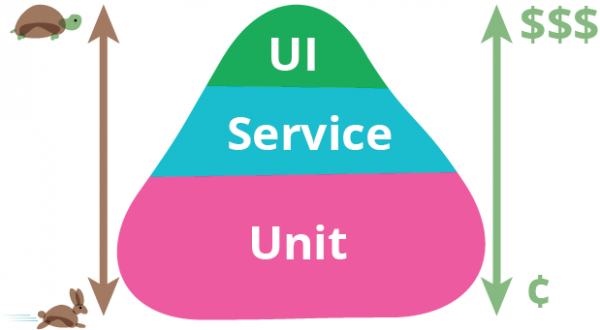
Testpiramide. Bron: Martin Fowler.
Aan de onderkant van deze piramide bevinden zich tests die gemakkelijker zijn om te schrijven, sneller worden uitgevoerd en minder kans hebben op valse positieven. Daarom moeten er meer van zijn, ze moeten meer code dekken en als eerste worden uitgevoerd. Aan de bovenkant van de piramide is het tegenovergestelde het geval, waardoor het aantal integratie- en UI-tests tot een absoluut minimum moet worden verminderd. De mens in deze keten is de duurste, traagste en minst betrouwbare hulpbron, en staat daarom aan het einde en voert alleen werkzaamheden uit als de vorige fasen geen defecten hebben ontdekt. Echter, dezelfde principes worden ook toegepast in de delen die niet direct met testen te maken hebben!
Ik zou een analogie willen voorstellen in de vorm van een multi-traps watersfilteringssysteem. Aan de ingang komt vervuild water (wijzigingen met defecten) binnen, aan de uitgang moeten we schoon water krijgen, waarin alle ongewenste verontreinigingen zijn gefilterd.
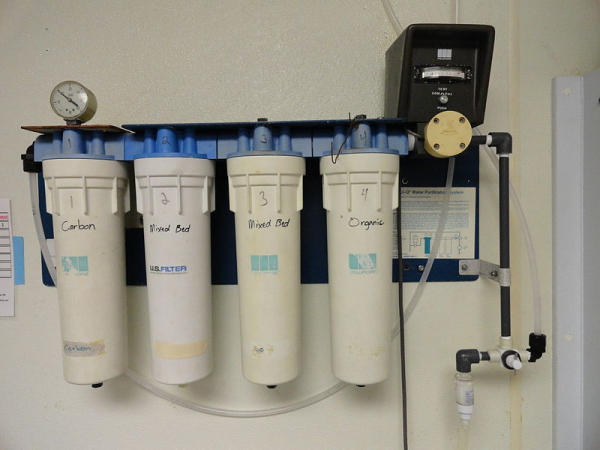
Meertrapsfilter. Bron:
Zoals bekend worden reinigingsfilters ontworpen zodat elke volgende cascade steeds fijnere verontreinigingen kan filteren. Dit betekent dat de cascades voor grove reiniging een grotere doorvoercapaciteit hebben en goedkoper zijn. In onze analogie betekent dit dat de invoerkwaliteitspoorten hogere prestaties hebben, minder inspanning vereisen om te activeren en zelf minder veeleisend zijn in gebruik—en precies in die volgorde zijn ze opgebouwd. De rol van statische analyse, die, zoals we nu begrijpen, alleen de meest grove defecten kan afvangen—is de rol van het roostersysteem 'vuilvanger' aan het begin van de filtercascade.
Statische analyse op zichzelf verbetert de kwaliteit van het eindproduct niet, net zoals een vuilvanger het water niet drinkbaar maakt. Desondanks is het belang ervan in combinatie met andere elementen van de keten duidelijk. Hoewel de uitgaande cascades in een multi-cascadefilter potentieel in staat zijn om hetzelfde te vangen als de inkomende—is het duidelijk wat de gevolgen zullen zijn van te proberen alleen met fijne reinigingscascades bezig te zijn, zonder inkomende cascades.
Het doel van de 'vuilvanger' is om de latere cascades te ontlasten van het vangen van echt grove defecten. Bijvoorbeeld, ten minste de persoon die de code review uitvoert, moet niet afgeleid worden door verkeerd opgemaakte code en het overtreden van vereiste coding standards (zoals overtollige haakjes of te diep geneste takken). Bugs zoals NPE moeten door unit tests worden opgevangen, maar als de analyzer al vóór de test aangeeft dat de bug onvermijdelijk zal optreden—zal dit de oplossing aanzienlijk versnellen.
Ik denk dat het nu duidelijk is waarom statische analyse de kwaliteit van het product niet verbetert als deze sporadisch wordt toegepast, en dat deze continu moet worden toegepast om wijzigingen met grove defecten af te vangen. De vraag of het gebruik van een statische analyzer de kwaliteit van uw product verbetert, is ongeveer gelijk aan de vraag: 'Verbeteren de drinkeigenschappen van water uit een vervuilde bron als ik het door een vergiet laat lopen?'
Implementatie in legacy-project
Een belangrijke praktische vraag: hoe implementeer je statische analyse in het continue integratieproces als een "quality gate"? Bij automatische tests is het duidelijk: er is een set tests, en als een van deze faalt, is dat voldoende reden om te concluderen dat de build de quality gate niet heeft doorstaan. Proberen om op dezelfde manier een gate in te stellen op basis van de resultaten van de statische analyse mislukt: bij legacy-code zijn er te veel waarschuwingen van de analyse, het is niet wenselijk om ze volledig te negeren, maar het is ook niet mogelijk om de productlevering stop te zetten alleen omdat er waarschuwingen van de analyzer zijn.
Wanneer voor de eerste keer toegepast, geeft de analyzer op elk project een enorme hoeveelheid waarschuwingen, waarvan het overgrote deel niet gerelateerd is aan de juiste werking van het product. Het is niet mogelijk om al deze opmerkingen onmiddellijk te corrigeren, en voor velen is dat ook niet nodig. Uiteindelijk weten we dat ons product in het algemeen goed werkt, zelfs voordat we statische analyse implementeerden!
Als gevolg hiervan beperken velen zich tot incidenteel gebruik van statische analyse, of gebruiken het alleen in informatiemodus, waarbij tijdens de build gewoon een rapport van de analyzer wordt afgegeven. Dit is gelijk aan het ontbreken van enige analyse, want als we al een reeks waarschuwingen hebben, blijft het voorkomen van nog een (hoe ernstig ook) bij het wijzigen van de code onopgemerkt.
De volgende manieren zijn bekend om quality gates in te voeren:
- Het instellen van een limiet op het totale aantal waarschuwingen of het aantal waarschuwingen gedeeld door het aantal regels code. Dit werkt slecht, omdat zo'n gate vrij gemakkelijk wijzigingen met nieuwe defecten doorlaat, totdat hun limiet is overschreden.
- Het vastleggen, op een bepaald moment, van alle oude waarschuwingen in de code als genegeerd, en het weigeren van de build bij nieuwe waarschuwingen. Deze functionaliteit wordt aangeboden door PVS-studio en sommige online bronnen, zoals Codacy. Ik heb geen ervaring met PVS-studio, maar mijn ervaring met Codacy laat zien dat de belangrijkste probleem ligt in het onderscheiden van wat een ‘oude’ en wat een ‘nieuwe’ fout is — een vrij complexe en niet altijd goed werkende algoritme, vooral wanneer bestanden sterk veranderen of hernoemd worden. In mijn herinnering kon Codacy nieuwe waarschuwingen in een pull request missen, terwijl het ook een pull request kon blokkeren vanwege waarschuwingen die niet gerelateerd zijn aan de wijzigingen in de code van deze PR.
- Naar mijn mening is de meest effectieve oplossing die beschreven staat in het boek de ‘ratchet’-methode. Het kernidee is dat een eigenschap van elke release het aantal waarschuwingen van statische analyse is, en alleen veranderingen die het totale aantal waarschuwingen niet verhogen, zijn toegestaan.
Hendel
Dit werkt als volgt:
- In de eerste fase wordt in de metadata van de release het aantal waarschuwingen in de code opgenomen, zoals gevonden door analyseprogramma's. Zo wordt er bij het bouwen van de hoofdbranch in uw repositorymanager niet slechts 'release 7.0.2' genoteerd, maar 'release 7.0.2 met 100500 Checkstyle-waarschuwingen'. Als u een geavanceerde repositorymanager gebruikt (zoals Artifactory), is het gemakkelijk om dergelijke metadata over uw release te bewaren.
- Nu vergelijkt elke pull request bij het bouwen het aantal ontvangen waarschuwingen met het aantal dat in de huidige release aanwezig is. Als de PR tot een stijging van dit aantal leidt, dan doorstaat de code de kwaliteitstest van statische analyse niet. Als het aantal waarschuwingen afneemt of onveranderd blijft — dan wel.
- Bij de volgende release wordt het herberekende aantal waarschuwingen opnieuw in de metadata van de release vastgelegd.
Zo geleidelijk aan, maar gestaag (zoals bij het gebruik van een ratchet), zal het aantal waarschuwingen neigen naar nul. Natuurlijk kan het systeem worden bedrogen door een nieuwe waarschuwing in te voeren, maar door een andere te corrigeren. Dat is prima, want op de lange termijn levert het resultaat op: waarschuwingen worden doorgaans niet één voor één gecorrigeerd, maar als een groep van een bepaald type, en alle gemakkelijk op te lossen waarschuwingen worden vrij snel opgelost.
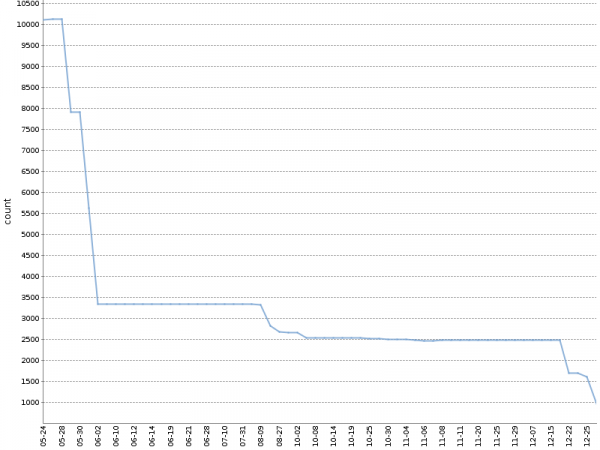
Op deze grafiek wordt het totale aantal Checkstyle-waarschuwingen weergegeven over een periode van zes maanden waarin deze 'ratchet' heeft gewerkt op . Het aantal waarschuwingen is met een factor tien afgenomen, en dit gebeurde op een natuurlijke wijze, parallel aan de ontwikkeling van het product!
Ik pas een gemodificeerde versie van deze methode toe, waarbij ik waarschuwingen afzonderlijk tel per module van het project en analysetools. Het resulterende YAML-bestand met metadata over de build ziet er ongeveer als volgt uit:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
In elk geavanceerd CI-systeem kan een 'ratchet' worden geïmplementeerd voor elke tool voor statische analyse, zonder te vertrouwen op plugins en externe tools. Elk van de analyzers geeft zijn rapport in een eenvoudig tekst- of XML-formaat, dat gemakkelijk kan worden geanalyseerd. Het enige dat resteert is de noodzakelijke logica in het CI-script te schrijven. Je kunt zien hoe dit is geïmplementeerd in onze open source-projecten op basis van Jenkins en Artifactory. of Beide voorbeelden zijn afhankelijk van de bibliotheek : de methode countWarnings() telt op de gebruikelijke manier xml-tags in de bestanden die door Checkstyle en Spotbugs worden gegenereerd, en compareWarningMaps() implementeert de daadwerkelijke ratchet, die een fout genereert wanneer het aantal waarschuwingen in een van de categorieën toeneemt.
Een interessante implementatie van een 'ratchet' kan worden gebruikt voor het analyseren van de spelling van commentaren, tekstliteralen en documentatie met behulp van aspell. Zoals bekend is, zijn niet alle onbekende woorden volgens de standaardwoordenlijst foutief, ze kunnen worden toegevoegd aan een gebruikerswoordenlijst. Als we de gebruikerswoordenlijst onderdeel maken van de broncode van het project, kan de kwaliteitsnorm voor spelling als volgt worden geformuleerd: uitvoering van aspell met de standaard en de gebruikerswoordenlijst. geen spellingsfouten vinden.
Over het belang van het vastleggen van de versie van de analyzer
Tot slot moet het volgende worden opgemerkt: hoe je de analyse ook in je leveringspipeline implementeert, de versie van de analyzer moet worden vastgelegd. Als de analyzer spontaan wordt bijgewerkt, kunnen er bij het samenstellen van de volgende pull request nieuwe defecten aan het licht komen, die niet verband houden met de codewijzigingen, maar die voortkomen uit het feit dat de nieuwe analyzer simpelweg meer defecten kan vinden – en dit zal je proces van pull request-acceptatie verstoren. Het upgraden van de analyzer moet een weloverwogen actie zijn. Toch is het strikte vastleggen van de versie van elke component van de build in het algemeen een noodzakelijke eis en onderwerp voor een apart gesprek.
Conclusies
- Statische analyse zal je geen bugs vinden en de kwaliteit van je product verbetert niet door eenmalig gebruik. Positieve effecten voor de kwaliteit komen alleen tot stand door constante toepassing in het leveringsproces.
- Het vinden van bugs is in het geheel geen hoofddoel van de analyse; de overgrote meerderheid van de nuttige functies zijn beschikbaar in open-source tools.
- Implementeer quality gates op basis van de resultaten van de statische analyse in de allereerste fase van de leveringspipeline, gebruikmakend van de 'ratchet' voor legacy-code.
Links
- presentatie over verschillende analysemethoden (niet alleen statische!)
Bron: habr.com
