

Hallo, en eerst even wat poëzie. Soms ben ik jaloers op collega's die op afstand werken — het is geweldig om de mogelijkheid te hebben om vanuit elke uithoek van de internetverbonden wereld te werken, op elk moment vakantie te nemen, verantwoordelijkheid te hebben voor projecten en deadlines, in plaats van van 8 tot 17 uur op kantoor te zitten. Mijn functie en verantwoordelijkheden sluiten de mogelijkheid van een langdurige afwezigheid in het datacentrum praktisch uit. Echter — er komen af en toe interessante case studies voorbij, zoals de hieronder beschreven — en ik realiseer me dat er maar weinig posities zijn die zo'n ruimte bieden voor creatieve uiting van de interne troubleshooter.
Een kleine disclaimer — op het moment van schrijven is de case volledig niet opgelost, maar gezien de snelheid van de reacties van de leveranciers kan het volledige oplossen nog maanden duren, en ik wil mijn bevindingen nu al delen. Ik hoop dat, geachte lezers, u me deze haast vergeeft. Maar genoeg gepraat — wat is er met de case?
Eerst een inleiding: er is een bedrijf (waar ik werk als netwerkingenieur) dat klantoplossingen host in een privé VMware-cloud. De meeste nieuwe oplossingen worden verbonden met VXLAN-segmenten die door NSX-V worden beheerd — ik zal niet beoordelen hoeveel tijd deze oplossing me heeft bespaard, kort gezegd — veel. Ik heb zelfs mijn collega's kunnen opleiden in het configureren van NSX ESG, en kleine klantoplossingen worden zonder mijn betrokkenheid uitgerold. Een belangrijke opmerking — het control plane is met unicast-replicatie. De hypervisors zijn redundant verbonden met twee interfaces aan verschillende fysieke Juniper QFX5100-switches (samengesteld in een Virtual Chassis) en met de policy van timen route based on originating virtual port — dit voor de volledigheid.
De klantoplossingen zijn zeer divers: van Windows IIS, waar alle components van de webserver op één machine zijn geïnstalleerd, tot behoorlijk grote oplossingen — bijvoorbeeld load-balanced Apache webfronten + LB MariaDB in Galera + shared servers die zijn gesynchroniseerd met GlusterFS. Bijna elke server moet afzonderlijk worden gemonitord, en niet alle components hebben publieke adressen — als u met deze taak te maken heeft gehad en een eleganter oplossing hebt, zou ik blij zijn met uw advies.
Mijn monitoringoplossing bestaat uit het 'verbinden' van de firewall (Fortigate) met elk intern klantnetwerk (+SNAT en uiteraard strikte beperkingen op het soort verkeer dat is toegestaan) en het observeren van interne adressen — op deze manier wordt enige uniformiteit en vereenvoudiging van de monitoring bereikt. De monitoring zelf vindt plaats vanuit een cluster van PRTG-servers. Het schema voor monitoring ziet er ongeveer als volgt uit:
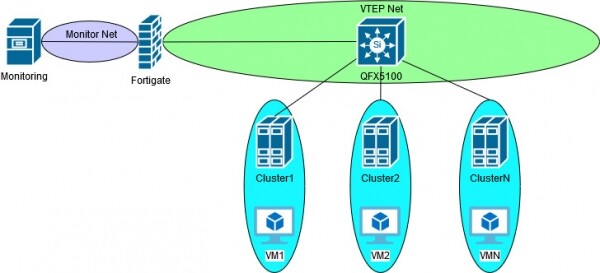
Zolang we alleen met VLAN opereerden, was alles tamelijk normaal en werkte het als een klok. Na de implementatie van NSX-V en VXLAN stuitten we echter op de vraag — kunnen we de monitoring op de oude manier voortzetten? Op het moment van deze vraag was de 'snelste' oplossing het implementeren van NSX ESG en het aansluiten van de VXLAN trunk-interface in het VTEP-netwerk. Snel tussen aanhalingstekens — omdat het gebruik van de GUI voor het configureren van klantnetwerken, SNAT en firewallregels misschien het beheer centraliseert in één interface van vSphere, maar naar mijn mening behoorlijk omslachtig is en bovendien de set van tools voor troubleshooting beperkt. Diegenen die NSX ESG hebben gebruikt als vervanging voor een 'echte' firewall, zullen het daar vermoedelijk mee eens zijn. Hoewel zo'n oplossing misschien stabieler zou zijn — alles gebeurt immers binnen één leverancier.
Een andere oplossing is het gebruik van NSX DLR in bridge-modus tussen VLAN en VXLAN. Hier is het denk ik duidelijk — het voordeel van het gebruik van VXLAN gaat verloren, want in dit geval moet je alsnog VLAN naar de monitoring-installatie trekken. Trouwens, tijdens de afhandeling van deze oplossing stuitte ik op een probleem waarbij de DLR-bridge geen pakketten naar de virtuele machine verstuurde die zich op dezelfde host bevond. Ik weet het, ik weet het — in boeken en gidsen over NSX-V staat duidelijk dat voor NSX Edge een aparte cluster moet worden toegewezen, maar dat staat in de boeken... Hoe dan ook, na een paar maanden met de support hebben we het probleem niet opgelost. In principe begreep ik de logica van de actie — de kernelmodule van de hypervisor, verantwoordelijk voor de encapsulatie van VXLAN, werd niet ingeschakeld als DLR en de geobserveerde server op dezelfde host bevonden, omdat het verkeer de host niet verliet en volgens de logica подключено moest zijn aan het VXLAN-segment — encapsulatie was niet nodig. Met de support kwamen we uit op de virtuele interface vdrPort, die logisch de uplinks verenigt en ook het bridgen/encapsuleren uitvoert — daar werd een onverenigbaarheid in het binnenkomende verkeer opgemerkt, die ik heb meegenomen in de huidige case. Maar zoals gezegd, ik heb deze case niet verder uitgewerkt, aangezien ik naar een ander project werd overgeplaatst en bovendien was de tak aanvankelijk doodlopend en had ik er niet echt de drang om deze verder te ontwikkelen. Als ik me niet vergis, werd het probleem waargenomen in de versies NSX 6.1.4 en 6.2.
En daar — bingo! Fortinet kondigt native . En niet alleen point-to-point of VXLAN-over-IPSec, geen softwarematige bridging VLAN-VXLAN — dit alles is al geïmplementeerd sinds versie 5.4 (en is gepresenteerd door andere ), en de echte ondersteuning van unicast control plane. Bij de implementatie van de oplossing stuitte ik op een ander probleem - de gecontroleerde servers verdwenen af en toe uit de monitoring, terwijl de virtuele machine zelf actief was. De oorzaak bleek te zijn dat ik vergeten was Ping toe te staan op de VXLAN-interface. Tijdens het herschikken van de clusters verhuisden de virtuele machines, en met Ping werd de vMotion voltooid om de nieuwe ESXI-host aan te geven waar de machine naartoe was verplaatst. Een domme vergissing van mijn kant, maar dit probleem heeft opnieuw mijn vertrouwen in de ondersteuning van de fabrikant - in dit geval Fortinet - ondermijnd. Laat staan dat elke case met VXLAN begint met de vraag 'waar is de VLAN-VXLAN instelling in uw configuratie?' Deze keer werd me aangeraden om de MTU te veranderen - dat is voor de Ping, die 32 bytes is. Daarna 'speel' met tcp-send-mss en tcp-receive-mss in het beleid - voor VXLAN, dat in UDP wordt ingekapseld. Pfoe, excuses - het is me even teveel geworden. In ieder geval heb ik dit probleem zelf opgelost.
Nadat ik met succes testverkeer had gedraaid, werd besloten om deze oplossing te implementeren. En in productie bleek dat, na een dag of twee, alles wat via VXLAN werd gemonitord, geleidelijk aan viel. Deactivering/activatie van de interface hielp, maar slechts tijdelijk. Omdát ik me de traagheid van de fabrikant-ondersteuning herinnerde, begon ik met troubleshooten aan mijn kant - tenslotte is mijn bedrijf, mijn netwerk - mijn verantwoordelijkheid.
Onder de spoiler staat het verloop van de troubleshooting. Wie moe is van letters en opschepperij - sla deze sectie over en ga naar de post-analyse.
Verloop van de troubleshootingBedankt voor het doorlezen - laten we verder gaan!
Dus, de monitoring werkt een tijdje, daarna valt hij vanzelf uit. Dat betekent dat er waarschijnlijk geen problemen zijn in de firewall-beleid. Echter, omdat ik eerder te maken heb gehad met het probleem van vastlopende systeemprocessen in Fortigate versies 5.6+, kijken we eerst naar 'diagnose debug flow' - zoals verwacht, wordt het verkeer toegestaan en verlaat het de interface, en zoals verwacht komt er niets terug. Dat betekent dat we dieper in de stack moeten graven. Helaas moet ik de adressen verbergen, ook al zijn het RFC1918-adressen, maar ik hoop het proces van voldoende beschrijvingen te voorzien voor begrip. De server binnen de VXLAN heeft het adres x.x.x.15, de interface van de Fortigate x.x.x.254, alle andere adressen behoren tot het VTEP-netwerk.
Voor een succesvolle overdracht van VXLAN-ingekapselde pakketten is het noodzakelijk om correcte informatie in verschillende tabellen te hebben. Voor overlay zijn dat ARP en OVSDB, voor underlay zijn dat ARP en CAM. In het geval van Fortigate is VXLAN FDB gelijk aan OVSDB. Laten we daar beginnen:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=xx.xx.xx.47 port=4789 vni=5008 ifindex=7
Hier is alles vrij eenvoudig — het MAC-adres van de virtuele machine moet zich bevinden op de VTEP met adres xx.xx.xx.47. Bij het bekijken van de inhoud en instellingen van de ESXi-cluster ontdek ik dat het MAC-adres van de virtuele machine correct is, het adres van de VTEP ook. Ik controleer de CAM/ARP-tabel op de Fortigate — weer allemaal overeenstemmend met de instellingen van de ESXi-host:
fortigate (root) #get sys arp | grep xx.xx.xx.47
xx.xx.xx.47 0 00:50:56:65:f6:2c dmz
De tabellen zijn correct en het verkeer gaat eruit — misschien is het probleem niet op de Fortigate? Ik heb opzettelijk de analyse van de verkeersswitching op de Juniper overgeslagen — logisch gezien moet de volgende stap van troubleshooting daar voort worden gezet, maar mijn netwerk is eenvoudig — slechts één VLAN voor VTEP en alle componenten zijn rechtstreeks verbonden. Bovendien herinner ik me de case met de DLR-brug, VDR en het verdwijnende verkeer — ik ga sniffen op de ESXi-host en creëer ondertussen een case bij VMware. Hieronder behoort MAC "97:6e" tot de Fortigate, vmnic1 — dit is de interface die de VTEP heeft met adres xx.xx.xx.47, en ik sniff in beide richtingen "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
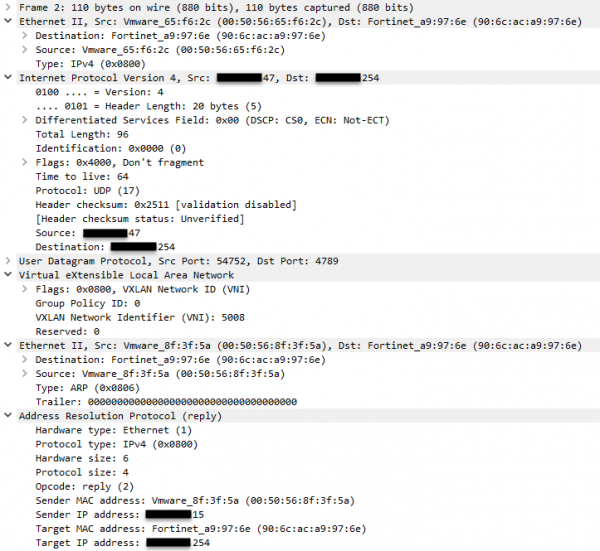
Vooruitgang — ik zie een ARP-verzoek en binnenkomend antwoord in de sniff. Ik geef alleen het ARP-antwoord en dat is alles correct. Ik heb het niet genoemd, maar de monitoringserver pingt ondertussen adres xx.xx.xx.15 — waar is het ICMP-verkeer? Ik herinner me dat ik twee uplinks heb. Hier kan gediscussieerd worden dat de virtuele poort van de bron dezelfde is (mijn teaming policy), wat betekent dat voor dezelfde vNIC dezelfde uplink moet worden gekozen, maar aangezien ik op de host ben, is het geen probleem om de andere uplink te controleren:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
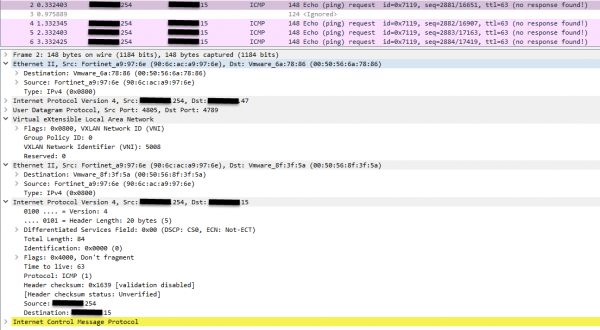
Er komen verzoeken binnen van de Fortigate, maar er is geen antwoord. Dus de probleem ligt niet bij de Fortigate. Nou, dacht ik — weer hetzelfde probleem met verdwijnend verkeer op de VDR, weer een paar maanden een case op de juiste manier moeten sturen. Na een paar dagen te zijn afgekoeld, en niet bereid om te berusten in de impasse, besloot ik meer sniffers voor de support te verzamelen om het proces te versnellen. En toen viel mijn blik "toevallig" op de Ethernet encapsulatie van de onderlaag. De koning is niet echt en het MAC adres van de VTEP komt niet overeen met zijn IP. Ik reset het naar nul, sniff, graaf dieper — klopt het, ja of nee. Ik geef de ARP-tabel ernaast, zodat het handiger is om te vergelijken. Let op de eerste Ethernet encapsulatie op de afbeelding bovenaan:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep u.u.u.42
u.u.u.42 0 00:50:56:6a:78:86 dmz
Dus, wat hebben we uiteindelijk — na de migratie van de virtuele machine probeert de Fortigate verkeer naar de VTEP te sturen vanuit (juiste) VXLAN FDB, maar gebruikt het een onjuist DST MAC en het verkeer wordt zoals verwacht afgewezen door de interface van de hypervisor die het ontvangt. In één geval van de vier hoorde dit MAC bij de oorspronkelijke hypervisor waar we de migratie van de machine mee begonnen.
Gisteren kreeg ik een e-mail van de technische ondersteuning van Fortinet — ze hebben een bug 615586 voor mijn case geopend. Ik weet niet of ik moet juichen of treuren: aan de ene kant is het probleem niet met de instellingen, aan de andere kant komt de fix pas met de firmware-update, in het beste geval bij de volgende. Mijn zelfvertrouwen wordt ook aangewakkerd door een andere bug die ik vorige maand ontdekte, maar deze keer in de HTML5 GUI van vSphere. Het lijkt wel een lokale QA afdeling van de verkopers...
Ik waag het om het volgende te veronderstellen:
1 — de multicast control plane zal waarschijnlijk niet onderhevig zijn aan het beschreven probleem — de MAC adressen van de VTEP worden verkregen uit het IP-adres van de groep waarop de interface is ingeschreven.
2 — het probleem van de Fortigate ligt vermoedelijk in het offloaden van sessies naar de Network Processor (een soortgelijke functie als CEF) — als je elk pakket via de CPU laat gaan, zullen de tabellen worden gebruikt die de juiste — in elk geval visueel — informatie bevatten. Dit vermoeden ondersteunt dat het helpt om de interface te sluiten/openen of een tijdje te wachten — meer dan 5 minuten.
3 — het veranderen van de teaming policy, bijvoorbeeld naar expliciete failover, of het implementeren van LAG zal het probleem niet oplossen, aangezien het ‘vastlopen’ van het MAC-adres van de oorspronkelijke hypervisor in ingekapselde pakketten is waargenomen.
In het licht hiervan kan ik delen dat ik recentelijk iets heb ontdekt. , waar in een van de artikelen werd beweerd dat stateful firewalls en cachebare overdrachten een soort van noodoplossingen zijn. Nou, ik ben niet voldoende ervaren in IT om zoiets te beweren, en ik ben het ook niet meteen met alle stellingen van blogartikelen eens. Maar iets zegt me dat er waarheid in de woorden van Ivan zit.
Dank voor uw aandacht! Ik beantwoord graag vragen en ontvang constructieve kritiek.
Bron: habr.com
