

Hallo allemaal. Hieronder volgt een transcriptie .
– een monitoringssysteem voor verschillende systemen en services, waarmee systeembeheerders informatie kunnen verzamelen over de huidige parameters van systemen en waarschuwingen kunnen instellen om notificaties te ontvangen over afwijkingen in de werking van systemen.
In de lezing zal een vergelijking worden gemaakt en – projecten voor langdurige opslag van metrics van Prometheus.
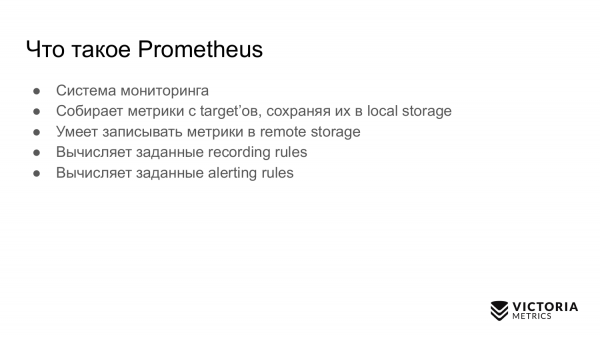
Allereerst zal ik vertellen over Prometheus. Dit is een monitoringssysteem dat metrics verzamelt van opgegeven target(s) en deze opslaat in lokale opslag. Prometheus kan metrics naar externe opslag schrijven, alerts genereren en recording rules instellen.
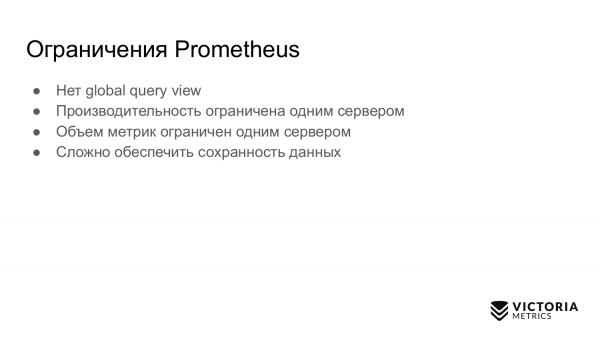
Beperkingen van Prometheus:
- Het heeft geen globale queryweergave. Dit is wanneer je meerdere onafhankelijke exemplaren van Prometheus hebt. Ze verzamelen metrics. En je wilt een query uitvoeren over al deze metrics, verzameld van verschillende exemplaren van Prometheus. Prometheus staat dit niet toe.
- De prestaties van Prometheus zijn beperkt tot één server. Prometheus kan niet automatisch opschalen naar meerdere servers. Je kunt alleen handmatig je targets verdelen over meerdere Prometheus-exemplaren.
- Het aantal metrics in Prometheus is beperkt tot één server om dezelfde reden dat het niet automatisch kan opschalen naar meerdere servers.
- In Prometheus is het niet eenvoudig om de dataopslag te organiseren.
Oplossingen voor deze problemen/taken?
De oplossingen zijn:
Al deze oplossingen zijn voor externe opslag van gegevens die door Prometheus zijn verzameld. Ze lossen het probleem van externe opslag van de vorige dia op verschillende manieren op. In deze presentatie zal ik alleen de eerste twee oplossingen bespreken: en .
Voor het eerst verscheen informatie over op . Daarin wordt de architectuur beschreven en hoe het werkt.
Thanos neemt de gegevens die Prometheus op de lokale schijf heeft opgeslagen en kopieert deze naar S3, naar of naar een andere objectopslag.
Op deze manier biedt Thanos een globale queryweergave. Je kunt gegevens aanvragen die in objectopslag zijn opgeslagen van meerdere exemplaren van Prometheus.
Thanos ondersteunt PromQL en .
Thanos maakt gebruik van de code van Prometheus voor gegevensopslag.
Thanos wordt ontwikkeld door dezelfde ontwikkelaars als Prometheus.
Over . Hier is , waar we voor het eerst hebben verteld over .
VictoriaMetrics ontvangt gegevens van verschillende Prometheus-exemplaren via protocol, ondersteund door Prometheus.
VictoriaMetrics biedt een wereldwijd query-overzicht, omdat meerdere Prometheus-instanties gegevens in één VictoriaMetrics kunnen opslaan. Hierdoor kunt u queries uitvoeren op al deze gegevens.

VictoriaMetrics ondersteunt, net als Thanos, PromQL en de Prometheus-query-API.
In tegenstelling tot Thanos is de broncode van VictoriaMetrics vanaf nul geschreven en geoptimaliseerd op snelheid en resourceverbruik.
VictoriaMetrics kan, in tegenstelling tot Thanos, zowel verticaal als horizontaal schalen. Er is , die verticaal schaalt. U kunt beginnen met één processor en 1 GB geheugen en geleidelijk groeien naar honderden processoren en 1 TB geheugen. VictoriaMetrics kan al deze middelen benutten. De prestaties zullen ongeveer 100 keer beter zijn in vergelijking met een enkelvoudig systeem.
Het verhaal van Thanos begon in november 2017, toen de eerste publieke commit verscheen. Daarvoor werd Thanos intern ontwikkeld door .
In juni 2019 was er een belangrijke release 0.5.0, waarin protocol. Dit is uit Thanos verwijderd, omdat het niet goed functioneerde. Vaak werkte een Thanos-cluster niet correct, en waren knooppunten niet goed verbonden door het gossipprotocol. Daarom hebben ze besloten het daaruit te verwijderen. Ik beschouw dat als de juiste beslissing.
In hetzelfde juni 2019 dienden ze aanvraag nummer in .
En een paar maanden later werd Thanos opgenomen in , dat onder andere Prometheus, Kubernetes en andere populaire projecten omvat.
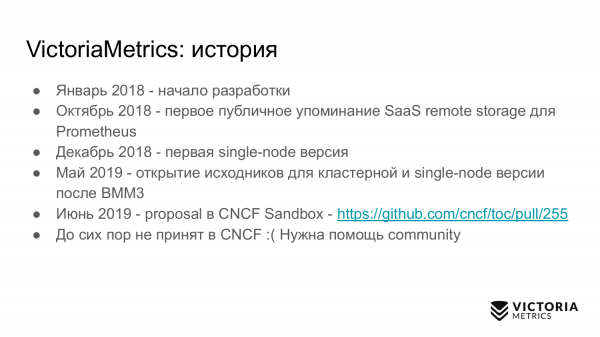
De ontwikkeling van VictoriaMetrics begon in januari 2018.
In september 2018 heb ik voor het eerst publiekelijk over VictoriaMetrics gesproken.
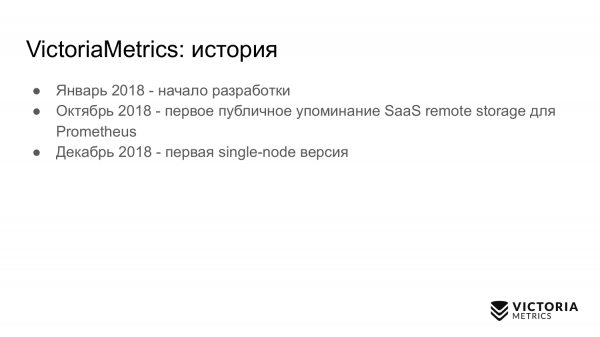
In december 2018 werd de single-node versie gepubliceerd.
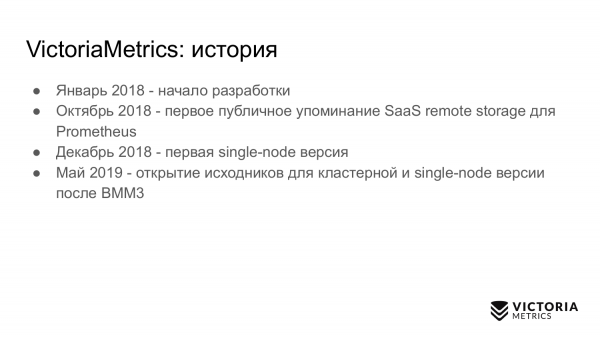
In mei 2019 In juni 2019 dienden we, net als Thanos, een aanvraag in bij de CNCF-stichting onder nummer
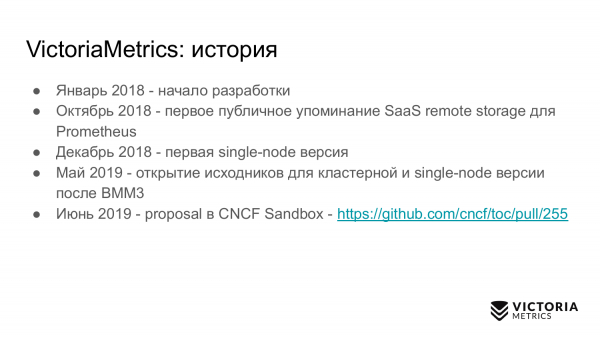
. We dienden onze aanvraag een dag eerder in dan Thanos. Maar helaas zijn we daar tot nu toe niet aangenomen. Er is hulp van de gemeenschap nodig.
Laten we de belangrijkste dia's bekijken die de architectuur van Thanos en VictoriaMetrics laten zien.
Laten we beginnen met Thanos. De gele componenten zijn de Prometheus-componenten. Al het andere zijn de Thanos-componenten. Laten we beginnen met de belangrijkste component. Thanos Sidecar is de component die naast elke Prometheus wordt geïnstalleerd. Het is verantwoordelijk voor het uploaden van Prometheus-gegevens vanuit lokale opslag naar S3 of een andere objectopslag.
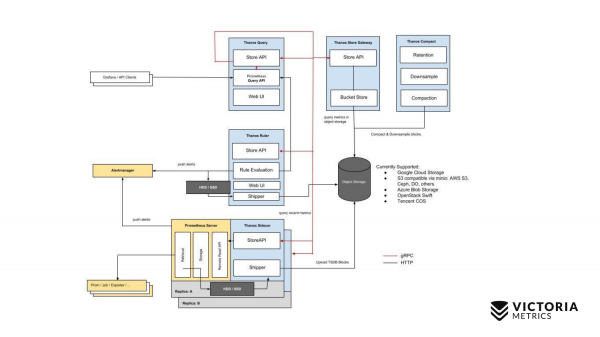
Laten we beginnen met Thanos. De gele componenten zijn Prometheus-componenten. Alles wat overblijft zijn Thanos-componenten. We beginnen met de belangrijkste component. Thanos Sidecar is de component die naast elke Prometheus wordt geïnstalleerd. Het zorgt ervoor dat Prometheus-gegevens vanuit de lokale opslag naar S3 of een andere Object Storage worden geüpload.
Er is ook een component genaamd Thanos Store Gateway, die deze gegevens uit Object Storage kan uitlezen bij binnenkomende verzoeken van Thanos Query. Thanos Query implementeert PromQL en de Prometheus API. Dat wil zeggen, van buitenaf lijkt het op Prometheus. Het accepteert PromQL-verzoeken, stuurt deze naar Thanos Store Gateway, die de benodigde gegevens uit Object Storage opvraagt en deze terugstuurt.
Maar in onze Object Storage bevinden zich geen gegevens van de laatste twee uur vanwege de specifieke implementatie van Thanos Sidecar, die de laatste twee uur niet in Object Storage S3 kan uploaden, omdat Prometheus voor deze twee uur nog geen bestanden in de lokale opslag heeft aangemaakt.
Hoe hebben ze dit opgelost? Thanos Query stuurt niet alleen verzoeken naar Thanos Store Gateway, maar verzendt ook parallelle verzoeken naar elke Thanos Sidecar die zich dicht bij Prometheus bevindt.
De Thanos Sidecar proxy't de verzoeken verder naar Prometheus en haalt de gegevens van de laatste twee uur op.
Naast deze componenten is er nog een optionele component zonder welke Thanos niet goed zal functioneren. Dit is Thanos Compact, dat zich bezighoudt met het samenvoegen van kleine bestanden in Object Storage tot grotere bestanden die door Thanos Sidecars zijn geüpload. Thanos Sidecar uploadt bestanden met gegevens van de laatste twee uur. Als deze bestanden niet worden samengevoegd tot grotere bestanden, kan hun aantal aanzienlijk toenemen. Hoe meer van dergelijke bestanden, hoe meer geheugen nodig is voor Thanos Store Gateway, en hoe meer middelen vereist zijn voor het verzenden van gegevens via het netwerk en metadata. De werking van Thanos Store Gateway wordt dan inefficiënt. Daarom moet je Thanos Compact zeker uitvoeren, dat kleine bestanden samensmelt tot grotere, zodat er minder van deze bestanden zijn en om de overhead op Thanos Store Gateway te verminderen.
Er is ook een component genaamd Thanos Ruler. Het voert de alarmregels van Prometheus uit en kan recording rules van Prometheus berekenen om gegevens opnieuw in Object Storage op te slaan. Maar dit component wordt niet aanbevolen om te gebruiken, aangezien het .
Dit is het eenvoudige schema van Thanos.
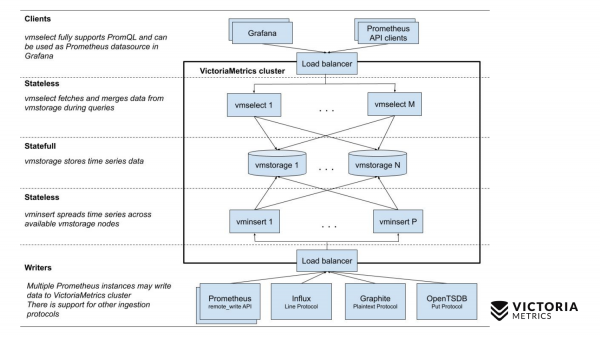
Laten we nu vergelijken met het schema van VictoriaMetrics.
VictoriaMetrics heeft 2 versies: Single-node en cluster versie. Single-node werkt op één computer. In Single-node zijn deze componenten niet aanwezig, gewoon één binair bestand. Dit binaire bestand ziet er op de dia uit als dit vierkant. Alles wat zich binnen het vierkant bevindt, is de inhoud van het binaire bestand voor de Single-node versie. Je hoeft er niet per se iets over te weten. Gewoon de binary starten - en alles werkt.
De cluster versie is complexer. Deze bevat drie verschillende componenten: vmselect, vminsert en vmstorage. Uit hun namen moet duidelijk zijn waar elk van hen voor verantwoordelijk is. De Insert component accepteert gegevens in verschillende formaten: van de Prometheus remote write API, het Influx line protocol, het Graphite protocol en van het OpenTSDB protocol. De Insert component accepteert deze, parseert ze en distribueert ze naar de beschikbare storage componenten, waar de gegevens vervolgens worden opgeslagen. De Select component accepteert op zijn beurt PromQL verzoeken. Het implementeert , evenals de Prometheus querying API, en het kan worden gebruikt als vervanging voor Prometheus in Grafana of andere Prometheus API-clients. Select accepteert een promql verzoek, parseert het, leest de noodzakelijke gegevens voor de uitvoering van dat verzoek uit de storage nodes, verwerkt deze gegevens en geeft een antwoord terug.
Laten we de complexiteit van de installatie van Thanos en VictoriaMetrics vergelijken.
Laten we beginnen met Thanos. Voordat je met Thanos kunt werken, moet je een bucket in Object Storage creëren, zoals S3 of GCS, zodat de Thanos Sidecar daar gegevens kan opslaan.
Vervolgens moet je voor elke Prometheus de Thanos Sidecar installeren. Vergeet niet om de data compaction in Prometheus uit te schakelen. Data compaction comprimeert periodiek gegevens in de lokale opslag van Prometheus om het middelenverbruik te verminderen.
Wanneer je Thanos Sidecar installeert voor je Prometheus-instanties, moet je deze data compaction uitschakelen, omdat Thanos Sidecar niet goed werkt met ingeschakelde data compaction. Dit betekent dat je Prometheus begint met het opslaan van gegevens in blokken van twee uur en stopt met het samenvoegen van deze blokken in grotere. Dienovereenkomstig, als je verzoeken doet die de duur van de laatste twee uur overschrijden, zullen ze minder efficiënt werken dan wanneer de data compaction was ingeschakeld.
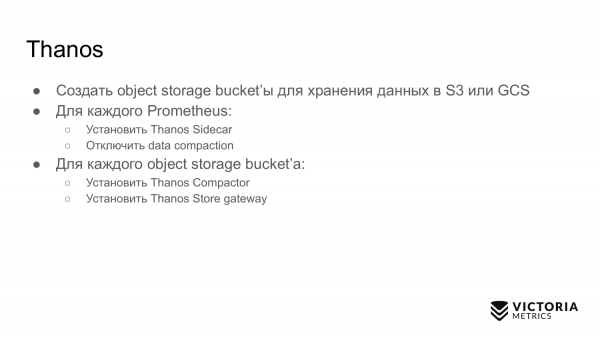
Daarom raadt Thanos aan om de data retention in de lokale opslag te verminderen tot 6-8 uur, om deze overhead van vele kleine blokken te verlagen.
Nadat je Thanos Sidecar hebt geïnstalleerd, moet je voor elke Object Storage Bucket twee componenten installeren. Dit zijn Thanos Compactor en Thanos Store Gateway.
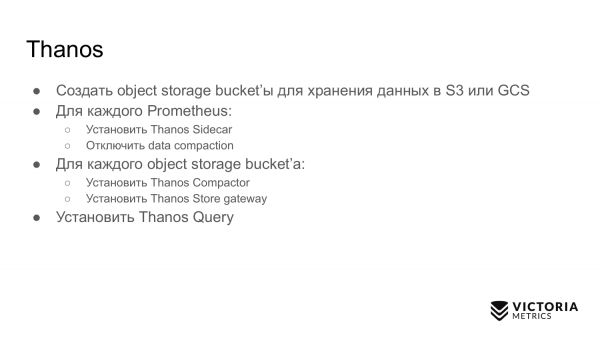
Daarna moet je Thanos Query installeren en configureren zodat het verbinding kan maken met alle Thanos Store Gateways die je hebt, en ook met alle Thanos Sidecars.
Hier kan er een klein probleempje zijn.
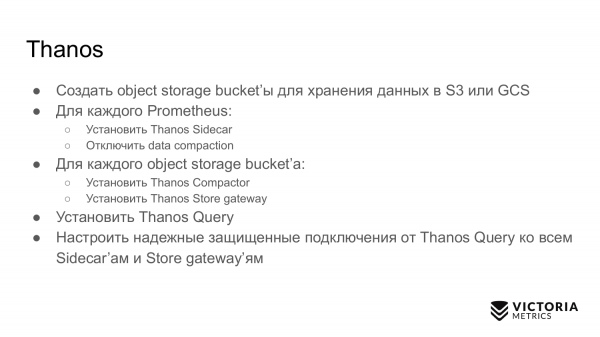
U moet een betrouwbare en veilige verbinding van Thanos Query naar deze componenten instellen. En als uw Prometheus-instanties zich in verschillende datacenters of in verschillende VPC's bevinden, zijn verbindingen van buitenaf verboden. Maar voor de werking van Thanos Query moet u op een of andere manier verbinding maken, en u moet een oplossing bedenken.
Als u veel van zulke datacenters heeft, vermindert dat de betrouwbaarheid van het hele systeem. Thanos Query moet immers voortdurend verbindingen onderhouden met alle Thanos Sidecar's die zich in verschillende datacenters bevinden. Bij elke binnenkomende aanvraag zal het verzoek naar alle Thanos Sidecar's worden gestuurd. Als de verbinding verbroken wordt, krijgt u ofwel een onvolledige gegevensset, of een antwoord 'cluster werkt niet'.
Bij VictoriaMetrics is alles iets eenvoudiger. Voor de single-node versie is het genoeg om één binaire uitvoerbare versie te starten en dat is alles.
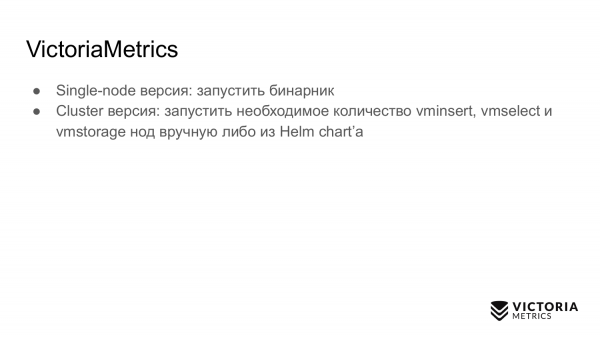
Bij de cluster versie is het voldoende om alle eerder genoemde drie typen componenten in elke gewenste hoeveelheid op te starten, of om automatisering voor het opstarten van componenten in Kubernetes te gebruiken. We zijn ook van plan om een Kubernetes-operator te maken. De Helm-chart dekt niet alle scenario's en kan ervoor zorgen dat u uzelf in de voet schiet. Bijvoorbeeld, het staat toe om het aantal storage nodes te verminderen, wat kan leiden tot dataverlies.
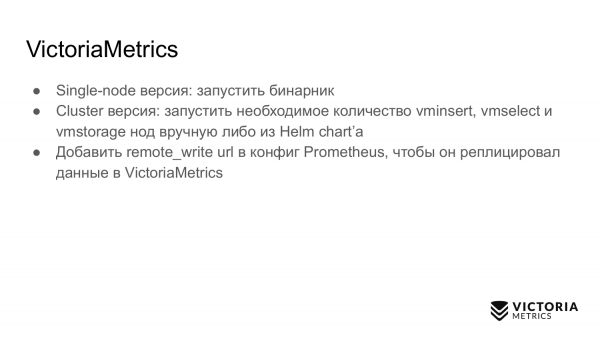
Nadat u een binaire uitvoerbare versie of cluster versie hebt gestart, hoeft u alleen maar de configuratie van Prometheus aan te passen. , zodat het gegevens gelijktijdig in de lokale opslag en in de externe opslag begint te schrijven. Zoals u kunt zien, zou deze configuratie veel betrouwbaarder moeten werken in vergelijking met de Thanos-configuratie. We hoeven geen verbinding te houden tussen VictoriaMetrics en alle Prometheus-instanties, omdat de Prometheus-instanties zelf verbinding maken met VictoriaMetrics en gegevens doorgeven.
Laten we eens kijken naar de ondersteuning van Thanos en VictoriaMetrics.
Thanos moet Sidecar in de gaten houden, zodat ze de gegevensoverdracht naar Object Storage niet stoppen. Ze kunnen deze gegevensoverdracht onderbreken door uploadfouten, bijvoorbeeld als uw netwerkverbinding met Object Storage tijdelijk is verbroken, of als Object Storage tijdelijk niet beschikbaar is. Thanos Sidecar zal dit opmerken, een foutmelding geven, mogelijk crashen en daarna stoppen met werken. Als u het niet monitort, stopt de gegevensoverdracht naar Object Storage. Als de retain-tijd verstrijkt (6-8 uur aanbevolen), verliest u gegevens die niet in Object Storage zijn gekomen.
Thanos compactors kunnen stoppen met werken door . Compactors nemen gegevens uit Object Storage en voegen ze samen in grotere datablokken. Aangezien compactors niet gesynchroniseerd zijn met de Sidecars, kan het volgende gebeuren: de Sidecar heeft het blok nog niet volledig geschreven, de Compactor denkt dat dit blok volledig is geschreven. De Compactor begint het te lezen. Hij leest het blok niet volledig en stopt met werken. Zie voor details .
Store Gateway kan inconsistente gegevens teruggeven door race-condities tussen de Compactor en de Sidecars. Hier is het hetzelfde, omdat de Store Gateway niet gesynchroniseerd is met de Compactors en Sidecars. Er kunnen dus race-condities ontstaan waarbij de Store Gateway een deel van de gegevens niet ziet, of extra gegevens ziet.
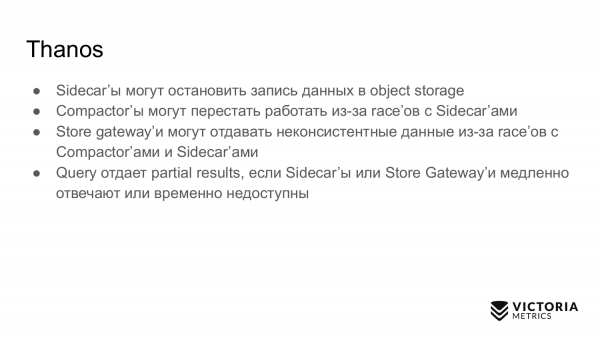
De Query-component in Thanos geeft standaard een gedeeltelijk resultaat terug als sommige Sidecars of de Store Gateway op dat moment niet beschikbaar zijn. U krijgt een deel van de gegevens en weet zelfs niet dat u niet alle gegevens heeft ontvangen. Dit is de standaardwerking. In een vergelijkbare situatie retourneert VictoriaMetrics gemarkeerde gegevens als gedeeltelijk.
In tegenstelling tot Thanos verliest VictoriaMetrics zelden gegevens. Zelfs als de verbinding tussen Prometheus en VictoriaMetrics verbroken is, is dat geen probleem, omdat Prometheus doorgaat met het opschrijven van nieuwe gegevens in de Write Ahead Log, die een grootte van 2 uur heeft. Als u binnen twee uur de verbinding met VictoriaMetrics herstelt, gaan de gegevens niet verloren. Prometheus .
In tegenstelling tot Thanos, dat pas na twee uur gegevens opslaat in object storage, repliceren Prometheus geautomatiseerd gegevens via het remote write-protocol naar remote storage, zoals VictoriaMetrics. Je hoeft je geen zorgen te maken over het verlies van lokale opslag in Prometheus. Als het lokale opslag verliest, verlies je in het slechtste geval alleen de laatste seconden gegevens die nog niet in remote storage zijn opgeslagen.
Kubernetes beheert het cluster automatisch, in tegenstelling tot Thanos. Alle componenten van Thanos zijn moeilijk in één Kubernetes-cluster onder te brengen, in tegenstelling tot de clustercomponenten van VictoriaMetrics.
Het updaten naar een nieuwe versie van VictoriaMetrics is heel eenvoudig. Stop gewoon VictoriaMetrics, werk de binaire bestanden bij en start opnieuw op. Bij het stoppen via de SIGINT-signaal maken alle binaire bestanden van VictoriaMetrics een graceful shutdown. Ze bewaren correct de benodigde gegevens en sluiten de binnenkomende verbindingen goed af, zodat er niets verloren gaat. Daarom verlies je niks bij een update.
Het is heel eenvoudig om een cluster van VictoriaMetrics uit te breiden. Voeg gewoon de benodigde componenten toe en je kunt verder werken.
Over de valkuilen van Thanos en VictoriaMetrics.
Thanos heeft de volgende valkuilen. Prometheus moet gegevens voor de afgelopen twee uur opslaan. Als ze verloren gaan, verlies je ze volledig, omdat ze nog niet naar Object Storage, zoals S3, zijn opgeslagen.
De Store Gateway-component en de compactor-component kunnen veel geheugen vereisen om te werken met een grote Object Storage, als er veel kleine bestanden zijn opgeslagen. Hoe groter het aantal en het volume van de bestanden, hoe meer geheugen de Store Gateway en compactor nodig hebben om metadata op te slaan. Thanos heeft veel problemen hiermee dat .
Thanos wordt aangeprezen als iets dat oneindig kan schalen met het aantal Prometheus-instanties. In werkelijkheid is dit niet waar. Omdat alle verzoeken via de Query-component gaan, die parallel alle Store Gateway-componenten en alle Sidecar-componenten moet ondervragen om gegevens op te halen en deze vervolgens voor te verwerken. Het is duidelijk dat de snelheid van verzoeken beperkt is door de traagste schakel, de traagste Store Gateway of de traagste Sidecar.
Deze componenten kunnen ongelijkmatig worden belast. Bijvoorbeeld, je hebt een Prometheus die miljoenen metrics per seconde verzamelt. En er is een Prometheus die duizenden metrics per seconde verzamelt. Prometheus die miljoenen metrics per seconde verzamelt, belast de server waarop hij draait veel zwaarder. Correspondent is de Sidecar daar trager. En over het algemeen werkt alles daar traag. En de Query-component zal heel langzaam gegevens daaruit extraheren. De prestaties van je hele cluster zullen dus beperkt zijn door deze trage Sidecar.
Standaard geeft Thanos gedeeltelijke gegevens als sommige Sidecars en/of de Store Gateway niet beschikbaar zijn. Bijvoorbeeld, als je Sidecars over de wereld verspreid hebt in verschillende datacentra, dan neemt de kans op een verbroken verbinding en onbeschikbare componenten aanzienlijk toe. Als gevolg hiervan ontvang je in de meeste gevallen gedeeltelijke gegevens, zonder dat je dit weet.
VictoriaMetrics heeft ook zijn valkuilen. De eerste valkuil is een optie die de hoeveelheid RAM die door de cache van VictoriaMetrics wordt gebruikt, beperkt. Standaard is dit 60% van het RAM op de machine waar VictoriaMetrics draait of 60% van het RAM van de VictoriaMetrics-pod in Kubernetes.
Als je deze waarde verkeerd verandert, kun je de prestaties van VictoriaMetrics verpesten. Bijvoorbeeld, als je een te lage waarde instelt, kunnen de gegevens niet meer in de cache van VictoriaMetrics passen. Dit zal extra werk met zich meebrengen en de CPU en schijf belasten. Als je deze optie te hoog instelt, vergroot dit ten eerste de kans dat VictoriaMetrics crasht met een out of memory-fout, en ten tweede zal er heel weinig RAM in het besturingssysteem overblijven voor de bestandscache. VictoriaMetrics vertrouwt op de bestandscache voor prestaties. Als deze tekortschiet, kan de belasting op de schijf aanzienlijk toenemen. Daarom is het advies: wijzig de parameter alleen indien echt nodig.
De tweede optie. Dit is de retentionPeriod - de periode die standaard op 1 maand is ingesteld. Dit is de tijd waarin VictoriaMetrics gegevens opslaat. Na deze periode verwijdert VictoriaMetrics de gegevens.
Veel mensen starten VictoriaMetrics zonder deze parameter en schrijven gedurende een maand data. En dan vragen ze: waarom zijn de gegevens van de vorige maand verdwenen? Omdat de retentionPeriod standaard op 1 maand is ingesteld. Daarom is het belangrijk om de juiste retentionPeriod te kennen en in te stellen.
Laten we de unieke mogelijkheden doornemen.
Thanos heeft een functie zoals downsampling: 5-minuten en uurlijkse intervallen, die vaak . Als je het googelt en hun probleemoplossingen op GitHub bekijkt, zijn er veel problemen gerapporteerd die verband houden met deze downsampling; soms werkt het niet goed of niet zoals gebruikers verwachten.
Thanos heeft deduplicatie van gegevens voor Prometheus HA-pairs. Wanneer twee Prometheus-systemen dezelfde statistieken van dezelfde targets verzamelen, worden deze door Thanos in Object Storage opgeslagen. Thanos kan deze gegevens correct dedupliceren, in tegenstelling tot VictoriaMetrics.
Thanos heeft een alert-component, die op het Thanos-schema staat. Maar deze .
Een voordeel van Thanos is dat de code van Thanos en Prometheus gemeenschappelijk is. Thanos en Prometheus zijn ontwikkeld door dezelfde ontwikkelaars. Bij verbeteringen in Thanos of Prometheus profiteert de andere kant.
De belangrijkste functie van VictoriaMetrics is MetricsQL. Dit is een uitbreiding van VictoriaMetrics voor PromQL, waarover ik heb gesproken op de vorige big monitoring meetup.
VictoriaMetrics ondersteunt het uploaden van gegevens via verschillende protocollen. VictoriaMetrics kan niet alleen gegevens van Prometheus ontvangen, maar ook via de protocollen Influx, OpenTSDB en Graphite.
De gegevens van VictoriaMetrics nemen doorgaans veel minder ruimte in beslag in vergelijking met Thanos en Prometheus.
Als echte gegevens worden geregistreerd, melden gebruikers een vermindering van de gegevensgrootte op de schijf met 2-5 keer in vergelijking met Prometheus en Thanos.
Een ander voordeel van VictoriaMetrics is dat het is geoptimaliseerd voor snelheid.
Laten we de kosten van de infrastructuur bekijken.
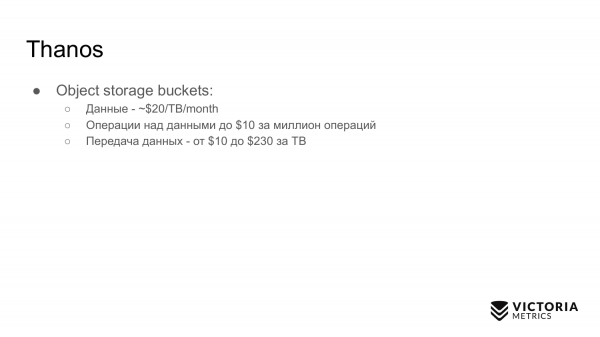
Een van de voordelen van Thanos is dat het gegevens opslaat in object storage, dat relatief goedkoop is.
Bij het opslaan van gegevens in object storage, moet je betalen voor de lees- en schrijfoperaties ($10 per miljoen operaties). Wanneer je gegevens in object storage opslaat, betaal je de kosten van je hosting voor het uploaden van gegevens naar het internet, als je cluster zich niet in AWS bevindt — daar is het gratis. Wanneer je gegevens leest, betaal je tussen de $10 en $230 per 1TB. Dit kan aanzienlijk zijn als je vaak historische gegevens uit de Thanos-cluster opvraagt.
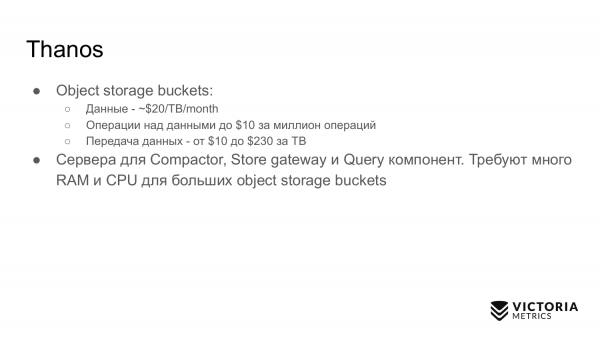
Voor een Thanos-cluster zijn servers nodig voor de Compact, Store Gateway en Query componenten, die veel geheugen en CPU vereisen voor grote datavolumes.
De kosten voor VictoriaMetrics zijn als volgt. Als je gegevens opslaat op GCE HDD-schijven, kost dit $40 per 1TB. Voor VictoriaMetrics zijn gewone HDD-schijven voldoende, SSD's zijn niet nodig en kosten vijf keer zoveel. VictoriaMetrics is geoptimaliseerd voor HDD.
Voor VictoriaMetrics zijn servers nodig voor de componenten: ofwel Single-node of voor clustercomponenten, die in tegenstelling tot Thanos-componenten veel minder CPU en geheugen vereisen — dit zal dus goedkoper zijn.
Voorbeelden van implementaties.
Een voorbeeld van implementatie voor Thanos is Gitlab. Gitlab draait volledig op Thanos. Maar het is niet allemaal rozengeur en maneschijn. Als je kijkt naar hun , dan zie je dat ze voortdurend tegen operationele problemen met Thanos aanlopen Hierdoor stijgen de kosten om deze problemen op te lossen.
De tweede implementatie, die succesvoller kan zijn, is het bedrijf Improbable, dat is gestart met de ontwikkeling van Thanos. Ze hebben de bronbestanden van Thanos gepubliceerd. Improbable is een bedrijf dat zich bezighoudt met de ontwikkeling van game-engines.
Openbare voorbeelden van implementatie van VictoriaMetrics zijn:
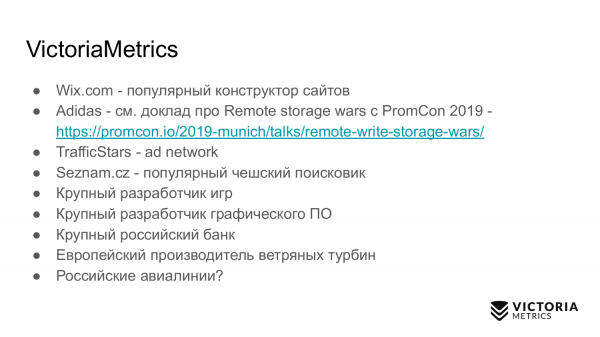
wix.com website bouwer
- Adidas implementeert VictoriaMetrics en heeft zelfs een presentatie gegeven op de laatste PromCon 2019
- TrafficStars — advertentienetwerk
- Seznam.cz — populaire Tsjechische zoekmachine.
- Daarna volgden onbekende bedrijven die ik nu niet kan noemen. Ze gaven geen toestemming.
Een grote game-ontwikkelaar. Groter dan Improbable.
- Een grote ontwikkelaar van grafische software.
- Een grote Russische bank.
- Een Europese producent van windturbines die VictoriaMetrics met succes heeft getest. Deze producent implementeert VictoriaMetrics voor het monitoren van gegevens van windturbines met een snelheid van 50 samples per seconde per sensor. Elke windturbine heeft enkele honderden sensoren. Ze hebben enkele honderden windturbines.
- Russische luchtvaartmaatschappijen die VictoriaMetrics willen implementeren, maar het nog steeds niet kunnen. We zijn in onderhandeling.
- Conclusies.
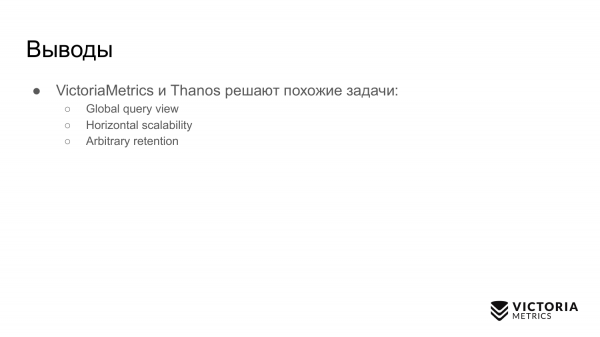 VictoriaMetrics en Thanos pakken vergelijkbare problemen aan, maar op verschillende manieren:
Globaal queryoverzicht
- horizontale schaalvergroting
- arbitraire retentie
- Dank je.
We wachten op je in onze
telegramkanaal .
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Thanos6
35,3%Cortex0
0,0%M3DB0
0,0%VictoriaMetrics7
41,2%VictoriaMetrics7
23,5%andere4
17 gebruikers hebben gestemd. 16 gebruikers hebben zich onthouden.
Bron: habr.com
