

Zabbix is een monitoringsysteem. Net als elk ander systeem, heeft het te maken met drie belangrijke problemen die bij alle monitoringsystemen voorkomen: het verzamelen en verwerken van gegevens, het opslaan van geschiedenis en het opruimen daarvan.
De stappen voor het verkrijgen, verwerken en opslaan van gegevens kosten tijd. Een beetje, maar voor een groot systeem kan dit leiden tot aanzienlijke vertragingen. Het probleem van opslag betreft de toegang tot gegevens. Deze worden gebruikt voor rapporten, controles en triggers. Vertragingen bij de toegang tot gegevens beïnvloeden ook de prestaties. Wanneer databases groeien, moeten verouderde gegevens worden verwijderd. Verwijderen is een zware operatie die ook een deel van de middelen verbruikt.
Problemen met vertragingen bij het verzamelen en opslaan in Zabbix worden opgelost door caching: verschillende soorten caches, caching in de database. Voor het oplossen van het derde probleem is caching niet geschikt, daarom is TimescaleDB toegepast in Zabbix. Hierover zal Andrey Gushchin — technisch ondersteuningsingenieur . Andrey werkt al meer dan 6 jaar bij de ondersteuning van Zabbix en heeft direct te maken met prestaties.
Hoe werkt TimescaleDB, welke prestaties kan het bieden in vergelijking met gewone PostgreSQL? Welke rol speelt Zabbix voor de TimescaleDB-database? Hoe start je vanaf nul en hoe migreer je van PostgreSQL, en welke configuratie presteert beter? Dit alles onder de cat.

Prestatie-uitdagingen
Elke monitoringsysteem heeft te maken met bepaalde prestatie-uitdagingen. Ik zal het hebben over drie ervan: het verzamelen en verwerken van gegevens, opslag, en het opruimen van geschiedenis.
Snelle verzameling en verwerking van gegevens. Een goed monitoringsysteem moet in staat zijn om snel alle gegevens te verzamelen en deze te verwerken volgens triggeruitdrukkingen — op basis van eigen criteria. Na verwerking moet het systeem deze gegevens ook snel opslaan in de database, zodat ze later gebruikt kunnen worden.
Opslaan van geschiedenis. Een goed monitoringsysteem moet de geschiedenis in de database opslaan en gemakkelijke toegang tot de metrics bieden. De geschiedenis is nodig om te gebruiken in rapporten, grafieken, triggers, drempelwaarden en berekende gegevensitems voor waarschuwingen.
Opruimen van geschiedenis. Soms komt er een dag dat je geen metrics meer hoeft op te slaan. Waarom zou je gegevens van vijf jaar geleden, een maand of twee nodig hebben: sommige knooppunten zijn verwijderd, sommige hosts of metrics zijn niet meer nodig omdat ze verouderd zijn en niet meer worden verzameld. Een goed monitorsysteem moet historische gegevens opslaan en deze van tijd tot tijd verwijderen zodat de database niet te groot wordt.
Het verwijderen van verouderde gegevens is een cruciaal vraagstuk dat een grote impact heeft op de prestaties van de database.
Caching in Zabbix
In Zabbix worden de eerste en tweede oproep opgelost met behulp van caching. Voor het verzamelen en verwerken van gegevens wordt het RAM-geheugen gebruikt. Voor opslag zijn er de geschiedenis in triggers, grafieken en berekende datapunten. Aan de databasekant is er bepaalde caching voor de belangrijkste selecties, bijvoorbeeld voor grafieken.
Caching aan de kant van de Zabbix-server zelf is:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Laten we ze in meer detail bekijken.
ConfigurationCache
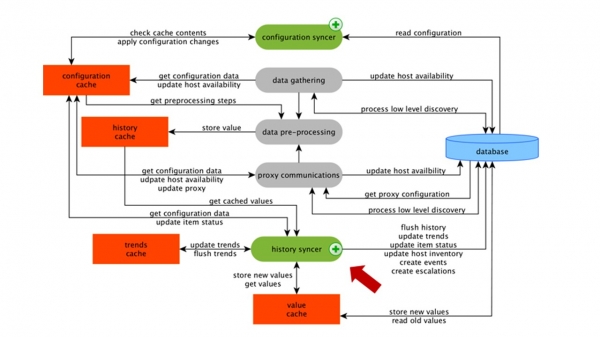
Dit is de belangrijkste cache waarin we metrics, hosts, datapunten, triggers - alles wat nodig is voor preprocessing en gegevensverzameling - opslaan.
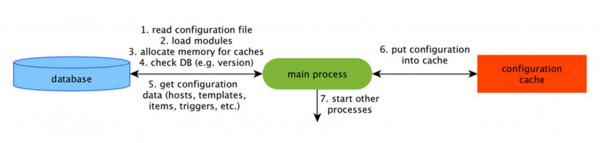
Dit alles wordt opgeslagen in de ConfigurationCache om extra aanvragen aan de database te vermijden. Na de start van de server vernieuwen we deze cache, maken we configuraties aan en werken we deze regelmatig bij.
Gegevensverzameling
Het schema is vrij groot, maar het belangrijkste daarin is de verzamelaars.. Dit zijn verschillende "pollers" - verzamelprocessen. Ze zijn verantwoordelijk voor verschillende soorten verzamelen: ze verzamelen gegevens via SNMP, IPMI, en dragen dit allemaal over naar preprocessing.
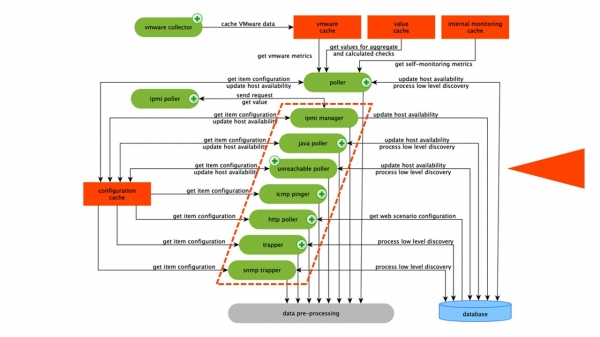 De verzamelaars zijn omrand met een oranje lijn.
In Zabbix zijn er berekende aggregatie datapunten die nodig zijn om controles te aggregeren. Als we die hebben, halen we gegevens voor hen direct uit de ValueCache.
PreProcessing HistoryCache
Alle verzamelaars gebruiken de ConfigurationCache om opdrachten te verkrijgen. Vervolgens dragen ze deze over naar preprocessing.
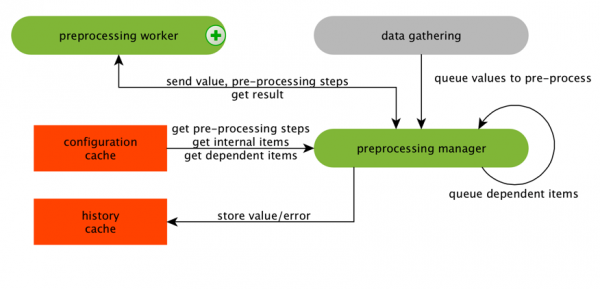
Preprocessing gebruikt de ConfigurationCache om de stappen voor preprocessing te verkrijgen. Het verwerkt deze gegevens op verschillende manieren.
Na het verwerken van gegevens via preprocessing, worden ze opgeslagen in de HistoryCache, om te worden verwerkt. Hier eindigt de gegevensverzameling en gaan we over naar het belangrijkste proces in Zabbix - history syncer,, aangezien dit een monolithische architectuur is.
Opmerking: Preprocessing is een vrij zware operatie. Sinds v 4.2 is het verplaatst naar de proxy. Als je een zeer grote Zabbix hebt met een groot aantal datapunten en verzamelingsfrequentie, verlicht dit de workload aanzienlijk.
ValueCache, geschiedenis & trends cache
History syncer is het belangrijkste proces dat elk gegevenselement atomair verwerkt, dat wil zeggen elke waarde.
History syncer haalt waarden uit HistoryCache en controleert in de Configuration op triggers voor berekeningen. Als ze er zijn, dan rekent hij deze uit.
History syncer creëert een gebeurtenis, een escalatie om meldingen te genereren indien vereist door de configuratie, en schrijft deze op. Als er triggers zijn voor verdere verwerking, onthoudt hij deze waarde in ValueCache, zodat hij niet in de geschiedenis tabel hoeft te kijken. Zo wordt ValueCache gevuld met gegevens die nodig zijn voor de berekening van triggers en berekende elementen.
History syncer schrijft alle gegevens naar de database, en deze naar de schijf. Het verwerkingsproces eindigt hier.
Caching in de database
Aan de databasezijde zijn er verschillende caches wanneer je grafieken of rapporten over gebeurtenissen wilt bekijken:
Innodb_buffer_poolaan de MySQL-zijde;shared_buffersaan de PostgreSQL-zijde;effective_cache_sizeaan de Oracle-zijde;shared_poolaan de DB2-zijde.
Er zijn nog veel andere caches, maar dit zijn de belangrijkste voor alle databases. Ze maken het mogelijk om gegevens die vaak nodig zijn voor aanvragen in het RAM te houden. Ze hebben hun eigen technologieën hiervoor.
Databaseprestaties zijn van cruciaal belang
De Zabbix-server verzamelt constant gegevens en schrijft deze op. Bij herstart leest hij ook uit de geschiedenis om ValueCache te vullen. Hij gebruikt de Zabbix API, die is gebaseerd op de webinterface. De Zabbix API maakt verbinding met de database en haalt de benodigde gegevens op voor grafieken, rapporten, evenementenlijsten en recente problemen.
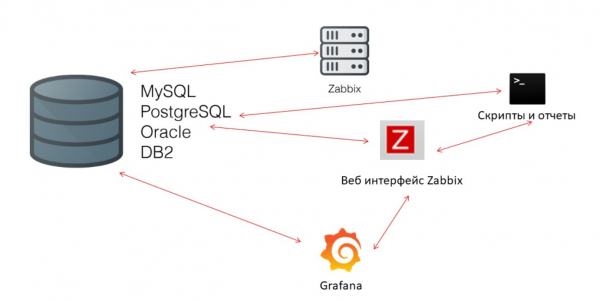
Voor visualisatie — Grafana. Dit is een populaire oplossing onder onze gebruikers. Hij kan rechtstreeks aanvragen indienen via de Zabbix API en in de database, en creëert een bepaalde concurrentie voor het ophalen van gegevens. Daarom is een fijnere en betere databaseconfiguratie nodig om te voldoen aan de snelle output van resultaten en tests.
Housekeeper
De derde prestatie-uitdaging in Zabbix is het opruimen van geschiedenis met behulp van Housekeeper. Hij houdt zich aan alle instellingen — in de gegevensitems staat aangegeven hoe lang de dynamiek van veranderingen (trends) in dagen bewaard moet blijven.
TrendsCache berekenen we on-the-fly. Wanneer gegevens binnenkomen, aggregeren we deze over een uur en schrijven ze naar tabellen voor de dynamiek van veranderingen in trends.
Housekeeper wordt gestart en verwijdert informatie uit de database met behulp van gewone 'selects'. Dit is niet altijd efficiënt, wat je kunt begrijpen aan de prestatiediagrammen van interne processen.
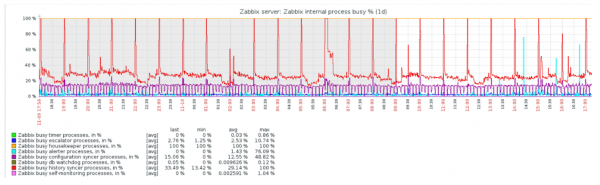
De rode grafiek toont aan dat de History syncer continu bezig is. De oranje grafiek bovenaan is de Housekeeper, die constant draait. Hij wacht op de database om alle rijen te verwijderen die hij heeft opgegeven.
Wanneer moet je de Housekeeper uitschakelen? Bijvoorbeeld, als er een 'Item ID' is en je moet de laatste 5.000 rijen verwijderen over een bepaalde tijd. Natuurlijk gebeurt dit op basis van indexen. Maar meestal is de dataset zeer groot, en de database leest toch van de schijf en laadt in het cachegeheugen. Dit is altijd een zeer dure operatie voor de database en, afhankelijk van de grootte van de database, kan dit leiden tot prestatieproblemen.
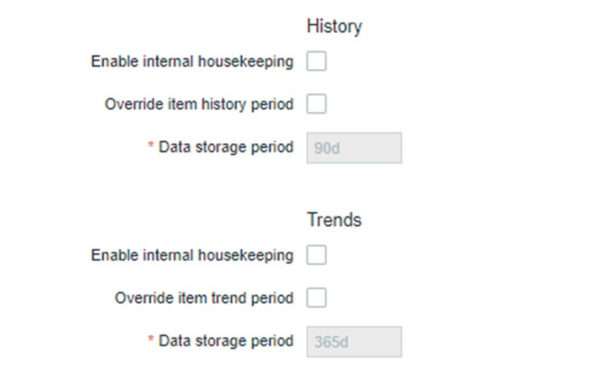
Je kunt de Housekeeper eenvoudig uitschakelen. In de webinterface is er een instelling onder 'Administratie algemeen' voor de Housekeeper. We schakelen de interne housekeeping voor de interne trendgeschiedenis uit en hij beheert dit niet meer.
De Housekeeper is uitgeschakeld, de grafieken zijn gelijkgetrokken — wat voor problemen kunnen er in dit geval zijn en wat kan helpen bij het oplossen van de derde prestatieoproep?
Partitioning — partitionering of sectieindeling
Gewoonlijk wordt partitionering op verschillende manieren ingesteld op elke relationele database die ik heb opgesomd. Elke database heeft zijn eigen technologie, maar ze zijn in het algemeen vergelijkbaar. Het aanmaken van een nieuwe partitie leidt vaak tot bepaalde problemen.
Gewoonlijk worden partities ingesteld op basis van de 'setup' — de hoeveelheid gegevens die per dag wordt aangemaakt. In de regel wordt partitionering ingesteld op één dag, dit is het minimum. Voor trends wordt een nieuwe partitie ingesteld op basis van 1 maand.
De waarden kunnen veranderen in het geval van een zeer grote 'setup'. Als de kleine 'setup' tot 5.000 nvps (nieuwe waarden per seconde) is, gemiddeld van 5.000 tot 25.000, dan is de grote meer dan 25.000 nvps. Dit zijn grote en zeer grote installaties die zorgvuldige afstemming van de database vereisen.
Op zeer grote installaties kan een segment van één dag niet optimaal zijn. Ik heb partities van 40 GB of meer per dag op MySQL gezien. Dit is een zeer grote hoeveelheid gegevens, wat kan leiden tot problemen, en het moet verminderd worden.
Wat biedt partitionering?
Tabelpartitionering. Vaak zijn dit afzonderlijke bestanden op de schijf. Het uitvoeringsplan voor de aanvraag kiest optimaler één partitie. Gewoonlijk wordt partitionering gedaan op basis van bereiken — dit geldt ook voor Zabbix. We gebruiken daar 'timestamp' — tijd sinds het begin van het tijdperk. Voor ons zijn dit gewone getallen. Je stelt het begin en het einde van de dag in — dat is de partitie.
Snelle verwijdering — HEADEr wordt één bestand/subtabel geselecteerd, niet een selectie van rijen voor verwijdering.
Versnelt de selectie van gegevens merkbaar. SELECT — gebruikt één of meer partities, niet de volledige tabel. Als u gegevens van twee dagen geleden opvraagt, worden deze sneller uit de database opgehaald, omdat er slechts één bestand moet worden geladen in de cache in plaats van een grote tabel.
Vaak versnelt dit ook vele databases. INSERT — invoegingen in de child-tabel.
TimescaleDB
Voor versie 4.2 hebben we gekeken naar TimescaleDB. Deze uitbreiding voor PostgreSQL heeft een native interface. De uitbreiding werkt efficiënt met tijdreeksgegevens, zonder de voordelen van relationele databases te verliezen. TimescaleDB partitioneert ook automatisch.
In TimescaleDB bestaat het concept van hypertabel, die u creëert. Hierin bevinden zich chunks, — partities. Chunks zijn automatisch beheerde fragmenten van de hypertabel, die geen invloed hebben op andere fragmenten. Voor elke chunk geldt een eigen tijdsbereik.
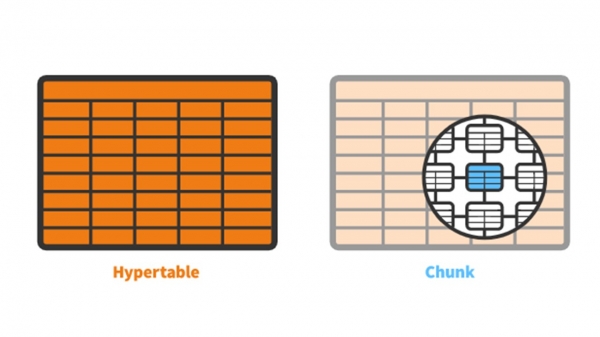
TimescaleDB vs PostgreSQL
TimescaleDB werkt echt efficiënt. De ontwikkelaars van de uitbreiding beweren dat zij een betere algoritme gebruiken voor het verwerken van aanvragen, in het bijzonder voor inserts. Wanneer de grootte van de dataset-invoegingen toeneemt, behoudt het algoritme constante prestaties.
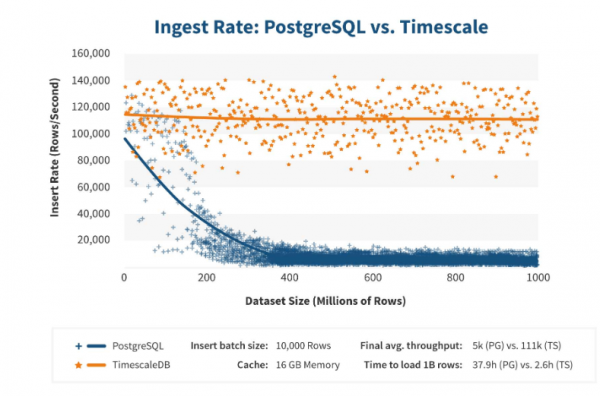
Na 200 miljoen rijen begint PostgreSQL meestal aanzienlijk te vertragen en verliest het zijn prestaties tot 0. TimescaleDB maakt efficiënte invoegingen mogelijk bij elke hoeveelheid gegevens.
Installatie
TimescaleDB installeren is vrij eenvoudig voor alle pakketten. In wordt alles in detail beschreven – het hangt af van de officiële PostgreSQL-pakketten. TimescaleDB kan ook handmatig worden samengesteld en gecompileerd.
Voor de Zabbix database activeren we eenvoudig de uitbreiding:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix U activeert de uitbreiding en creëert deze voor de Zabbix database. De laatste stap is het creëren van de hypertabel.
Migratie van historische tabellen naar TimescaleDB.
Hiervoor is er een speciale functie, create_hypertable.:
SELECT create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
De functie heeft drie parameters. De eerste is de tabel in de database, waarvoor een hypertable moet worden aangemaakt. De tweede is veld, waarop de moet worden aangemaakt chunk_time_interval — het tijdsinterval voor de partitiechunk die moet worden gebruikt. In mijn geval is het interval één dag — 86.400.
De derde parameter is migrate_data. Als je dit instelt op true, worden alle huidige gegevens overgebracht naar de vooraf aangemaakte chunks. Ikzelf heb gebruikt migrate_data. Ik had ongeveer 1 TB, wat meer dan een uur kostte. Zelfs in sommige gevallen, tijdens het testen, verwijderde ik niet-noodzakelijke historische gegevens van tekenreekstypen om deze niet over te brengen.
De laatste stap is UPDATE: in db_extension zetten we timescaledb, zodat de database begrijpt dat deze uitbreiding bestaat. Zabbix activeert dit en gebruikt de syntaxis en de queries correct voor de database — die functies die nodig zijn voor TimescaleDB.
Configuratie van de hardware
Ik gebruikte twee servers. De eerste is een VMware-machine. Deze is vrij klein: 20 processoren Intel® Xeon® CPU E5-2630 v4 @ 2,20 GHz, 16 GB RAM en een SSD-schijf van 200 GB.
Ik heb PostgreSQL 10.8 geïnstalleerd met Debian 10.8-1.pgdg90+1 en het xfs-bestandssysteem. Alles is minimaal ingesteld om deze specifieke database te gebruiken, behalve dat wat door Zabbix zelf zal worden gebruikt.
Op deze machine stond ook de Zabbix-server, PostgreSQL en belastingagents. Ik had 50 actieve agents, die gebruik maakten van LoadableModule, om zeer snel verschillende resultaten te genereren: getallen, strings. Ik vulde de database met een grote hoeveelheid gegevens.
Oorspronkelijk bevatte de configuratie 5.000 gegevensitems per host. Bijna elk item bevatte een trigger, zodat het leek op echte installaties. In sommige gevallen waren er meer dan één trigger. Voor één netwerknode waren er 3.000-7.000 triggers.
De updatefrequentie van de gegevensitems is 4-7 secondenIk reguleerde de belasting door niet alleen 50 agents te gebruiken, maar ik voegde er meer toe. Ook met behulp van data-elementen reguleerde ik dynamisch de belasting en verlaagde ik het update-interval tot 4 seconden.
PostgreSQL. 35.000 nvps
De eerste uitvoering op deze hardware was met een schone PostgreSQL — 35.000 waarden per seconde. Zoals te zien is, neemt het invoegen van gegevens fracties van een seconde in beslag — alles verloopt goed en snel. Het enige is dat de SSD-schijf van 200 GB snel vol raakt.
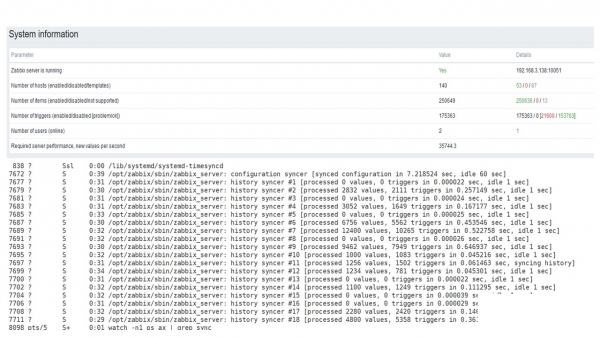
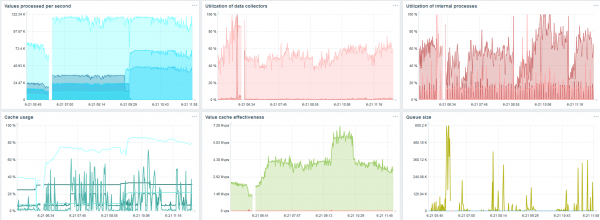
Dit is het standaard Zabbix-prestatie-dashboard voor servers.
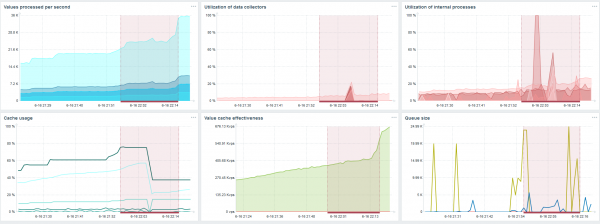
De eerste blauwe grafiek toont het aantal waarden per seconde. De tweede grafiek aan de rechterkant toont de belasting van de verzamelprocessen. De derde grafiek toont de belasting van interne verzamelprocessen: history syncers en Housekeeper, die hier lange tijd actief was.
De vierde grafiek toont het gebruik van HistoryCache. Dit is een soort buffer voor het invoegen in de database. De groene vijfde grafiek toont het gebruik van ValueCache, oftewel hoeveel hits ValueCache voor triggers — dit zijn enkele duizenden waarden per seconde.
PostgreSQL. 50.000 nvps
Daarna verhoogde ik de belasting tot 50.000 waarden per seconde op deze zelfde hardware.
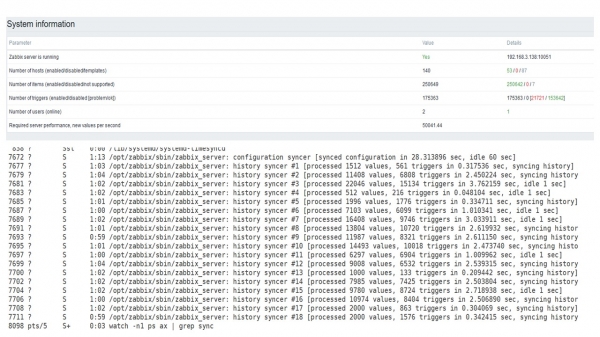
Bij het laden met Housekeeper werd het invoegen van 10.000 waarden geregistreerd binnen 2-3 seconden.
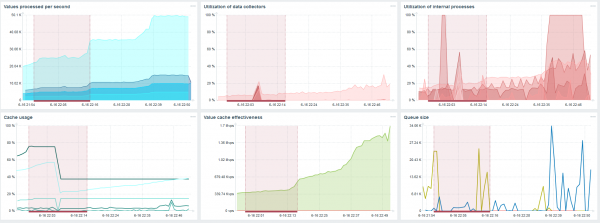
Housekeeper begint al in de weg te zitten.
Uit de derde grafiek blijkt dat de belasting van de trapper- en history syncers tot nu toe op niveau van 60% ligt. In de vierde grafiek begint HistoryCache tijdens het werken met Housekeeper al vrij actief vol te lopen. Het is met 20% gevuld — dat is ongeveer 0,5 GB.
PostgreSQL. 80.000 nvps
Vervolgens verhoogde ik de belasting tot 80.000 waarden per seconde. Dit is ongeveer 400.000 data-elementen en 280.000 triggers.
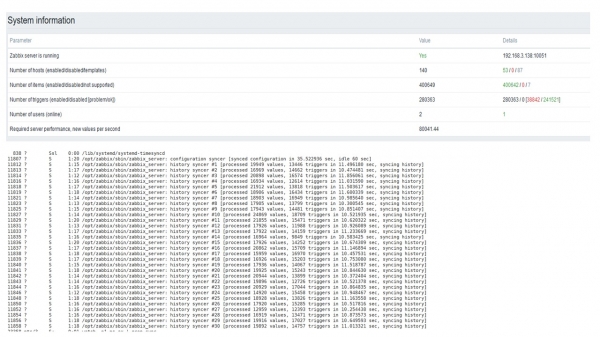
De invoeging bij een belasting van dertig history syncers is al behoorlijk hoog.
Ook verhoogde ik verschillende parameters: history syncers, caches.
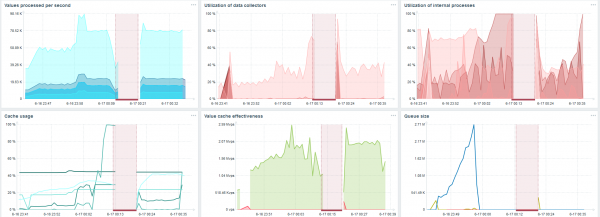
Op mijn hardware steeg de belasting van de history syncers tot het maximum. HistoryCache vulde zich snel met gegevens — in de buffer verzamelden zich gegevens voor verwerking.
De hele tijd observeerde ik hoe de CPU, RAM en andere systeemparameters werden gebruikt en ontdekte ik dat de schijfutilisatie maximaal was.
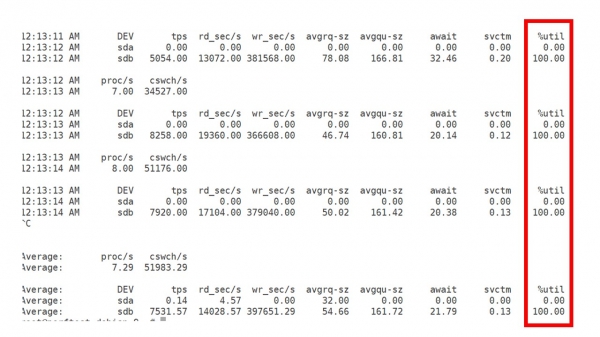
Ik bereikte het gebruik van de maximale capaciteiten van de schijf op deze hardware en op deze virtuele machine. Bij deze intensiteit begon PostgreSQL de gegevens vrij actief te flushen, en de schijf kon niet meer effectief lezen en schrijven.
Tweede server
Ik heb een andere server genomen, die al 48 processors en 128 GB RAM had. Ik heb hem getuned - ik installeerde 60 history syncers en bereikte acceptabele prestaties.
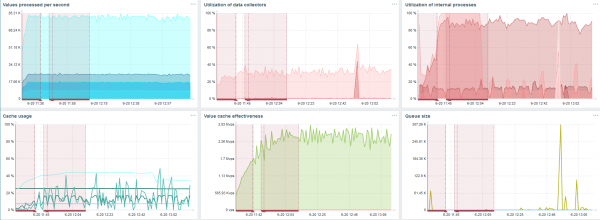
Eigenlijk is dit al de grens van de prestaties, waar iets gedaan moet worden.
TimescaleDB. 80.000 nvps
Mijn belangrijkste taak is om de mogelijkheden van TimescaleDB onder belasting vanuit Zabbix te testen. 80.000 waarden per seconde is veel, de frequentie van het verzamelen van metrics (behalve Yandex, natuurlijk) en een behoorlijk grote 'setup'.
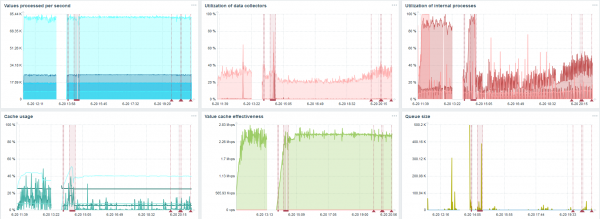
Op elke grafiek is er een dip - dat is precies de migratie van gegevens. Na de dips in de Zabbix-server veranderde het laadprofiel van de history syncer drastisch - het viel met een factor drie.
TimescaleDB stelt je in staat om gegevens bijna drie keer sneller in te voegen en minder HistoryCache te gebruiken.
Daarom ontvang je tijdig je gegevens.
TimescaleDB. 120.000 nvps
Daarna verhoogde ik het aantal gegevens tot 500.000. De belangrijkste taak was om de mogelijkheden van TimescaleDB te testen - ik kreeg een geschat aantal van 125.000 waarden per seconde.
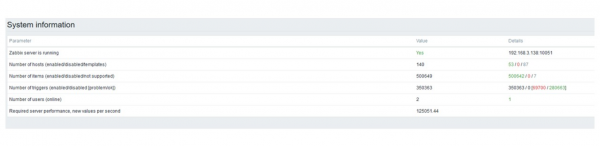
Dit is een werkende 'setup' die lang kan draaien. Maar omdat mijn schijf slechts 1,5 TB was, vulde ik deze in een paar dagen.
Het belangrijkste is dat op dat moment nieuwe TimescaleDB-partities werden aangemaakt.
Voor de prestaties is dit helemaal niet merkbaar. Wanneer partities in MySQL worden aangemaakt, is het heel anders. Dit gebeurt meestal 's nachts omdat het de algemene invoer blokkeert, de werkzaamheden met tabellen verstoort en service-afbraakin kan veroorzaken. Dit is niet het geval met TimescaleDB.
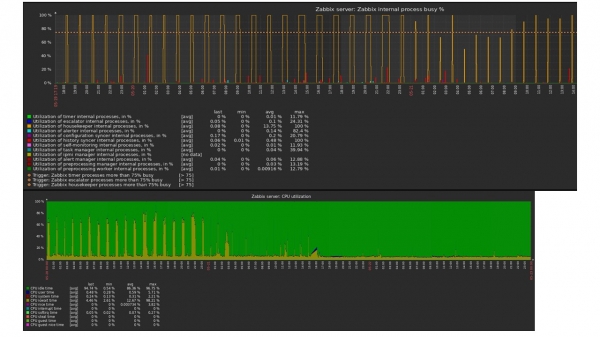
Als voorbeeld laat ik een grafiek zien uit de vele in de community. De afbeelding bevat TimescaleDB, waardoor de belasting op het gebruik van io.weight op de processor is gedaald. Het gebruik van interne proces-elementen is ook verminderd. Dit is overigens een gewone virtuele machine op normale schijven en geen SSD.
Conclusies
TimescaleDB is een goede oplossing voor kleine 'setups', die vastlopen op de schijfprestaties. Het stelt je in staat om redelijk door te blijven werken tot de database naar snellere hardware migreert.
TimescaleDB is eenvoudig in te stellen, biedt prestatieverbeteringen, werkt goed met Zabbix en heeft voordelen ten opzichte van PostgreSQL..
Als je PostgreSQL gebruikt en niet van plan bent het te wijzigen, raad ik aan PostgreSQL met de TimescaleDB-extensie in combinatie met Zabbix. Deze oplossing werkt effectief tot middelgrote 'setups'.
Als we 'hoge prestaties' zeggen, bedoelen we Het duurt niet lang meer om kennis te maken met de technologieën en praktijken die services in staat stellen miljoenen gebruikers te bedienen. Lijst voor 7 en 8 november hebben we al samengesteld, maar kunnen nog worden voorgesteld.
Volg onze en , waarin we de geheimen van de aankomende conferentie onthullen en ontdek hoe je er het meeste uit kunt halen.
Bron: habr.com
