

VictoriaMetrics, TimescaleDB en InfluxDB zijn vergeleken op een dataset met een miljard datapoints, afkomstig van 40K unieke tijdreeksen.
Enkele jaren geleden was er een tijdperk van Zabbix. Elke bare metal server had maximaal enkele statistieken - CPU-gebruik, geheugengebruik, schijfgebruik en netwerkverkeer. Zo konden metrics van duizenden servers worden samengevoegd tot 40 duizend unieke tijdreeksen, en Zabbix kan MySQL gebruiken als backend voor die tijdreeksen 🙂
Tegenwoordig biedt één met de standaardinstellingen meer dan 500 metrics op een gemiddelde host. Er zijn veel voor verschillende databases, webservers, hardware systemen, enz. Al deze bieden een breed scala aan nuttige statistieken. Steeds beginnen om verschillende metrics over zichzelf te publiceren. Er is Kubernetes met clusters en pods die vele metrics onthullen. Dit resulteert in servers die duizenden unieke metrics op een host publiceren. Hierdoor is een unieke tijdreeks van 40K niet langer een hoge prestatie. Het wordt mainstream, iets wat elke moderne TSDB op één server gemakkelijk moet kunnen verwerken.
Wat is momenteel een groot aantal unieke tijdreeksen? Misschien 400K of 4M? Of 40M? Laten we moderne TSDB's met deze cijfers vergelijken.
Configureren van de benchmark
is een geweldige benchmarkingtool voor TSDB's. Het stelt je in staat om een willekeurig aantal metrics te genereren door het vereiste aantal tijdreeksen in te voeren, verdeeld over 10 - de vlag (voorheen -scale-var). 10 is het aantal dimensies (metrics) dat op elke host, server wordt gegenereerd. De volgende datasets zijn gemaakt met behulp van TSBS voor de benchmark:
- 400K unieke tijdreeks, 60 seconden interval tussen datapoints, de gegevens beslaan een volledige periode van 3 dagen, ~1.7B totaal aantal datapoints.
- 4M unieke tijdreeks, interval van 600 seconden, de gegevens beslaan een volledige periode van 3 dagen, ~1.7B totaal aantal datapoints.
- 40M unieke tijdreeks, interval van 1 uur, de gegevens beslaan een volledige periode van 3 dagen, ~2.8B totaal aantal datapoints.
De client en server werden uitgevoerd op toegewijde instanties in de cloud van Google. Deze instanties hadden de volgende configuraties:
- vCPUs: 16
- RAM: 60 GB
- Opslag: standaard harde schijf van 1 TB. Het biedt een lees-/schrijfsnelheid van 120 Mbit/s, 750 leesoperaties per seconde en 1,5K schrijfoperaties per seconde.
TSDB's zijn opgezet vanuit officiële Docker-images en werden uitgevoerd in Docker met de volgende configuraties:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsInfluxDB-waarden (-e zijn nodig voor het ondersteunen van hoge capaciteit. Zie details in ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (de configuratie is overgenomen uit bestand):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it — rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
De gegevenslader werd uitgevoerd met 16 parallelle threads.
Dit artikel bevat alleen resultaten voor de invoerprestaties. Resultaten van de steekproefbenchmark zullen in een apart artikel worden gepubliceerd.
400K unieke tijdreeksen
Laten we beginnen met de eenvoudige elementen — 400K. Benchmarkresultaten:
- VictoriaMetrics: 2,6M datapunten per seconde; geheugengebruik: 3 GB; uiteindelijke schijfgrootte: 965 MB
- InfluxDB: 1,2M datapunten per seconde; geheugengebruik: 8,5 GB; uiteindelijke schijfgrootte: 1,6 GB
- Timescale: 849K datapunten per seconde; geheugengebruik: 2,5 GB; uiteindelijke schijfgrootte: 50 GB
Zoals u kunt zien uit de bovenstaande resultaten, wint VictoriaMetrics in invoerprestaties en compressiegraad. Timescale wint in geheugengebruik, maar het gebruikt veel schijfruimte — 29 bytes per datapunt.
Hieronder staan de CPU-gebruiksgrafieken voor elk van de TSDB's tijdens de benchmark:
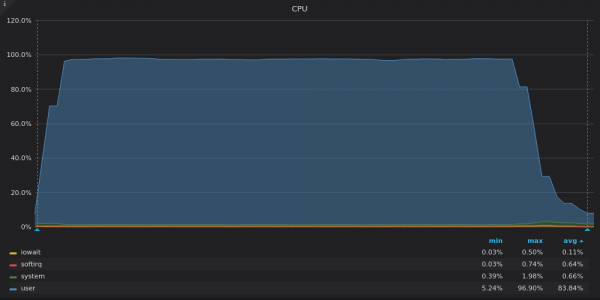
Bovenste screenshot: VictoriaMetrics — CPU-belasting tijdens de invoertest voor unieke metriek 400K.
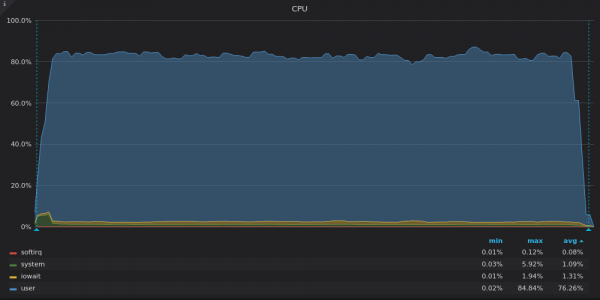
Bovenste screenshot: InfluxDB — CPU-belasting tijdens de invoertest voor unieke metriek 400K.
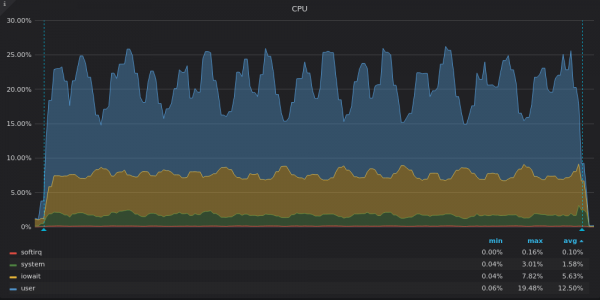
Bovenstaand screenshot: TimescaleDB — CPU-belasting tijdens de invoertest voor unieke metriek 400K.
VictoriaMetrics benut alle beschikbare vCPU's, terwijl InfluxDB niet genoeg gebruikmaakt van ongeveer 2 van de 16 vCPU's.
Timescale maakt slechts 3-4 van de 16 vCPU's gebruik. Hoge iowait en system percentages op de grafiek van TimescaleDB wijzen op een knelpunt in de I/O-subsystemen. Laten we kijken naar de grafieken van het schijfbewakingsgebruik:
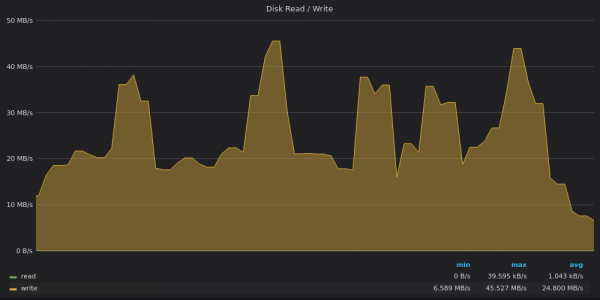
Bovenstaand screenshot: VictoriaMetrics — Gebruik van schijfbewaking tijdens de invoertest voor unieke statistieken 400K.
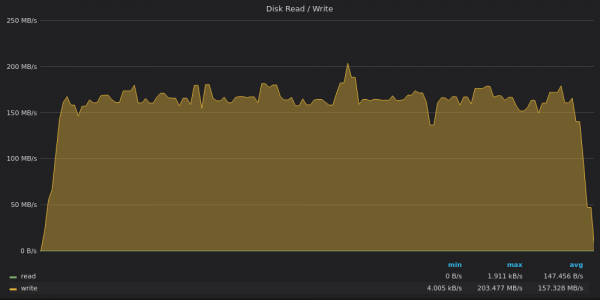
Bovenstaand screenshot: InfluxDB — Gebruik van schijfbewaking tijdens de invoertest voor unieke statistieken 400K.
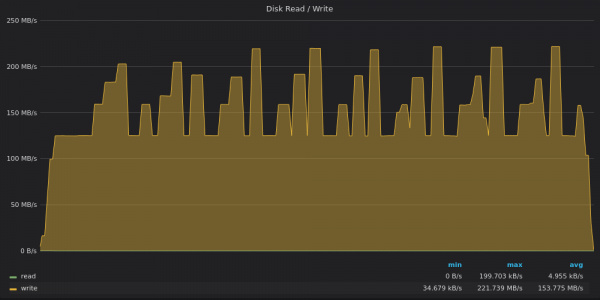
Bovenstaand screenshot: TimescaleDB — Gebruik van schijfbewaking tijdens de invoertest voor unieke statistieken 400K.
VictoriaMetrics schrijft gegevens met een snelheid van 20 Mbit/s met pieken tot 45 Mbit/s. De pieken corresponderen met grote deelmerge's in het boomstructuur. .
InfluxDB schrijft gegevens met een snelheid van 160 MB/s, terwijl een 1 TB-schijf op een schrijfcapaciteit van 120 MB/s.
TimescaleDB is beperkt tot een schrijfcapaciteit van 120 Mbit/s, maar onderbreekt soms deze limiet en bereikt pieken van 220 Mbit/s. Deze pieken komen overeen met momenten van onvoldoende CPU-belasting op de vorige grafiek.
Laten we kijken naar de I/O-gebruiksgrafieken:
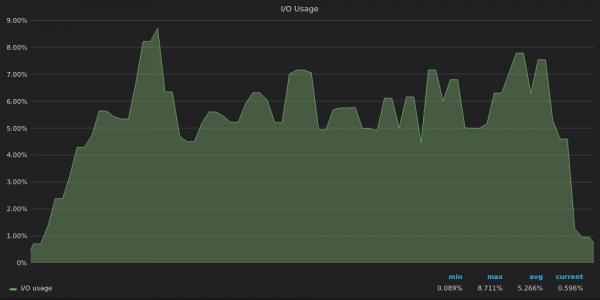
Bovenstaand screenshot: VictoriaMetrics — I/O-gebruik tijdens de invoertest voor 400K unieke metriek.
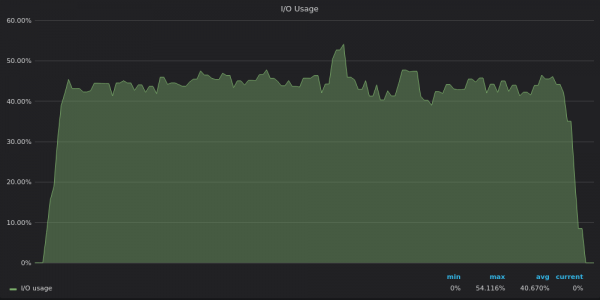
Bovenstaand screenshot: InfluxDB — I/O-gebruik tijdens de invoertest voor 400K unieke metriek.
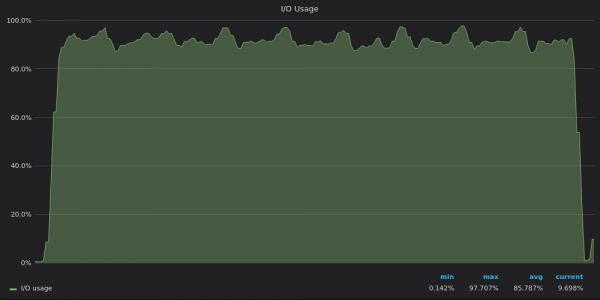
Bovenstaand screenshot: TimescaleDB — I/O-gebruik tijdens de invoertest voor 400K unieke metriek.
Het is nu duidelijk dat TimescaleDB de I/O-limiet bereikt, waardoor het de resterende 12 vCPU's niet kan gebruiken.
4M unieke tijdreeksen
4M tijdreeksen lijken wat uitdagend. Maar onze concurrenten passen succesvol deze test toe. Benchmarkresultaten:
- VictoriaMetrics: 2,2M datapoints per seconde; geheugengebruik: 6 GB; uiteindelijke grootte van gegevens op schijf: 3 GB.
- InfluxDB: 330K datapoints per seconde; geheugengebruik: 20,5 GB; uiteindelijke grootte van gegevens op schijf: 18,4 GB.
- TimescaleDB: 480K datapoints per second; geheugengebruik: 2,5 GB; uiteindelijke schijfgrootte: 52 GB.
De prestaties van InfluxDB daalden van 1,2 miljoen datapoints per seconde voor 400K tijdreeks naar 330 duizend datapoints per seconde voor 4M tijdreeks. Dit is een aanzienlijke prestatieafname vergeleken met andere concurrenten. Laten we de CPU-gebruik grafieken bekijken om de oorzaak van dit verlies te begrijpen:
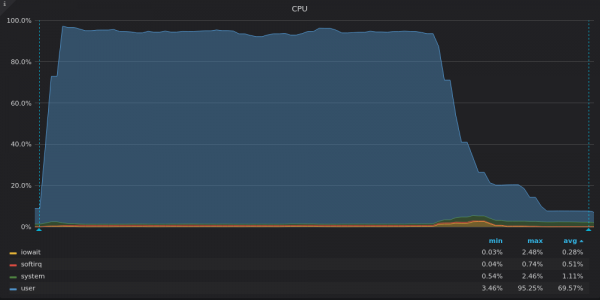
Bovenste screenshot: VictoriaMetrics — CPU-gebruik tijdens de invoegen test voor unieke tijdreeks 4M.
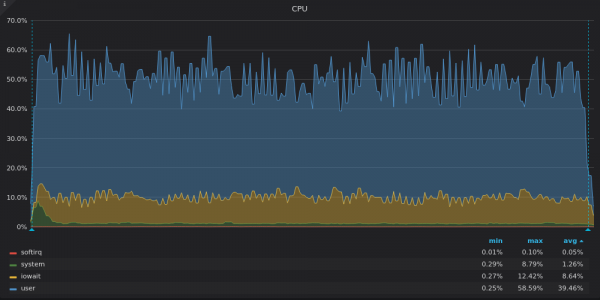
Bovenste screenshot: InfluxDB — CPU-gebruik tijdens de invoegen test voor unieke tijdreeks 4M.
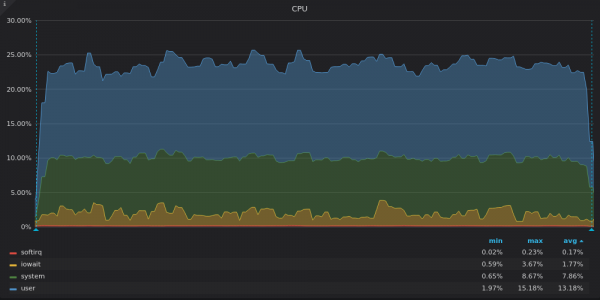
Bovenste screenshot: TimescaleDB — CPU-gebruik tijdens de invoegen test voor unieke tijdreeks 4M.
VictoriaMetrics gebruikt bijna alle CPU-kracht. De daling aan het einde komt overeen met resterende LSM-samenvoegingen na het invoegen van alle gegevens.
InfluxDB gebruikt slechts 8 uit 16 vCPUs, terwijl TimescaleDB 4 uit 16 vCPUs gebruikt. Wat gemeen is aan hun grafieken? Hoge percentage iowait, wat opnieuw wijst op een knelpunt in de input-output.
TimescaleDB heeft een hoog percentage system. We vermoeden dat de hoge efficiëntie heeft geleid tot veel systeemcalls of tot veel .
Laten we de schijven doorvoersnelheid grafieken bekijken:
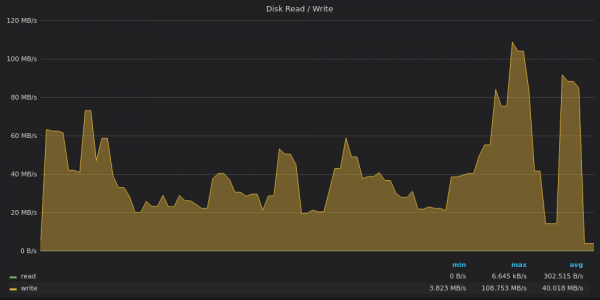
Bovenste screenshot: VictoriaMetrics — Gebruik van schijfbandbreedte voor het invoegen van 4M unieke metrics.
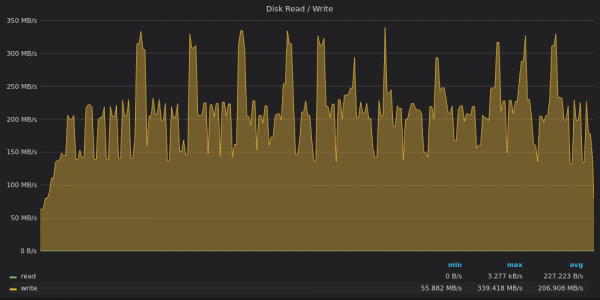
Bovenste screenshot: InfluxDB — Gebruik van schijfbandbreedte voor het invoegen van 4M unieke metrics.
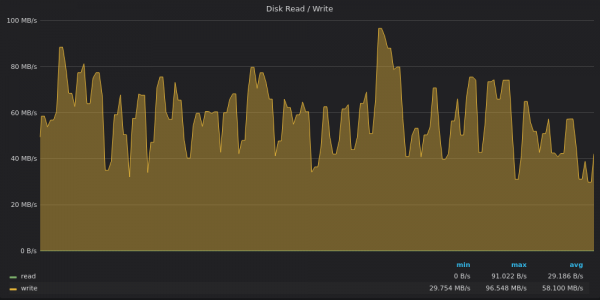
Bovenste screenshot: TimescaleDB — Gebruik van schijfbandbreedte voor het invoegen van 4M unieke metrics.
VictoriaMetrics bereikte een piek van 120 MB/s, terwijl de gemiddelde schrijfsnelheid 40 MB/s was. Het is waarschijnlijk dat er verschillende zware LSM-samenvoegingen plaatsvonden tijdens de piek.
InfluxDB haalt opnieuw een gemiddelde schrijfsnelheid van 200 MB/s met pieken tot 340 MB/s op een schrijfbeperkte schijf van 120 MB/s 🙂
TimescaleDB is niet langer beperkt door de schijf. Het lijkt beperkt te zijn door iets anders dat verband houdt met het hoge percentage systeem CPU belasting.
Laten we de IO-gebruik grafieken bekijken:
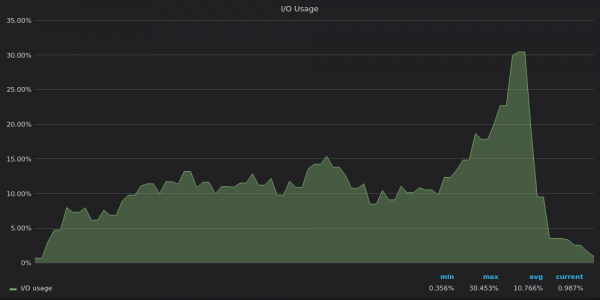
Bovenste screenshot: VictoriaMetrics — Gebruik van input-output tijdens de invoegen test voor unieke tijdreeks 4M.
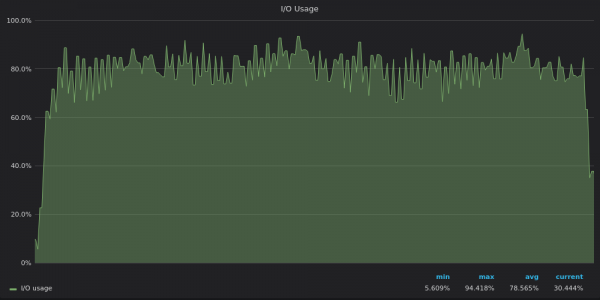
Bovenste screenshot: InfluxDB — Gebruik van input-output tijdens de invoegen test voor unieke tijdreeks 4M.
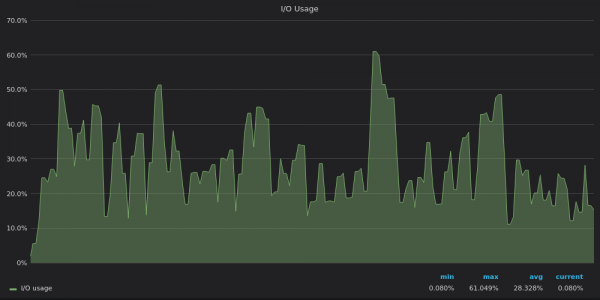
Bovenstaande screenshot: TimescaleDB - I/O-gebruik tijdens de invoertest voor een unieke tijdreeks van 4M.
De grafieken van I/O-gebruik volgen de grafieken van de schijfbandbreedte - InfluxDB is beperkt in I/O, terwijl VictoriaMetrics en TimescaleDB over extra I/O-resources beschikken.
40M unieke tijdseries
40M unieke tijdseries waren te groot voor InfluxDB 🙁
Benchmark-resultaten:
- VictoriaMetrics: 1,7M datapunten per seconde; geheugengebruik: 29 GB; schijfruimtegebruik: 17 GB.
- InfluxDB: niet voltooid omdat er meer dan 60 GB RAM nodig was.
- TimescaleDB: 330K datapunten per seconde, geheugengebruik: 2,5 GB; schijfruimtegebruik: 84 GB.
TimescaleDB toont een uitzonderlijk laag en stabiel geheugengebruik – 2,5 GB – hetzelfde als voor unieke metrische gegevens van 4M en 400K.
VictoriaMetrics steeg langzaam naar 100.000 datapunten per seconde totdat alle 40M metrische namen met labels waren verwerkt. Toen bereikte het een stabiele invoersnelheid van 1,5-2,0M datapunten per seconde, waardoor het eindresultaat 1,7M datapunten per seconde was.
De grafieken voor 40M unieke tijdseries zijn vergelijkbaar met die voor 4M unieke tijdseries, dus laten we ze overslaan.
Conclusies
- Moderne TSDB's zijn in staat om invoer te verwerken voor miljoenen unieke tijdseries op één server. In het volgende artikel zullen we onderzoeken hoe goed TSDB's presteren bij het opvragen van miljoenen unieke tijdseries.
- Een onvoldoende belasting van de CPU wijst meestal op een I/O-bottleneck. Dit kan ook wijzen op te grove locking, waarbij slechts een paar threads tegelijkertijd actief kunnen zijn.
- De I/O-bottleneck is reëel, vooral in opslag die geen SSD's gebruikt, zoals virtuele blokapparaten van cloudproviders.
- VictoriaMetrics biedt de beste optimalisatie voor langzame opslag met lage I/O. Het zorgt voor de beste snelheid en compressieverhouding.
Download en probeer deze met jouw gegevens. Het bijbehorende statische binaire bestand is beschikbaar op .
Lees meer over VictoriaMetrics in deze .
Update: gepubliceerd met reproduceerbare resultaten.
Update #2: Lees ook .
Update #3: !
Telegram chat:
Bron: habr.com
