

Een van de typische scenario's in alle gebruikelijke toepassingen is het zoeken naar gegevens op basis van bepaalde criteria en het weergeven daarvan in een leesbaar formaat. Hier kunnen ook extra mogelijkheden zijn voor sorteren, groeperen en paginering. De taak lijkt triviaal, maar bij het oplossen ervan maken veel ontwikkelaars een aantal fouten waardoor de prestaties in gevaar komen. Laten we verschillende oplossingen voor deze taak onderzoeken en aanbevelingen formuleren voor de keuze van de meest efficiënte implementatie.
Paginering optie #1
De eenvoudigste optie die in je opkomt, is het pagineren van de zoekresultaten in de meest klassieke vorm.
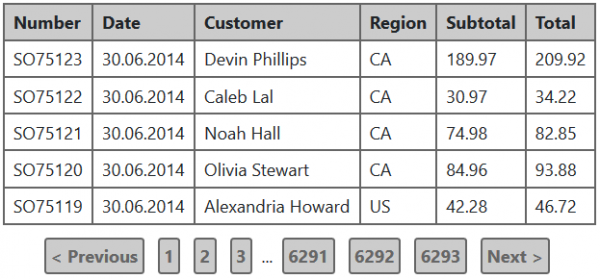
Stel dat er een relationele database in de applicatie wordt gebruikt. In dat geval moeten er twee SQL-query's worden uitgevoerd om informatie op deze manier weer te geven:
- Haal de rijen op voor de huidige pagina.
- Tel het totale aantal rijen dat aan de zoekcriteria voldoet - dit is nodig voor het tonen van pagina's.
Laten we de eerste query bekijken aan de hand van een test MS SQL database voor de 2016 server. Voor dit doel gebruiken we de tabel Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
De bovenstaande query zal de eerste 50 bestellingen uit de lijst weergeven, gesorteerd op de datum van toevoeging in aflopende volgorde, met andere woorden - de laatste 50 bestellingen.
Deze wordt snel uitgevoerd op de testdatabase, maar laten we naar het uitvoeringplan en de invoer-/uitvoerstatistieken kijken:
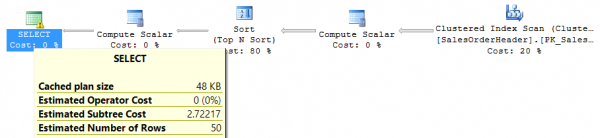
Tabel 'SalesOrderHeader'. Scan count 1, logical reads 698, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.Statistieken voor invoer/uitvoer voor elke query kunnen worden verkregen door de opdracht SET STATISTICS IO ON in de query-uitvoeringsomgeving uit te voeren.
Zoals blijkt uit het uitvoeringplan, is de meest resource-intensievere taak het sorteren van alle rijen in de oorspronkelijke tabel op datum van toevoeging. Het probleem is dat naarmate er meer rijen in de tabel komen, de sortering 'zwaarder' wordt. In de praktijk moeten dergelijke situaties worden vermeden, laten we daarom een index op de datum van toevoeging toevoegen en kijken of het resourceverbruik is veranderd:
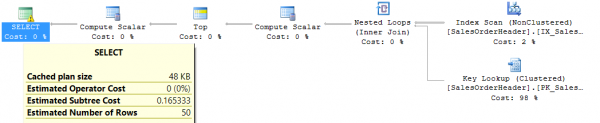
Tabel 'SalesOrderHeader'. Scan count 1, logical reads 165, physical reads 0, read-ahead reads 5, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.
Het is duidelijk dat het veel beter is geworden. Maar zijn alle problemen opgelost? Laten we de zoekopdracht aanpassen naar bestellingen waarbij de totale waarde van de artikelen meer dan 100 dollar bedraagt:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
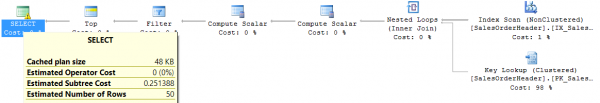
Tabel 'SalesOrderHeader'. Scan aantal 1, logische leesbewerkingen 1081, fysieke leesbewerkingen 0, read-ahead leesbewerkingen 0, lob logische leesbewerkingen 0, lob fysieke leesbewerkingen 0, lob read-ahead leesbewerkingen 0.We hebben een interessante situatie: het plan van de query is niet veel beter dan het vorige, maar het daadwerkelijke aantal logische leesbewerkingen is bijna twee keer zoveel als bij een volledige scan van de tabel. Er is een oplossing — als we van de al bestaande index een samengestelde index maken en de totale prijs van de artikelen als tweede veld toevoegen, krijgen we weer 165 logische leesbewerkingen:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Deze reeks voorbeelden kan nog lang doorgaan, maar er zijn twee belangrijke gedachten die ik hier wil uitdrücken:
- Het toevoegen van elke nieuwe voorwaarde of sorteervolgorde aan de zoekopdracht kan de snelheid van de uitvoering aanzienlijk beïnvloeden.
- Maar als we alleen een deel van de gegevens moeten lezen, en niet alle resultaten die aan de zoekcriteria voldoen — zijn er veel manieren om zo'n query te optimaliseren.
Laten we nu overgaan naar de tweede query die aan het begin werd genoemd — die welke het aantal records telt dat voldoet aan de zoekcriteria. Laten we hetzelfde voorbeeld nemen — het zoeken naar bestellingen die meer dan 100 dollar kosten:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Met de samengestelde index zoals hierboven vermeld, krijgen we:
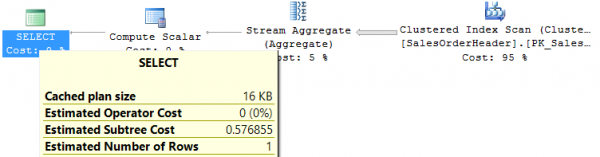
Tabel 'SalesOrderHeader'. Scan count 1, logical reads 698, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.Dat de query de hele index doorloopt, is niet verwonderlijk, aangezien het veld SubTotal niet op de eerste positie staat, waardoor de query deze niet kan gebruiken. Het probleem wordt opgelost door een extra index op het veld SubTotal toe te voegen, wat uiteindelijk slechts 48 logische leesbewerkingen oplevert.
We kunnen nog enkele voorbeelden geven van queries voor het tellen van aantallen, maar de essentie blijft dezelfde: het verkrijgen van een gegevensportie en het tellen van het totale aantal — dit zijn twee fundamenteel verschillende queries, en iedere query vereist zijn eigen maatregelen voor optimalisatie. In het algemeen is het niet mogelijk om een combinatie van indexen te vinden die voor beide queries even goed werkt.
Een van de belangrijke vereisten die moet worden verduidelijkt bij het ontwikkelen van een zoekoplossing is of het voor het bedrijf echt belangrijk is om het totale aantal gevonden objecten te zien. Vaak is dat niet het geval. En de navigatie naar specifieke paginanummers is, naar mijn mening, een oplossing met een zeer beperkte toepassing, aangezien de meeste scenario's met paging eruitzien als 'ga naar de volgende pagina'.
Paging optie #2
Stel dat het voor gebruikers niet belangrijk is om het totale aantal gevonden objecten te weten. Laten we proberen de zoekpagina te vereenvoudigen:
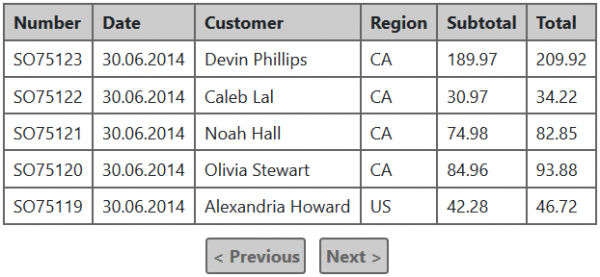
Feitelijk is er alleen veranderd dat er geen mogelijkheid is om naar specifieke paginanummers te gaan, en nu hoeft deze tabel niet te weten hoeveel pagina's er in totaal kunnen zijn. Maar er rijst de vraag: hoe weet de tabel of er gegevens zijn voor de volgende pagina (om de link "Volgende" correct weer te geven)?
Het antwoord is heel eenvoudig: je kunt één record meer ophalen uit de database dan nodig is voor weergave, en het bestaan van dit 'extra' record zal aangeven of er een volgende partij is. Op deze manier is er voor het verkrijgen van één pagina gegevens slechts één verzoek nodig, wat de prestaties aanzienlijk verbetert en het onderhoud van dergelijke functionaliteit vergemakkelijkt. Ik heb in de praktijk een geval meegemaakt waarin het afzien van het tellen van het totale aantal records de resultaten 4-5 keer versnelde.
Voor deze aanpak zijn er verschillende opties voor de gebruikersinterface: ‘terug’ en ‘verder’ knoppen, zoals in het bovenstaande voorbeeld, een 'meer laden' knop die gewoon een nieuwe partij aan de weergegeven resultaten toevoegt, en 'oneindige scroll', die werkt op basis van 'meer laden', maar waarbij het signaal om de volgende partij op te halen wordt gegeven door de gebruiker die alle weergegeven resultaten tot het einde scrolt. Wat de visuele oplossing ook is, het principe van gegevensselectie blijft hetzelfde.
Nuances van implementatie van paging
In alle voorbeelden van verzoeken die hierboven zijn gegeven, wordt de aanpak 'offset + aantal' gebruikt, waarbij in het verzoek wordt aangegeven vanaf welke volgorde van het resultaat en hoeveel rijen moeten worden geretourneerd. Laten we eerst bekijken hoe we de parameteroverdracht in dit geval het beste kunnen organiseren. In de praktijk ben ik verschillende manieren tegengekomen:
- Het volgnummer van de opgevraagde pagina (pageIndex), de paginagrootte (pageSize).
- Het volgnummer van de eerste record die moet worden teruggegeven (startIndex), het maximale aantal records in het resultaat (count).
- Het volgnummer van de eerste record die moet worden teruggegeven (startIndex), het volgnummer van de laatste record die moet worden teruggegeven (endIndex).
In eerste instantie kan het lijken alsof dit zo elementair is, dat er geen verschil is. Maar dat is niet zo — de meest handige en universele optie is de tweede (startIndex, count). Hier zijn verschillende redenen voor:
- Voor de aanpak met het afleiden van +1 record, zoals hierboven genoemd, is de eerste optie met pageIndex en pageSize uiterst onhandig. Bijvoorbeeld, we willen 50 records op een pagina weergeven. Volgens het hierboven beschreven algoritme moet er één record meer worden gelezen dan nodig. Als deze ‘+1’ niet op de server is ingebouwd, moeten we voor de eerste pagina records opvragen van 1 tot 51, voor de tweede van 51 tot 101 enzovoort. Als we de paginagrootte op 51 instellen en pageIndex verhogen, zal de tweede pagina records van 52 tot 102 teruggeven enzovoort. Bijgevolg is de enige manier om de knop voor het navigeren naar de volgende pagina correct te implementeren in de eerste optie, door ‘de extra’ regel op de server in te bouwen, wat een zeer onduidelijk punt zal zijn.
- De derde optie heeft helemaal geen zin, omdat voor het uitvoeren van aanvragen in de meeste databases nog steeds het aantal moet worden doorgegeven, en niet de index van de laatste record. Hoewel het aftrekken van startIndex van endIndex een elementaire wiskundige bewerking is, is deze hier overbodig.
Nu moeten we de nadelen van de implementatie van paging via ‘offset + aantal’ beschrijven:
- Het verkrijgen van elke volgende pagina zal kostbaarder en langzamer zijn dan de vorige, omdat de database alle records ‘vanaf het begin’ moet doorlopen volgens de zoek- en sorteerkriteria, waarna deze moet stoppen bij het juiste fragment.
- Niet alle DBMS kunnen deze aanpak ondersteunen.
Er zijn alternatieven, maar die zijn ook niet perfect. De eerste van deze benaderingen wordt 'keyset paging' of de 'seek method' genoemd en bestaat uit het volgende: na het verkrijgen van een groep records kun je de waarden van de velden in de laatste record op de pagina onthouden, en deze vervolgens gebruiken om de volgende groep te verkrijgen. Bijvoorbeeld, we hebben zo'n aanvraag uitgevoerd:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
In de laatste invoer hebben we de bestellingsdatum ‘2014-06-29’ ontvangen. Om de volgende pagina op te halen, zou je het volgende kunnen proberen:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Het probleem is dat OrderDate een niet-uniek veld is en de bovenstaande voorwaarde waarschijnlijk veel benodigde rijen overslaat. Om de nauwkeurigheid van deze query te vergroten, moet een uniek veld aan de voorwaarde worden toegevoegd (laten we aannemen dat 75074 de laatste waarde van de primaire sleutel uit de eerste set is):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Deze optie zal correct werken, maar in het algemeen is het moeilijk te optimaliseren, aangezien de voorwaarde de operator OR bevat. Als de primaire sleutel toeneemt met de OrderDate, kan de voorwaarde worden vereenvoudigd door alleen de filter op SalesOrderID te behouden. Maar als er geen strikte correlatie is tussen de waarden van de primaire sleutel en het veld waarop het resultaat is gesorteerd, dan is het in de meeste databases onmogelijk om deze OR te vermijden. Een bekende uitzondering is PostgreSQL, waar het vergelijken van tuples volledig wordt ondersteund, en de bovenstaande voorwaarde kan worden geschreven als ‘WHERE (OrderDate, SalesOrderID) < (‘2014-06-29’, 75074)’. Bij een samengestelde sleutel met deze twee velden moet een dergelijke query relatief eenvoudig zijn.
Een tweede alternatieve benadering kan bijvoorbeeld worden gevonden in of — wanneer de query naast de gegevens een speciale identificator retourneert, waarmee je de volgende set gegevens kunt ophalen. Als deze identificator een onbeperkte levensduur heeft (zoals in Cosmos DB), dan is dit een uitstekende manier om paging met voortgang tussen pagina's te implementeren (de hierboven genoemde optie #2). Mogelijke nadelen zijn: het wordt lang niet door alle databases ondersteund; de verkregen identificator voor de volgende set kan een beperkte levensduur hebben, wat in het algemeen niet geschikt is voor gebruikersinteractie (zoals bijvoorbeeld de ElasticSearch scroll API).
Complexe filtering
We complicate the task further. Let's assume there is a requirement to implement what is known as a faceted search, familiar to everyone from online stores. The above examples based on the orders table are not very illustrative in this case, so let’s switch to the Product table from the AdventureWorks database:
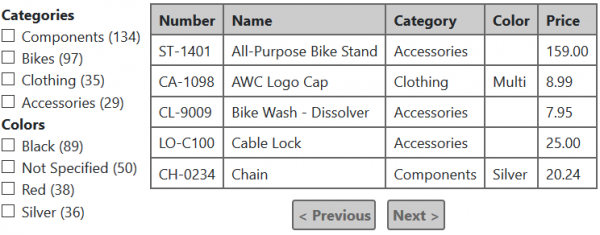
What is the idea behind faceted search? It is that for each filter item, the number of records corresponding to this criterion is displayed. taking into account the filters selected in all other categories..
For example, if we select the Bikes category and the color Black in this instance, the table will only output black bicycles, but at the same time:
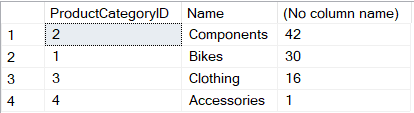
- For each criterion in the 'Categories' group, the number of products from that category in black will be shown.
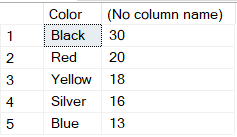
- For each criterion in the 'Colors' group, the number of bicycles in that color will be shown.
Here is an example output for such conditions:
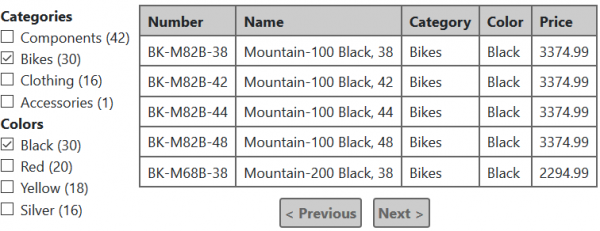
If we further mark the Clothing category, the table will also show black clothing items that are available. The number of black products in the 'Color' section will also be recalculated according to the new conditions, but in the 'Categories' section, nothing will change... I hope these examples are enough to understand the familiar algorithm of how faceted search works.
Now let's imagine how this can be implemented in a relational database. Each group of criteria, such as Category and Color, will require a separate query:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
What is wrong with this solution? Very simply - it scales poorly. Each filter section requires a separate query to count quantities, and these queries are not the lightest. In online stores, some categories can have several dozen filter sections, which can become a serious performance issue.
Usually, after these statements, I am offered some solutions, namely:
- Alle tellingen combineren in één aanvraag. Technisch gezien is dit mogelijk met het sleutelwoord UNION, maar het zal de prestaties niet significant verbeteren — de database moet namelijk voor elk van de fragmenten opnieuw beginnen.
- Aantal cachen. Dit wordt me praktisch elke keer voorgesteld wanneer ik het probleem beschrijf. Het probleem is dat dit in het algemeen onmogelijk is. Stel dat we 10 'facetten' hebben, elk met 5 waarden. Dit is een zeer 'bescheiden' situatie vergeleken met wat we in dezelfde webwinkels kunnen zien. De keuze van één facette beïnvloedt het aantal in 9 andere; met andere woorden, voor elke combinatie van criteria kunnen de aantallen verschillend zijn. In totaal zijn er in ons voorbeeld 50 criteria die de gebruiker kan kiezen, en daarmee zijn er 250 mogelijke combinaties. Voor het vullen van zo'n gegevensset is er niet genoeg geheugen of tijd. Hier kan men inbrengen dat niet alle combinaties realistisch zijn en dat een gebruiker zelden meer dan 5-10 criteria zal kiezen. Ja, het is mogelijk om luie ladingen en caching van aantallen alleen voor datgene wat ooit is gekozen te maken, maar hoe meer keuzemogelijkheden er zijn, hoe minder effectief die cache zal zijn en hoe merkbaarder de responstijden (vooral als de dataset regelmatig veranderd).
Gelukkig zijn er voor dergelijke taken al geruime tijd voldoende efficiënte oplossingen beschikbaar die voorspelbaar werken bij grote hoeveelheden data. Voor elk van deze opties is het zinvol om de herberekening van facetten en het verkrijgen van de resultatenpagina te splitsen in twee parallelle verzoeken aan de server, en de gebruikersinterface zo te organiseren dat het laden van gegevens over facetten de weergave van de zoekresultaten 'niet stoort'.
- Roep de volledige herberekening van "facet" zo min mogelijk aan. Bijvoorbeeld, herbereken niet alles bij elke wijziging van de zoekcriteria, maar vind in plaats daarvan het totale aantal resultaten dat voldoet aan de huidige voorwaarden en bied de gebruiker aan om deze te tonen — "1425 records gevonden, tonen?" De gebruiker kan ofwel doorgaan met het wijzigen van de zoekvoorwaarden of op de knop "tonen" klikken. Alleen in dat laatste geval zullen alle verzoeken voor het verkrijgen van resultaten en het herberekenen van aantallen op alle "facetten" worden uitgevoerd. Het is evident dat hierbij een verzoek voor het verkrijgen van het totale aantal resultaten en de optimalisatie ervan aan de orde komt. Deze methode komt vaak voor in veel kleine webwinkels. Het is duidelijk dat dit geen panacee is voor dit probleem, maar in eenvoudige gevallen kan het een redelijke compromislomp zijn.
- Gebruik zoekmachines om resultaten te vinden en facetten te tellen, zoals Solr, ElasticSearch, Sphinx en anderen. Ze zijn allemaal ontworpen voor het opbouwen van "facetten" en doen dit vrij effectief dankzij omgekeerde indexen. Hoe zoekmachines zijn ingericht, waarom ze in zulke gevallen effectiever zijn dan relationele databases, welke praktijken en aandachtspunten er zijn — dit is een onderwerp voor een apart artikel. Hier wil ik benadrukken dat een zoekmachine niet kan worden vervangen door de belangrijkste gegevensopslag, maar wordt gebruikt als aanvulling: alle veranderingen in de hoofd database die relevant zijn voor de zoekopdracht worden gesynchroniseerd in de zoekindex; het zoekmechanisme werkt normaal gesproken alleen met de zoekmachine en raadpleegt de hoofd database niet. Een van de belangrijkste momenten hier is hoe deze synchronisatie betrouwbaar te organiseren. Dit hangt volledig af van de vereisten voor "reactietijd". Als de tijd tussen een wijziging in de hoofd database en de "weergave" daarvan in de zoekresultaten niet kritiek is, kan er een service worden gemaakt die om de paar minuten onlangs gewijzigde records zoekt en indiceert. Als de minimale mogelijkheid van reactietijd vereist is, kan er iets worden geïmplementeerd als voor het verzenden van updates naar de zoekservice.
Conclusies
- Implementatie van server-side paging is een ernstige complicatie en het is alleen zinvol om het toe te passen voor snelgroeiende of gewoon grote datasets. Er is geen absoluut nauwkeurige richtlijn om te bepalen wat 'groot' of 'snelgroeiend' is, maar ik zou de volgende aanpak aanhouden:
- Als het verkrijgen van de volledige dataset rekening houdend met server tijd en netwerktransmissie normaal binnen de prestatie-eisen past, heeft server-side paging geen zin.
- Er kan zich een situatie voordoen waarin er voorlopig geen prestatieproblemen te verwachten zijn, omdat er weinig gegevens zijn, maar de dataset groeit voortdurend. Als een bepaalde dataset in de toekomst mogelijk niet meer aan het vorige punt voldoet, is het beter om paging direct in te plannen.
- Als er vanuit de business geen strikte vereiste is voor het tonen van het totale aantal resultaten of voor het weergeven van paginanummers, en er daarnaast geen zoekmachine in uw systeem aanwezig is, is het beter om deze aspecten niet te implementeren en optie #2 te overwegen.
- Als er een duidelijke vereiste is voor faceted search, heeft u twee opties om de prestaties niet in gevaar te brengen:
- Tel niet alle aantallen bij elke wijziging van de zoekcriteria.
- Gebruik zoekmachines zoals Solr, ElasticSearch, Sphinx en anderen. Maar het moet worden begrepen dat dit geen vervanging voor de hoofd-database kan zijn, en het moet worden gebruikt als aanvulling op de hoofdopslag om zoekproblemen op te lossen.
- Ook in het geval van faceted search is het zinvol om het ophalen van de zoekresultaatpagina en het tellen van aantallen in twee parallelle aanvragen te splitsen. Het tellen van aantallen kan meer tijd in beslag nemen dan het verkrijgen van resultaten, terwijl de resultaten belangrijker zijn voor de gebruiker.
- Als u een SQL-database gebruikt voor zoekopdrachten, moet elke codewijziging die betrekking heeft op dit onderdeel goed getest worden op prestatie op het relevante gegevensvolume (dat groter is dan het volume in de 'live' database). Het is ook wenselijk om de uitvoeringstijden van aanvragen op alle database-exemplaren te monitoren, en vooral op de 'live' versie. Zelfs als alles er op ontwikkelingsniveau goed uitzag met de queryplannen, kan de situatie veranderen naarmate het gegevensvolume groeit.
Bron: habr.com
