

Op 27 mei in de grote zaal van de DevOpsConf 2019, die plaatsvindt in het kader van het festival , tijdens de sessie 'Continue Levering', werd de presentatie 'werf — onze tool voor CI/CD in Kubernetes' gepresenteerd. Hierin worden de problemen en uitdagingen besproken waarmee iedereen wordt geconfronteerd bij het implementeren in Kubernetes, evenals de nuances die niet meteen opvallen. Door mogelijke oplossingen te bespreken, laten we zien hoe dit is gerealiseerd in onze open-source tool .
Sinds de presentatie heeft onze tool (voorheen bekend als dapp) de historische mijlpaal van 1000 sterren op GitHub bereikt — we hopen dat de groeiende gemeenschap van gebruikers het leven voor veel DevOps-engineers zal vergemakkelijken.
Dus, hier is (~47 minuten, veel informatief dan het artikel) en de belangrijkste punten in tekstvorm. Laten we beginnen!
Codelevering naar Kubernetes
In de presentatie gaat het niet langer alleen over werf, maar over CI/CD in Kubernetes, met de veronderstelling dat onze software verpakt is in Docker-containers (hierover heb ik gesproken in de ), en K8s zal worden gebruikt voor de productie-implementatie (hierover — in ).
Hoe ziet het leveren in Kubernetes eruit?
- Er is een Git-repository met code en instructies voor het bouwen. De applicatie wordt opgebouwd in een Docker-image en gepubliceerd in de Docker Registry.
- In dezelfde repository zijn er instructies over hoe de applicatie te implementeren en uit te voeren. Tijdens de implementatiefase worden deze instructies naar Kubernetes gestuurd, dat het benodigde image uit de registry haalt en deze opstart.
- Daarnaast zijn er meestal tests. Sommige hiervan kunnen worden uitgevoerd bij het publiceren van het image. Ook kan (aan de hand van dezelfde instructies) een kopie van de applicatie worden uitgerold (in een aparte namespace van K8s of in een aparte cluster) en kunnen tests daar worden uitgevoerd.
- Tot slot is er een CI-systeem dat gebeurtenissen vanuit Git (of drukknopacties) ontvangt en alle gedefinieerde fasen oproept: build, publish, deploy, test.
Hier zijn een paar belangrijke opmerkingen:
- Omdat we ongewijzigde infrastructuur hebben (immutable infrastructure), moet het applicatiebeeld dat in alle fasen wordt gebruikt (staging, productie, enz.) één zijn. Meer hierover, met voorbeelden, heb ik besproken .
- Omdat we de benadering van infrastructuur als code volgen (IaC), moeten de applicatiecode, de instructies voor het bouwen en uitvoeren ervan precies in één repository worden opgeslagen. Meer hierover — zie in .
- De leveringsketen (delivery) We zien meestal het zo: de applicatie is gebouwd, getest en gelanceerd (release stage) en dat is het — de levering heeft plaatsgevonden. Maar in werkelijkheid ontvangt de gebruiker datgene wat je hebt uitgebracht, niet op het moment dat je dit in productie hebt gebracht, en wanneer hij toegang heeft gekregen tot die productie en deze werkte. Daarom beschouw ik de leveringsketen als eindigend pas in de uitwerkingsfase (run), en als we preciezer willen zijn, zelfs op het moment dat de code uit productie is gehaald (vervangen door een nieuwe).
Laten we terugkomen op het hierboven beschreven leveringsschema in Kubernetes: dit is niet alleen door ons bedacht, maar letterlijk iedereen die met dit probleem bezig was. In wezen wordt dit patroon nu GitOps genoemd (meer over de term en de ideeën erachter kun je lezen ). Laten we naar de fases van het schema kijken.
Bouw fase (build)
Het lijkt misschien dat er in 2019 nog iets te vertellen valt over het bouwen van Docker-afbeeldingen, wanneer iedereen kan schrijven met Dockerfiles en starten docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- De grootte van de afbeelding doet er toe, dus gebruik , om alleen het noodzakelijke voor de werking van de applicatie in de afbeelding te laten.
- Het aantal lagen moet geminimaliseerd worden door samenhangende ketens van
RUN-commando's te combineren. - Echter, dit voegt problemen toe met debuggen, omdat je bij een mislukte build de juiste opdracht uit de keten moet vinden die het probleem veroorzaakte.
- De snelheid van de build is belangrijk, omdat we snel wijzigingen willen uitrollen en het resultaat willen zien. Bijvoorbeeld, we willen niet bij elke build de afhankelijkheden in de programmeertaal opnieuw opbouwen.
- Vaak zijn er uit één Git-repository veel afbeeldingen, wat je kunt oplossen met een set Dockerfiles (of benoemde stadia in één bestand) en een Bash-script voor hun opeenvolgende opbouw.
Dit was slechts de top van de ijsberg, waarmee iedereen in aanraking komt. Maar er zijn ook andere problemen, met name:
- Vaak moeten we iets mounten (bijvoorbeeld de resultaten van een commando zoals apt in een externe directory cachen).
- We willen Ansible in plaats van dat we het op shell doen.
- We willen bouwen zonder Docker (waarom hebben we een extra virtuele machine nodig, waarin we alles moeten instellen als we al een Kubernetes-cluster hebben waarop we containers kunnen draaien?).
- Parallel bouwen, die op verschillende manieren kan worden begrepen: verschillende opdrachten uit Dockerfile (indien multi-stage wordt gebruikt), meerdere commits van één repository, meerdere Dockerfile's.
- Gedistrubeerde bouw: we willen iets samenstellen in pods die "ephemerisch" zijn, omdat ze de cache verliezen, wat betekent dat deze ergens apart moet worden opgeslagen.
- Eindelijk noemde ik de top van mijn wensen automagie: het zou ideaal zijn om naar de repository te gaan, een bepaalde opdracht in te voeren en een kant-en-klaar beeld te ontvangen, samengesteld met begrip van hoe en wat goed te doen is. Persoonlijk ben ik echter niet zeker of alle nuances zo kunnen worden voorzien.
En er zijn projecten:
- — de bouwer van het bedrijf Docker Inc (al geïntegreerd in de actuele versies van Docker), die probeert al deze problemen op te lossen;
- — de bouwer van Google, die bouwen zonder Docker mogelijk maakt;
- — een poging van CNCF om automagie te creëren en, in het bijzonder, een interessante oplossing met rebase voor lagen;
- en nog veel andere tools, zoals , …
… en kijk hoeveel sterren ze op GitHub hebben. Dat wil zeggen, aan de ene kant, docker build er is iets en kan iets doen, maar feitelijk is de vraag nog niet opgelost — het bewijs daarvoor is de parallelle ontwikkeling van alternatieve bouwers, elk van hen lost een deel van de problemen op.
Bouwen in werf
Zo kwamen we bij (voorheen zoals dapp) — een Open Source-tool van het bedrijf "Flant", dat we al vele jaren maken. Het begon ongeveer 5 jaar geleden met Bash-scripts die de bouw van Dockerfile's optimaliseerden, en de laatste 3 jaar wordt er een volledige ontwikkeling gevoerd binnen één project met zijn eigen Git-repository (eerder in Ruby, en vervolgens in Go, en daarbij hernoemd). Welke bouwvragen worden opgelost in werf?
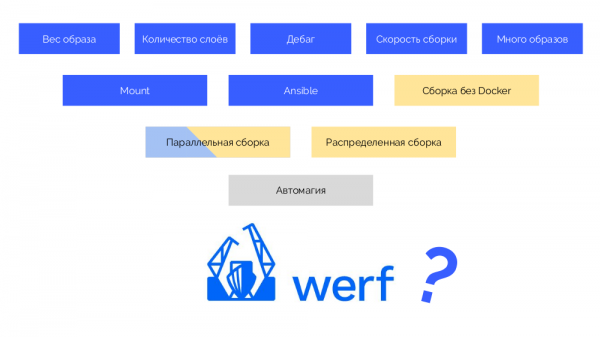
De in het blauw gemarkeerde problemen zijn al gerealiseerd, de parallelle bouw is uitgevoerd op één host, en de in het geel gemarkeerde vragen zijn we van plan om tegen het einde van de zomer af te ronden.
De publicatiefase in de registry (publish)
We hebben verzameld docker push… — wat kan er complex zijn aan het uploaden van een beeld naar de registry? En dan rijst de vraag: "Welke tag moet aan het beeld worden gegeven?" Dit ontstaat omdat we hebben Gitflow (of een andere Git-strategie) en Kubernetes, en de industrie streeft ernaar dat wat er in Kubernetes gebeurt, overeenkomt met wat er in Git wordt gedaan. Want Git is onze enige bron van waarheid.
Wat is hier moeilijk aan? Garanderen van reproduceerbaarheid: van een commit in Git, dat van nature onveranderlijk is (onveranderlijk), tot een Docker-image, dat hetzelfde moet blijven.
Het is ook belangrijk voor ons de oorsprong te bepalen, omdat we willen begrijpen uit welke commit de applicatie is samengesteld die op Kubernetes draait (dan kunnen we diff's en dergelijke doen).
Taggingstrategieën
De eerste is een eenvoudige git tag. We hebben een registry met een image, getagd als 1.0. In Kubernetes zijn er stage en production, waar dit image naartoe is gepusht. In Git maken we commits en op een gegeven moment plaatsen we een tag 2.0. We bouwen het volgens de instructies uit de repository en plaatsen het in de registry met de tag 2.0. We rollen het uit naar stage en, als alles goed is, daarna naar production.
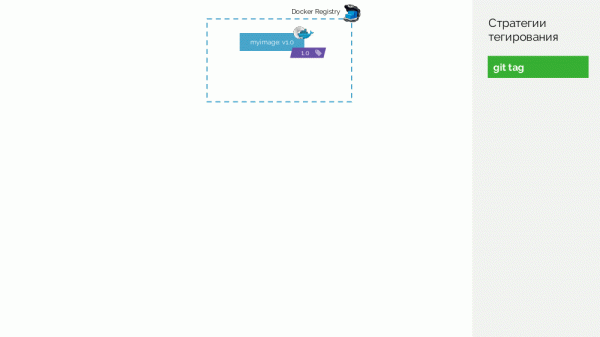
Het probleem met deze benadering is dat we eerst een tag hebben geplaatst en pas daarna getest en uitgerold. Waarom? Ten eerste is het gewoon niet logisch: we geven een versie van de software uit die we nog niet eens hebben gecontroleerd (we kunnen het niet anders doen, omdat we voor de controle een tag moeten plaatsen). Ten tweede past deze aanpak niet bij Gitflow.
De tweede optie is git commit + tag. In de master-branch is er een tag 1.0; daarvoor is er in de registry een image, uitgerold op production. Bovendien zijn er in de Kubernetes-cluster preview en staging omgevingen. Vervolgens volgen we Gitflow: in de hoofdtak voor ontwikkeling (develop) maken we nieuwe features, wat leidt tot een commit met de identificatie #c1. We bouwen het en publiceren het in de registry, gebruikmakend van deze identificatie (#c1). Met dezelfde identificatie rollen we het uit naar preview. Op dezelfde manier doen we dit met commits #c2 en #c3.
Wanneer we weten dat de features voldoende zijn, beginnen we alles te stabiliseren. In Git maken we een branch release_1.1 (gebaseerd op #c3 uit develop). Het is niet nodig om deze release te bouwen, omdat dit in de vorige stap is gedaan. Daarom kunnen we het gewoon naar staging uitrollen. We verhelpen bugs in #c4 en rollen dit op dezelfde manier uit naar staging. Tegelijkertijd is er ontwikkeling in develop, waar regelmatig veranderingen uit release_1.1worden gehaald. Op een gegeven moment hebben we een commit die is gebouwd en naar staging gepusht, waar we tevreden mee zijn (#c25).
. Dan maken we een merge (met fast-forward) van de release branch (release_1.1) in master. We plaatsen op deze commit een tag met de nieuwe versie (1.1). Maar dit image is al gebouwd in de registry, dus om het niet opnieuw te bouwen, voegen we gewoon een tweede tag toe aan het bestaande image (nu heeft het in de registry de tags #c25 en 1.1). Daarna rollen we het uit naar production.
Er is een nadeel, dat op staging één image is uitgerold (#c25), terwijl op production een andere is uitgebracht (1.1), maar we weten dat het 'fysiek' dezelfde afbeelding uit de registry is.
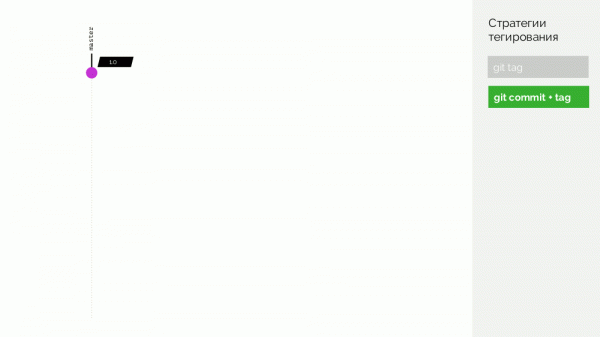
Het echte nadeel is dat er geen ondersteuning is voor merge commits, je moet fast-forward doen.
We kunnen verder gaan en een truc doen... Laten we een voorbeeld bekijken van een eenvoudige Dockerfile:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
We zullen een bestand opbouwen volgens het principe dat we nemen:
- SHA256 van de identificaties van de gebruikte afbeeldingen (
ruby:2.3ennginx:alpine), die de controlesommen van hun inhoud zijn; - alle opdrachten (
RUN,CMDenzovoort); - SHA256 van de bestanden die zijn toegevoegd.
... en we nemen de controlewaarde (opnieuw SHA256) van zo'n bestand. Dit is de handtekening van alles wat de inhoud van de Docker-image definieert.
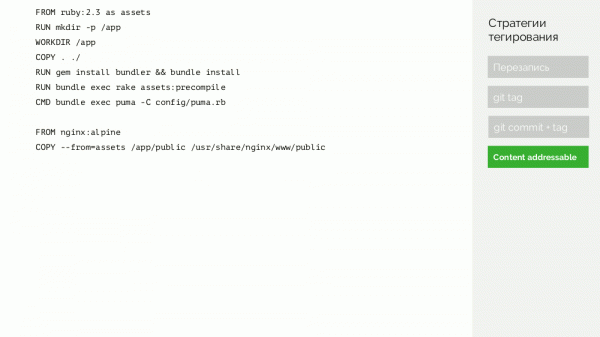
Laten we terugkeren naar het schema en in plaats van commits zullen we zulke handtekeningen gebruiken, d.w.z. beelden taggen met handtekeningen.
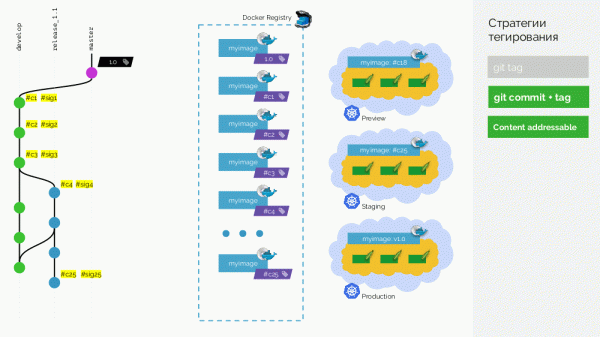
Nu, wanneer het nodig is om bijvoorbeeld wijzigingen van de release naar master te 'mergen', kunnen we een echte merge commit maken: het zal een andere identificatie hebben, maar dezelfde handtekening. Met dezelfde identificatie kunnen we de image in productie uitrollen.
Het nadeel is dat we nu niet kunnen bepalen welke commit naar productie is gehaald — controlesommen werken alleen in één richting. Dit probleem wordt opgelost door een extra laag met metadata — daarover later meer.
Tagging in werf
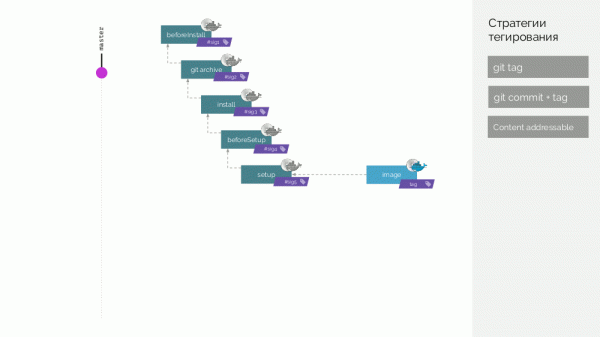
In werf zijn we nog verder gegaan en bereiden we een gedistribueerde build voor met een cache die niet op één machine wordt opgeslagen... Dus, we bouwen Docker-images van twee types, we noemen ze stage en afbeelding.
In de Git-repository van werf zijn specifieke instructies voor de build opgeslagen, die verschillende fasen van de build beschrijven (beforeInstall, install, beforeSetup, setup). De eerste stage-image bouwen we met een handtekening, gedefinieerd als de controlewaarde van de eerste stappen. Vervolgens voegen we de broncode toe, voor een nieuwe stage-image berekenen we de controlewaarde... Deze bewerkingen worden herhaald voor alle fasen, waardoor we een set stage-images krijgen. Vervolgens maken we de definitieve image, die ook metadata over zijn oorsprong bevat. En deze image taggen we op verschillende manieren (meer details later).
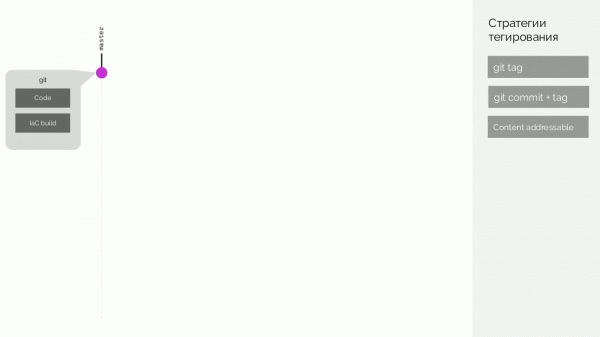
Laten we aannemen dat er een nieuwe commit verschijnt waarin alleen de applicatiecode is gewijzigd. Wat gebeurt er? Voor de codewijzigingen wordt een patch gemaakt en een nieuwe stage-image voorbereid. De handtekening wordt gedefinieerd als de checksum van de oude stage-image en de nieuwe patch. Van deze image wordt een nieuwe finale image gemaakt. Een soortgelijk gedrag zal optreden bij wijzigingen op andere fasen.
Dus, stage-images zijn een cache die gedistribueerd kan worden opgeslagen, en de images die daaruit worden gemaakt, worden in de Docker Registry geladen.
Registry opschonen
Het gaat hier niet om het verwijderen van lagen die overgebleven zijn na verwijderde tags, dat is een standaardfunctie van Docker Registry zelf. Het gaat om de situatie waarin er veel Docker-tags zich ophopen en we begrijpen dat een deel daarvan niet meer nodig is, terwijl ze ruimte innemen (en/of we ervoor betalen).
Wat zijn de opschoonstrategieën?
- Je kunt simpelweg niets doen geen opschoning. Soms is het echt gemakkelijker om wat extra ruimte te betalen dan een enorme kluwen van tags te ontrafelen. Maar dit werkt slechts tot op een bepaald punt.
- Volledige reset. Als je alle images verwijdert en alleen de actuele opnieuw opbouwt in het CI-systeem, kan er een probleem optreden. Als een container in de productie opnieuw wordt gestart, wordt er een nieuwe image gedownload die nog door niemand is getest. Dit verpest het idee van immutable infrastructure.
- Blue-green. Een registry begint vol te raken — we laden images naar een andere. Hetzelfde probleem als bij de vorige methode: op welk moment kunnen we de registry die vol raakt opschonen?
- Op tijd. Verwijder je alle images ouder dan 1 maand? Maar er is altijd wel een service die al een maand niet is bijgewerkt…
- Handmatig bepalen wat al kan worden verwijderd.
Er zijn twee echt levensvatbare opties: niets opschonen of een combinatie van blue-green + handmatig. In het laatste geval gaat het als volgt: wanneer je begrijpt dat het tijd is om de registry op te schonen, creëer je een nieuwe en voeg je gedurende bijvoorbeeld een maand alle nieuwe images eraan toe. Na een maand kijk je welke pods in Kubernetes nog steeds de oude registry gebruiken en verplaats je ze ook naar de nieuwe registry.
Waar zijn we beland in werf? Мы собираем:
- Git head: alle tags, alle branches — ervan uitgaande dat alles wat getagd is in Git ook nodig is in de images (en zo niet, dan moet het in Git worden verwijderd);
- alle pod's die momenteel in Kubernetes zijn uitgerold;
- oude ReplicaSets (dat wat onlangs is uitgerold), en we zijn ook van plan om Helm-releases te scannen en de laatste beelden daaruit te selecteren.
… en we maken van deze set een whitelist — een lijst van beelden die we niet zullen verwijderen. Alles andere wordt schoongemaakt, waarna we wezenlijke stage-beelden vinden en ook deze verwijderen.
Stadium van uitrol (deploy)
Betrouwbare declarativiteit
Het eerste punt dat ik wil benadrukken bij de uitrol, is het uitrollen van de vernieuwde configuratie van middelen, die declaratief is verklaard. Het originele YAML-document met de beschrijving van Kubernetes-middelen verschilt altijd aanzienlijk van het resultaat dat daadwerkelijk in het cluster werkt. Dit komt omdat Kubernetes toevoegt aan de configuratie:
- identificatoren;
- service-informatie;
- veel standaardwaarden;
- sectie met de huidige status;
- wijzigingen gemaakt tijdens het werk van de admission webhook;
- resultaat van verschillende controllers (en de planner).
Daarom, wanneer er een nieuwe configuratie van het middel verschijnt (nieuw), kunnen we deze niet eenvoudigweg als de huidige, 'live' configuratie overschrijven (live). Hiervoor moeten we vergelijken nieuw met de laatst toegepaste configuratie (last-applied) en de live verkregen patch toepassen.
Deze benadering wordt genoemd 2-way merge. Hij wordt bijvoorbeeld gebruikt in Helm.
Er is ook een 3-way merge, die verschilt omdat:
- bij het vergelijken last-applied en nieuw, kijken we naar wat er is verwijderd;
- bij het vergelijken nieuw en live, kijken we naar wat er is toegevoegd of veranderd;
- de samengevoegde patch passen we toe op live.
We deployen 1000+ applicaties met Helm, dus we leven feitelijk met 2-way merge. Echter, er zijn een aantal problemen die we hebben opgelost met onze patches, die Helm helpen goed te functioneren.
De werkelijke status van de uitrol
Nadat ons CI-systeem een nieuwe configuratie voor Kubernetes heeft gegenereerd na een gelegenheid, geeft het deze door voor toepassing (apply) in het cluster — met behulp van Helm of kubectl apply. Vervolgens vindt de eerder beschreven N-way merge plaats, waarop de Kubernetes API goedkeuring geeft aan het CI-systeem en deze aan zijn gebruiker.
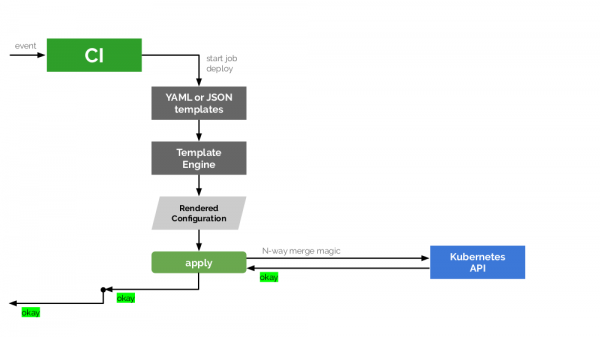
Echter, er is een enorm probleem: want succesvolle toepassing betekent niet succesvolle uitrol. Als Kubernetes begrijpt welke wijzigingen moeten worden toegepast en deze toepast — weten we nog niet wat het resultaat zal zijn. Bijvoorbeeld, de update en herstart van pod's in de frontend kunnen succesvol zijn, terwijl dat in de backend niet zo is, en we krijgen verschillende versies van de draaiende beelden van de applicatie.
Om alles goed te doen, is er een extra schakel in dit schema nodig — een speciale tracker die informatie over de status van de Kubernetes API ontvangt en deze doorgeeft voor verdere analyse van de werkelijke situatie. We hebben een Open Source-bibliotheek gemaakt in Go — (zie de aankondiging ), — die dit probleem oplost en is ingebouwd in werf.
Het gedrag van deze tracker op het niveau van werf wordt geconfigureerd met behulp van annotaties die worden toegepast op Deployments of StatefulSets. De belangrijkste annotatie is fail-mode en begrijpt de volgende waarden:
-
IgnoreAndContinueDeployProcess— negeer de problemen met het uitrollen van deze component en ga door met de deploy; -
FailWholeDeployProcessImmediately— een fout in deze component stopt het deployproces; -
HopeUntilEndOfDeployProcess— we hopen dat deze component aan het einde van de deploy werkt.
Bijvoorbeeld, zo'n combinatie van bronnen en waarden van de annotatie fail-mode:
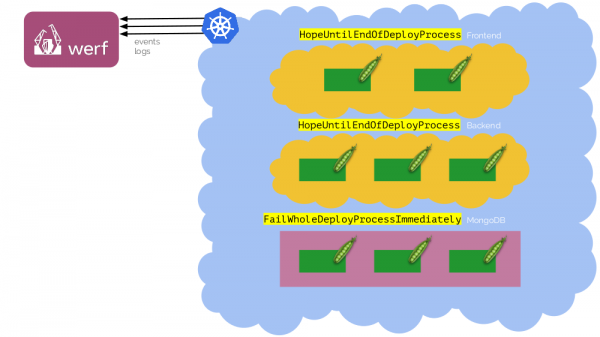
Wanneer we voor de eerste keer deployen, kan de database (MongoDB) nog niet klaar zijn — de Deployments zullen falen. Maar we kunnen wachten tot het moment dat deze opstart, en de deploy zal toch slagen.
Er zijn nog twee annotaties voor kubedog in werf:
-
failures-allowed-per-replica— het aantal toegestane uitval per replica; -
show-logs-until— regelt tot welk moment werf logs van alle uitgerolde pods toont (in stdout). Standaard is ditPodIsReady(om berichten te negeren die we waarschijnlijk niet nodig hebben wanneer een pod verkeer begint te ontvangen), maar ook de waardenControllerIsReadyenEndOfDeploy.
Wat willen we nog meer van de deploy?
Naast de twee al beschreven punten willen we graag:
- zien logs — en dan alleen de benodigde, en niet allemaal achtereen;
- de voortgang volgen, want als een taak 'stil' een paar minuten hangt, is het belangrijk om te begrijpen wat daar aan de hand is;automatische rollback
- in het geval dat er iets misgaat (en daarom is het cruciaal om de werkelijke status van de deploy te weten). De uitrol moet atomair zijn: of hij is volledig voltooid, of alles gaat terug naar de oude staat. Voor ons als bedrijf hebben we voldoende aan een CI-systeem en een hulpmiddel In plaats van een conclusie:
Conclusies
Met werf hebben we aanzienlijke vooruitgang geboekt in het oplossen van een groot aantal problemen voor DevOps-engineers en we zouden blij zijn als een breder publiek deze tool in de praktijk probeert. Samen een goed resultaat bereiken is gemakkelijker. .
Video en dia's
Video van de presentatie (~47 minuten):
Video en slides
Video van de presentatie (~47 minuten):
Presentatie van het verslag:
P.S.
Andere verslagen over Kubernetes op onze blog:
- «» (Dmitry Stolyarov; 27 april 2019 op 'Stack');
- «» (Andrey Polovov; 8 april 2019 op Saint HighLoad++);
- «» (Dmitry Stolyarov; 8 november 2018 op HighLoad++);
- «» (Dmitry Stolyarov; 28 mei 2018 op RootConf);
- «» (Dmitry Stolyarov; 7 november 2017 op HighLoad++);
- «» (Dmitry Stolyarov; 6 juni 2017 op RootConf).
Bron: habr.com
