

Logs zijn een belangrijk onderdeel van het systeem dat helpt te begrijpen of het naar verwachting functioneert (of niet). In een microservices-architectuur wordt het werken met logs een aparte discipline in een speciale olympiade. Er moeten veel vragen tegelijk worden beantwoord:
- hoe logs vanuit de applicatie te schrijven;
- waar logs te schrijven;
- hoe logs te verzenden voor opslag en verwerking;
- hoe logs te verwerken en op te slaan.
Het gebruik van populaire containerisatie-technologieën voegt extra uitdagingen toe aan het aanbod van oplossingen voor dit probleem.
Dit is precies waar de presentatie van Yuri Bushmelev over "De uitdagingen van het verzamelen en verzenden van logs" over gaat.
Wie geïnteresseerd is, kan verder lezen.
Mijn naam is Yuri Bushmelev. Ik werk bij Lazada. Vandaag zal ik vertellen hoe we onze logs hebben gemaakt, hoe we ze verzamelen en wat we erin schrijven.
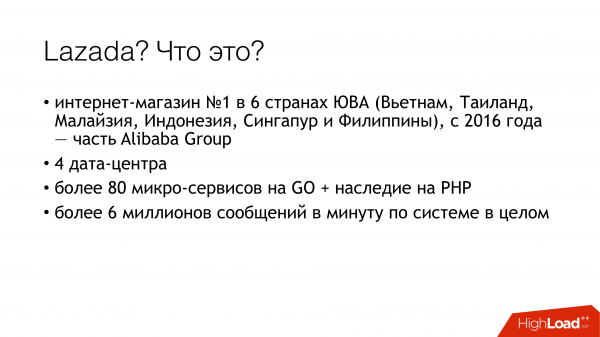
Vanuit waar komen we? Wie zijn wij? Lazada is de nummer 1 online winkel in zes landen in Zuidoost-Azië. Al deze landen zijn verdeeld over datacenters. We hebben momenteel in totaal 4 datacenters. Waarom is dit belangrijk? Omdat sommige oplossingen geboden zijn door de zeer zwakke verbinding tussen de centra. We hebben een microservices-architectuur. Ik was verrast te ontdekken dat we al 80 microservices hebben. Toen ik begon met de logtaken, waren er er slechts 20. Bovendien is er nog een aanzienlijke hoeveelheid PHP legacy waarmee we moeten leven en omgaan. Dit alles genereert momenteel meer dan 6 miljoen berichten per minuut door het systeem als geheel. Verder zal ik laten zien hoe we proberen hiermee om te gaan en waarom het zo is.
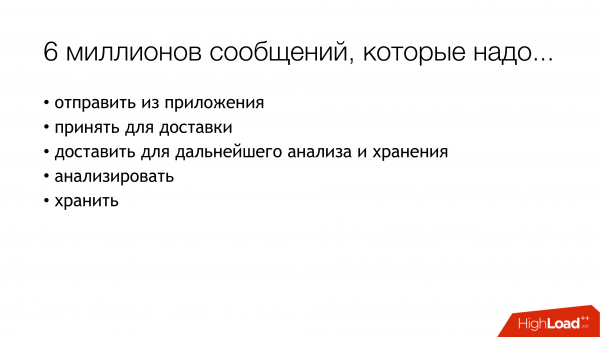
Met deze 6 miljoen berichten moeten we op de een of andere manier omgaan. Wat moeten we ermee doen? 6 miljoen berichten die moeten worden:
- verzonden vanuit de applicatie
- ontvangen voor levering
- geleverd voor analyse en opslag.
- geanalyseerd worden
- op een bepaalde manier opgeslagen worden.
Toen er drie miljoen berichten waren, had ik ongeveer dezelfde reactie. Omdat we met een paar centen begonnen. Het is duidelijk dat daar applicatielogs worden geschreven. Bijvoorbeeld, dat ik me niet kon verbinden met de database, dat ik me wel kon verbinden met de database, maar iets niet kon lezen. Maar daarnaast schrijft elke microservice ook nog een access-log. Elk verzoek dat binnenkomt op de microservice wordt in de log geregistreerd. Waarom doen we dit? Ontwikkelaars willen in staat zijn tot tracing. In elke access-log staat een veld traceid, waarmee een speciale interface verder alles uitpakt en de trace mooi weergeeft. De trace laat zien hoe het verzoek is verlopen, en dat helpt onze ontwikkelaars om sneller om te gaan met allerlei onduidelijke zaken.
Hoe ga je hiermee om? Ik zal kort de opties toelichten - hoe dit probleem in het algemeen wordt opgelost. Hoe je de taak van het verzamelen, verzenden en opslaan van logs aanpakt.
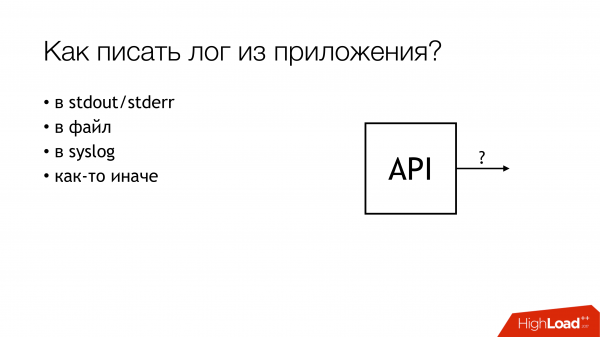
Hoe schrijf je vanuit de applicatie? Het is duidelijk dat er verschillende manieren zijn. In het bijzonder zijn er best practices, zoals modieuze experts ons vertellen. Er zijn old school methoden in twee vormen, zoals onze grootouders het vertelden. Er zijn andere manieren.
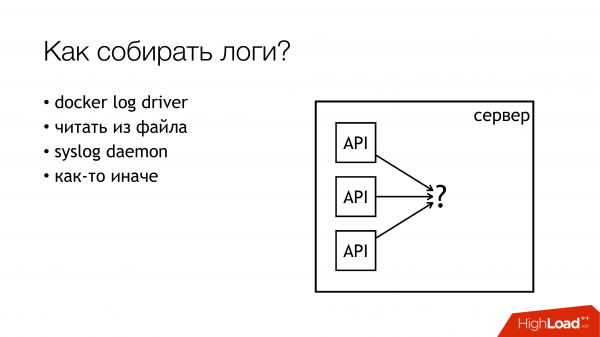
De situatie met logverzameling is ongeveer hetzelfde. Er zijn niet veel opties voor deze specifieke taak. Er zijn er meer, maar nog niet zo veel.
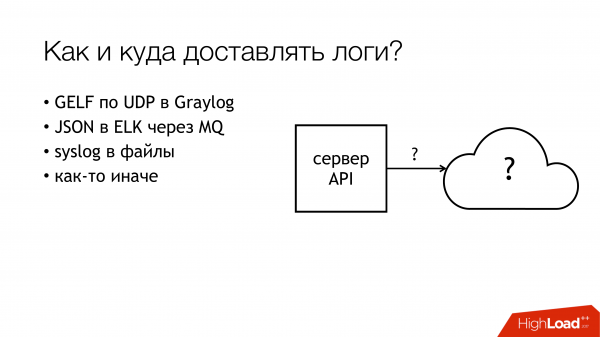
Maar wat betreft levering en daaropvolgende analyse - het aantal variaties begint te exploderen. Ik zal nu niet elke optie beschrijven. Ik denk dat de belangrijkste opties bekend zijn bij iedereen die zich in het onderwerp heeft verdiept.
Ik zal laten zien hoe we dit bij Lazada deden en hoe dit eigenlijk allemaal begon.
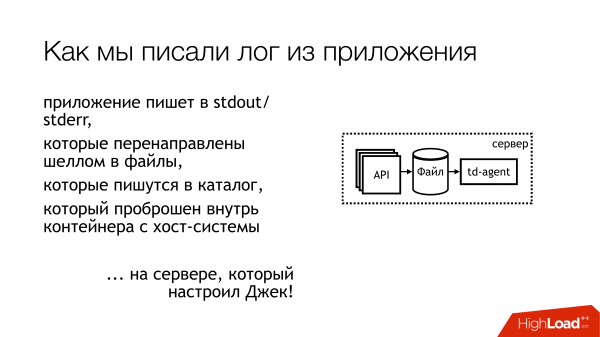
Een jaar geleden kwam ik bij Lazada, en werd ik gestuurd naar een project over logs. Het ging ongeveer zo. De log van de applicatie werd geschreven naar stdout en stderr. Iedereen deed het op de trendy manier. Maar later gooide de ontwikkelaars het uit de standaardstromen, en dan zou het wel goedkomen met de infrastructuurspecialisten. Tussen de infrastructuurspecialisten en de ontwikkelaars zijn er nog release-managers, die zeiden: "eh... nou goed, laten we het gewoon in een bestand stoppen met shell, en dat is het." En omdat dit allemaal in een container is, werd het gewoon in de container zelf verpakt, werd de map naar binnen gemapt en daar neergelegd. Ik denk dat het voor iedereen vrij duidelijk is wat daaruit ontstaan is.
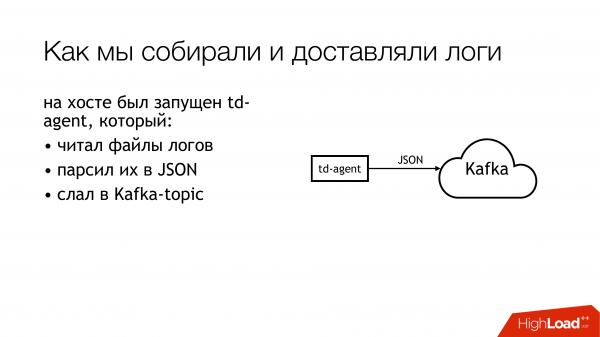
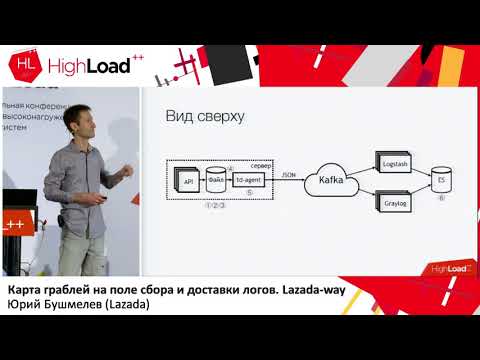
Laten we eens iets verder kijken. Hoe we deze logs hebben afgeleverd. Iemand heeft gekozen voor td-agent, dat eigenlijk fluentd is, maar niet helemaal fluentd. Ik heb de relatie tussen deze twee projecten nooit begrepen, maar ze lijken over hetzelfde te gaan. En deze fluentd, geschreven in Ruby, las logbestanden, parseerde ze naar JSON met behulp van bepaalde reguliere expressies. Vervolgens stuurde het ze naar Kafka. In Kafka hadden we voor elke API 4 aparte topics. Waarom 4? Omdat er een live-omgeving is, een staging-omgeving, en omdat er stdout en stderr zijn. Ontwikkelaars genereren deze, en infrastructuurbeheerders moeten ze in Kafka aanmaken. Dit werd echter door een andere afdeling beheerd. Daarom moest je een ticket aanmaken zodat zij daar 4 topics voor elke API konden aanmaken. Iedereen vergat dit. Kortom, het was een totale chaos.
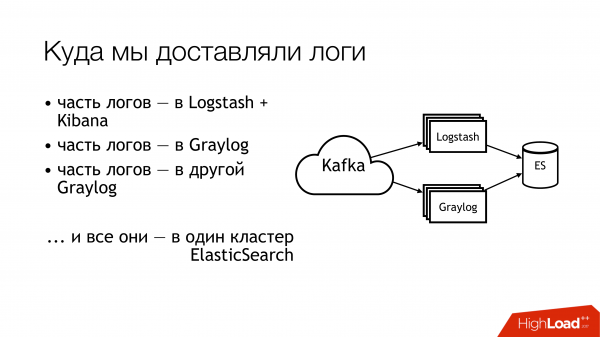
Wat deden we daar verder mee? We stuurden het naar Kafka. Vervolgens ging de helft van de logs naar Logstash. De andere helft van de logs werd verdeeld. Een deel ging naar de ene Graylog, een deel naar de andere Graylog. Uiteindelijk belandde alles in één Elasticsearch-cluster. Dus al deze rommel viel daar uiteindelijk in. Dit is niet de juiste manier om het te doen!
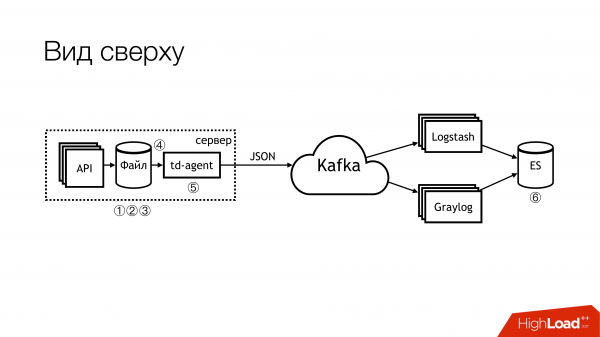
Zo ziet het eruit als je er van bovenaf naar kijkt. Dit moet je zo niet doen! Hier zijn meteen met cijfers de probleemgebieden gemarkeerd. Er zijn er in werkelijkheid meer, maar 6 zijn echt problematisch en daar moet iets mee gebeuren. Daarover zal ik nu apart vertellen.
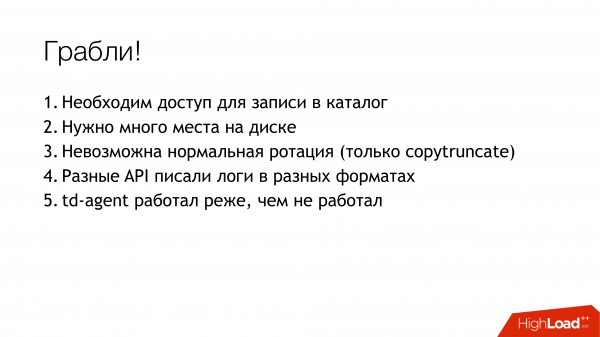
Hier (1,2,3) worden bestanden geschreven en hier zijn direct drie valkuilen.
Eerste (1) — we moeten ze ergens opslaan. Het is niet altijd wenselijk om de API de mogelijkheid te geven om direct naar een bestand te schrijven. Het is wenselijk dat de API geïsoleerd is in een container, en nog beter — dat deze alleen-read is. Ik ben systeembeheerder, dus ik heb een iets alternatieve kijk op deze zaken.
Een ander punt (2,3) is dat we veel aanvragen in de API ontvangen. De API schrijft veel gegevens naar een bestand. De bestanden worden groter. We moeten ze rouleren. Anders komt er geen enkele schijf meer aan te pas. Het is lastig om ze te rouleren omdat ze via een redirect via de shell naar een map zijn gemaakt. We kunnen het niet gewoon rouleren. We kunnen de applicatie niet zeggen dat ze de descriptors opnieuw moet openen. Want de ontwikkelaars kijken je aan als een idioot: "Welke descriptors? Wij schrijven helemaal naar stdout." De infra-mensen hebben copytruncate toegevoegd aan logrotate, wat gewoon een kopie van het bestand maakt en het origineel truncates. Daardoor eindigt meestal de schijfruimte tussen deze kopieerprocessen.
(4) We hadden verschillende formaten in verschillende API's. Ze verschilden een beetje, maar er moesten verschillende regexp's worden geschreven. Aangezien dit allemaal door Puppet werd beheerd, was er een grote bundel klassen met hun eigen problemen. Daarnaast kon td-agent het grootste deel van de tijd geheugen gebruiken, traag zijn, of gewoon doen alsof hij werkte zonder iets te doen. Van buitenaf was het onmogelijk om te begrijpen dat hij niets deed. In het beste geval viel hij gewoon uit en werd hij later weer opgestart door iemand. Of liever, er kwam een alert en iemand ging hem handmatig opnieuw opstarten.
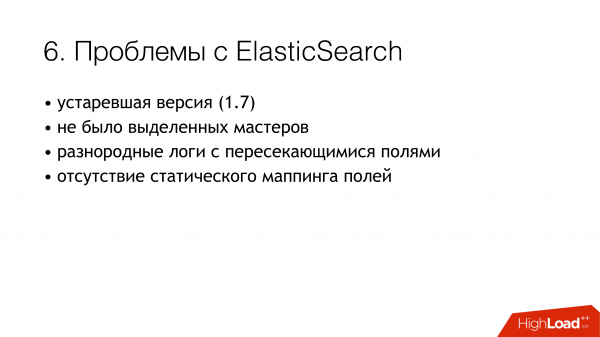
(6) En de grootste chaos was elasticsearch. Omdat het een oude versie was. We hadden destijds geen toegewezen masters. We hadden verschillende logs waarvan de velden konden overlappen. Verschillende logs van verschillende applicaties konden met dezelfde veldnamen worden geschreven, maar met verschillende gegevens binnenin. Bijvoorbeeld, de ene log binnenkomt met een Integer in het veld, bijvoorbeeld level. De andere log komt met een String in het veld level. In de afwezigheid van statische mapping krijg je een geweldig probleem. Als na de rotatie van de index in elasticsearch het eerste bericht met een string binnenkomt, dan is alles normaal. Maar als het eerste bericht met een Integer binnenkomt, worden alle daaropvolgende berichten die met een String binnenkomen gewoon afgewezen. Omdat het type van het veld niet overeenkomt.
We begonnen deze vragen te stellen. We besloten om geen schuldigen te zoeken.
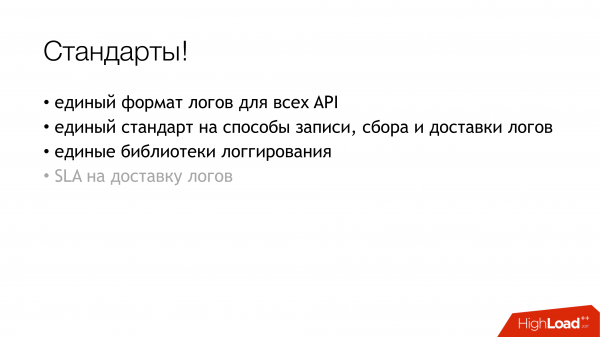
Maar we moeten iets doen! Het is duidelijk dat we standaarden moeten opstellen. Sommige standaarden hadden we al. Andere hebben we iets later ingevoerd. Gelukkig was er op dat moment al een uniforme logformat voor alle API's goedgekeurd. Dit is vastgelegd in de standaarden voor de interactie tussen de services. Dit betekent dat degenen die logs willen ontvangen, deze in dat format moeten schrijven. Als iemand de logs niet in dit format schrijft, kunnen wij niets garanderen.
Verder zouden we graag een uniforme standaard willen voor de manieren van registreren, verzenden en verzamelen van logs. Eigenlijk, waar ze geschreven moeten worden en hoe ze worden verzonden. De ideale situatie is wanneer in projecten dezelfde bibliotheek wordt gebruikt. Er is een aparte loggingbibliotheek voor Go en een aparte voor PHP. Iedereen die bij ons is, zou deze bibliotheken moeten gebruiken. Op dit moment zou ik zeggen dat we dit voor ongeveer 80% voor elkaar hebben. Maar sommigen blijven het moeilijk maken.
En daar bovenaan (op de dia) begint de 'SLA voor de levering van logs' langzaam zichtbaar te worden. Deze bestaat nog niet, maar we zijn er mee bezig. Het is namelijk erg handig wanneer de infrastructuur zegt dat als je in dit specifieke format op deze plek schrijft en niet meer dan N berichten per seconde, we dit met een bepaalde waarschijnlijkheid daar zullen afleveren. Dit scheelt veel hoofdpijn. Als er een SLA is, is dat geweldig!
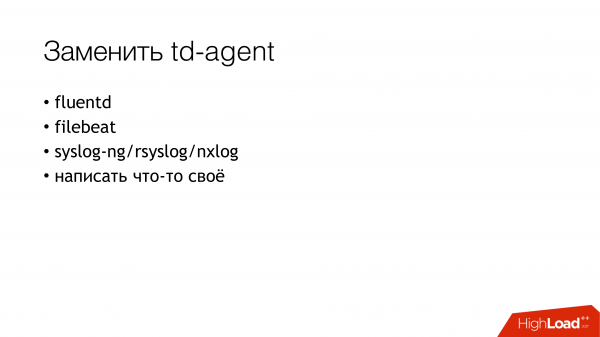
Hoe zijn we het probleem gaan aanpakken? Het grootste probleem was met td-agent. Het was onduidelijk waar onze logs naartoe gingen. Werden ze afgeleverd? Werden ze verzameld? Waar zijn ze überhaupt? Daarom hebben we als eerste punt besloten om td-agent te vervangen. Ik heb hier kort de opties opgesomd voor wat we als vervanging kunnen gebruiken.
Fluentd. Ten eerste ben ik ermee in aanraking gekomen bij mijn vorige baan en het viel daar ook regelmatig uit. Ten tweede, het is hetzelfde, maar gericht op specifieke behoeften.
Filebeat. Wat was handig voor ons? Dat het op Go is geschreven en wij veel expertise in Go hebben. Dus als het nodig was, konden we het aanpassen naar onze wensen. Daarom hebben we het niet gekozen, zodat er zelfs geen verleiding zou zijn om het voor ons aan te passen.
Een voor de hand liggende oplossing voor systeembeheerders blijft het gebruik van diverse syslogs in deze hoeveelheden (syslog-ng/rsyslog/nxlog).
Of we schrijven iets zelf, maar dat hebben we afgewezen, net als filebeat. Als we iets schrijven, dan beter iets dat nuttig is voor het bedrijf. Voor de levering van logs is het beter om iets kant-en-klaars te gebruiken.
Daarom komt de keuze eigenlijk neer op de keuze tussen syslog-ng en rsyslog. Ik heb gekozen voor rsyslog, simpelweg omdat we al klassen voor rsyslog in Puppet hadden, en ik vond geen duidelijke verschillen tussen de twee. Het is beide syslog. Ja, sommige hebben slechtere documentatie, anderen beter. De één kan het zo, de ander kan het anders.
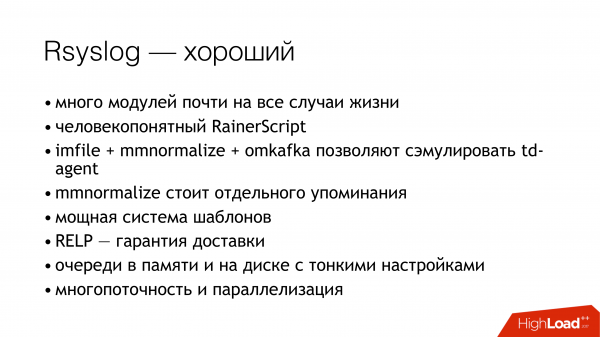
En een beetje over rsyslog. Ten eerste is het geweldig, omdat het veel modules heeft. Het heeft een begrijpelijke RainerScript (moderne configuratietaal). Een geweldig voordeel is dat we met standaardtools het gedrag van td-agent konden simuleren, en voor de applicaties veranderde er niets. Met andere woorden, we vervangen td-agent door rsyslog, en alles andere blijven we voorlopig ongemoeid. En we krijgen meteen een werkende afhandeling. Verder, mmnormalize — dat is een fantastische functie in rsyslog. Het stelt ons in staat om logs te parseren, maar niet met Grok en regexp. Het maakt een abstracte syntaxisboom. Het parseert logs ongeveer zoals een compiler de brontekst parseert. Dit zorgt ervoor dat het heel snel werkt, weinig CPU verbruikt, en het is over het algemeen een echt geweldige functie. Er zijn nog veel andere voordelen. Daar ga ik verder niet op in.
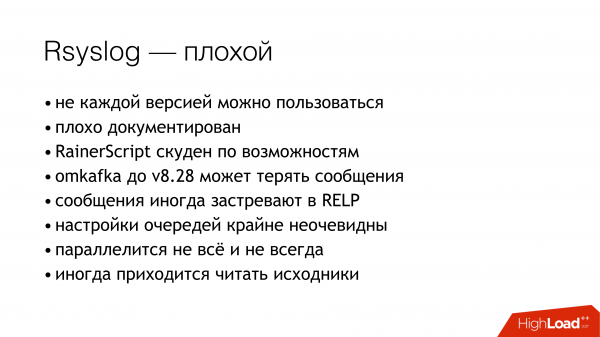
Rsyslog heeft nog een heleboel nadelen. Deze zijn ongeveer dezelfde als de voordelen. De belangrijkste problemen zijn dat je moet weten hoe je het moet configureren, en dat je de juiste versie moet kiezen.
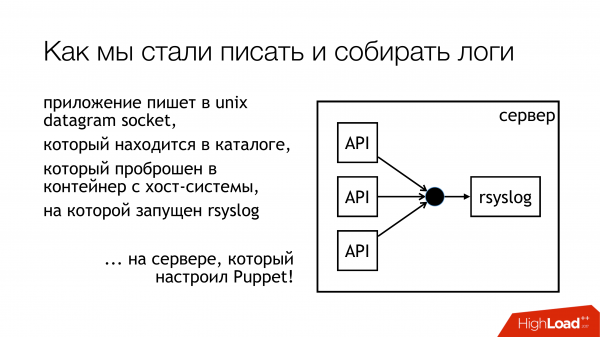
We hebben besloten om logs in een unix socket te schrijven. En niet in /dev/log, omdat daar een rommel van system logs is, er is journald in die pipeline. Dus laten we in een aangepaste socket schrijven. We zullen het koppelen aan een aparte ruleset. We zullen niets met elkaar vermengen. Het zal allemaal transparant en begrijpelijk zijn. Zo hebben we het eigenlijk gedaan. De map met deze sockets is gestandaardiseerd en wordt doorgegeven aan alle containers. Containers kunnen de socket die ze nodig hebben zien, openen en er in schrijven.
Waarom geen bestand? Omdat iedereen het heeft gelezen , die probeerde een bestand naar docker door te geven, en ontdekte dat na het herstarten van rsyslog de file descriptor veranderde, en docker dat bestand verloor. Het houdt iets anders open, maar het is niet de socket waar ze naar schrijven. We besloten dat we dit probleem zouden omzeilen, en bovendien het probleem van vergrendeling zouden omzeilen.
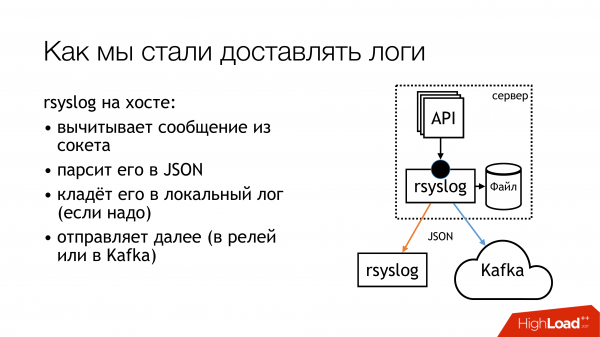
Rsyslog voert de acties uit die op de dia staan en stuurt logs of naar relays of naar Kafka. Kafka komt overeen met de oude manier. Een relay — dat is waar ik heb geprobeerd puur rsyslog te gebruiken voor logafhandeling. Zonder Message Queue, met standaard rsyslog-tools. In principe werkt dat.
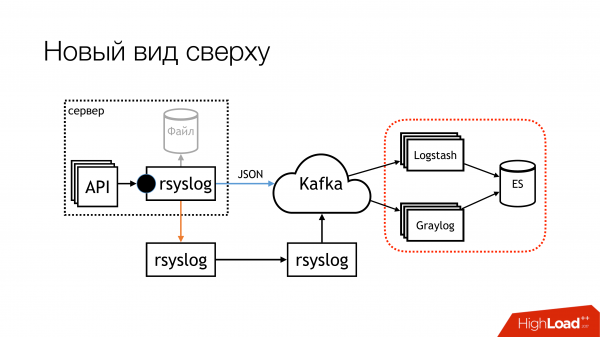
Maar er zijn nuances aan hoe ze later in dit gedeelte (Logstash/Graylog/ES) moeten worden gestopt. Dit gedeelte (rsyslog-rsyslog) wordt gebruikt tussen datacenters. Hier is een gecomprimeerde tcp-link die bandwidth bespaart en daardoor de kans vergroot dat we logs van een ander datacenter ontvangen wanneer de verbinding verzadigd is. Want we hebben Indonesië, waar het slecht gaat. Daar is dit een voortdurend probleem.
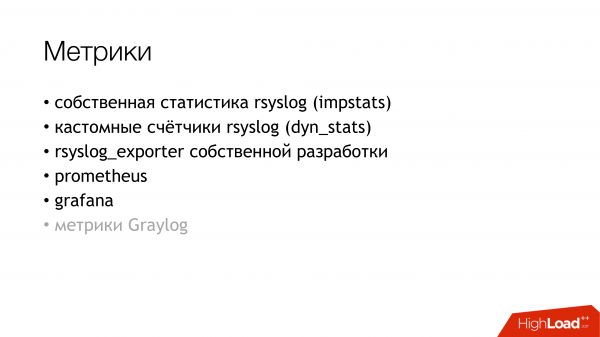
We hebben nagedacht over hoe we eigenlijk kunnen monitoren met welke waarschijnlijkheid de logs die we uit de applicatie hebben geregistreerd, de andere kant bereiken. We besloten om metrics in te voeren. Rsyslog heeft zijn eigen statistiekenmodule waarin verschillende tellers zich bevinden. Bijvoorbeeld, het kan je de grootte van de wachtrij tonen, of hoeveel berichten in een bepaalde actie zijn aangekomen. Hieruit kan je al iets halen. Daarnaast heeft het aangepaste tellers die je kunt instellen, en dan toont het je bijvoorbeeld het aantal berichten dat een bepaalde API heeft geregistreerd. Vervolgens heb ik de rsyslog_exporter schrijf op Python en we hebben dit allemaal naar Prometheus gestuurd en grafieken gebouwd. We wilden graag de Graylog-metrics, maar we hebben nog geen tijd gehad om deze in te stellen.
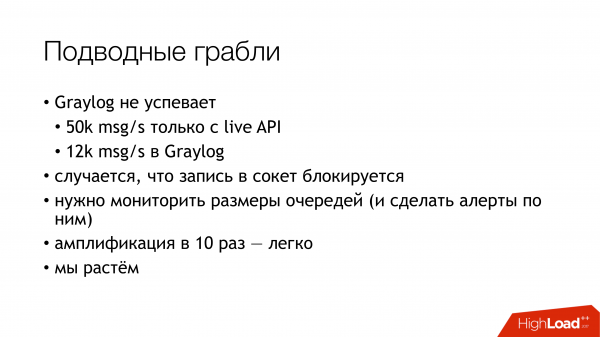
Waar waren de problemen? De problemen ontstonden omdat we (ENIGE MAAT!) ontdekten dat onze Live API 50.000 berichten per seconde schreef. Dit is alleen de Live API zonder staging. En Graylog toont ons slechts 12.000 berichten per seconde. Er ontstond een redelijke vraag: waar zijn de restanten? Hieruit concludeerden we dat Graylog het simpelweg niet aankon. We hebben gekeken, en inderdaad, Graylog kon deze stroom niet aan met Elasticsearch.
Verder, andere ontdekkingen die we tijdens het proces hebben gedaan.
Schrijvingen naar sockets worden geblokkeerd. Hoe is dit gebeurd? Toen ik rsyslog gebruikte voor levering, brak op een gegeven moment de verbinding tussen de datacenters. De levering stopte op de ene plek, stopte op de andere plek. Dit leidde tot een volle wachtrij op de machine met de API's die naar de rsyslog-socket schrijven. De wachtrij vulde zich. Vervolgens vulde de wachtrij voor schrijven naar de unix-socket zich, die standaard 128 pakketten is. En de volgende write() in de applicatie wordt geblokkeerd. Toen we in de bibliotheek keken die we gebruiken in de Go-applicaties, stond er dat schrijven naar de socket in non-blocking modus gebeurt. We waren er zeker van dat er niets werd geblokkeerd. Omdat we dat hadden gelezen. , die hierover schreef. Maar er is één punt. Rondom deze oproep was er ook een eindeloze lus waarin constant geprobeerd werd om een bericht in de socket te stoppen. Dat hebben we niet opgemerkt. We moesten de bibliotheek herschrijven. Sindsdien is deze meerdere keren veranderd, maar nu hebben we alle blokkades in alle subsysteem verwijderd. Daarom kun je rsyslog stoppen en zal er niets uitvallen.
Het is nodig om de grootte van de wachtrijen te monitoren, wat helpt om niet in deze val te trappen. Ten eerste kunnen we monitoren wanneer we beginnen berichten te verliezen. Ten tweede kunnen we monitoren dat we in het algemeen problemen hebben met de bezorging.
En nog een onaangenaam punt — amplificatie van 10 keer in een microservices-architectuur — dat is heel makkelijk. We hebben niet zoveel binnenkomende verzoeken, maar door de grafiek waar deze berichten verder doorheen gaan, door de access-logboeken, verhogen we de belasting van de logboeken echt met ongeveer tien keer. Helaas heb ik de exacte cijfers niet kunnen berekenen, maar microservices zijn zo. Dat moet in gedachten worden gehouden. Het blijkt dat het verzamelsysteem voor logs momenteel het meest belast is in Lazada.
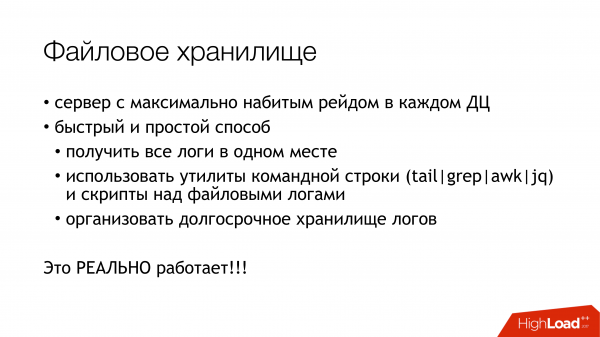
Hoe los je het probleem met Elasticsearch op? Als je snel logs op één plek wilt krijgen, zodat je niet over alle machines hoeft te rennen en ze daar hoeft te verzamelen, gebruik dan een bestandssysteem. Dat werkt gegarandeerd. Het wordt gemaakt van elke server. Je hoeft alleen maar wat schijven in te steken en syslog in te stellen. Daarna heb je gegarandeerd al je logs op één plek. Vervolgens kun je rustig Elasticsearch, Graylog of iets anders configureren. Maar je hebt al al je logs, en bovendien kun je ze opslaan zolang de schijfruimtes het toelaten.
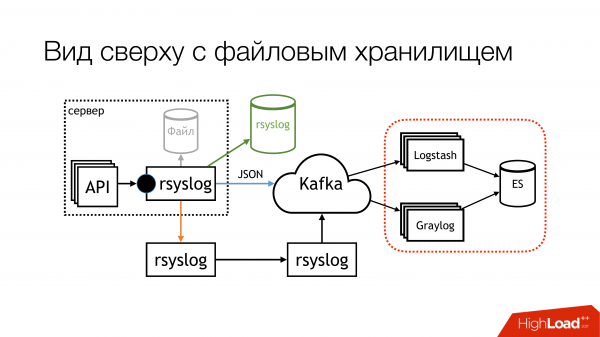
Op het moment van mijn presentatie zag het schema er zo uit. We zijn praktisch gestopt met schrijven naar bestanden. Waarschijnlijk schakelen we de rest nu uit. Op de lokale machines waarop de API's draaien, zullen we stoppen met schrijven naar bestanden. Ten eerste is er een bestandssysteem dat erg goed werkt. Ten tweede is de ruimte op deze machines altijd beperkt, dus die moet continu gemonitord worden.
Dit deel met Logstash en Graylog, dat is echt vervelend. Daarom moeten we ervan af. We moeten iets ééns kiezen.
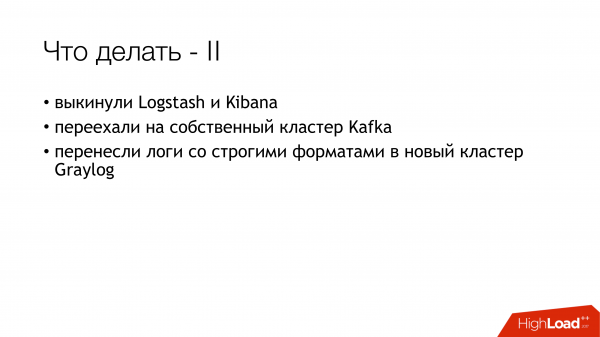
We hebben besloten om Logstash en Kibana te verwijderen. Omdat we een beveiligingsafdeling hebben. Wat is de link? De link is dat Kibana zonder X-Pack en zonder Shield geen toegang kan beperken tot de logs. Daarom hebben we Graylog genomen. Dit heeft alles wat we nodig hebben. Ik vind het niet leuk, maar het werkt. We hebben nieuwe hardware aangeschaft, Graylog opnieuw geïnstalleerd en alle logs met strikte formaten naar een aparte Graylog overgebracht. We hebben het probleem van verschillende typen identieke velden organisatorisch opgelost.
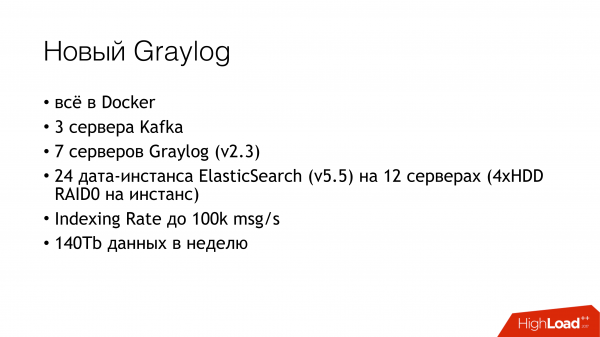
Wat zit er eigenlijk in de nieuwe Graylog? We hebben alles gewoon in Docker opgeslagen. We hebben een aantal servers genomen, drie Kafka-instanties uitgerold, 7 Graylog-servers van versie 2.3 opgezet (omdat we versie 5 van Elasticsearch wilden). Alles is op RAID met HDD's opgebouwd. We zagen een indexing rate van tot 100.000 berichten per seconde. We zagen dat er 140 terabyte aan gegevens per week was.
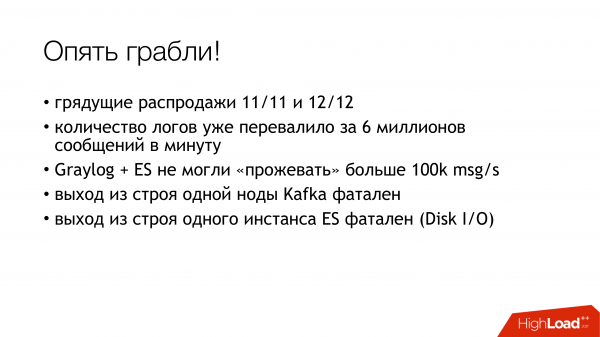
En weer zijn er problemen! We hebben twee uitverkopen in het vooruitzicht. We zijn overgestapt op 6 miljoen berichten. Onze Graylog kan het niet bijbenen. We moeten op de een of andere manier weer overleven.
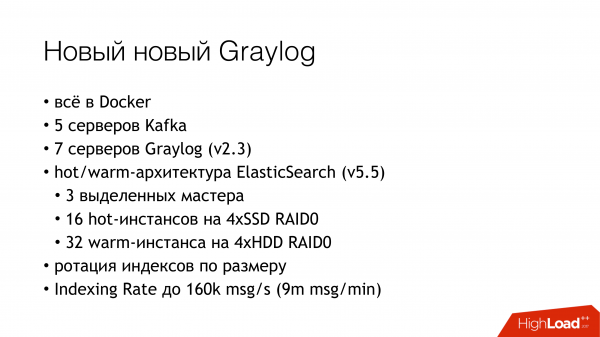
Zo hebben we overleefd. We hebben nog een paar servers en SSD's toegevoegd. Op dit moment leven we op deze manier. We verwerken nu al 160.000 berichten per seconde. We hebben de limiet nog niet bereikt, dus het is nog onduidelijk hoeveel we hier daadwerkelijk uit kunnen halen.
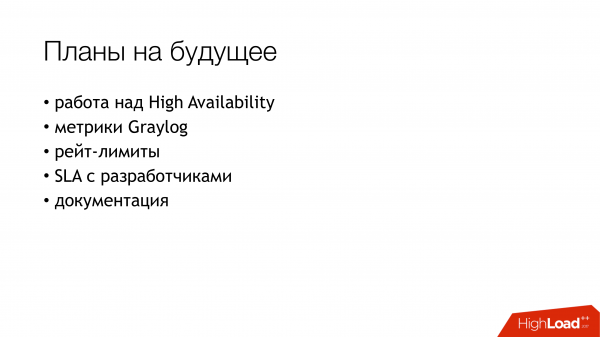
Dit zijn onze plannen voor de toekomst. Van deze zijn, in feite, het belangrijkste waarschijnlijk de hoge beschikbaarheid. We hebben het nog niet. Een paar machines zijn identiek ingesteld, maar alles gaat voorlopig via één machine. We moeten tijd besteden om failover tussen hen in te stellen.
Verzamel metrics van Graylog.
Maak een rate limit zodat onze chaotische API geen invloed heeft op onze bandbreedte en alles eromheen.
En ten slotte, teken een SLA met de ontwikkelaars waarin staat dat we dit aantal kunnen bedienen. Als je meer schrijft, dan sorry.
En schrijf documentatie.
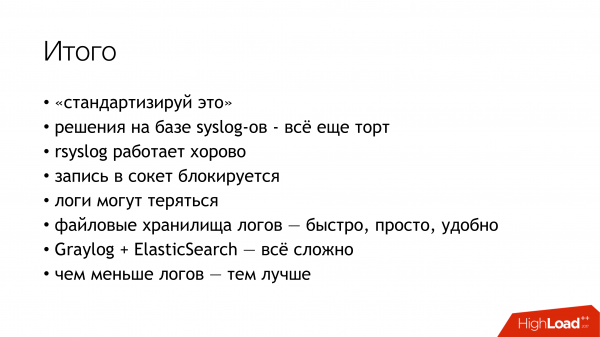
Kort samengevat, de resultaten van alles wat we hebben doorgemaakt. Ten eerste, normen. Ten tweede, syslog is een taart. Ten derde, rsyslog werkt precies zoals in de presentatie beschreven. Laten we nu naar de vragen gaan.
Vragen.
Vraag: Waarom hebben jullie uiteindelijk besloten om niet te nemen… (filebeat?)
Antwoord: We moeten naar een bestand schrijven. Dat wilde ik heel graag vermijden. Wanneer je API duizenden berichten per seconde schrijft, dan is het niet haalbaar om elke uur te roteren, het is gewoon geen optie. Je kunt naar een pipe schrijven. Waarop de ontwikkelaars vroegen: "Wat gebeurt er als het proces waar we naar schrijven, crasht?" Ik wist niet wat ik ze moest antwoorden, dus zei ik: "Oké, laten we dat maar niet doen."
Vraag: Waarom schrijf je logs gewoon niet in HDFS?
Antwoord: Dit is de volgende fase. We hebben er in het begin over nagedacht, maar omdat we op dit moment geen middelen hebben om het aan te pakken, blijft het bij een langetermijnoplossing.
Vraag: Het kolomformaat zou geschikter zijn.
Antwoord: Ik begrijp het helemaal. We zijn 'voor' met beide handen.
Vraag: Je schrijft naar rsyslog. Daar kun je zowel TCP als UDP gebruiken. Maar als je UDP gebruikt, hoe garandeer je dan de aflevering?
Antwoord: Er zijn twee zaken. Ten eerste, ik zeg meteen tegen iedereen dat we de aflevering van logs niet garanderen. Want wanneer ontwikkelaars komen en zeggen: 'Laten we financiële gegevens daar gaan schrijven, en dan kunnen jullie ze ergens opslaan voor het geval er iets gebeurt', antwoorden we: 'Prima! Laten we zeggen dat je moet blokkeren op het schrijven naar de socket en dit in transacties moet doen, zodat je ons dit gegarandeerd in de socket plaatst en zorgt dat we het aan de andere kant ontvangen.' En op dat moment heeft iedereen meteen geen zin meer. En omdat ze er geen zin in hebben, wat voor vragen hebben ze dan nog voor ons? Als je geen garantie wilt geven voor het schrijven naar de socket, waarom zouden wij dan de aflevering garanderen? We doen ons best. We proberen echt zoveel mogelijk en zo goed mogelijk af te leveren, maar we geven geen 100% garantie. Daarom is het niet nodig om daar financiële gegevens naar te schrijven. Daar zijn databases met transacties voor.
Vraag: Wanneer de API een bericht aan het loggen genereert en de controle overdraagt aan microservices, zijn jullie niet tegen het probleem gelopen dat berichten van verschillende microservices in de verkeerde volgorde aankomen? Dit creëert verwarring.
Antwoord: Het is normaal dat ze in verschillende volgordes aankomen. Je moet hierop voorbereid zijn. Want welke netwerbezorging garandeert je de volgorde, of je moet daar speciaal middelen voor inzetten. Als we opslagbestanden bekijken, dan slaat elke API logs in zijn eigen bestand op. Eigenlijk legt rsyslog ze in mappen. Elke API heeft daar zijn eigen logs waar je naartoe kunt gaan en kijken, en dan kun je ze op timestamp in die logs vergelijken. Als ze in Graylog gaan kijken, worden ze daar op timestamp gesorteerd. Dan is alles in orde.
Vraag: De timestamp kan op milliseconden verschillen.
Antwoord: De timestamp wordt door de API zelf gegenereerd. Dat is eigenlijk het hele punt. We hebben NTP. De API genereert de timestamp al in het bericht. Dat voegt rsyslog niet toe.
Vraag: Het is niet helemaal duidelijk hoe de interactie tussen datacenters plaatsvindt. Binnen het datacenter is het duidelijk hoe de logs zijn verzameld en verwerkt. Hoe vindt de interactie tussen datacenters plaats? Leeft elk datacenter zijn eigen leven?
Antwoord: Bijna. Elke land bevindt zich in een bepaald datacenter. Momenteel is er geen verdeling, zodat één land verspreid is over verschillende datacenters. Daarom hoeven ze niet te worden samengevoegd. Binnen elk centrum is er een Log Relay. Dit is een Rsyslog-server. In feite zijn er twee beheermachines. Ze zijn identiek ingesteld. Maar voorlopig gaat het verkeer gewoon via een van hen. Deze verzamelt alle logs. Het heeft een schijfq voor het geval dat. Het comprimeert de logs en verzendt ze naar het centrale datacenter (in Singapore), waar ze verder naar Graylog worden gestuurd. En in elk datacenter is er zijn eigen bestandopslag. In geval we de verbinding verliezen, hebben we alle logs daar. Ze blijven daar. Ze worden daar opgeslagen.
Vraag: Krijg je logs van daaruit in noodgevallen?
Antwoord: Je kunt daarheen gaan (naar de bestandsopslag) en kijken.
Vraag: Hoe monitoren jullie dat jullie geen logs verliezen?
Antwoord: We verliezen ze eigenlijk, en we monitoren dit. De monitoring is een maand geleden gestart. In de bibliotheek die de Go API gebruikt, zijn er metrics. Het kan tellen hoe vaak het niet gelukt is om naar de socket te schrijven. Momenteel is er een slimme heuristiek. Er is een buffer. Het probeert berichten vanuit die buffer naar de socket te schrijven. Als de buffer vol raakt, begint het ze te droppen. En het telt hoeveel het er heeft gedropt. Als de tellers beginnen vol te raken, komen we daarachter. Ze komen nu ook in Prometheus, en in Grafana kun je grafieken bekijken. Je kunt waarschuwingen instellen. Maar het is nog onduidelijk aan wie ze moeten worden gestuurd.
Vraag: Bewaar je logs met een redundantie in Elasticsearch. Hoeveel replicas heb je?
Antwoord: Eén replica.
Vraag: Is dat slechts één replica?
Antwoord: Dit is een master en een replica. De data wordt in twee exemplaren opgeslagen.
Vraag: Heb je de grootte van de rsyslog buffer aangepast?
Antwoord: Wij schrijven datagrammen naar een aangepaste Unix-socket. Dit legt ons meteen de beperking van 128 kilobyte op. We kunnen er niet meer in schrijven. Dit hebben we in de standaard vastgelegd. Wie in de storages wil komen, schrijft 128 kilobyte. Bibliotheken snijden het af en zetten een vlag dat het bericht is afgekapt. In onze standaard van het bericht is er een speciaal veld dat aangeeft of het bij het schrijven is afgekapt of niet. Dus we hebben de mogelijkheid om ook dat moment te traceren.
Vraag: Schrijft u corrupte JSON?
Antwoord: Corrupt JSON zal worden afgewezen ofwel tijdens de relay omdat het pakket te groot is. Of het wordt afgewezen door Graylog, omdat het JSON niet kan parseren. Maar hier zijn nuances die moeten worden opgelost en deze zijn grotendeels verbonden aan rsyslog. Ik heb daar al enkele issues ingevuld die nog moeten worden aangepakt.
Vraag: Waarom Kafka? Heeft u RabbitMQ geprobeerd? Werkt Graylog niet bij zulke belastingen?
Antwoord: Met Graylog werkt het niet. Maar Graylog zelf werkt wel. Het is echt problematisch. Het is een bijzondere zaak. En eigenlijk is het niet nodig. Ik zou liever rechtstreeks vanuit rsyslog naar Elasticsearch schrijven en daarna naar Kibana kijken. Maar we moeten het met de beveiligingsmedewerkers afstemmen. Dit is een mogelijke ontwikkeling voor ons, wanneer we Graylog verwijderen en Kibana gebruiken. Logstash heeft geen zin, omdat ik al het bovenstaande ook met rsyslog kan doen. En hij heeft een module om naar Elasticsearch te schrijven. We proberen met Graylog te leven. We hebben het zelfs een beetje geoptimaliseerd. Maar er is nog ruimte voor verbetering.
Over Kafka. Historically, it just happened. When I arrived, it was already there, and logs were already being written to it. We simply set up our cluster and moved the logs into it. We manage it, we know how it’s feeling. Regarding RabbitMQ… we don’t really click with RabbitMQ. But RabbitMQ works well for us. We have it in production, and there were problems with it. Just before the sale, we had it magically fixed, and now it works properly. But before that, I wasn't ready to release it into production. There’s another point. Graylog can read AMQP 0.9, while rsyslog can write AMQP 1.0. And there’s no solution in between that can do both. It's either one or the other. So for now, it’s only Kafka. But there are nuances there too. The version of rsyslog that we're using can lose the entire message buffer that it pulled from rsyslog. For now, we’re living with that.
Vraag: Do you use Kafka because it was already there for you? Is it not used for any other purposes?
Antwoord: The Kafka that was there is used by the Data Science team. It’s a completely separate project, and unfortunately, I can’t say anything about it. I’m not in the loop. It was under the Data Science team’s management. When the logs were being established, they decided to use it so they wouldn’t have to set up another one. Now we’ve updated Graylog and lost compatibility, because it’s an old version of Kafka. We had to establish our own. At the same time, we got rid of those four topics for each API. We created one large topic for all live, one large topic for all staging, and we just dump everything there. Graylog processes everything in parallel.
Vraag: Why do we need this magic with sockets? Have you tried using the syslog log driver for containers?
Antwoord: Op het moment dat we deze vraag stelden, waren onze relaties met Docker gespannen. Het was Docker 1.0 of 0.9. Docker zelf was vreemd. Ten tweede, als je ook nog logs erin probeert te stoppen... Ik heb een onbewezen vermoeden dat het alle logs door zichzelf haalt, via de Docker-daemon. Als een API gek wordt, dan blokkeren de andere API's omdat ze stdout en stderr niet kunnen versturen. Ik weet niet wat dat gaat veroorzaken. Ik heb een gevoel dat we op dit punt de syslog-driver van Docker niet moeten gebruiken. Onze functionele testafdeling heeft een eigen kleine Graylog-cluster met logs. Ze gebruiken Docker-logdrivers en daar lijkt het goed te gaan. Maar ze schrijven GELF direct naar Graylog. Toen we dit alles organiseerden, hadden we gewoon iets nodig dat werkte. Misschien, als iemand later komt en zegt dat het al een eeuwigheid goed werkt, proberen we het uit.
Vraag: Jullie doen de levering tussen datacenters met rsyslog. Waarom niet met Kafka?
Antwoord: We doen het eigenlijk op beide manieren. Om twee redenen. Als de verbinding helemaal kapot is, dan komen al onze logs, zelfs in gecomprimeerde vorm, er niet doorheen. En Kafka laat ze gewoon verliezen in het proces. Op deze manier voorkomen we dat die logs vastlopen. We gebruiken in dat geval Kafka direct. Als onze verbinding goed is en we willen deze vrijmaken, dan gebruiken we rsyslog. Maar eigenlijk kan je het zo instellen dat het zelf wat niet doorlaat dropt. Op dit moment gebruiken we gewoon op sommige plekken rsyslog rechtstreeks en op andere plaatsen Kafka.
Bron: habr.com
