

Pavel Selivanov, solutions architect at Southbridge and lecturer at Slyurm, presented a talk at DevOpsConf 2019. This presentation is part of one of the in-depth topics of the Kubernetes course 'Slyurm Mega.'
takes place in Moscow from November 18 to 20.
— Moscow, November 22 to 24.
are available at any time.
Below is the transcript of the presentation.
Good day, colleagues and sympathizers. Today I will talk about security.
I see that there are many security professionals in the room today. I apologize in advance if I use security terminology differently than what you're used to.
It so happened that about six months ago, I came across a public Kubernetes cluster. Public means that there are a certain number of namespaces, and within those namespaces, there are users isolated in their own namespace. All these users belong to different companies. Well, it was supposed that this cluster would be used as a CDN. That is, you are given a cluster, assigned a user, and you come to your namespace to deploy your front ends.
My previous company tried to sell such a service. I was asked to poke around the cluster to see whether such a solution was suitable or not.
I entered this cluster. I was given limited rights and a limited namespace. The guys there understood what security meant. They had read about Role-based Access Control (RBAC) in Kubernetes—and they configured it so that I could not launch pods separately from deployments. I don't remember the task I was trying to solve by launching a pod without a deployment, but I really wanted to launch a pod. I decided to check what rights I had in the cluster, what I could and could not do, and what they had configured. Also, I'll explain what they have set up incorrectly in RBAC.
It turned out that within two minutes, I gained admin access to their cluster, looked into all the neighboring namespaces, and saw running production fronts of companies that had already purchased the service and deployed. I barely stopped myself from going to someone’s front and placing some inappropriate word on the homepage.
I will illustrate with examples how I did this and how to protect against it.
Maar laat me mezelf eerst voorstellen. Mijn naam is Pavel Selivanov. Ik ben architect bij Southbridge. Ik heb verstand van Kubernetes, DevOps en allerlei trendy dingen. Samen met de ingenieurs van Southbridge bouwen we dit alles, terwijl ik adviseer.
Naast onze kernactiviteiten hebben we onlangs projecten gelanceerd die Slërms heten. We proberen onze vaardigheden met Kubernetes een beetje naar de massa te brengen, om andere mensen ook te leren werken met K8s.
Waarover ik vandaag ga praten. Het onderwerp van de presentatie is duidelijk - over de beveiliging van de Kubernetes-cluster. Maar ik wil meteen zeggen dat dit onderwerp heel uitgebreid is - en daarom wil ik meteen duidelijk maken waarover ik zeker niet ga spreken. Ik ga het niet hebben over versleten termen die al honderd keer op het internet zijn behandeld. Dingen als RBAC en certificaten.
Ik ga het hebben over de problemen die ik en mijn collega's hebben met de beveiliging van de Kubernetes-cluster. We zien deze problemen zowel bij de providers die Kubernetes-clusters aanbieden, als bij de klanten die bij ons komen. En zelfs bij klanten die via andere advies- en beheersbedrijven bij ons komen. De schaal van de tragedie is in werkelijkheid heel groot.
Bijna drie punten waarover ik vandaag zal spreken:
- Gebruikersrechten vs pod-rechten. Gebruikersrechten en pod-rechten zijn niet hetzelfde.
- Informatie verzamelen over de cluster. Ik zal laten zien welke informatie van de cluster kan worden verzameld zonder speciale rechten in deze cluster te hebben.
- DoS-aanval op de cluster. Als we de informatie niet kunnen verzamelen, kunnen we de cluster in ieder geval uitschakelen. Ik zal vertellen over DoS-aanvallen op de besturingselementen van de cluster.
Een ander algemeen ding dat ik zal noemen - waarop ik dit alles heb getest, waarop ik zeker kan zeggen dat dit allemaal werkt.
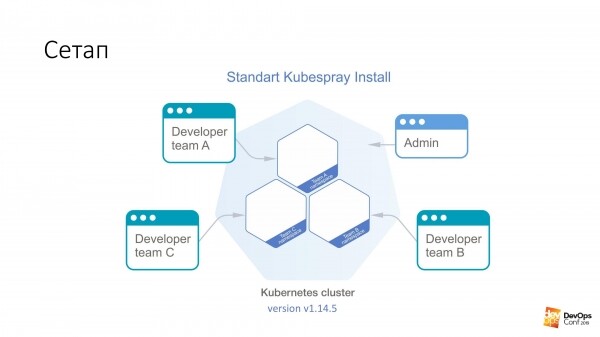
Als basis nemen we de installatie van de Kubernetes-cluster met behulp van Kubespray. Voor degenen die het niet weten, dit is eigenlijk een set rollen voor Ansible. We gebruiken het constant in ons werk. Het is handig omdat het overal kan worden geïmplementeerd - zowel op hardware als ergens in de cloud. Één installatiemethode is in principe voor alles geschikt.
In deze cluster heb ik Kubernetes v1.14.5. De hele Kubernetes-cluster die we gaan bekijken, is verdeeld in namespaces, elk namespace belongs tot een afzonderlijk team, en leden van dit team hebben toegang tot hun eigen namespace. Ze kunnen niet naar andere namespaces gaan, alleen naar de hunne. Maar er is een admin-account die rechten heeft over de hele cluster.
Ik heb beloofd dat het eerste wat we doen, het verkrijgen van adminrechten op de cluster zal zijn. We hebben een speciaal voorbereide pod nodig die de Kubernetes-cluster kan kraken. Alles wat we hoeven te doen is deze toe te passen in de Kubernetes-cluster.
kubectl apply -f pod.yamlDeze pod zal binnenkomen op een van de masternodes van de Kubernetes-cluster. En de cluster zal ons vervolgens blij een bestand teruggeven dat admin.conf heet. In dit bestand zijn alle admin-certificaten opgeslagen, en daarnaast is de API van de cluster geconfigureerd. Zo eenvoudig kan je admintoegang krijgen, ik denk, tot 98% van de Kubernetes-clusters.
Ik herhaal, deze pod is gemaakt door een ontwikkelaar in jouw cluster, die toegang heeft om zijn voorstellen in een kleine namespace te implementeren; hij is volledig beperkt door RBAC. Hij had geen rechten. Maar desondanks werd het certificaat teruggegeven.
Laten we nu het speciaal voorbereide pod bespreken. We draaien het op een willekeurig imago. Voor het voorbeeld nemen we debian:jessie.
We hebben zoiets:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Wat is een tolerantie? Masters in de Kubernetes-cluster zijn meestal gemarkeerd met iets dat een taint wordt genoemd. En de essentie van deze 'taint' is dat er geen pods op master nodes kunnen worden toegewezen. Maar niets staat in de weg om in elke pod aan te geven dat deze tolerantie heeft voor de 'taint'. De sectie Toleration geeft precies aan dat als er op een node een NoSchedule is, onze pod tolerantie heeft voor deze taint — en er zijn geen problemen.
Vervolgens zeggen we dat onze pod niet alleen tolerant is, maar ook specifiek op de master wil komen. Omdat er op de masters het waardevolste is wat we nodig hebben — alle certificaten. Daarom zeggen we nodeSelector — en we hebben een standaardlabel op de masters, waarmee we precies die nodes uit de cluster kunnen selecteren die masters zijn.
Met deze twee secties zal de pod zeker op de master aankomen. En hem zal daar toestemming worden gegeven om te verblijven.
Maar alleen aankomen op de master is niet genoeg voor ons. Dit zal ons niets opleveren. Daarom hebben we vervolgens deze twee dingen:
hostNetwork: true
hostPID: true
We geven aan dat onze pod, die we draaien, zal leven in de kernel namespace, in de network namespace en in de PID namespace. Zodra de pod op de master draait, kan hij alle echte, actieve interfaces van deze node zien, al het verkeer beluisteren en de PID's van alle processen zien.
Daarna is het een kwestie van weinig. Neem etcd en lees wat je wilt.
Het interessantste is deze mogelijkheid van Kubernetes, die standaard aanwezig is.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
En de essentie daarvan is dat we in de pod die we draaien, zelfs zonder rechten op deze cluster, kunnen aangeven dat we een volume van het type hostPath willen creëren. Dat betekent dat we een pad van de host dat we draaien, als een volume nemen. En verder noemen we het name: host. Dit hele hostPath monteren we in de pod. In dit voorbeeld in de directory /host.
Nogmaals, we hebben de pod gezegd om naar de master te komen, hostNetwork en hostPID te verkrijgen — en de hele root van de master in deze pod te monteren.
Je begrijpt dat we in Debian bash draaien, en deze bash draait onder root. Dat betekent dat we net root op de master hebben gekregen, zonder enige rechten in de Kubernetes-cluster te hebben.
Daarna is de hele taak — in de pod gaan naar de directory /host /etc/kubernetes/pki, als ik het goed heb, daar alle mastercertificaten van de cluster ophalen en zo de admin van de cluster worden.
Als je het zo bekijkt, zijn dit een van de meest gevaarlijke rechten in de pods — ongeacht welke rechten de gebruiker heeft:
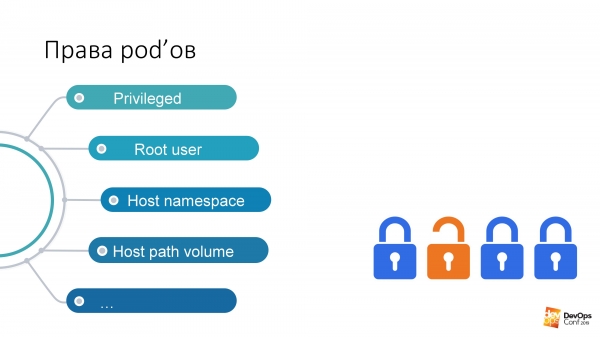
Als ik het recht heb om een pod in een bepaalde namespace van de cluster te draaien, dan heeft deze pod deze rechten standaard. Ik kan privileged pods draaien, wat vrijwel alle rechten betekent, praktisch root op de node.
Mijn favoriet — Root user. En Kubernetes heeft zo'n optie Run As Non-Root. Dat is een soort bescherming tegen hackers. Weten jullie wat een "Moldavische virus" is? Als je een hacker bent en in mijn Kubernetes-cluster komt, vragen wij, arme beheerders: "Geef alstublieft aan in uw pods, waarmee u mijn cluster gaat hacken, run as non-root. Anders kan het zo zijn dat je een proces in je pod als root start, en het zal heel gemakkelijk zijn om mij te hacken. Bescherm jezelf alstublieft tegen jezelf."
Host path volume — naar mijn mening de snelste manier om het gewenste resultaat van de Kubernetes-cluster te verkrijgen.
Maar wat moeten we met al dit doen?
Gedachten die bij elke normale administrator moeten opkomen wanneer ze met Kubernetes aan de slag gaan: 'Aha, ik zei al dat Kubernetes niet werkt. Het heeft gaten. En heel dat systeem is waardeloos.' In werkelijkheid is er zoiets als documentatie, en als je daar kijkt, is er een sectie .
Dit is een yaml-object — we kunnen het maken in de Kubernetes-cluster — dat de veiligheidsaspecten regelt met betrekking tot de beschrijving van pods. Het beheert de rechten voor het gebruik van verschillende hostNetwork, hostPID en bepaalde types volume die in de pods zijn bij de uitvoering. Met behulp van de Pod Security Policy kan dit allemaal worden beschreven.
Het interessante aan de Pod Security Policy is dat in de Kubernetes-cluster alle installateurs van PSP niet alleen niet zijn beschreven, maar standaard zijn uitgeschakeld. De Pod Security Policy wordt geactiveerd met behulp van een admission plugin.
Oké, laten we de Pod Security Policy in de cluster implementeren, en zeggen dat we bepaalde systeem-pods in een namespace hebben, waartoe alleen beheerders toegang hebben. Laten we zeggen dat in alle andere pods de rechten beperkt zijn. Waarschijnlijk hebben ontwikkelaars geen behoefte om bevoorrechte pods in jouw cluster uit te voeren.
En voor ons lijkt alles goed te zijn. En onze Kubernetes-cluster kan niet binnen twee minuten worden gehackt.
Er is een probleem. Waarschijnlijk, als je een Kubernetes-cluster hebt, is er monitoring ingesteld. Ik durf zelfs te voorspellen dat als je monitoring in jouw cluster hebt, het Prometheus wordt genoemd.
Wat ik nu ga vertellen geldt zowel voor de Prometheus-operator als voor Prometheus in zijn pure vorm. Het punt is, als ik zo snel geen admin kan krijgen in de cluster, betekent dit dat ik meer moet zoeken. En dat kan ik doen met behulp van jouw monitoring.
Waarschijnlijk heeft iedereen dezelfde artikelen op Habr gelezen, en monitoring bevindt zich in de namespace monitoring. Helm-chart heet bij iedereen ongeveer hetzelfde. Ik ga ervan uit dat als je helm install stable/prometheus doet, je ongeveer dezelfde namen zult krijgen. En waarschijnlijk hoef ik geen DNS-naam in jouw cluster te raden. Omdat het standaard is.
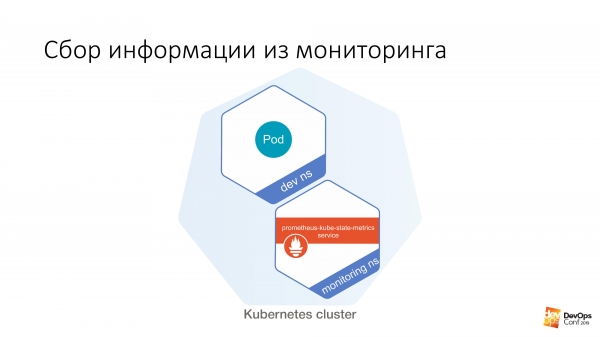
Vervolgens hebben we een bepaalde dev ns, waarin we een bepaalde pod kunnen starten. En vanuit deze pod is het heel gemakkelijk om dit te doen:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics is een van de Prometheus-exporteurs die statistieken verzamelt vanuit de API van Kubernetes zelf. Er is veel informatie beschikbaar over wat er draait in je cluster, wat de status is en welke problemen er zijn.
Een eenvoudig voorbeeld:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Met een eenvoudige curl-aanroep vanuit een niet-geprivilegieerde pod kun je deze informatie verkrijgen. Als je niet weet welke versie van Kubernetes je draait, kan het je dat eenvoudig vertellen.
En het leukste is dat je, naast het gebruik van kube-state-metrics, net zo goed rechtstreeks naar Prometheus kunt gaan. Je kunt daar metrics verzamelen. Je kunt zelfs metrics daaruit opbouwen. In theorie kun je zelfs een query vanuit het cluster naar Prometheus sturen die deze gewoon uitschakelt. En dan zal je monitoring helemaal niet meer functioneren.
Dan ontstaat de vraag of er enige externe monitoring is die jouw monitoring in de gaten houdt. Zojuist kreeg ik de mogelijkheid om in het Kubernetes-cluster te opereren zonder enige gevolgen voor mij. Je zou zelfs niet weten dat ik daar bezig ben, omdat de monitoring al niet meer werkt.
Evenals met PSP, heb je het gevoel dat het probleem is dat al deze trendy technologieën - Kubernetes, Prometheus - simpelweg niet werken en vol gaten zitten. In werkelijkheid is dat niet het geval.
Er is zoiets als - .
Als je een normale admin bent, weet je waarschijnlijk dat Network Policy gewoon een andere yaml is, waarvan er al genoeg in het cluster zijn. En sommige Network Policies zijn absoluut niet nodig. Zelfs als je hebt gelezen wat een Network Policy is, dat het een yaml-firewall van Kubernetes is die de toegangsrechten tussen namespaces en pods beperkt, ben je waarschijnlijk tot de conclusie gekomen dat een firewall in yaml-formaat in Kubernetes op basis van abstracties... Nee, dat is zeker niet nodig.
Zelfs als uw beveiligingsexperts niet weten dat u met uw Kubernetes heel eenvoudig en gemakkelijk een zeer granulaire firewall kunt bouwen, hoeft u zich daar geen zorgen over te maken. Mocht dit nog niet bekend zijn en vragen ze niet: "Geef ons dat..." Dan heeft u in ieder geval Network Policy nodig om de toegang te beperken tot bepaalde serviceplaatsen die vanuit uw cluster kunnen worden aangesproken zonder enige autorisatie.
Zoals in het voorbeeld dat ik gaf, kunt u kube state metrics uit elke namespace in het Kubernetes-cluster ophalen zonder daar enige rechten voor te hebben. Network policies hebben de toegang uit alle andere namespaces naar de monitoring namespace geblokkeerd, en dat is het: geen toegang, geen problemen. In alle charts die beschikbaar zijn, zowel de standaard Prometheus als die van de operator, is er gewoon in de Helm values-optie de mogelijkheid om network policies voor hen in te schakelen. U hoeft het alleen maar in te schakelen, en ze zullen werken.
Er is hier echter één probleem. Als een normale ervaren admin heeft u waarschijnlijk besloten dat network policies niet nodig zijn. En na het lezen van diverse artikelen op sites zoals Habr, heeft u besloten dat flannel, vooral met de host-gateway modus, het beste is wat u kunt kiezen.
Wat te doen?
U kunt proberen de netwerkoplossing die u in uw Kubernetes-cluster hebt, te herdeplooiën en deze te vervangen door iets functioneler, zoals Calico. Maar ik wil meteen zeggen, het is behoorlijk niet-triviaal om de netwerkoplossing in een actief Kubernetes-cluster te wijzigen. Ik heb dit twee keer opgelost (beide keren overigens theoretisch), maar zelfs op Slurm hebben we laten zien hoe dit moet. Voor onze trainees hebben we gedemonstreerd hoe je de netwerkoplossing in een Kubernetes-cluster kunt wijzigen. In principe kunt u proberen dit te doen zonder downtime in het productiecluster. Maar waarschijnlijk lukt het u niet.
En het probleem kan werkelijk heel eenvoudig worden opgelost. In het cluster zijn certificaten, en u weet dat de certificaten over een jaar vervallen. Welnu, de gebruikelijke oplossing met certificaten in het cluster is: waarom zouden we ons daar druk om maken, we richten gewoon een nieuwe cluster op, in de oude kan het vervallen, en we herdeplooien alles. Echter, zodra het vervalt, hebben we een dag dat alles stil ligt, maar kijk, dan hebben we wel een nieuwe cluster.
Wanneer u de nieuwe cluster opzet, voegt u ook Calico toe in plaats van flannel.
Wat te doen als uw certificaten voor honderd jaar zijn uitgegeven en u van plan bent de cluster niet opnieuw in te zetten? Er is zoiets als Kube-RBAC-Proxy. Dit is een geweldige ontwikkeling, het stelt u in staat om het als een sidecar container in elke pod in de Kubernetes-cluster te integreren. En het voegt feitelijk autorisatie via RBAC van Kubernetes zelf toe aan deze pod.
Er is één probleem. Eerder was deze Kube-RBAC-Proxy oplossing ingebouwd in de Prometheus-operator. Maar dat is er later niet meer. De moderne versies zijn afhankelijk van het feit dat u een netwerkbeleid heeft en deze gebruikt om te sluiten. Daarom moet het chart een beetje herschreven worden. In feite, als u gaat naar , zijn er voorbeelden van hoe dit als sidecars te gebruiken, en de charts moeten minimaal herschreven worden.
Er is nog een klein probleem. Niet alleen Prometheus geeft zijn metrics overal aan. Al onze componenten van de Kubernetes-cluster kunnen ook hun metrics geven.
Maar zoals ik al zei, als je geen toegang tot de cluster kunt krijgen en informatie kunt verzamelen, kun je op zijn minst wat schade aanrichten.
Dus ik zal snel twee manieren laten zien waarop je de gezondheid van een Kubernetes-cluster kunt bederven.
Je zult lachen als ik dit vertel, het zijn twee gevallen uit de praktijk.
Methode één. Uitputting van bronnen.
We starten nog een speciale pod. Het zal zo'n sectie hebben.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Zoals je weet, requests zijn de hoeveelheid CPU en geheugen die op de host wordt gereserveerd voor specifieke pods met requests. Als we een vierkernige host in de Kubernetes-cluster hebben, en er komt een pod binnen met vier CPU-requests, dan kan er geen enkele andere pod met requests naar deze host komen.
Als ik zo'n pod start, en dan het commando geef:
$ kubectl scale special-pod --replicas=...Dan kan niemand meer in de Kubernetes-cluster worden gedeployed. Omdat op alle nodes de requests op zullen zijn. En zo kan ik uw Kubernetes-cluster stoppen. Als ik dit 's avonds doe, kan ik de deploys behoorlijk lang stopzetten.
Als we opnieuw in de Kubernetes-documentatie kijken, zien we iets dat een Limit Range wordt genoemd. Dit stelt de bronnen voor clusterobjecten in. U kunt een Limit Range-object in YAML schrijven, het toepassen in bepaalde namespaces — en vervolgens kunt u in deze namespace aangeven dat u standaard-, maximale en minimale bronnen voor de pods heeft.
Met zo'n mechanisme kunnen we gebruikers beperken in specifieke product-neilspacen van teams in de mogelijkheden om ongewenste dingen op hun pods aan te geven. Maar helaas, zelfs als u de gebruiker vertelt dat hij geen pods met requests van meer dan één CPU mag starten, is er zo'n geweldige scale-commando, of via het dashboard kunnen ze de schaal ook doen.
En hieruit komt methode twee voort. We starten 11 111 111 111 111 pods. Dat is elf miljard. Dit is niet omdat ik dat getal heb verzonnen, maar omdat ik het zelf heb gezien.
Echte geschiedenis. Laat op de avond was ik al van plan om het kantoor te verlaten. Ik kijk, in de hoek zit een groep ontwikkelaars en doet iets nerveus met laptops. Ik ga naar de jongens toe en vraag: "Wat is er aan de hand?"
Een beetje eerder, rond negen uur 's avonds, was een van de ontwikkelaars van plan naar huis te gaan. En hij besloot: "Ik ga mijn applicatie naar één schalen." Hij drukte op één, maar de internetverbinding was een beetje traag. Hij drukte nog een keer op de één, hij duwde op de één, klikte op Enter. Hij drukte overal op waar hij kon. Toen kwam het internet weer tot leven — en alles begon naar dat getal te schalen.
Echter, dit verhaal vond niet plaats op Kubernetes, op dat moment was het Nomad. Dit eindigde ermee dat, na een uur van onze pogingen om Nomad te stoppen van zijn hardnekkige pogingen om te schalen, Nomad antwoordde dat het niet zou stoppen met schalen en niets anders zou doen. "Ik ben moe, ik ga weg." En het klapte dicht.
Natuurlijk heb ik geprobeerd hetzelfde op Kubernetes te doen. Elf miljard pods maakten Kubernetes niet blij; hij zei: "Ik kan niet. Overschrijdt interne limieten." Maar 1 000 000 000 pods kon hij wel aan.
In reactie op een miljard pods is Kubernetes er niet op achteruit gegaan. Het begon inderdaad op te schalen. Naarmate het proces vorderde, kostte het steeds meer tijd om nieuwe pods te creëren. Maar het proces ging door. Het enige probleem is dat als ik in mijn namespace onbeperkt pods kan starten, ik, zelfs zonder requests en limieten, zoveel pods kan lanceren met bepaalde taken dat de nodes beginnen te verzakken op het gebied van geheugen en CPU. Wanneer ik zoveel pods start, moet de informatie daaruit naar de opslag komen, dat wil zeggen etcd. En wanneer er te veel informatie binnenkomt, begint de opslag te traag te reageren — en dan heeft Kubernetes vertragingen.
En er is nog een probleem... Zoals je weet, zijn de stuurdevices van Kubernetes niet één centraal ding, maar meerdere componenten. Onder andere is er de controller manager, scheduler, enzovoort. Al deze jongens zullen tegelijkertijd onnodig, chaotisch werk gaan verrichten, dat na verloop van tijd steeds meer tijd in beslag gaat nemen. De controller manager zal nieuwe pods creëren. De scheduler zal proberen een nieuwe node voor hen te vinden. Je zult waarschijnlijk binnenkort geen nieuwe nodes meer in je cluster hebben. Het Kubernetes-cluster zal steeds trager gaan werken.
Maar ik besloot nog een stap verder te gaan. Zoals je weet, is er in Kubernetes een functie die een service wordt genoemd. En standaard werkt deze service waarschijnlijk met behulp van IP tables in je clusters.
Als je bijvoorbeeld een miljard pods start en daarna met een script Kubernetes teksten vraagt om nieuwe services te creëren:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
Op alle nodes van het cluster zullen ongeveer gelijktijdig continu nieuwe regels voor iptables gegenereerd worden. En voor elke service zullen er een miljard regels voor iptables worden gegenereerd.
Ik heb dit getest bij enkele duizenden, tot aan tien. En het probleem is dat SSH op de node al best problematisch wordt bij dit aantal. Omdat pakketten, die door zoveel ketens gaan, zich niet erg goed voelen.
En dit kan ook allemaal worden opgelost met Kubernetes. Er is zo'n object, de Resource quota. Dit stelt het aantal beschikbare bronnen en objecten in een namespace in het cluster in. We kunnen een yaml-object in elke namespace van het Kubernetes-cluster aanmaken. Met dit object kunnen we aangeven dat er voor deze namespace een bepaald aantal verzoeken en limieten is toegewezen, en daarna kunnen we zeggen dat er in deze namespace 10 services en 10 pods kunnen worden aangemaakt. En de ontwikkelaar kan zich in de avonden uitleven. Kubernetes zal hem zeggen: "Je kunt je pods niet zo opschalen, omdat je de resource quota overschrijdt." Probleem opgelost. .
Er ontstaat één probleem. U voelt hoe moeilijk het wordt om een namespace in Kubernetes te creëren. Om het te maken, moeten we heel veel dingen in overweging nemen.
Resource quota + Limit Range + RBAC
• Maak een namespace aan
• Maak een limitrange aan binnen de namespace
• Maak een resourcequota aan binnen de namespace
• Maak een serviceaccount voor CI aan
• Maak een rolebinding aan voor CI en gebruikers
• Optioneel: start de benodigde hulppods
Daarom wil ik van deze gelegenheid gebruikmaken om mijn ontwikkelingen te delen. Er is zoiets als de operator SDK. Dit is een manier om operators voor Kubernetes in het cluster te schrijven. U kunt operators schrijven met behulp van Ansible.
In het begin was het geschreven in Ansible, maar toen zag ik dat er een operator SDK was en herschreef ik de Ansible-rol naar een operator. Deze operator maakt het mogelijk een object in het Kubernetes-cluster aan te maken dat een team wordt genoemd. Binnen het team kan het de omgeving voor dit team in yaml beschrijven. En binnen de omgeving van het team kan het beschrijven welke middelen we toewijzen.
Klein .
En tot slot. Wat moeten we hiermee doen?
Eerst. Pod Security Policy — dat is goed. En hoewel geen enkele Kubernetes-installer ze tot nu toe gebruikt, is het toch nodig om ze in je clusters te gebruiken.
Network Policy — dat is geen onnodige functie. Dit is wat je echt nodig hebt in het cluster.
LimitRange/ResourceQuota — tijd om dit te gebruiken. We zijn hier al lang mee bezig en ik was er lange tijd van overtuigd dat iedereen dit toepaste. Blijkbaar is dit zeldzaam.
Naast wat ik in de presentatie heb genoemd, zijn er niet gedocumenteerde functies die het mogelijk maken om een cluster aan te vallen. Onlangs is er een .
Sommige dingen zijn zo triest en frustrerend. Zoals bijvoorbeeld, onder bepaalde omstandigheden kunnen de kubelets in het Kubernetes-cluster de inhoud van de warlocks-directory blootstellen aan een niet-geautoriseerde gebruiker.
staan instructies over hoe je alles kunt reproduceren wat ik heb verteld. Daar liggen bestanden met productvoorbeelden van hoe ResourceQuota en Pod Security Policy eruitzien. En dit alles kan je aanraken.
Iedereen bedankt.
Bron: habr.com
