

TL; DR: JSONB kan de ontwikkeling van een database-schema aanzienlijk vereenvoudigen zonder in te boeten op de prestaties van zoekopdrachten.
Inleiding
Laten we een klassiek voorbeeld bekijken, waarschijnlijk een van de oudste toepassingen in de wereld van relationele databases: we hebben een entiteit en moeten bepaalde kenmerken (attributen) van deze entiteit opslaan. Maar niet alle instanties kunnen dezelfde set kenmerken hebben, en bovendien kunnen in de toekomst mogelijk nog meer kenmerken worden toegevoegd.
De eenvoudigste manier om dit probleem op te lossen, is door een kolom in de database-tabel te maken voor elke waarde van een kenmerk, en gewoon diegene in te vullen die nodig zijn voor een bepaalde instantie van de entiteit. Prima! Probleem opgelost... tot het moment dat uw tabel miljoenen records bevat en u de noodzaak heeft om een nieuw record toe te voegen.
Laten we het EAV-patroon overwegen (), dat komt vrij vaak voor. Een tabel bevat entiteiten (records), een andere tabel bevat de namen van kenmerken (attributen), en een derde tabel verbindt de entiteiten met hun attributen en bevat de waarde van deze attributen voor de huidige entiteit. Dit geeft u de mogelijkheid om verschillende sets kenmerken voor verschillende objecten te hebben, en ook om eigenschappen 'ter plekke' toe te voegen zonder de database-structuur te wijzigen.
Toch zou ik deze opmerking niet maken als er geen nadelen waren aan de EVA-aanpak. Bijvoorbeeld, om een of meerdere entiteiten te verkrijgen die elk 1 attribuut hebben, zijn 2 joins in de query nodig: de eerste is een join met de attributentabel, de tweede is een join met de waardetabel. Als de entiteit 2 attributen heeft, heeft u al 4 joins nodig! Bovendien worden alle attributen meestal als strings opgeslagen, wat resulteert in typecasting, zowel voor de uitkomst als voor de WHERE-clausule. Als u veel queries schrijft, is dit behoorlijk kostbaar qua middelen.
Ondanks deze voor de hand liggende nadelen wordt EAV al lang gebruikt om dit soort problemen op te lossen. Dit zijn onvermijdelijke nadelen, en er was simpelweg geen betere oplossing.
Maar toen kwam er een nieuwe 'technologie' in PostgreSQL...
Met PostgreSQL 9.4 is het datatype JSONB toegevoegd voor het opslaan van binaire JSON-gegevens. Hoewel het opslaan van JSON in dit formaat doorgaans iets meer ruimte en tijd kost dan gewone tekst-JSON, zijn de bewerkingen ermee veel sneller. Bovendien ondersteunt JSONB indexering, wat de aanvragen nog sneller maakt.
Het datatype JSONB stelt ons in staat om het onhandige EAV-patroon te vervangen door slechts één JSONB-kolom aan onze entiteitentabel toe te voegen, wat het databaseontwerp aanzienlijk vereenvoudigt. Maar velen beweren dat dit gepaard moet gaan met een vermindering van de prestaties... Om deze reden is dit artikel ontstaan.
Configuratie van de testdatabase
Voor deze vergelijking heb ik een database gemaakt op een nieuwe installatie van PostgreSQL 9.5 op een 80-dollarconfiguratie Ubuntu 14.04. Na het configureren van enkele instellingen in postgresql.conf heb ik script uitgevoerd met psql. Voor de weergave van de gegevens in EAV-vorm zijn de volgende tabellen aangemaakt:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Hieronder is de tabel waarin dezelfde gegevens zullen worden opgeslagen, maar met de attributen in een JSONB-kolom – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Het ziet er veel eenvoudiger uit, nietwaar? Vervolgens werden er 10 miljoen records toegevoegd aan de entiteitstabellen (entity & entity_jsonb) en de tabellen die het EAV-patroon gebruiken en de benadering met de JSONB-kolom werden overeenkomstig gevuld met identieke gegevens – entity_jsonb.properties. Op deze manier hebben we verschillende datatypes verkregen onder het totale eigenschappenpakket. Voorbeeldgegevens:
{
  id:          1
  name:        "Entity1"
  description: "Test entiteit nr. 1"
  properties:  {
    color:        "rood"
    lengte:      120
    breedte:     3.1882420
    heeftIets:  true
    land:        "België"
  }
}
Dus, nu hebben we identieke gegevens voor twee opties. Laten we beginnen met het vergelijken van de implementaties in de praktijk!
Vereenvoudigen van het ontwerp
Eerder is al vermeld dat het databaseontwerp aanzienlijk is vereenvoudigd: één tabel, door het gebruik van een JSONB-kolom voor eigenschappen in plaats van het gebruik van drie tabellen voor EAV. Maar hoe weerspiegelt dit zich in de aanvragen? Het bijwerken van één eigenschap van de entiteit ziet er als volgt uit:
-- EAV
UPDATE entity_attribute_value
SET value = 'blauw'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blauw"')
WHERE id = 120;
Zoals we zien, lijkt de laatste query niet eenvoudiger. Om de waarde van een eigenschap in een JSONB-object bij te werken, moeten we de functie , en we moeten onze nieuwe waarde doorgeven als een JSONB-object. We hoeven echter geen enkele identificator van tevoren te kennen. Kijken we naar het voorbeeld met EAV, moeten we zowel entity_id als entity_attribute_id kennen om de update uit te voeren. Als je een eigenschap in de JSONB-kolom wilt bijwerken op basis van de naam van het object, dan kan dat allemaal met één simpele regel.
Laten we nu de entiteit selecteren die we zojuist hebben bijgewerkt, op basis van haar nieuwe kleur:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'kleur' AND eav.value = 'blauw';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blauw';
Ik denk dat we het erover eens kunnen zijn dat de tweede korter is (zonder join!), en daarom leesbaarder. Hier wint JSONB! We gebruiken de JSON-operator ->>, om de kleur als tekstwaarde uit het JSONB-object te krijgen. Er is ook een tweede manier om hetzelfde resultaat te bereiken in het JSONB-model met de operator @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blauw"}';
Dit is iets ingewikkelder: we controleren of het JSON-object in de eigenschap kolom het object aan de rechterkant van de operator @> bevat. Minder leesbaar, maar efficiënter (zie hieronder).
Laten we het gebruik van JSONB nog verder vereenvoudigen, wanneer je meerdere eigenschappen tegelijk wilt selecteren. Hier komt de JSONB-aanpak echt van pas: we selecteren gewoon de eigenschappen als extra kolommen in onze resultaten zonder dat we joins nodig hebben:
-- JSONB
SELECT name
  , properties ->> 'kleur'
  , properties ->> 'land'
FROM entity_jsonb
WHERE id = 120;
Met EAV heb je 2 joins nodig voor elke eigenschap die je wilt opvragen. Naar mijn mening tonen de bovenstaande queries een grote vereenvoudiging in het databaseontwerp. Kijk ook naar meer voorbeelden van hoe je queries kunt schrijven voor JSONB, misschien ook in post.
Het is nu tijd om over prestaties te praten.
Prestaties
Om de prestaties te vergelijken, heb ik gebruikt in de aanvragen, voor het berekenen van de uitvoeringstijd. Elke aanvraag werd minimaal drie keer uitgevoerd, omdat de planner bij de eerste uitvoering meer tijd nodig heeft. Eerst heb ik de aanvragen zonder enige indices uitgevoerd. Dit was duidelijk een voordeel van JSONB, aangezien de joins die nodig zijn voor EAV geen gebruik konden maken van indices (de velden met vreemde sleutels werden niet geïndexeerd). Daarna heb ik een index gemaakt voor 2 kolommen van vreemde sleutels in de EAV-waarden tabel, evenals een index voor de JSONB-kolom.
De gegevensupdates toonden de volgende resultaten in tijd (in ms). Houd er rekening mee dat de schaal logaritmisch is:
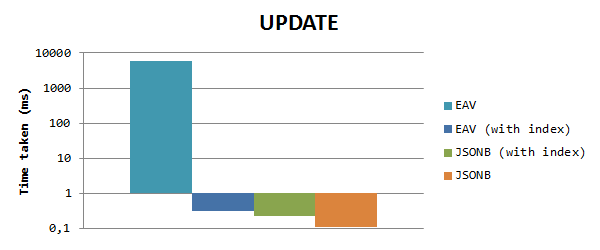
We zien dat JSONB veel (> 50000x) sneller is dan EAV, wanneer er geen indices worden gebruikt, om de eerder genoemde reden. Wanneer we de kolommen met primaire sleutels indexeren, verdwijnt het verschil bijna, maar JSONB is nog steeds 1,3 keer sneller dan EAV. Let op dat de index in de JSONB-kolom hier geen invloed heeft, omdat we de eigenschap kolom niet gebruiken in de beoordelingscriteria.
Voor het selecteren van gegevens op basis van eigenschapswaarde krijgen we de volgende resultaten (normale schaal):
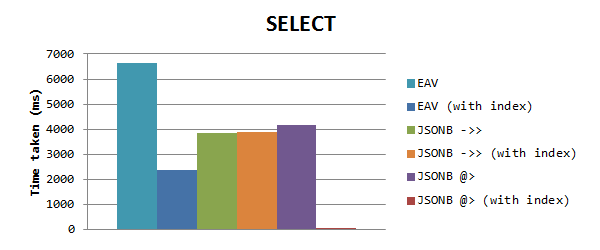
We kunnen opmerken dat JSONB opnieuw sneller werkt dan EAV zonder indices, maar wanneer EAV met indices is, werkt het nog steeds sneller dan JSONB. Maar toen merkte ik dat de tijd voor JSONB-aanvragen gelijk was, wat me deed beseffen dat de GIN-index niet werd geactiveerd. Schijnbaar geldt de GIN-index voor een kolom met ingevulde eigenschappen alleen wanneer de @> operator wordt gebruikt. Ik gebruikte dit in een nieuwe test, wat een enorme impact had op de tijd: slechts 0,153 ms! Dat is 15000 keer sneller dan EAV en 25000 keer sneller dan de ->> operator.
Ik denk dat het snel genoeg was!
Grootte van de databases
Laten we de groottes van de tabellen vergelijken bij beide benaderingen. In psql kunnen we de grootte van alle tabellen en indices laten zien met de opdracht dti+
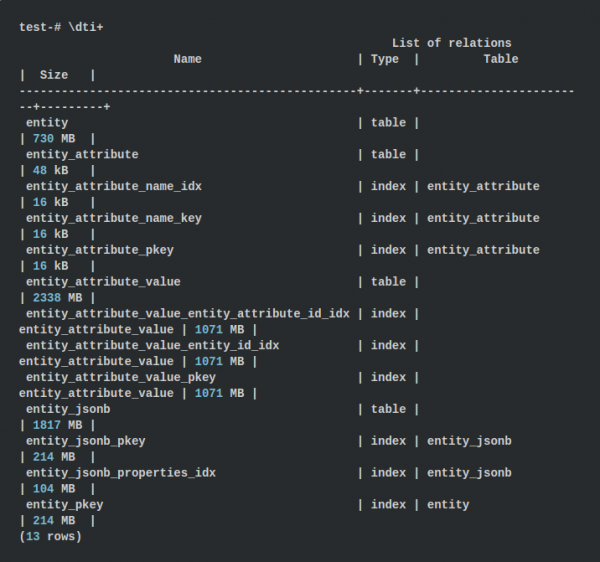
Voor de EAV-benadering bedragen de groottes van de tabellen ongeveer 3068 MB en de indices tot 3427 MB, wat totaal 6,43 GB oplevert. Bij het gebruik van de JSONB-benadering is het 1817 MB voor de tabel en 318 MB voor de indices, wat samen 2,08 GB is. Dat is 3 keer minder! Dit verraste me een beetje, omdat we de namen van de eigenschappen in elk JSONB-object opslaan.
Maar cijfers spreken nu eenmaal voor zich: in EAV slaat men 2 integer externe sleutels op voor de waarde van het attribuut, wat resulteert in 8 extra bytes aan gegevens. Bovendien worden in EAV alle waarden van eigenschappen als tekst opgeslagen, terwijl JSONB numerieke en logische waarden gebruikt waar mogelijk, wat leidt tot een kleinere omvang.
Conclusies
Over het geheel genomen denk ik dat het opslaan van de eigenschappen van entiteiten in het JSONB-formaat het ontwerpen en onderhouden van uw database aanzienlijk kan vereenvoudigen. Als u veel zoekopdrachten uitvoert, zal alles wat in één tabel met de entiteit is opgeslagen, echt efficiënter werken. Het feit dat dit de interactie tussen gegevens vereenvoudigt, is al een pluspunt, maar ook de resulterende database is drie keer kleiner in omvang.
Daarnaast kan uit de uitgevoerde tests worden geconcludeerd dat de prestatieverliezen zeer gering zijn. In sommige gevallen werkt JSONB zelfs sneller dan EAV, wat het nog beter maakt. Deze benchmarktest dekt natuurlijk niet alle aspecten (bijvoorbeeld entiteiten met een zeer groot aantal eigenschappen, een aanzienlijke toename van het aantal eigenschappen van bestaande gegevens,...), dus als u suggesties heeft voor verbetering, aarzel dan niet om deze in de opmerkingen achter te laten!
Bron: habr.com
