

Ik deel uit persoonlijke ervaring wat en wanneer nuttig was. Het is een overzichtelijke en puntsgewijze uitleg, zodat duidelijk is wat je verder kunt uitdiepen — maar dit is uitsluitend mijn subjectieve ervaring, jouw situatie kan heel anders zijn.
Waarom is het belangrijk om te weten en om te kunnen werken met querytalen? In Data Science zijn er een paar belangrijke fasen van het werk en de allereerste en belangrijkste (zonder deze zal niets werken!) is het verkrijgen of extraheren van gegevens. Meestal zitten gegevens op de een of andere manier ergens en moeten ze daar ‘uitgehaald’ worden.
Querytalen zorgen er juist voor dat deze gegevens kunnen worden geëxtraheerd! En vandaag zal ik vertellen over de querytalen die mij van pas zijn gekomen en ik zal laten zien waar en hoe precies — waarom het nuttig is om ze te leren.
Er zullen drie hoofdtypes van gegevensqueries zijn die we in dit artikel behandelen:
- ‘Standaard’ querytalen — dat zijn de talen die meestal bedoeld worden als men spreekt over querytalen, zoals relationele algebra of SQL.
- Scriptingquerytalen: bijvoorbeeld Python-tools zoals pandas, numpy of shell scripting.
- Querytalen voor kennisgrafieken en grafdatabases.
Alles wat hier geschreven staat, is gewoon een persoonlijke ervaring van wat nuttig was, met beschrijvingen van situaties en ‘waarom het nodig was’ — iedereen kan het toepassen om te kijken of dergelijke situaties zich ook bij jou kunnen voordoen en zich hierop voorbereiden door met deze talen aan de slag te gaan voordat je ze (snel) moet toepassen in een project of überhaupt in een project terechtkomt waar ze nodig zijn.
‘Standaard’ querytalen
Standaard querytalen zijn in die zin dat we meestal aan deze denken als we het over queries hebben.
Relationele algebra
Waarom is relationele algebra vandaag de dag nodig? Om een goed begrip te hebben van waarom querytalen op een bepaalde manier zijn opgebouwd en om ze bewust te kunnen gebruiken, moet je de kern begrijpen die eraan ten grondslag ligt.
Wat is relationele algebra?
De formele definitie is als volgt: relationele algebra is een gesloten systeem van bewerkingen op relaties in het relationele datamodel. In iets meer menselijke termen is het een systeem van bewerkingen op tabellen, waarbij het resultaat ook altijd een tabel is.
Zie alle relationele bewerkingen in In het artikel van Habr - hier beschrijven we waarom het belangrijk is om te weten en waar het van pas komt.
Waarom?
Je begint te begrijpen waaruit querytalen zijn opgebouwd en welke operaties achter de uitdrukkingen van specifieke querytalen schuilgaan - dit geeft vaak een dieper inzicht in wat en hoe dingen werken in querytalen.
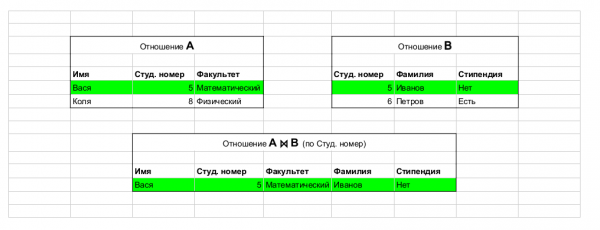
Gehaald uit artikelen. Voorbeeld van een operatie: join, die tabellen samenvoegt.
Leer materiaal:
. Over het algemeen zijn er ontzettend veel materialen over relationele algebra en theorie - Coursera, Udacity. Er is ook een enorme hoeveelheid online materialen, waaronder goede . Mijn persoonlijke advies: je moet relationele algebra heel goed begrijpen - het is de basis der basis.
SQL
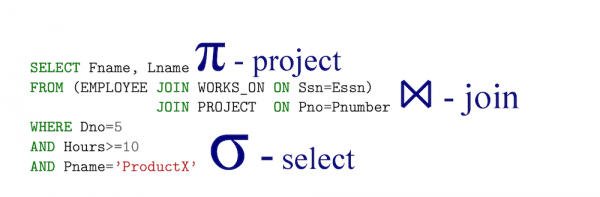
Gehaald uit van het artikel gaan.
SQL is in feite een implementatie van relationele algebra - met de belangrijke kanttekening dat SQL declaratief is! Dat wil zeggen, wanneer je een query schrijft in de taal van relationele algebra, zeg je feitelijk hoe het moet worden berekend - maar met SQL geef je aan wat je wilt extraheren, en de DBMS genereert dan (efficiënte) uitdrukkingen in de taal van relationele algebra (de equivalentie is bekend onder ).
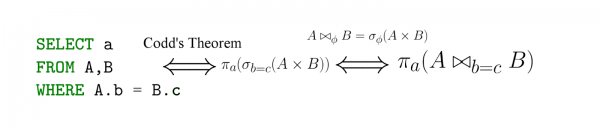
Gehaald uit van het artikel gaan.
Waarom?
Relationele DBMS: Oracle, Postgres, SQL Server, enz. - zijn nog steeds feitelijk overal en de kans is groot dat je ermee te maken krijgt, wat betekent dat je waarschijnlijk SQL moet lezen (wat heel waarschijnlijk is) of in SQL moet schrijven (ook niet onwaarschijnlijk).
Wat te lezen en te bestuderen
Via dezelfde links hierboven (over relationele algebra) is er een ongelofelijke hoeveelheid materiaal, bijvoorbeeld .
Trouwens, wat is NoSQL?
"Het moet nogmaals worden benadrukt dat de term 'NoSQL' een volstrekt organische oorsprong heeft en geen algemeen erkende definitie of wetenschappelijke instantie achter zich heeft." Bijbehorende op Habr.
In wezen hebben mensen begrepen dat het volledige relationele model niet nodig is voor het oplossen van veel taken, vooral voor die situaties waarin bijvoorbeeld prestaties cruciaal zijn en bepaalde eenvoudige queries met aggregatie domineren - daar is het cruciaal om metriek snel te berekenen en deze in de database te schrijven, en de meeste kenmerken van relationele databases bleken niet alleen niet nodig, maar zelfs schadelijk - waarom iets normaliseren als dit het belangrijkste voor ons (voor een bepaalde specifieke taak) - de prestaties - zou schaden?
Vaak zijn flexibele schema's in plaats van vaste wiskundige schema's van het klassieke relationele model nodig — dit vereenvoudigt de ontwikkeling van applicaties enorm, vooral wanneer het cruciaal is om snel een systeem op te zetten en aan de slag te gaan met het verwerken van resultaten — of het schema en de soorten opgeslagen gegevens zijn simpelweg niet zo belangrijk.
Bijvoorbeeld, we creëren een expertensysteem en willen informatie over een bepaald domein opslaan samen met enige metadata — we hoeven mogelijk niet alle velden te kennen en kunnen eenvoudigweg JSON voor elke record opslaan — dit biedt ons een zeer flexibele omgeving voor het uitbreiden van het datamodel en snel itereren — daarom is NoSQL in dit geval zelfs de voorkeur en leesbaarder. Voorbeeld van een record (uit een van mijn projecten, waar NoSQL precies was waar het nodig was).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Johnny Cash","ru"],
"en_wiki_pagecount":2338861}
Meer details kunnen worden gelezen over NoSQL.
Wat te studeren?
Hier moet je gewoon goed analyseren wat je taak is, wat de eigenschappen ervan zijn en welke NoSQL-systemen passen bij deze beschrijving — en dan kun je beginnen met het bestuderen van het betreffende systeem.
Scriptingquerytalen
Aanvankelijk lijkt het misschien niets te maken te hebben met Python — het is een programmeertaal, helemaal niet over queries.
- Pandas is als een Zwitsers zakmes voor Data Science, er gebeurt ontzettend veel datatransformatie, aggregatie, enzovoort in.
- Numpy — vectorberekeningen, matrices en lineaire algebra vinden daar plaats.
- Scipy — veel wiskunde in dit pakket, vooral statistiek.
- Jupyter lab — veel exploratieve data-analyse past goed in notebooks — nuttig om te kunnen.
- Requests — werkt met netwerken.
- Pyspark — zeer populair onder data-ingenieurs, je zult waarschijnlijk met deze of Spark moeten interageren, simpelweg vanwege hun populariteit.
- *Selenium — zeer nuttig voor het verzamelen van gegevens van websites en bronnen, soms is er gewoon geen andere manier om gegevens te verkrijgen.
Mijn belangrijkste advies: leer Python!
Pandas
Laten we als voorbeeld de volgende code nemen:
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Bereken en hernoem aggregaties
all_together = (df[df['trip_type'] == "return"]
    .groupby(['start_station_name', 'end_station_name'])
                  	    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': min_duration_seconds,
           'amax': 'max_duration_seconds'}))
In wezen zien we dat de code past in het klassieke SQL-patroon.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Maar het belangrijke deel is dat deze code een onderdeel is van het script en de pipeline; feitelijk integreren we de queries in de Python-pipeline. In deze situatie komt de querytaal naar ons toe vanuit libraries zoals Pandas of pySpark.
In het algemeen zien we in pySpark een soortgelijke manier van datatransformatie via de querytaal in de geest van:
df.filter(df.trip_type = 'return')
  .groupby('day')
  .agg({duration: 'mean'})
  .sort()
Waar en wat te lezen
Over Python in het algemeen om materialen voor studie te vinden. Er is een enorme hoeveelheid tutorials online over , en cursussen over (en ook over ). Over het algemeen zijn de materialen hier uitstekend te vinden via Google, en als ik één pakket zou moeten kiezen om me op te concentreren, zou dat zeker pandas zijn. Wat betreft DS+Python zijn er ook .
Shell als querytaal
Vele projecten voor de verwerking en analyse van gegevens waarmee ik heb gewerkt, zijn in wezen shell-scripts die Python-, Java-code en de shell-opdrachten zelf aanroepen. Daarom kunnen pipelines in bash/zsh/etc. worden beschouwd als een soort hoog-niveau query (natuurlijk kunnen hier ook lussen in worden gestopt, maar dat is niet typisch voor DS-code in shell-talen). Laten we een eenvoudig voorbeeld geven: ik moest een mapping maken van QID in Wikidata naar de volledige links naar de Russische en Engelse Wikipedia. Hiervoor schreef ik een eenvoudige commandoregelquery in bash en een simpel script in Python voor de output, die ik als volgt samenstelde:
pv 'data/latest-all.json.gz' |
unpigz -c |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py "output.csv"
waar
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2] == "enwiki" or .[0][2] == "ruwiki") and .[0][3] == "title") or .[0][1] == "id")' Dit was feitelijk de hele pipeline die de benodigde mapping creëerde; zoals we zien, werkte alles in streaming-modus:
- pv filepath — toont een voortgangsbalk op basis van de bestandsgrootte en geeft de inhoud door.
- unpigz -c las een deel van het archief en gaf dit door aan jq.
- jq met de sleutel — stream gaf onmiddellijk het resultaat en gaf dit door naar de postprocessor (net als in het eerste voorbeeld) in Python.
- Binnen de postprocessor is dit een eenvoudige toestandsmachine die de output formatteert.
Een complexe pipeline die in streammodus werkt met grote datasets (0,5TB), zonder aanzienlijke middelen en opgebouwd uit een eenvoudige pipeline en een paar tools.
Een andere belangrijke tip: Zorg ervoor dat je goed en efficiënt kunt werken in de terminal en schrijven in bash/zsh/etc.
Waar is dit nuttig? Bijna overal — er is opnieuw VEEL studiemateriaal beschikbaar op het internet. In het bijzonder, hier is mijn vorige artikel.
R-script
Wederom kan de lezer uitroepen — maar dat is toch een volledige programmeertaal! En hij heeft gelijk. Echter, meestal ging ik met R om in een context die lijkt op een querytaal.
R is een omgeving voor statistische berekeningen en een taal voor statistische berekeningen en visualisatie (volgens ).
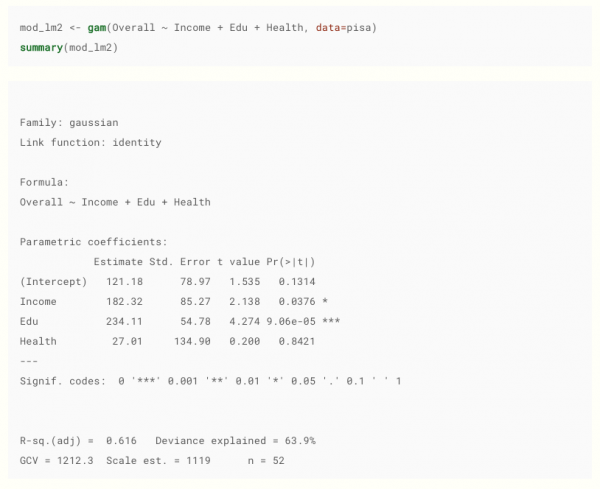
Bron . Trouwens, ik raad het aan, goed materiaal.
Waarom moet een data scientist R kennen? Althans, omdat er een enorme groep mensen buiten de IT is die data-analyse doet met R. Ik ben ze tegengekomen op de volgende plekken:
- De farmaceutische sector.
- Biologen.
- De financiële sector.
- Mensen met een puur wiskundige achtergrond die zich bezighouden met statistiek.
- Gespecialiseerde statistische modellen en machine learning-modellen (die vaak alleen in auteursversies als R-pakket beschikbaar zijn).
Waarom is het feitelijk een querytaal? In de vorm waarin het vaak voorkomt — is het feitelijk een verzoek om een model te creëren, inclusief het lezen van gegevens en het vastleggen van de parameters van het verzoek (modellen), en ook datavisualisatie in pakketten zoals ggplot2 — dit is ook een vorm van het schrijven van verzoeken.
Voorbeeldverzoek voor visualisatie
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Over het algemeen zijn veel ideeën uit R overgenomen in Python-pakketten, zoals pandas, numpy of scipy, zoals dataframes en datavectorisatie — daarom zullen veel dingen in R je bekend en gebruiksvriendelijk lijken.
Er zijn veel bronnen om te leren, bijvoorbeeld, .
Kennisgrafieken (Knowledge graph)
Hier heb ik een iets ongebruikelijke ervaring, omdat ik redelijk vaak moet werken met kennisgrafieken en querytalen voor grafieken. Daarom zullen we kort de basisprincipes bekijken, omdat dit gedeelte iets meer exotisch is.
In klassieke relationele databases hebben we een vaste schema — hier is het schema flexibel, elke predicaat is feitelijk een «kolom» en zelfs meer.
Stel je voor dat je een mens zou modelleren en je wilt de belangrijkste dingen beschrijven; laten we voor deze oefening de specifieke persoon Douglas Adams nemen, en gebruikmaken van deze beschrijving.
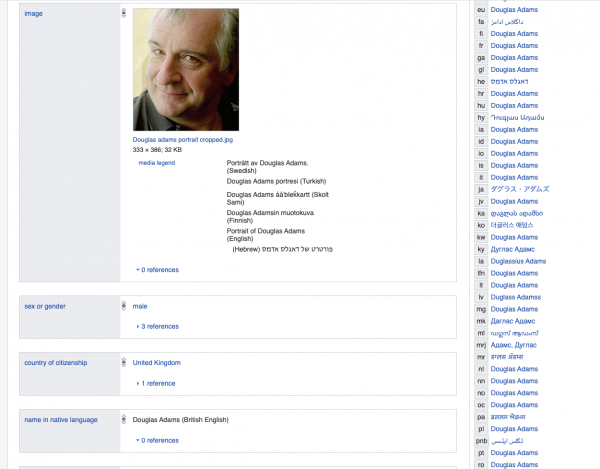
Als we een relationele database zouden gebruiken, zouden we enorme tabellen of tabellen met een overweldigend aantal kolommen moeten aanmaken, waarvan het grootste deel NULL zou zijn of gevuld met een standaard False waarde. Bijvoorbeeld, waarschijnlijk heeft niet veel van ons een record in de nationale Koreaanse bibliotheek — natuurlijk zouden we ze in aparte tabellen kunnen onderbrengen, maar dat zou uiteindelijk een poging zijn om een flexibele logische schema met predikaten te modelleren met behulp van een vaste relationele structuur.
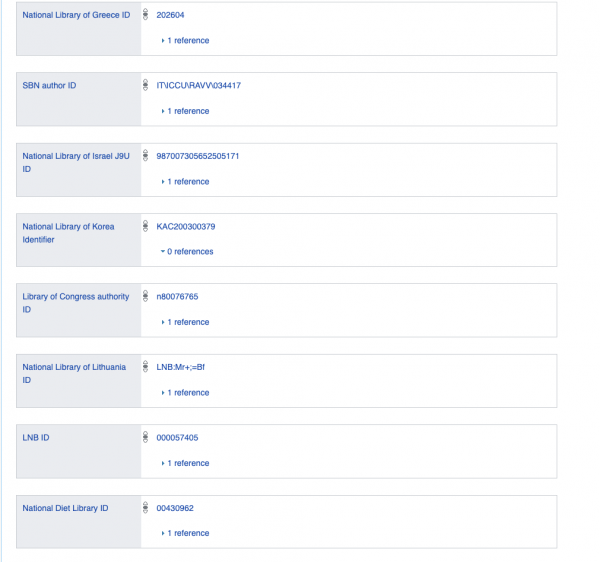
Dus stel je voor dat alle gegevens worden opgeslagen in de vorm van een graaf of in de vorm van binaire en unitaire logische expressies.
Waar kun je zoiets tegenkomen? Ten eerste, bij het werken met , en met alle grafische databases of gelinkte gegevens.
Daarna volgen de belangrijkste querytalen die ik moest toepassen en waarmee ik moest werken.
SPARQL
Wiki:
SPARQL ( van SPARQL Protocol and RDF Query Language) — , gepresenteerd volgens het model , evenals voor het verzenden van deze query's en de antwoorden daarop. SPARQL is een aanbeveling van en een van de technologieën .
In wezen is het een querytaal voor logische unitaire en binaire predikaten. Je geeft eenvoudigweg aan wat vastligt in de logische expressie en wat niet ( heel eenvoudig).
De RDF-database (Resource Description Framework), waarop de SPARQL-query's worden uitgevoerd — is eenTriple object, predicaat, subject — en de query selecteert de benodigde triples op basis van de gegeven beperkingen in de geest van: vind zo'n X dat p_55(X, q_33) waar is — waarbij, uiteraard, p_55 een relatie met id 55 is en q_33 is het object met id 33 (en dat is het hele verhaal, waarbij we allerlei details verder buiten beschouwing laten).
Voorbeeld van gegevensrepresentatie:
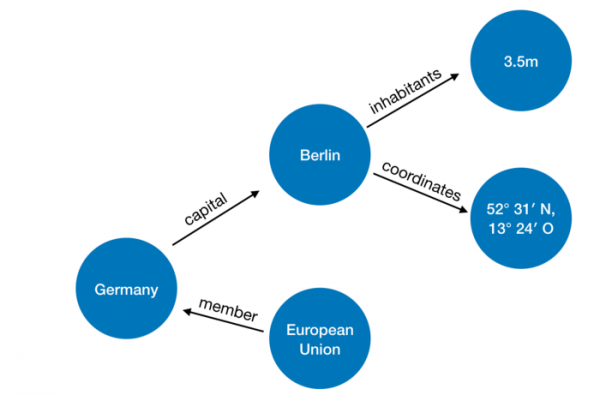
Afbeeldingen en voorbeeld met landen hier .
Voorbeeld van een basisquery
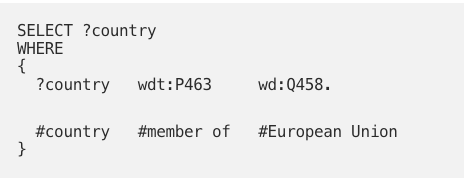
In feite willen we de waarde van de variabele ?country vinden, zodat voor de predicaat
member_of, waar is dat member_of(?country,q458), en q458 is de ID van de Europese Unie.
Voorbeeld van een echte SPARQL-query binnen de Python-engine:
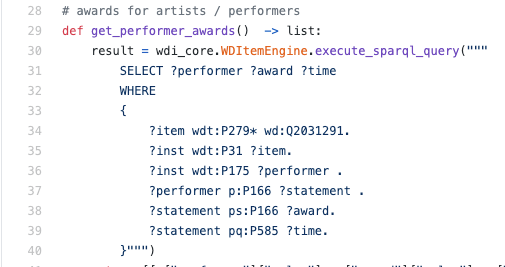
Over het algemeen moest ik SPARQL lezen en niet schrijven; in die situatie is het waarschijnlijk nuttig om de taal ten minste op basisniveau te begrijpen, zodat je kunt begrijpen hoe gegevens precies worden opgehaald.
Er zijn veel online materialen om te leren: bijvoorbeeld hier is er en . Ik zoek meestal specifieke constructies en voorbeelden op Google en tot nu toe is dat voldoende.
Logische querytalen
Meer hierover is te vinden in mijn artikel . Hier bespreken we kort waarom logische talen goed geschikt zijn voor het schrijven van queries. In wezen is RDF gewoon een verzameling logische uitspraken in de vorm van p(X) en h(X,Y), terwijl een logische query de volgende vorm heeft:
output(X) :- country(X), member_of(X, "EU").
Hier zeggen we dat we een nieuwe predicaat output/1 aanmaken (de /1 betekent unair), op voorwaarde dat voor X geldt dat country(X) waar is, dat wil zeggen, X is een land en dat member_of(X, "EU\") ook waar is.
Dat wil zeggen, we hebben zowel gegevens als regels die in dit geval op dezelfde manier worden gepresenteerd, wat het heel gemakkelijk en goed maakt om problemen te modelleren.
Waar we in de industrie tegenkwamen: een groot project met een bedrijf dat in die taal queries schrijft, en ook op het huidige project in de kern van het systeem — het lijkt misschien een behoorlijk exotische zaak, maar soms komt het voor.
Een fragment van code in de logische taal die wikidata verwerkt:
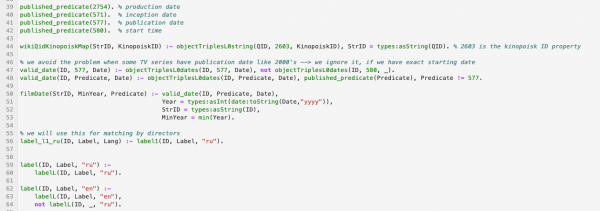
Materialen: ik zal hier een paar links geven naar de moderne logische programmeertaal Answer Set Programming — ik raad aan deze juist te bestuderen:
Bron: habr.com
