

In We have told you about the new features in the January update Update 4 for Veeam Backup & Replication 9.5 (VBR), where we consciously did not mention backups on magnetic tape. A discussion of this area deserves a separate article because there were indeed many new features.
– Guys from QA, will you write an article?
– Why not!
Tape drives in the 21st century
Data storage on magnetic tapes (cassettes, "tapes" as we in R&D call them) is not limited to the long-gone ZX-Spectrum computer, which could load a game into 48 kb of RAM from in a few minutes. Over the quarter-century, the speed and capacity of cassettes have increased by 6-7 orders of magnitude. This is not a completely correct comparison, and by standaard is not keeping pace. Nevertheless, modern technologies allow recording 12 terabytes of data (up to 30 terabytes in compression mode) on a kilometer of tape from a single cassette, thus making the 160-dollar drive outshine competitors in terms of long-term storage costs for large volumes of data, even considering investments in recording/reading equipment. Data on such cassettes is reliably stored for 15-30 years.
Let me approach it from another angle. Recently, has reached a new level. They can wait patiently in a large company's infrastructure for weeks or months, and with the emergence of another zero-day vulnerability – destroy (not without human assistance, since big money is at stake) not only all data but also all backups that can be reached. Here is , when a company had to pay the hackers. So-called air gap, i.e., backups physically isolated from the infrastructure, have become essentially the only reliable salvation from such incidents. Magnetic tape here is one of the timeless solutions.
But one specification and technological innovations from leading manufacturers (IBM, HPE, Oracle, Dell) are not enough for reliable data protection; good software is required. At Veeam, we have a whole team dedicated to tape backups, about 10 people analyzing, planning, researching, developing, and testing daily. You could see the results of this work in previous articles (, ). What has been accomplished over the past year?
Glossary
Er wordt gekozen tussen vrijheden ten opzichte van de moedertaal en lastige bureaucratische termen die de leesbaarheid bemoeilijken. Ik geef de voorkeur aan het eerste, dus bied ik mijn excuses aan als sommige jargonwoorden uit de onderstaande lijst iemand tegen de borst stuiten. Hier herinner ik kort aan wat elke term betekent.
VBR-experts kunnen dit deel overslaanJob – job – een taak voor back-up. Eigenlijk is de hele VBR gebaseerd op jobs. Naast back-up en replicatie kan dit ook een kopie naar tape zijn (backup to tape job, tape job). Ik wil opmerken dat het herstellen van een back-up (restore) ook een job is, maar in dit artikel wordt met dat woord specifiek een back-up bedoeld.
Storage – storage – de historisch gevormde naam. Dit zijn bestanden in de repository (repository – opslagplaats), die back-ups bevatten – volledige en incrementele. In één storage kunnen zowel één als meerdere virtuele machines zijn.
Chain – chain – een reeks aan elkaar verbonden storages. Voor het herstellen van gegevens uit de n-de incrementele storage zijn alle voorgaande nodig, van (n-1) tot 1, en de volle storage waarop de eerste incrementele verwijst.
Source, Target – source, target. Source is de oorspronkelijke entiteit die door de job wordt verwerkt. In het geval van back-ups/replicaties is dit meestal een virtuele machine in de hypervisor. In het geval van een tape job is de source de back-up job zelf (of de bestanden in het geval van een file to tape job). Target voor de back-up job is het repository waar de back-ups worden opgeslagen. Voor de tape job is dat de media pool.
Media pool – – een pool van opslagmedia, in ons geval – tapes. Een logisch container dat door de gebruiker wordt aangemaakt en die tapes van één of meerdere bibliotheken bevat. Dus, een tape job heeft altijd een media pool als target, dat wil zeggen dat de gegevens niet op een specifieke tape of op een willekeurige tape in de bibliotheek worden geschreven, maar op een specifieke set van hen. De media pool heeft een instelling voor de opslagduur van gegevens, na dewelke de tape opnieuw kan worden overschreven. De gebruiker kan standaard (standard) en . Elk van deze soorten kan nu ook WORM en niet-WORM zijn, daarover hieronder.
Media set – – een set cartridges in de media pool, waarop continu backups/bestanden worden geschreven. Voor GFS-pools zijn media sets ook gekoppeld aan een interval (bijvoorbeeld jaarlijks – yearly), cartridges worden alleen binnen hun eigen interval omgeroteerd.
– de elementen van de tape-bibliotheek. De drive leest en rewindt de cartridge, de changer is een robot die cartridges tussen opslagslots, uitlaatslots en de drive verplaatst. Er zijn ook standalone drives (standalone – op zichzelf staand), hier wordt de rol van de changer uitgevoerd door een persoon. Voor de drive is een correct geïnstalleerde fabrikant-driver op de Windows-machine, waar de bibliotheek op is aangesloten, verplicht; met de changer kunnen we echter ook zonder drivers werken, via native SCSI.
Tenant to tape. De provider is beveiligd – de klanten zijn beveiligd.
Trek de troeven meteen op tafel. De meest ingrijpende functie van onze update, bedoeld voor , die VBR in hun infrastructuur gebruiken. De ontwikkeling begon twee jaar geleden. Al snel realiseerden we ons dat we een dergelijke grote taak niet op tijd konden voltooien voor de volgende release, namen we een korte pauze en uiteindelijk hebben we de functie uitgebracht in 9.5 Update 4.
Kortom, providers hebben nu de mogelijkheid om de backups van hun klanten op cartridges te kopiëren met behulp van tape jobs in de GFS-pool. Dit biedt providers – en dit zijn zeer belangrijke, kostbare mensen voor ons en de commerciële afdeling – twee mogelijkheden:
- de klanten (tenants, tenant – huurder) te beschermen tegen gegevensverlies als gevolg van onopzettelijk verwijderen of infrastructurele problemen (‘overstroming in de serverruimte’);
- hun tenants een extra dienst te bieden voor het herstellen van gegevens uit een oude backup die al lang uit de cloudrepository is verwijderd volgens het gegevensbewaarbeleid, maar op de cartridges nog steeds beschikbaar is.
Vanuit marketingperspectief is de functionaliteit zeer ‘smakelijk’, maar vanuit ons perspectief is het niet minder ingewikkeld om te realiseren.
Ontwikkeling
Het grootste probleem dat zich voordeed, was de versleuteling van gegevens. De meeste cloudbackups zijn versleuteld, statistieken zeggen dat ⅔ van het totale aantal. Voor ons was dit cijfer een verrassing; we dachten dat bijna alles was versleuteld, maar dat is niet het geval – veel klanten vertrouwen blijkbaar blindelings op hun providers.
De eenvoudige paradigma is dat de provider de gegevens van zijn tenants niet mag kunnen ontcijferen. In het kader van deze nieuwe functie moet de provider opslaglocaties openen met back-ups. Dit is nodig om datablokken te verplaatsen, bijvoorbeeld voor het creëren . Het belangrijkste is dat dit onafhankelijk van de tenant moet gebeuren, wanneer de benodigde sleutels niet naar de provider worden verzonden tijdens het uitvoeren van de job.
De oplossing voor dit probleem, dat ook werd gebruikt in een andere belangrijke functie van de recent uitgebrachte uitbreiding – – bestaat uit het toevoegen van een extra versleutelingssleutel. De archiefsleutel (Archive key) wordt in versleutelde vorm in de database van de provider opgeslagen. Met een slimme aanpak kan de provider hiermee de opslag openen, datablokken verplaatsen en hersleutelen tussen opslaglocaties (iedere opslag heeft immers zijn eigen sleutel), maar de gegevens zelf kunnen niet worden ontcijferd.
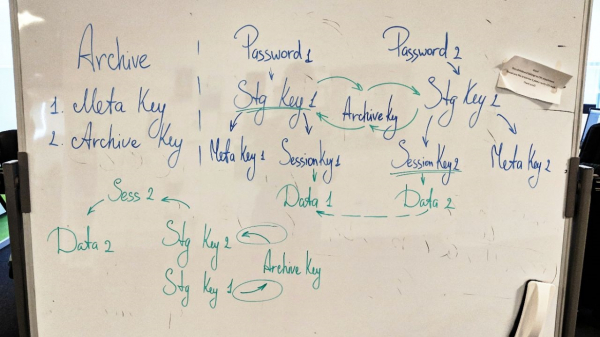
Slimme aanpak (werkende variant)
Ik voeg toe dat alle ingenieurs in R&D dol zijn op versleuteling in ons product, hoewel niemand in alle details weet hoe het werkt. (Er was ook nog een grap over 'en waarom het überhaupt werkt', maar die werd door de redacteuren afgekeurd.)
Testen
Voor deze functie zijn honderden bugs geregistreerd. De moeilijkste gebieden zijn versleuteling, gebruikersinterface en problemen bij herstel.
Vanuit het perspectief van testen was de grote variabiliteit, de 'combinatoriek' van de soorten en typen tenant-jobs en repositories een uitdaging – ik bedoel zowel de source als de target bij het herstellen van back-ups in de infrastructuur. Dit valt onder de logica van (inclusief de nieuwe – parallelisme en dagelijkse mediasets, daarover later), en in het algemeen de ongebruikelijke cloud-specifieke kenmerken voor types. Vergeet niet rijkelijk te kruiden met versleuteling. Om de metafoor voort te zetten, we hebben ons goed tegoed gedaan aan dit gerecht – maar hebben het ook van alle kanten geproefd.
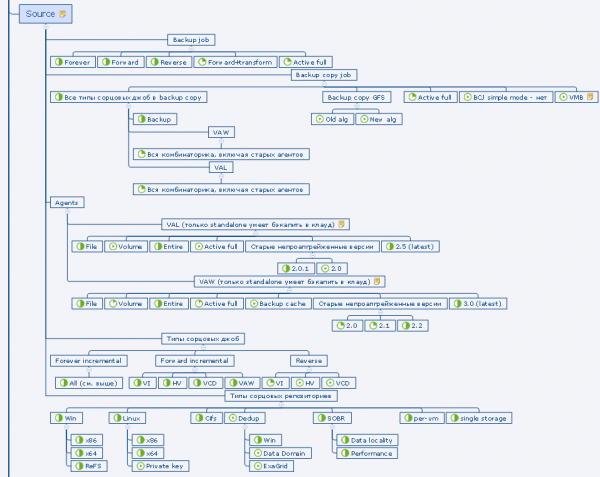
Fragment van het testplan
Als resultaat
Een gedetailleerde beschrijving is te vinden in (voorlopig in het Engels): , . Ik zal me richten op de belangrijkste punten.
Back-up
De provider voegt tenants toe aan de type-job met de GFS-pool als target. Bij een beschikbare cloudlicentie is in de tweede stap van de wizard de optie beschikbaar TenantsJe kunt alle tenants tegelijkertijd of afzonderlijk toevoegen, of je kunt gewoon een afzonderlijke quota (maar geen subquota) van een bepaalde tenant kiezen. Het is niet toegestaan om tenant-back-ups en gewone lokale back-ups in één job te mengen.
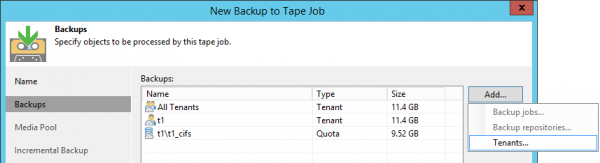
De overige instellingen zijn vrijwel identiek aan een gewone job in de GFS-pool.
Herstel van gegevens is mogelijk zowel aan de kant van de provider als aan de kant van de tenant zelf.
Herstel aan de kant van de provider
Dit wordt uitgevoerd via een nieuwe wizard. Hier kun je al naar een afzonderlijke job gaan, waarbij de volledige keten die op een bepaalde dag in het repository zat, wordt hersteld.
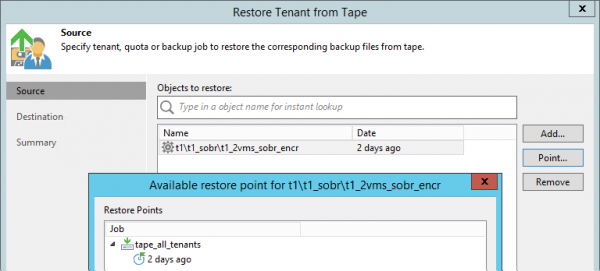
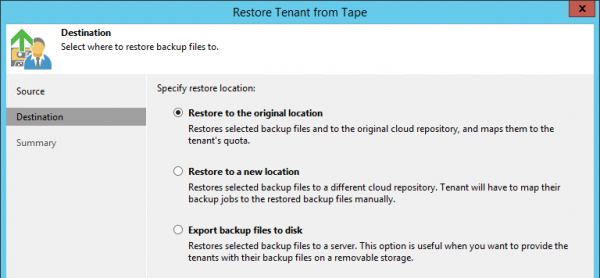
Er zijn drie opties voor herstel:
- Naar de oorspronkelijke locatie. In dit geval wordt de originele back-up, indien aanwezig, verwijderd; tenant-jobs worden automatisch opnieuw ingesteld op de herstelde keten. Dit soort herstel zal in principe helemaal niet opvallen voor de klant, alleen gedurende korte tijd is hij offline van het cloudrepository.
- Naar een nieuwe quota/repository. De provider kan bijvoorbeeld een aparte tijdelijke account voor dit doel creëren, die later wordt verwijderd. De back-up verschijnt in de infrastructuur van de tenant na synchronisatie met de database van de provider.
- Gewoon naar de schijf van een Linux- of Windows-server die in de infrastructuur van de provider is geregistreerd. Vervolgens kan deze keten op een USB-stick worden opgeslagen en naar de tenant worden gestuurd.
Herstel aan de kant van de tenant
Deze optie veronderstelt dat de klant beschikt over eigen tape-infrastructuur en een grote hoeveelheid gegevens voor herstel. De cassette met de geschreven back-ups kan fysiek naar de klant worden verzonden via de postdienst, waarna deze deze op zijn apparatuur catalogiseert, de cassettes ontsleutelt en met de back-ups werkt alsof hij ze zelf op tape heeft geschreven. Dit is een handige truc om geen terabytes over de WAN te downloaden.
Grote verbeteringen aan de GFS-pool
-media-pools verschenen twee jaar geleden in VBR, versie 9.5. In de uitgebrachte update, zowel door de komst van de functie Tenant to tape als op verzoek van gebruikers, hebben we deze functionaliteit aanzienlijk verbeterd.
Dagelijkse mediasets
Er is een nieuwe dagelijkse (dagelijks) media-set. Nu kunnen in de GFS-pool back-ups voor elke dag worden opgeslagen, en niet alleen volledige, maar ook incrementele. Laatsten nemen aanzienlijk minder ruimte in beslag, en dit is gedaan om bandbreedte te besparen. Er wordt van uitgegaan dat deze tapes altijd in de bibliotheek worden geroteerd en niet naar externe opslag worden vervoerd. Voor het herstel vanuit het incrementele punt zijn tapes van een van de oudere media-sets (wekelijks, maandelijks, jaarlijks of kwartaal) nodig. Het is niet mogelijk om de dagelijkse media-set in te schakelen zonder de wekelijkse in te schakelen, omdat in de meeste gevallen voor herstel vanuit een incrementele kopie juist wekelijkse tapes vereist zijn. Deze bevinden zich altijd in de bibliotheek of worden opgeslagen op een minder verre locatie.
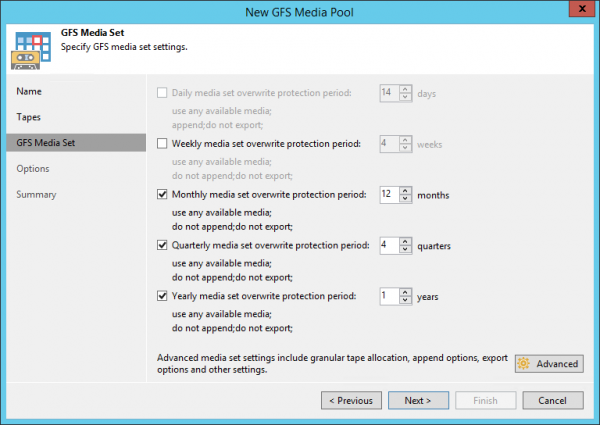
De logica achter tape-jobs in de GFS-media-pool , technische schrijvers kunnen het bevestigen. In het kort, zonder in detail te treden, worden in de wekelijkse en oudere media-sets alleen volledige back-ups (inclusief virtuele volledige back-ups) gekopieerd, één voor elke datum, terwijl in de dagelijkse – alle back-ups die op de huidige dag in de repository staan, omdat een back-up-job vaker kan worden uitgevoerd dan eenmaal per dag.
Parallelisme, starttijd en wachttijd in GFS-pools
Het is nu mogelijk om gelijktijdig meerdere ketens of jobs op verschillende schijven van de bibliotheek te schrijven, ook in de GFS-media-pools (voorheen alleen in de gewone). Dit wordt ingeschakeld in de stap Opties media-pool.
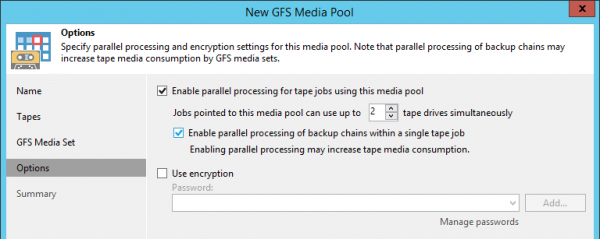
Belangrijke opmerking: hetzelfde bestand wordt altijd naar één stroom geschreven, daarom wordt aangeraden om in het geval van meerdere grote virtuele machines , zodat de back-up uit meerdere ketens bestaat.
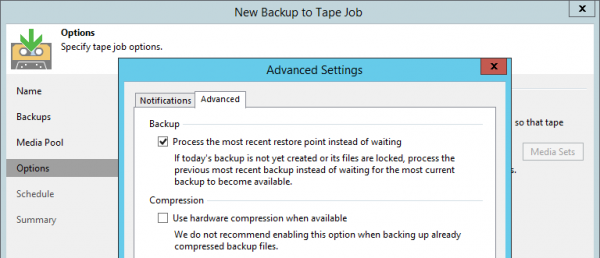
Bovendien is het nu mogelijk om de starttijd van de GFS-job zelf te kiezen. Veel gebruikers waren niet tevreden met de start om middernacht en de daaropvolgende wachttijd van bijna een hele dag, totdat de source-job was voltooid. Nu kan deze tijd bijvoorbeeld op de late avond worden ingesteld, wanneer er al iets te kopiëren is naar de tape. Bovendien hebben we op verzoek van gebruikers de optie in de geavanceerde instellingen opgenomen, die voorheen alleen met een registersleutel kon worden geactiveerd. Het is voldoende om te kiezen Verwerk het meest recente herstelpunt in plaats van te wachten En op de cassette wordt gekopieerd wat er op het moment van starten van de tapejob in de repository staat (bijvoorbeeld het punt van gisteren), er is helemaal geen wachttijd.
Verbeterd werken met meerdere bibliotheken
Het gaat hier om de situatie waarin meer dan één bibliotheek aan één media pool is toegevoegd. Dit ondersteunden we eerder ook al, maar af en toe kwamen er klanten met klachten over niet helemaal voorspelbaar gedrag.
Was
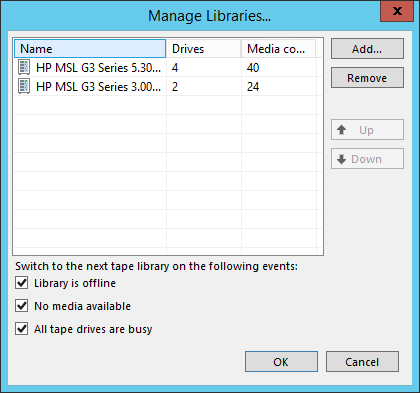
Bijvoorbeeld, een tapejob is gestart, nam twee drives in de eerste bibliotheek in beslag, maar de parallelle instellingen laten het toe om meteen 4 drives te gebruiken. Moet deze job overschakelen naar de tweede bibliotheek van de mediapool en deze ook gebruiken, of zou dat een oververbruik van middelen zijn?
Een andere situatie. Het is de optie geselecteerd om over te schakelen bij de voorwaarde 'geen beschikbare cassettes', in de eerste bibliotheek is er maar één cassette, maar daarop kunnen potentieel alle gegevens worden geplaatst. De instellingen staan echter toe om parallel op twee cassettes te schrijven. Moet in dit geval de tweede bibliotheek worden ingeschakeld?
We hebben besloten om dit gebied op orde te brengen door de mogelijkheid te bieden om het gedrag expliciet in te stellen.
Is
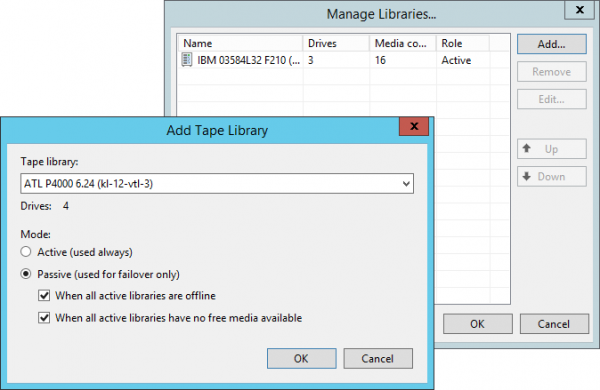
hebben rollen gekregen - actief en enpassief. En de mediapool zelf heeft twee modi: fouttolerant of failover (failover) en parallel schrijven
- (paralleling). Nu, afhankelijk van de vereisten, kan de mediapool op verschillende manieren worden ingesteld.
- Als je meerdere gelijke bibliotheken hebt en het is nodig om het schrijven naar hen te paralleliseren - zet je de modus voor parallel schrijven aan, daarvoor moeten aan alle bibliotheken actieve rollen worden toegewezen. In dit geval zullen nieuwe cassettes en drives direct worden ingeschakeld zodra er behoefte aan is, ongeacht in welke bibliotheek ze zich bevinden. Prioriteit is er nog steeds - we zullen in eerste instantie proberen middelen te vinden in de bibliotheek die hoger op de lijst staat. Maar als er één hoofd bibliotheek is en één oude of standalone drive in reserve, zet je de failover-modus aan, waarbij je de hoofd bibliotheek bovenaan de lijst plaatst en de passieve rol voor de reserve apparatuur kiest. De overstap naar zo'n apparaat zal alleen plaatsvinden wanneer dat echt nodig is, zodat de job in ieder geval op de een of andere manier kan functioneren. Zo'n situatie wordt als onverhoopt beschouwd, waarvoor een melding per e-mail wordt verzonden.
Er is een complexere situatie die we voorlopig nog niet ondersteunen – meerdere actieve bibliotheken naast passieve. Feedback zal aangeven of er behoefte is aan dergelijke configuraties en of we deze functie in de toekomst moeten verbeteren. Dit is een standaardpraktijk.
Ondersteuning voor WORM
WORM – Write Once Read Many – tapes die niet gewist of overschreven kunnen worden , er kunnen alleen gegevens aan worden toegevoegd. Het verplichte gebruik hiervan wordt geregeld door de regels van bepaalde organisaties, bijvoorbeeld in de gezondheidszorg. Het belangrijkste probleem met deze tapes was vroeger dat VBR tijdens of de titel schreef die later niet kon worden gewist, en tape-jobs vielen met een foutmelding bij een dergelijke poging.
In 9.5 Update 4 is volledige ondersteuning voor deze tapes gerealiseerd. WORM-mediamiddelen zijn toegevoegd, zowel normaal als GFS, waar alleen tapes van dit type in kunnen worden geplaatst.
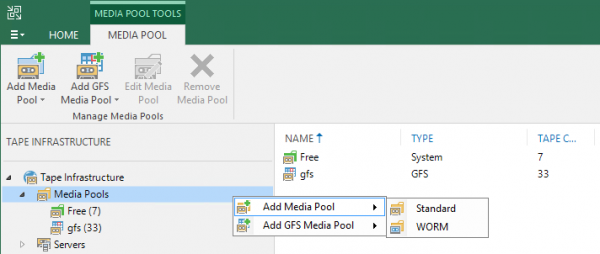
Nieuwe tapes hebben een blauwe, ‘bevroren’ icoon. Voor de gebruiker verschilt het werken met WORM-tapes niet van het werken met gewone tapes.
De ‘WORM-status’ van tapes wordt oorspronkelijk bepaald door de suffix van de , als de streepjescode normaal of onleesbaar is, geeft de driver informatie bij de eerste invoer van de tape. Het is niet mogelijk om WORM-tapes in een normale media-pool te plaatsen en daarop te schrijven. Leuk detail: er zijn al gebruikers die WORM-streepjescodes op gewone tapes hebben geplakt en verrast waren over de veranderingen in hun infrastructuur na de update.
De chip van de tape
Gelijktijdig met de implementatie van niet-overschrijfbare tapes, zijn we gaan werken met de . Standaardattributen in de chip werden eerder niet door ons gebruikt, nu schrijven en lezen we er in sommige van, maar beschouwen ze niet als de primaire gegevensbron. De belangrijkste referentie blijft nog steeds de titel van de tape. Deze beslissing bleek de juiste: een maand na de release zien we hoe de ‘dierenpartij’ van gebruikershardware verrassingen oplevert wat betreft het werken met de chip.
Back-up van NDMP-volumes naar tape
Tot slot – over de meest gevraagde functie op basis van het aantal reacties van deze update. Het is nu mogelijk om back-ups van NDMP-volumes naar tapes te maken. In de VBR-infrastructuur moet , waarna in de tape-job het mogelijk wordt om volumes van deze host te selecteren. Ze worden op banden gelegd als bestanden met een speciaal attribuut, zodat ze bij catalogisering van gewone bestanden kunnen worden onderscheiden.
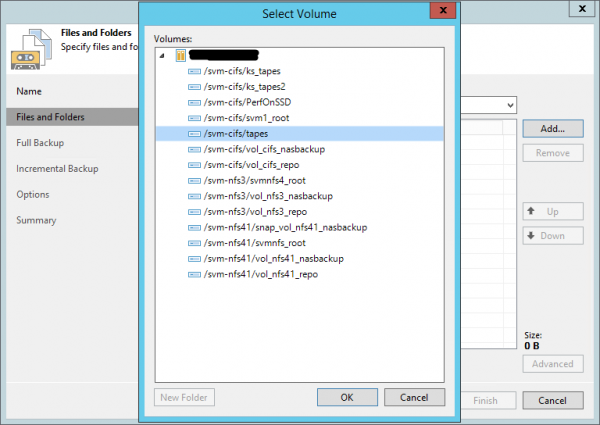
In de eerste versie zijn er bepaalde beperkingen: extensies worden niet ondersteund, en er kan alleen een back-up en herstelling van het volledige volume worden uitgevoerd, maar niet van afzonderlijke bestanden. De back-up werkt via (in het geval van NetApp – ), hier zijn enkele bijzonderheden: het maximale aantal incrementale punten is 9, waarna een volledige back-up wordt geforceerd.
Tot slot
Dit waren slechts de belangrijkste vernieuwingen op het gebied van back-up naar tape in VBR 9.5 Update 4. Andere wijzigingen noem ik in een lijst:
- mogelijkheid om de volgorde van source-jobs en bestanden in tape-jobs op te geven;
- rol Tape Operator toegevoegd (de gebruiker kan alles doen, behalve herstellen vanaf tape – daar is de Restore Operator voor);
- volledige include/exclude-masks toegevoegd in de file tape-job (behalve NDMP);
- herstellen in de file tape-job verbeterd (de map wordt hersteld met de bestanden die op het moment van de back-up daarin waren, en niet met alle bestanden die ooit in de loop van de back-ups daarin stonden – een zeer gewilde functie, trouwens);
- de snelheid van het herstel van een zeer groot aantal bestanden van banden verhoogd;
- de algoritme voor het kiezen van de volgende tape voor het schrijven verbeterd, in het bijzonder, bij gelijke omstandigheden wordt rekening gehouden met de hoeveelheid geschreven/gelezen gegevens gedurende zijn hele leven, we nemen de meest recente;
- de stabiliteit van het product verbeterd.
Nuttige links
Ter afwisseling geef ik enkele links naar Russische bronnen:
- En we zijn weer terug naar de vertrouwde plaats met overzichtvideo's "Hoe het werkt" (helaas voorlopig alleen in het Engels) – je kunt het bekijken . Over tapes wordt gesproken op dia's 95 – 102.
Bron: habr.com
