

Hallo, Habr.
Mijn naam is Misha Butrimov, en ik wil je graag iets vertellen over Cassandra. Mijn verhaal zal nuttig zijn voor degenen die nog nooit met NoSQL-databases zijn geconfronteerd, omdat er veel implementatiekenmerken en valkuilen zijn die je moet kennen. Als je alleen Oracle of een andere relationele database hebt gezien, zullen deze dingen je leven redden.
Wat is er goed aan Cassandra? Het is een NoSQL-database, ontworpen zonder een enkel punt van falen, die goed schaalbaar is. Als je een paar terabyte aan een bepaalde database moet toevoegen, voeg je gewoon knooppunten aan het netwerk toe. Wil je het uitbreiden naar een andere datacenter? Voeg knooppunten aan het cluster toe. Wil je de verwerkte RPS verhogen? Voeg knooppunten aan het cluster toe. Het werkt ook in omgekeerde richting.
Wat is er nog meer goed aan? Het verwerkt veel verzoeken. Maar hoeveel is veel? 10, 20, 30, 40 duizend verzoeken per seconde - dat is nog steeds niet veel. 100 duizend verzoeken per seconde bij schrijven - ook dat is niet veel. Er zijn bedrijven die zeggen dat ze 2 miljoen verzoeken per seconde aankunnen. Daar moeten we ze waarschijnlijk op vertrouwen.
En in principe heeft Cassandra één groot verschil met relationele gegevens - het lijkt er helemaal niet op. Dit is iets heel belangrijks om te onthouden.
Niet alles wat hetzelfde eruitziet, werkt op dezelfde manier.
Op een gegeven moment kwam er een collega naar me toe en vroeg: "Hier is SQL, de Cassandra querytaal, en daarin zijn select statements, er is een where, er is een and. Ik typ letters en het werkt niet. Waarom niet?" Als je Cassandra beschouwt als een relationele database, is dat de perfecte manier om je leven op een wrede manier te beëindigen. En ik moedig dat niet aan, het is verboden in Rusland. Je ontwerpt gewoon iets verkeerd.
Bijvoorbeeld, een klant komt naar ons toe en zegt: "Laten we een database bouwen voor series, of een database voor een receptenwijzer. We hebben daar gerechten met ingrediënten of een lijst van series en de acteurs daarin." We zeggen vrolijk: "Laten we dat doen!" Het is slechts twee bytes om door te sturen, een paar tabellen en alles is klaar, alles zal heel snel en betrouwbaar werken. En alles is geweldig, totdat de klanten komen en zeggen dat huisvrouwen ook het omgekeerde probleem oplossen: ze hebben een lijst van ingrediënten en willen weten welk gerecht ze willen bereiden. Je bent verloren.
Dat komt doordat Cassandra een hybride database is: het is zowel een key-value store als een wide-column store. Om het in Java of Kotlin te beschrijven, zou je het zo kunnen formuleren:
Map<RowKey, SortedMap>
Dat wil zeggen, een map waarin een gesorteerde map ligt. De eerste sleutel voor deze map is de Row key of Partition key — de partitie-sleutel. De tweede sleutel, die de sleutel is voor de gesorteerde map, is de Clustering key.
Om de gedistribueerdheid van de database te illustreren, tekenen we drie knooppunten. Nu moeten we begrijpen hoe we de gegevens over de knooppunten moeten verdelen. Want als we alles in één knooppunt blijven proppen (er kunnen er trouwens duizend, tweeduizend of meer zijn), dan is dat niet echt gedistribueerd. Daarom hebben we een wiskundige functie nodig die een nummer retourneert. Gewoon een nummer, een lange int, die binnen een bepaald bereik valt. En één knooppunt zal verantwoordelijk zijn voor één bereik, het tweede voor een tweede, en zo verder.
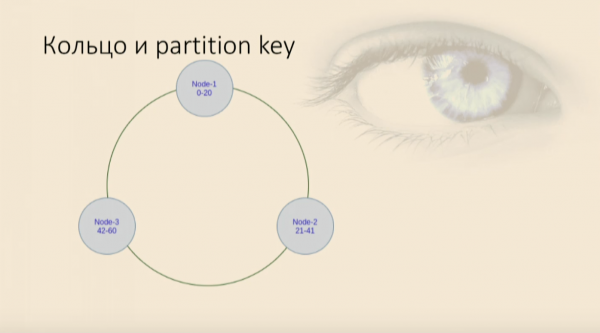
Dit nummer wordt verkregen met behulp van een hashfunctie die juist wordt toegepast op wat we de Partition key noemen. Dit is de kolom die wordt ingevoerd in de Primary key-directive, en dit is de kolom die de eerste en belangrijkste sleutel van de map zal zijn. Het bepaalt welke gegevens naar welk knooppunt gaan. Een tabel wordt in Cassandra bijna met dezelfde syntaxis aangemaakt als in SQL:
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
De Primary key bestaat in dit geval uit één kolom, en deze is ook de partitie-sleutel.
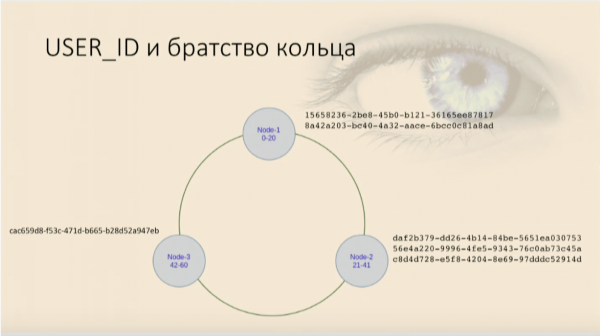
Hoe zullen de gebruikers verdeeld worden? Een deel gaat naar het ene knooppunt, een deel naar het andere, en een deel naar het derde. Dit resulteert in een gewone hash-tabel, ook wel map genoemd, die in Python een dictionary is, en dit is een eenvoudige key-value structuur, waaruit we alle waarden kunnen lezen en waarbij we kunnen lezen en schrijven op basis van sleutel.
Select: wanneer allow filtering verandert in full scan, of hoe je het niet moet doen
Laten we een select statement schrijven: select * from users where userid = Het lijkt een beetje op Oracle: we schrijven een select, geven de voorwaarden op en alles werkt, gebruikers worden opgehaald. Maar als we bijvoorbeeld een gebruiker met een bepaald geboortejaar willen selecteren, zegt Cassandra dat het de query niet kan uitvoeren. Dit komt omdat het helemaal niet weet hoe de gegevens over het geboortejaar zijn verdeeld — als sleutel is er slechts één kolom aangegeven. Dan zegt het: 'Oké, ik kan deze query nog steeds uitvoeren. Voeg allow filtering toe.' We voegen de directive toe, alles werkt. En op dat moment gebeurt er iets verschrikkelijks.
Wanneer we met testdata werken, gaat alles prima. Maar wanneer je een query in productie uitvoert, waar we bijvoorbeeld 4 miljoen records hebben, gaat het niet zo goed. Omdat allow filtering een directive is die Cassandra toestaat om alle gegevens uit deze tabel van alle knooppunten te verzamelen, allemaal, (als er veel zijn in deze cluster), en pas daarna te filteren. Dit is gelijk aan een Full Scan, en waarschijnlijk is niemand daar enthousiast over. datacenters Als we alleen gebruikers op basis van ID's nodig hadden, zou dat ons goed uitkomen. Maar soms moeten we andere queries schrijven en andere beperkingen aan de selectie toevoegen. Daarom herinneren we ons: dit is allemaal een map, die een partitioneringssleutel heeft, maar binnenin is het een gesorteerde map.
En deze heeft ook een sleutel, die we de Clustering Key noemen. Deze sleutel bestaat uit de kolommen die we selecteren, waarmee Cassandra begrijpt hoe de gegevens fysiek gesorteerd worden en op elke knoop opgeslagen zullen worden. Met andere woorden, voor een bepaalde Partition key vertelt de Clustering key hoe de gegevens precies in deze boom moeten worden geplaatst en welke plaats ze daar zullen innemen.
Het is echt een boom; daar wordt gewoon een comparator aangeroepen, waarbij we een set kolommen als object doorgeven, en deze wordt ook in de vorm van een opsomming van kolommen ingesteld.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
CREATE TABLE users_by_year_salary_id (
user_id uuid,
name text,
year int,
salary float,
PRIMARY KEY((year), salary, user_id)
Let op de primaire sleutel, de eerste parameter (in ons geval het jaar) is altijd de partition sleutel. Deze kan uit één of meerdere kolommen bestaan, dat maakt niet uit. Als er meerdere kolommen zijn, moet deze opnieuw in haakjes worden geplaatst, zodat de preprocessortaal begrijpt dat dit de primaire sleutel is, gevolgd door de andere kolommen — de clustering sleutel. Deze worden in de vergelijker doorgegeven in de volgorde waarin ze zijn ingevoerd. Dat wil zeggen, de eerste kolom is van grotere waarde, de tweede is minder belangrijk, enzovoorts. Zoals we bijvoorbeeld voor gegevensklassen schrijven, waarbij we de velden equals specificeren: we sommen de velden op en schrijven voor elk welke belangrijker zijn en welke minder. In Cassandra zijn dit conditioneel gesproken de velden van de gegevensklasse waarop de voor geschreven equals zal worden toegepast.
We stellen de sortering in en leggen beperkingen op.
We moeten onthouden dat de volgorde van sortering (aflopend, oplopend, het maakt niet uit) wordt ingesteld op het moment dat de sleutel wordt aangemaakt, en dat deze later niet kan worden gewijzigd. Deze bepaalt fysiek hoe de gegevens worden gesorteerd en hoe ze opgeslagen zullen worden. Als de clustering sleutel of de volgorde van sortering moet worden gewijzigd, moet er een nieuwe tabel worden aangemaakt en moeten de gegevens daarin worden overgezet. Het is niet mogelijk om dat met een bestaande tabel te doen.
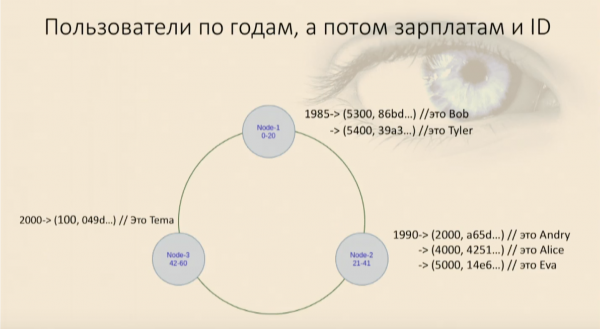
We hebben onze tabel gevuld met gebruikers en zagen dat ze eerst op jaar van geboorte in een ring waren geplaatst, en daarna op elke node op salaris en gebruikers-ID. Nu kunnen we selecteren met beperkingen.
Daar verschijnt onze werkende. waar, en.en we krijgen de gebruikers, alles is weer goed. Maar als we proberen alleen een deel van de clustering sleutel te gebruiken, dat minder belangrijk is, zal Cassandra onmiddellijk een fout geven dat het geen plek in onze map kan vinden waar dit object met deze velden voor de vergelijker null is, en waar deze, die we net hebben ingesteld, ligt. Ik zou dan opnieuw alle gegevens van deze node moeten ophalen en filteren. Dit is vergelijkbaar met een volledige scan binnen een node, wat slecht is.
In elke onduidelijke situatie, maak een nieuwe tabel aan.
Als we gebruikers op ID, leeftijd of salaris willen kunnen ophalen, wat moeten we dan doen? Niets. Gewoon twee tabellen gebruiken. Als we gebruikers op drie verschillende manieren moeten ophalen, zijn er drie tabellen nodig. Die tijden dat we schreven ruimte op de schijf probeerden te besparen zijn voorbij. Dit is de goedkoopste bron. Het kost veel minder dan de responstijd, die rampzalig kan zijn voor de gebruiker. Een gebruiker vindt het veel prettiger om iets in een seconde te ontvangen dan in 10 minuten.
We ruilen de overtollige opslag, gedenominaliseerde gegevens in voor de mogelijkheid om goed te schalen en betrouwbaar te werken. Want eigenlijk kan een cluster dat bestaat uit drie datacenters, met elk vijf knooppunten, met een acceptabel niveau van gegevensbehoud (wanneer er zeker niets verloren gaat), de volledige vernietiging van één datacenter overleven. En nog twee knooppunten in elk van de twee overgeblevenen. Pas daar zal de problemen beginnen. Dit is een behoorlijk goede redundantie, het kost een paar extra SSD's en processors. Daarom, om Cassandra te gebruiken, die totaal geen SQL is en geen relaties of externe sleutels heeft, moeten we een paar eenvoudige regels weten.
We ontwerpen alles vanuit de aanvraag. De gegevens zijn niet de belangrijkste, maar hoe de applicatie ermee omgaat. Als ze verschillende gegevens op verschillende manieren nodig heeft of dezelfde gegevens op verschillende manieren, moeten we ze zo opslaan dat het handig is voor de applicatie. Anders zullen we in een Full Scan verzanden en zal Cassandra ons geen voordeel bieden.
Gedemoraliseerde gegevens zijn de norm. We vergeten de normale vormen, we hebben geen relationele databases meer. We leggen iets honderd keer vast, het zal honderd keer liggen. Dat is nog steeds goedkoper dan traag worden.
We kiezen sleutels voor partitionering zodat ze normaal verdeeld zijn. We willen niet dat de hash van onze sleutels in een smal bereik valt. Hetzelfde geldt voor het geboortejaar in het bovenstaande voorbeeld - het is een slecht voorbeeld. Het is een goede als onze gebruikers per geboortejaar normaal verdeeld zijn, en slecht als het gaat om leerlingen van groep 5 - dan is het niet goed mogelijk om te partitioneren.
De sortering wordt eenmaal geselecteerd tijdens het creëren van de Clustering Key. Als deze gewijzigd moet worden, moeten we onze tabel opnieuw overzetten met een andere sleutel.
En het belangrijkste: als we op 100 verschillende manieren dezelfde gegevens moeten ophalen, betekent dit dat we 100 verschillende tabellen zullen hebben.
Bron: habr.com
