

Elke bewerking met grote gegevens vereist aanzienlijke computerkracht. Gewoon het verplaatsen van gegevens uit de database naar Hadoop kan weken duren of kosten als een vliegtuigvleugel. Wil je niet wachten en besparen? Balans de load over verschillende platforms. Een van de manieren is pushdown-optimalisatie.
Ik vroeg de vooraanstaande trainer in Rusland voor de ontwikkeling en het beheer van Informatica-producten, Alexey Ananyev, om de pushdown-optimalisatiefunctie in Informatica Big Data Management (BDM) toe te lichten. Heb je ooit geleerd om met Informatica-producten te werken? Waarschijnlijk heeft Alexey je de basis van PowerCenter geleerd en uitgelegd hoe je mappings moet opstellen.
Alexey Ananyev, hoofd van de opleidingsafdeling bij DIS Group
Wat is pushdown?
Velen van jullie zijn al bekend met Informatica Big Data Management (BDM). Het product kan grote gegevens integreren uit verschillende bronnen, ze tussen verschillende systemen verplaatsen, biedt gemakkelijke toegang, maakt profilering mogelijk en veel meer.
In bekwame handen kan BDM wonderen verrichten: taken worden snel uitgevoerd met minimale computerresources.
Wil je dit ook? Leer de pushdown-functie in BDM te gebruiken voor het verdelen van computerlast over verschillende platforms. De pushdown-technologie maakt het mogelijk om een mapping in een script om te zetten en de omgeving te kiezen waarin dit script wordt uitgevoerd. Deze keuzemogelijkheid stelt je in staat de sterke punten van verschillende platforms te combineren en hun maximale prestaties te bereiken.
Voor het instellen van de scriptuitvoeringsomgeving moet het type pushdown worden gekozen. Het script kan volledig op Hadoop worden uitgevoerd of gedeeltelijk tussen de bron en de ontvanger worden verdeeld. Er zijn 4 mogelijke types pushdown. De mapping hoeft niet in een script te worden omgezet (native). De mapping kan maximaal op de bron worden uitgevoerd (source) of volledig op de bron (full). De mapping kan ook in een Hadoop-script worden omgezet (none).
Pushdown-optimalisatie
De genoemde 4 types kunnen op verschillende manieren worden gecombineerd – optimaliseer de pushdown voor de specifieke behoeften van het systeem. Bijvoorbeeld, het is vaak zinvol om gegevens uit de database te extraheren met behulp van de eigen mogelijkheden. En de gegevens te transformeren met de kracht van Hadoop, zodat de database zelf niet wordt overbelast.
Laten we een geval bekijken waarin zowel de bron als de ontvanger zich in de database bevinden en de uitvoeringsplatform voor de conversies kan worden gekozen: afhankelijk van de instellingen kan dit Informatica, een database-server of Hadoop zijn. Dit voorbeeld zal de technische kant van het functioneren van dit mechanisme het beste illustreren. Natuurlijk komt zo'n situatie in het echte leven niet voor, maar het is perfect voor het demonstreren van de functionaliteit.
Laten we mapping nemen voor het lezen van twee tabellen in een enkele Oracle-database. En laten we de leesresultaten in een tabel in dezelfde database opslaan. Het schema van de mapping zal als volgt zijn:
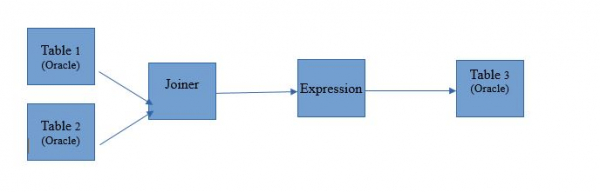
In de vorm van mapping op Informatica BDM 10.2.1 ziet het er als volgt uit:
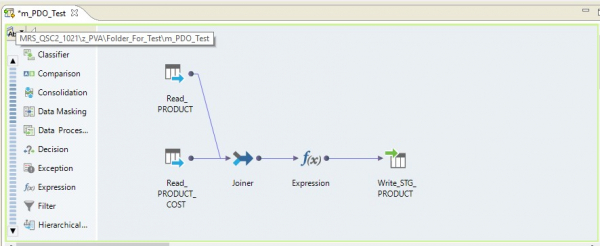
Type pushdown – native
Als we de native pushdown-type kiezen, zal de mapping worden uitgevoerd op de server Informatica. De gegevens worden gelezen van de Oracle-server, naar de Informatica-server overgebracht, daar omgevormd en naar Hadoop verzonden. Met andere woorden, we krijgen een gebruikelijk ETL-proces.
Type pushdown – source
Bij het kiezen van type source krijgen we de mogelijkheid om ons proces te verdelen tussen server databases (DB) en Hadoop. Bij het uitvoeren van het proces met deze instelling worden er aanvraag verzoeken voor gegevensselectie uit tabellen naar de database gestuurd. De rest zal worden uitgevoerd in de vorm van stappen op Hadoop.
Het uitvoeringsschema zal er als volgt uitzien:
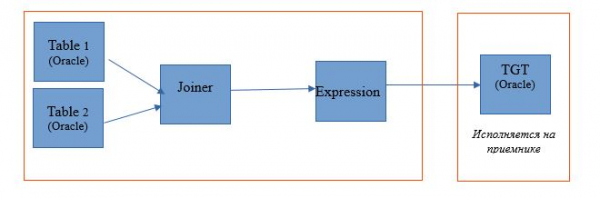
Hieronder staat een voorbeeld van de instellingen van de uitvoeringsomgeving.
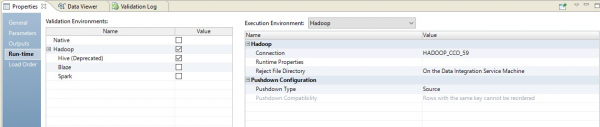
In dit geval zal de mapping in twee stappen worden uitgevoerd. In de instellingen zullen we zien dat het is omgevormd tot een script dat naar de bron wordt gestuurd. Daarbij zal de samenvoeging van tabellen en de transformatie van gegevens plaatsvinden in de vorm van een overschreven aanvraag op de bron.
In de afbeelding hieronder zien we de geoptimaliseerde mapping op BDM, en op de bron – een overschreven aanvraag.
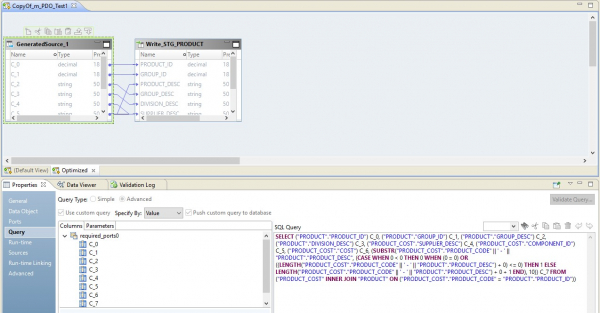
De rol van Hadoop in deze configuratie zal zijn om de stroom van gegevens te beheren – ze te dirigeren. Het resultaat van de aanvraag zal naar Hadoop worden gestuurd. Na het lezen zal het bestand uit Hadoop naar de ontvanger worden geschreven.
Type pushdown – full
Bij het kiezen van type full zal de mapping volledig omgevormd worden tot een aanvraag op de database. En het resultaat van de aanvraag zal naar Hadoop worden gestuurd. Het schema van een dergelijk proces is hieronder weergegeven.
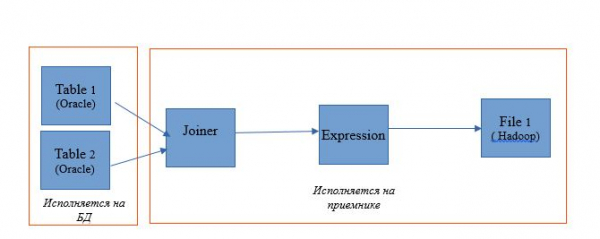
Een voorbeeld van de instellingen is hieronder weergegeven.
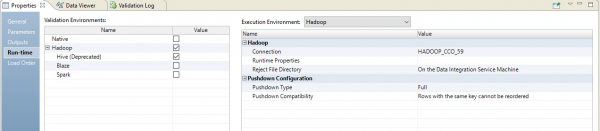
Hierdoor krijgen we een geoptimaliseerde mapping die lijkt op de vorige. Het enige verschil is dat de hele logica naar de ontvanger wordt overgebracht in de vorm van een overschrijving van zijn invoeging. Een voorbeeld van de geoptimaliseerde mapping is hieronder weergegeven.
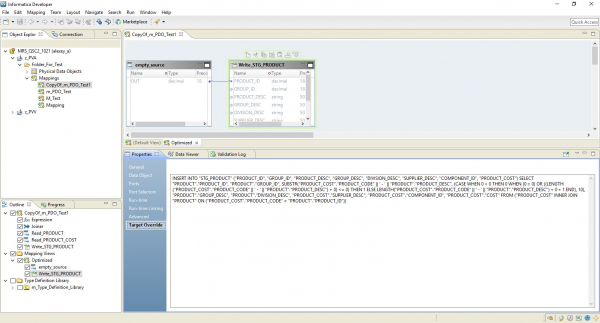
Hier, net als in het vorige geval, fungeert Hadoop als dirigent. Maar hier wordt de gegevensbron volledig gelezen, en vervolgens wordt de logica voor gegevensverwerking op niveau van de ontvanger uitgevoerd.
Pushdown-type – null
En de laatste variant – het pushdown-type, waarbij onze mapping verandert in een script op Hadoop.
De geoptimaliseerde mapping zal er nu als volgt uitzien:
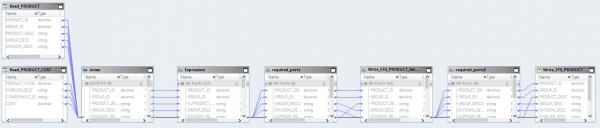
Hier worden de gegevens uit de bronbestanden eerst gelezen op Hadoop. Vervolgens worden deze twee bestanden met dezelfde middelen samengevoegd. Daarna worden de gegevens getransformeerd en naar de database geëxporteerd.
Door de principes van pushdown-optimalisatie te begrijpen, kunnen veel processen voor het werken met big data zeer efficiënt worden georganiseerd. Zo heeft een groot bedrijf nog niet zo lang geleden in slechts enkele weken een enorme hoeveelheid gegevens uit een opslag in Hadoop geëxporteerd, die daarvoor jarenlang was verzameld.
Bron: habr.com
