

Dit artikel is geschreven om je te helpen de juiste oplossing voor jezelf te kiezen en de verschillen tussen SDS als Gluster, Ceph en Vstorage (Virtuozzo) te begrijpen.
In de tekst worden links naar artikelen gebruikt die bepaalde problemen uitgebreider belichten, daarom zullen de beschrijvingen zo kort mogelijk zijn met gebruik van de belangrijkste punten zonder onnodige uitweidingen en inleidende informatie, die je zelf desgewenst op internet kunt vinden.
De behandelde onderwerpen vereisen eigenlijk een serieuze toon, maar in de moderne wereld houden steeds meer mensen er niet van om veel te lezen))), daarom kun je snel doorlezen en je keuze maken, en als iets niet duidelijk is, kun je de links volgen of onduidelijke woorden googlen))), en dit artikel functioneert als een doorzichtige verpakking voor deze diepgaande onderwerpen, die de inhoud laat zien - de belangrijkste punten van elke oplossing.
Gluster
Laten we beginnen met Gluster, dat veel wordt gebruikt door fabrikanten van hyper-geconvergeerde platforms met SDS op basis van open source voor virtuele omgevingen en dat te vinden is op de website van RedHat onder de opslagsectie, waar je kunt kiezen uit twee SDS-opties: Gluster of Ceph.
Gluster bestaat uit een stack van vertalers - diensten die alle taken met betrekking tot het verdelen van bestanden en dergelijke uitvoeren. Brick - een dienst die één schijf bedient, Volume - een volume (pool) - dat deze bricks samenvoegt. Vervolgens bestaat er een dienst voor het verdelen van bestanden over groepen met behulp van de functie DHT (distributed hash table). We zullen de Sharding-dienst niet in de beschrijving opnemen omdat er in de hieronder vermelde links beschrijvingen van de bijbehorende problemen zullen zijn.
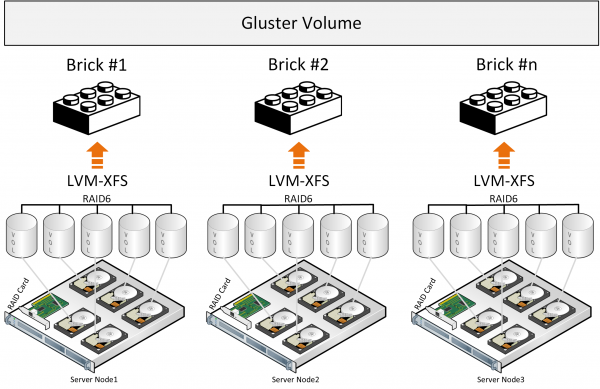
Bij het schrijven wordt het bestand volledig in de brick geplaatst en een kopie wordt parallel geschreven naar de brick op de tweede server. Daarna zal het tweede bestand worden geschreven naar de tweede groep van twee bricks (of meer) op verschillende servers.
Als de bestanden ongeveer dezelfde grootte hebben en het volume slechts uit één groep bestaat, is alles in orde, maar onder andere voorwaarden ontstaan de volgende problemen uit de beschrijvingen:
- de ruimte in de groepen wordt ongelijkmatig benut, afhankelijk van de bestandsgroottes, en als er onvoldoende ruimte in een groep is om een bestand te schrijven - krijg je een foutmelding, het bestand wordt niet geschreven en niet herverdeeld naar een andere groep;
- bij het schrijven van één bestand gaat de IO alleen naar één groep, terwijl de andere stil liggen;
- het is niet mogelijk om de IO van het volledige volume te krijgen bij het schrijven van één bestand;
- en het algemene concept lijkt minder efficiënt door het gebrek aan gegevensverdeling over blokken, waar het eenvoudiger is om balans te creëren en het probleem van gelijkmatige verdeling op te lossen, in plaats van zoals nu het bestand helemaal in een blok terechtkomt.
Uit de officiële beschrijving komt ook onvermijdelijk het besef op dat Gluster functioneert als een bestandopslag bovenop traditionele hardware RAID. Er zijn pogingen gedaan om bestanden te snijden (Sharding) in blokken, maar al dit extra werk voegt prestatiedalingen toe aan de reeds bestaande architectonische benadering, plus het gebruik van vrij beschikbare componenten met prestatiebeperkingen zoals Fuse. Er zijn geen metadata-services, wat de prestaties en fouttolerantie van de opslag beperkt bij de distributie van bestanden over blokken. Betere prestatiecijfers zijn te observeren bij de configuratie “Distributed Replicated” en het aantal nodes moet minimaal 6 zijn voor het opzetten van een betrouwbare replica 3 met een optimale belastingverdeling.
Deze bevindingen zijn ook gerelateerd aan de beschrijving van de gebruikservaring en bij de vergelijking met , daarnaast is er een beschrijving van de ervaring die leidt tot het begrip van deze meer performante en betrouwbaardere configuratie
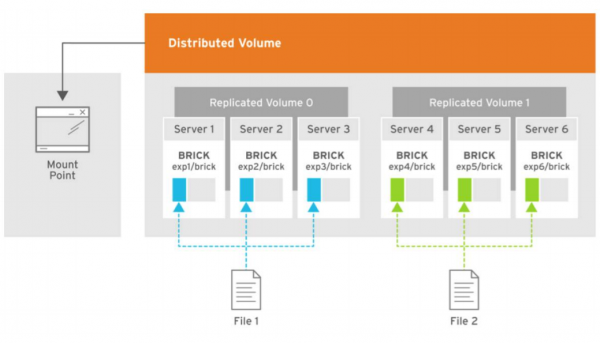
Op de afbeelding is de belastingverdeling te zien bij het schrijven van twee bestanden, waar de kopieën van het eerste bestand verdeeld worden over de eerste drie servers, die zijn samengevoegd in volume 0-groep, en drie kopieën van het tweede bestand worden opgeslagen op de tweede groep volume1 van drie servers. Elke server heeft één schijf.
De algemene conclusie is dat je Gluster kunt gebruiken, maar met het besef dat er beperkingen zijn op het gebied van prestaties en fouttolerantie, wat moeilijkheden met zich meebrengt onder bepaalde omstandigheden van hypergeconvergeerde oplossingen, waar middelen ook nodig zijn voor de rekenbelasting van virtuele omgevingen.
Er zijn ook bepaalde prestatie-indicatoren van Gluster die kunnen worden bereikt onder bepaalde voorwaarden met beperking in
Ceph
Laten we nu Ceph bekijken vanuit de architectuurbeschrijvingen die ik heb kunnen Er is ook een vergelijking tussen , waar je meteen kunt begrijpen dat Ceph bij voorkeur op afzonderlijke servers moet worden uitgerold, aangezien zijn services alle hardwarebronnen vereisen bij belasting.
Architectuur complexer dan Gluster met services zoals metadata services, maar de hele stack van componenten is behoorlijk ingewikkeld en niet erg flexibel voor gebruik in virtualisatieoplossingen. Gegevens worden in blokken opgeslagen, wat productievere prestaties lijkt te zijn, maar er zijn verliezen en latency in de hiërarchie van alle services (componenten) onder bepaalde belastingen en noodomstandigheden, bijvoorbeeld het volgende
Uit de beschrijving van de architectuur blijkt dat het hart CRUSH is, dat de plaats voor gegevensopslag kiest. Daarna komt PG - dit is de meest complexe abstractie (logische groep) om te begrijpen. PG's zijn nodig om CRUSH efficiënter te maken. Het belangrijkste doel van PG is objecten te groeperen om het resourceverbruik te verlagen, de prestaties te verhogen en schaalbaarheid te verbeteren. Directe adressering van objecten, afzonderlijk, zonder ze in PG's te groeperen, zou zeer kostbaar zijn. OSD is de service voor elke afzonderlijke schijf.
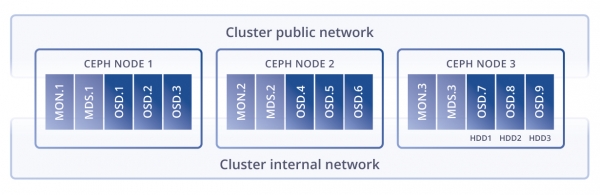
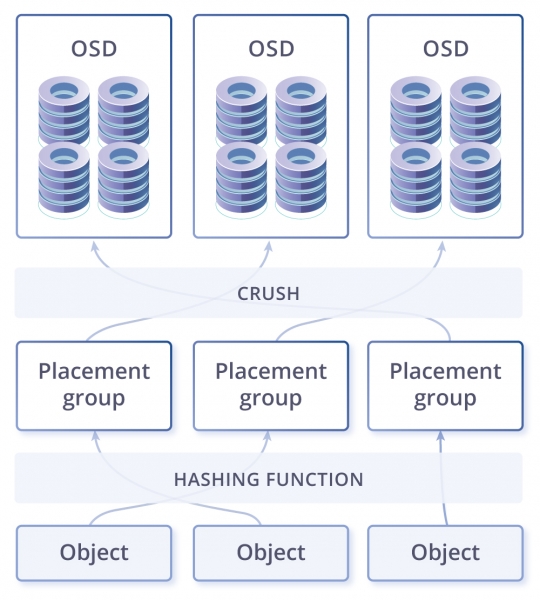
Een cluster kan één of meerdere datastores hebben voor verschillende doeleinden en met verschillende instellingen. De datastores zijn verdeeld in placement groups. In de placement groups worden de objecten opgeslagen die door klanten worden aangesproken. Dit is het einde van het logische niveau en het begin van het fysieke niveau, omdat er voor elke placement group één hoofdschijf en verschillende replica-schijven zijn toegewezen (hoeveel precies hangt af van de replicatiefactor van de pool). Met andere woorden, op logisch niveau wordt een object opgeslagen in een specifieke placement group, en op fysiek niveau - op de schijven die aan deze groep zijn toegewezen. De schijven kunnen fysiek op verschillende knooppunten of zelfs in verschillende datacenters liggen.
In dit schema lijken plaatsingsgroepen een noodzakelijke laag voor de flexibiliteit van de hele oplossing, maar tegelijkertijd ook een overbodige schakel in deze keten, wat onwillekeurig gedachten oproept over prestatieverlies. Bijvoorbeeld, bij het opslaan van gegevens moet het systeem deze verdelen in deze groepen en vervolgens op fysiek niveau naar de hoofdschijf en naar de schijven voor replicaties. Dat betekent dat de hashfunctie werkt bij het zoeken en invoegen van een object, maar er is een bijwerking – er zijn zeer grote kosten en beperkingen bij het opnieuw indelen van de hash (bij het toevoegen of verwijderen van een schijf). Een ander probleem met de hash is de starre positie van gegevens, die niet kan worden gewijzigd. Dus als een schijf een verhoogde belasting ondervindt, kan het systeem niet naar een andere schijf schrijven (door een andere schijf te kiezen), de hashfunctie verplicht om gegevens volgens een regel te plaatsen, ongeacht hoe slecht het met de schijf gaat, daarom gebruikt Ceph veel geheugen bij het herbouwen van PG in het geval van self-healing of uitbreiding van de opslag. Conclusie is dat Ceph goed werkt (hoewel traag), maar alleen wanneer er geen schaling, noodgevallen en upgrades zijn.
Er zijn natuurlijk opties om de prestaties te verhogen door middel van caching en cache-tiering, maar daarvoor is goed hardware nodig en er zullen toch verliezen zijn. Over het algemeen lijkt Ceph aantrekkelijker dan Gluster voor productie-omgevingen. Bij het gebruik van deze producten moet ook een belangrijke factor in overweging worden genomen – dat is het hoge niveau van competentie, ervaring en professionaliteit met een sterke focus op Linux, omdat het cruciaal is om alles correct uit te rollen, in te stellen en te onderhouden, wat nog meer verantwoordelijkheid en druk op de beheerder legt.
Vstorage
Het ziet er nog interessanter uit qua architectuur bij , die samen met de hypervisor op dezelfde knooppunten en op dezelfde , maar het is heel belangrijk om alles goed te configureren om goede prestaties te behalen. Dat betekent dat het heel eenvoudig is om zo'n product uit de doos te implementeren op een willekeurige configuratie zonder rekening te houden met aanbevelingen volgens de architectuur, maar dat zal niet efficiënt zijn.
Wat kan er naast de KVM-QEMU hypervisor-services coexistieren? Dit zijn slechts enkele services waar een compacte, optimale hiërarchie van componenten is gevonden: de klantservice gemonteerd via FUSE (aangepast, niet open source), de metadata-service MDS, en de chunk service, die op fysiek niveau gelijk is aan één schijf, en dat is het dan. Voor snelheid is het natuurlijk optimaal om een fouttolerante opstelling met twee replica's te gebruiken, maar door caching en logging op SSD-schijven te implementeren, kan foutencodering (erase coding of RAID6) aanzienlijk worden versneld op een hybride systeem of zelfs beter op een all-flash systeem. Met EC (erase coding) is er een klein nadeel: bij het wijzigen van één gegevensblok moeten de pariteitswaarden opnieuw worden berekend. Om verliezen tijdens deze operatie te omzeilen, schrijft Ceph in EC vertraagd en kunnen er prestatieproblemen optreden bij bepaalde aanvragen, wanneer bijvoorbeeld alle blokken moeten worden berekend. In het geval van Virtuozzo Storage worden wijzigingen in gegevensblokken opgeslagen met behulp van de benadering van een 'log-structured file system', wat de kosten voor pariteitsberekeningen minimaliseert. Om enkele opties voor prestatiewinst met en zonder EC ongeveer in te schatten, is er De cijfers kunnen bij benadering worden verkregen, afhankelijk van de nauwkeurigheidsfactor van de hardwarefabrikant, maar de rekentools helpen goed bij het plannen van de configuratie.
Een eenvoudig opslagcomponentenschema betekent niet dat deze componenten geen maar als alle kosten vooraf worden berekend, kan er worden gerekend op een samenwerking nabij de hypervisor.
Er is een schema dat het verbruik van hardwarebronnen door de Ceph- en Virtuozzo-storage-services vergelijkt.
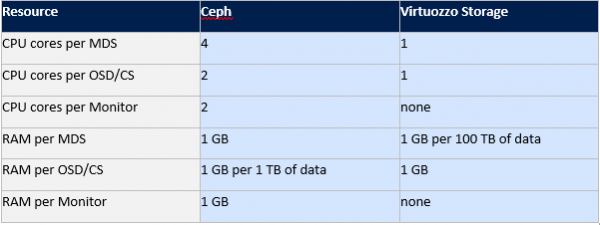
Als eerder Gluster en Ceph konden worden vergeleken aan de hand van oude artikelen, door de belangrijkste regels eruit te gebruiken, is het met Virtuozzo moeilijker. Er zijn niet veel artikelen over dit product en informatie kan alleen uit de documentatie komen op of in het Russisch als we Vstorage beschouwen als een opslag die wordt gebruikt in bepaalde hyper-converged oplossingen in bedrijven zoals en Acronis.
Ik zal proberen te helpen met de beschrijving van deze architectuur, dus de tekst zal iets langer zijn, maar om zelf het document te begrijpen, is veel tijd nodig, en de bestaande documentatie kan alleen als naslagwerk worden gebruikt door de inhoudsopgave te bekijken of door op een trefwoord te zoeken.
Laten we het schrijfproces in een hybride configuratie van hardware met de hierboven beschreven componenten bekijken: het schrijven begint op de node van waaruit de client (de FUSE-mount service) het heeft geïnitieerd, maar de master metadata service (MDS) zal de client zeker rechtstreeks naar de juiste chunk service (block storage service, CS) leiden, wat betekent dat de MDS niet betrokken is bij het schrijfproces, maar gewoon naar de noodzakelijke chunk service wijst. In feite kan de analoge voorstelling van de schrijfactie worden vergeleken met het vullen van vaten met water. Elk vat vertegenwoordigt een datablock van 256 MB.
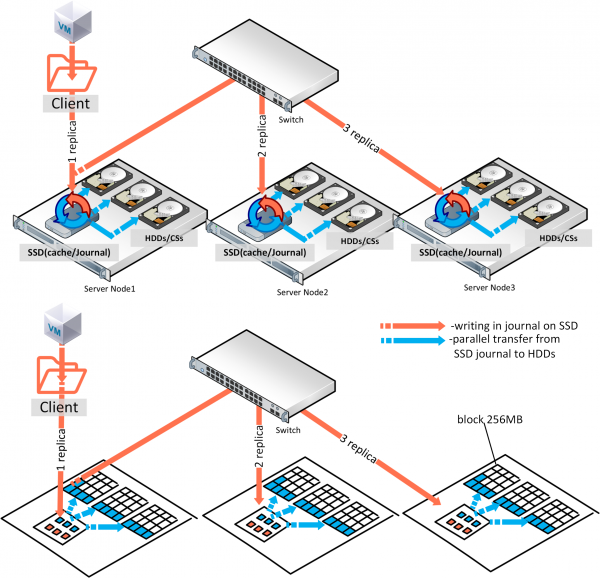
Dat wil zeggen, één schijf bestaat uit een bepaald aantal van zulke vaten, dus het volume van de schijf gedeeld door 256 MB. Elke copie wordt in één node geschreven, terwijl de tweede bijna parallel al naar een andere node gaat, enzovoort… Als we drie replica's hebben en er zijn SSD-schijven voor cache (voor lezen en schrijflogs), dan zal de bevestiging van de schrijfactie plaatsvinden na de schrijfactie in de SSD-log, terwijl de parallelle overschrijving van SSD op HDD als het ware op de achtergrond doorgaat. In het geval van drie replica's zal de commit van de schrijfactie plaatsvinden na bevestiging van de SSD van de derde node. Het kan lijken alsof de schrijfsnelheid van drie SSD's kan worden gedeeld door drie en we de schrijfsnelheid van één replica krijgen, maar het schrijven van kopieën gebeurt parallel en de netwerklatentie is meestal hoger dan die van SSD's, en in wezen zal de schrijfprestaties afhankelijk zijn van het netwerk. Daarom, om de werkelijke IOPS te zien, is het noodzakelijk om Vstorage volledig correct te belasten volgens , dat wil zeggen, we moeten de werkelijke belasting testen, niet het geheugen en de cache, waarbij het belangrijk is om de juiste blokgrootte, het aantal threads, enz. mee te nemen.
Het eerder genoemde logboek op SSD werkt zo dat zodra er gegevens in terechtkomen, deze onmiddellijk door de service worden gelezen en op de HDD worden geschreven. Er zijn meerdere metadata-services (MDS) per cluster en hun aantal wordt bepaald door de quorum die volgens het Paxos-algoritme werkt. Vanuit het perspectief van de klant is de FUSE-mountpoint een map in de clusteropslag die zichtbaar is voor alle knooppunten van het cluster; elk knooppunt heeft een gemonteerde client volgens dit principe, zodat deze opslag voor elk knooppunt toegankelijk is.
Voor de prestaties van elk van de hierboven beschreven benaderingen is het uiterst belangrijk tijdens de plannings- en implementatiefase om het netwerk correct in te stellen, waar de balans wordt bereikt door aggregatie en een goed afgestemde bandbreedte van de netwerkverbinding. Bij aggregatie is het belangrijk om het hash-algoritme en de framegroottes goed te kiezen. Er is ook een zeer sterk verschil met de eerder genoemde SDS; dit is fuse met de fast path-technologie in Virtuozzo Storage. Dit voegt, naast de gemoderniseerde fuse in tegenstelling tot andere open source oplossingen, aanzienlijk meer IOPS toe en laat je niet beperkt worden door horizontale of verticale schaalbaarheid. Over het algemeen lijkt deze, vergeleken met de eerder beschreven architecturen, krachtiger, maar voor dit voordeel moet je natuurlijk licenties kopen in plaats van met Ceph en Gluster.
Samenvattend kunnen we de top drie benadrukken: de eerste plaats qua prestaties en betrouwbaarheid wordt ingenomen door Virtuozzo Storage, de tweede door Ceph en de derde door Gluster.
Criteria voor de keuze van Virtuozzo Storage: dit is de optimale set van architectuurcomponenten, de gemoderniseerde fuse met fast path voor deze aanpak, een flexibele configuratie van hardware, lager verbruik van middelen en de mogelijkheid om samen te werken met computing (berekeningen / virtualisatie), wat het volledig geschikt maakt voor een hypergeconvergeerde oplossing waarin het deel uitmaakt. De tweede plaats is voor Ceph, omdat het een productievere architectuur is dan Gluster, dankzij de operaties met blokken en de meer flexibele scenario's en de mogelijkheid om in grotere clusters te werken.
Er is de wens om een vergelijking te schrijven tussen vSAN, Space Direct Storage, Vstorage en Nutanix Storage, testen van Vstorage op HPE, Huawei hardware, evenals scenario's voor de integratie van Vstorage met externe hardware-oplossingen voor opslag. Daarom, als je dit artikel leuk vond, zou het goed zijn om je feedback te ontvangen, die mijn motivatie voor nieuwe artikelen kan versterken, rekening houdend met jouw opmerkingen en wensen.
Bron: habr.com
