

Data Science voor beginners
1. Sentimentanalyse (Analyse van gevoelens via tekst)
Bekijk de volledige implementatie van het Data Science project met behulp van de broncode — .
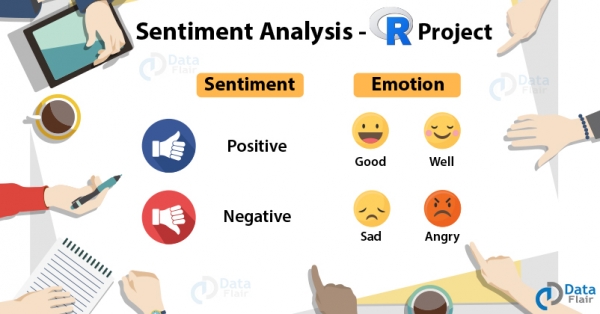
Sentimentanalyse is de analyse van woorden om gevoelens en meningen te bepalen, die positief of negatief kunnen zijn. Dit is een type classificatie waarbij de klassen binair (positief en negatief) of meervoudig (blij, boos, verdrietig, vervelend …) kunnen zijn. We implementeren dit Data Science project in de programmeertaal R en gebruiken een dataset uit het pakket 'janeaustenR'. We zullen algemene woordenboeken gebruiken, zoals AFINN, bing en loughran, inner join uitvoeren, en ten slotte zullen we een wordcloud maken om het resultaat weer te geven.
Taal: R
Dataset/Pakket: janeaustenR
Dit artikel is vertaald met de ondersteuning van EDISON Software, dat , evenals .
2. Fake News Detectie (Detectie van nepnieuws)
Til je vaardigheden naar een hoger niveau door te werken aan een Data Science project voor beginners — .
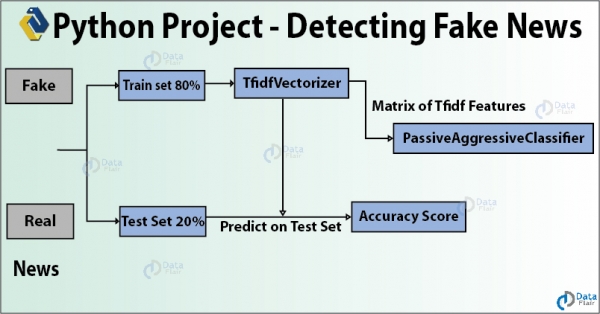
Nepnieuws is valse informatie die via sociale media en andere online media wordt verspreid voor politieke doeleinden. In dit idee voor een Data Science project zullen we Python gebruiken om een model te bouwen dat nauwkeurig kan bepalen of een nieuwsbericht echt of nep is. We zullen TfidfVectorizer maken en PassiveAggressiveClassifier gebruiken om nieuws te classificeren als 'echt' of 'nep'. We zullen een dataset van 7796 × 4 gebruiken en alles uitvoeren in Jupyter Lab.
Taal: Python
Dataset/Pakket: news.csv
3. Detecteren van de ziekte van Parkinson (Detectie van Parkinson's ziekte)
Beweeg vooruit door te werken aan het idee voor een Data Science Project — .
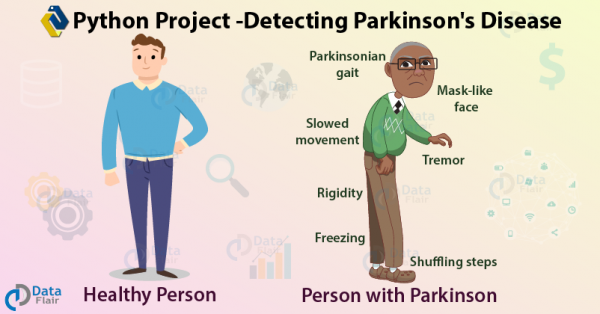
We zijn Data Science gaan gebruiken om de gezondheidszorg en diensten te verbeteren — als we een ziekte in een vroeg stadium kunnen voorspellen, hebben we veel voordelen. In dit Data Science-project leren we de ziekte van Parkinson te identificeren met behulp van Python. Dit is een neurodegeneratieve, progressieve aandoening van het centrale zenuwstelsel die de beweging beïnvloedt en trillingen en stijfheid veroorzaakt. Het heeft invloed op de dopamine-producerende neuronen in de hersenen en ieder jaar raakt het meer dan 1 miljoen mensen in India.
Taal: Python
Dataset/Pakket: UCI ML Parkinsons dataset
Data Science-projecten van gemiddelde complexiteit
4. Speech Emotion Recognition (Emotieherkenning uit spraak)
Bekijk de volledige uitvoering van het Data Science-project — .
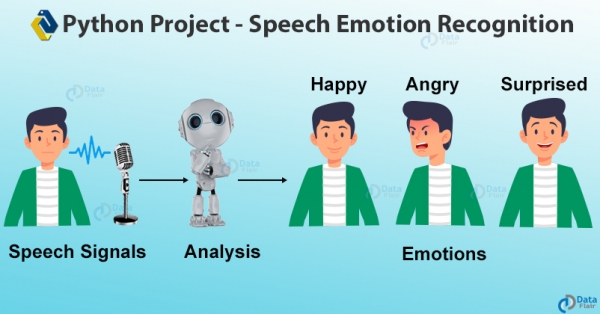
Laten we nu leren hoe we verschillende bibliotheken gebruiken. Dit Data Science-project maakt gebruik van librosa voor spraakherkenning. SER is het proces van het identificeren van menselijke emoties en affectieve toestanden aan de hand van spraak. Aangezien we toonhoogte en intonatie gebruiken om emoties met onze stem uit te drukken, is SER relevant. Maar omdat emoties subjectief zijn, is het annoteren van geluid een uitdaging. We zullen functies zoals mfcc, chroma en mel gebruiken en de RAVDESS-dataset toepassen voor emotieherkenning. We zullen een MLPC-classificator voor dit model creëren.
Taal: Python
Dataset/Pakket: RAVDESS dataset
5. Gender and Age Detection (Geslacht- en leeftijdsherkenning)
Impressioneer werkgevers met het nieuwste Data Science-project — .
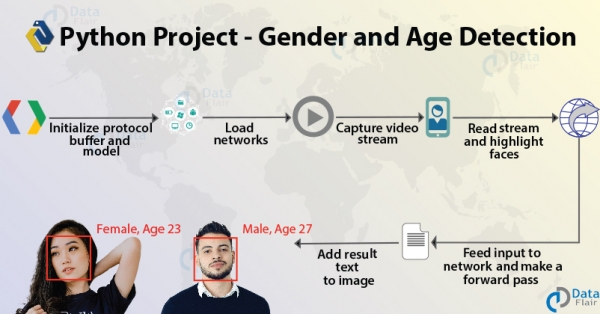
Dit is een interessant Data Science-project met Python. Met slechts één afbeelding leer je het geslacht en de leeftijd van een persoon te voorspellen. Hier introduceren we je in Computer Vision en zijn principes. We zullen bouwen aan en gebruikmaken van de modellen die zijn getraind door Tal Hassner en Gil Levi voor de Adience-dataset. Onderweg zullen we enkele .pb, .pbtxt, .prototxt en .caffemodel-bestanden gebruiken.
Taal: Python
Dataset/Pakket: Adience
6. Uber Data Analysis (Analyse van Uber-gegevens)
Bekijk de volledige uitvoering van het Data Science-project met de broncode — .
Dit is een gegevensvisualisatieproject met ggplot2, waarin we R en zijn bibliotheken gebruiken en verschillende parameters analyseren. We zullen de Uber Pickups-dataset in New York gebruiken en visualisaties creëren voor verschillende tijdsperioden van het jaar. Dit vertelt ons hoe tijd invloed heeft op de ritten van klanten.
Taal: R
Dataset/Pakket: Uber Pickups in New York City dataset
7. Detectie van slaperigheid bij chauffeurs
Bespaar je vaardigheden door te werken aan een Top Data Science Project — .
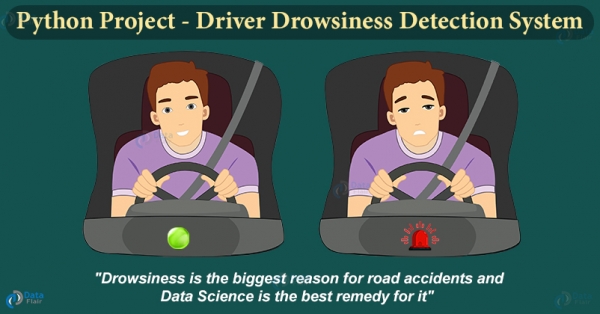
Slaperig rijden is extreem gevaarlijk, en elk jaar gebeuren er ongeveer duizend ongevallen doordat chauffeurs in slaap vallen tijdens het rijden. In dit Python-project zullen we een systeem creëren dat in staat is om slaperige chauffeurs te detecteren en hen te waarschuwen met een geluidssignaal.
Dit project is gerealiseerd met behulp van Keras en OpenCV. We zullen OpenCV gebruiken voor gezichts- en oogdetectie, terwijl we met Keras de toestand van het oog (Open of Gesloten) classificeren met behulp van diepgaande neural netwerkmethoden.
8. Chatbot
Creëer een chatbot met Python en maak een stap vooruit in je carrière — .
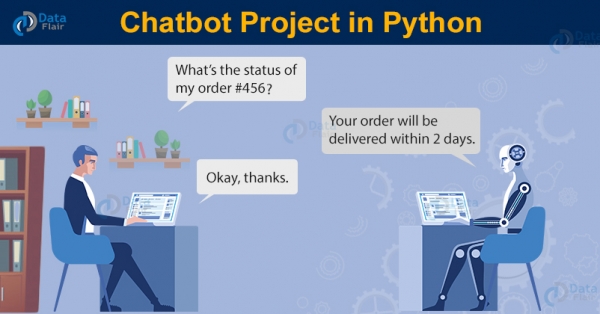
Chatbots zijn een integraal onderdeel van bedrijven. Veel bedrijven moeten diensten aan hun klanten bieden, en dit vereist veel arbeidskracht, tijd en inspanning. Chatbots kunnen een groot deel van de interactie met klanten automatiseren door te antwoorden op veelgestelde vragen. Er zijn in principe twee soorten chatbots: domeinspecifiek en open-domein. Domeinspecifieke chatbots worden vaak gebruikt om specifieke problemen op te lossen. Daarom moet je ze configureren voor effectief gebruik in jouw vakgebied. Open-domein chatbots kunnen op elke vraag worden gevraagd, waardoor enorme hoeveelheden gegevens nodig zijn voor hun training.
Dataset: Intents json-bestand
Taal: Python
Geavanceerde Data Science-projecten
9. Afbeelding Bijschrift Generator
Bekijk de volledige implementatie van het project met de broncode — .
Het beschrijven van wat er op een afbeelding staat is een gemakkelijke taak voor mensen, maar voor computers is een afbeelding gewoon een reeks cijfers die de kleurwaarde van elke pixel vertegenwoordigen. Dit is een moeilijke taak voor computers. Begrijpen wat er in een afbeelding staat en dan een beschrijving in natuurlijke taal (bijvoorbeeld in het Engels) creëren, is opnieuw een uitdagende taak. Dit project gebruikt methoden voor diep leren, waarbij we een Convolutioneel Neuraal Netwerk (CNN) implementeren in combinatie met een Recurrent Neuraal Netwerk (LSTM) om een afbeeldingsbijschriftgenerator te creëren.
Dataset: Flickr 8K
Taal: Python
Framework: Keras
10. Detectie van creditcardfraude
Doe je best terwijl je werkt aan het Data Science-projectidee — .
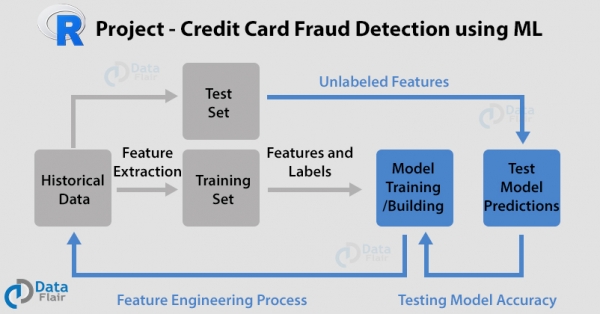
Tot nu toe heb je de methoden en concepten begonnen te begrijpen. Laten we doorgaan naar enkele geavanceerde projecten op het gebied van data science. In dit project zullen we de programmeertaal R gebruiken met algoritmen zoals , logistieke regressie, kunstmatige neurale netwerken en gradient boosting classifiers. We zullen een dataset van kaarttransacties gebruiken om creditcardtransacties te classificeren als frauduleus of legitiem. We zullen verschillende modellen voor hen selecteren en prestatietrends opstellen.
Taal: R
Dataset/Pakket: Dataset kaarttransacties
11. Aanbevelingssysteem voor films
Ontdek de implementatie van het beste Data Science-project met broncode —
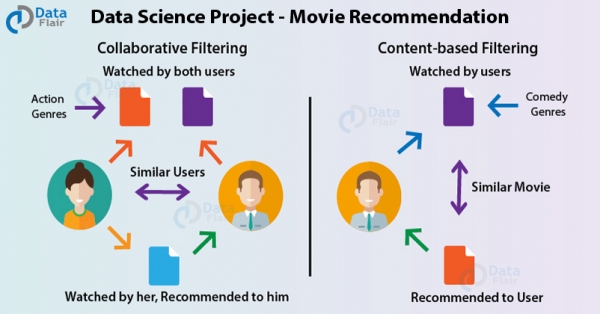
In dit Data Science-project zullen we R gebruiken om filmaanbevelingen te doen via machine learning. Het aanbevelingssysteem stuurt voorstellen naar gebruikers via een filtreringsproces, gebaseerd op de voorkeuren van andere gebruikers en kijkgeschiedenis. Als A en B van Home Alone houden, en B van Mean Girls houdt, kan het A worden aanbevolen — ze zouden het ook leuk kunnen vinden. Dit stelt klanten in staat om met het platform te interageren.
Taal: R
Dataset/Pakket: MovieLens dataset
12. Klantsegmentatie
Indruk maken op werkgevers met een Data Science-project (inclusief broncode) — .
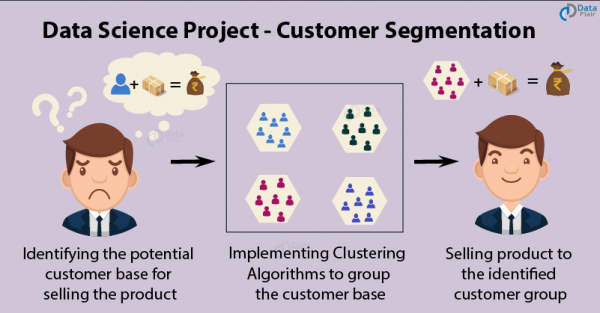
Klantsegmentatie is een populaire toepassing . Door middel van clustering bepalen bedrijven klantsegmenten om met een potentiële gebruikersbasis te werken. Ze verdelen klanten in groepen op basis van gemeenschappelijke kenmerken, zoals geslacht, leeftijd, interesses en uitgavenpatronen, zodat ze hun producten effectief aan elke groep kunnen verkopen. We zullen gebruik maken van , en ook de verdeling naar geslacht en leeftijd visualiseren. Vervolgens analyseren we hun jaarlijkse inkomsten en uitgavenniveau.
Taal: R
Dataset/Pakket: Mall_Customers dataset
13. Classificatie van borstkanker
Bekijk de volledige uitvoering van het Data Science-project in Python — .
Terugkomend op de medische bijdrage van data science, laten we leren hoe we borstkanker kunnen detecteren met Python. We zullen de IDC_regular dataset gebruiken om invasieve ductale carcinoom te identificeren, de meest voorkomende vorm van borstkanker. Het ontwikkelt zich in de melkkanalen en dringt door in het vezelige of vetweefsel van de borst buiten het kanaal. In dit idee van een wetenschappelijk project voor gegevensverzameling zullen we en de Keras-bibliotheek gebruiken voor classificatie.
Taal: Python
Dataset/Pakket: IDC_regular
14. Herkenning van verkeersborden
Nauwkeurigheid bereiken in zelfrijdende autotecnologie met een Data Science-project over met open source.
Verkeersborden en verkeersregels zijn cruciaal voor elke bestuurder om ongelukken te voorkomen. Om de regels te volgen, moet je eerst begrijpen hoe een verkeersbord eruit ziet. Een persoon moet alle verkeersborden leren voordat hij/zij toestemming krijgt om een voertuig te besturen. Maar nu groeit het aantal autonome voertuigen, en in de nabije toekomst zal iemand niet langer zelf een auto besturen. In het project 'Herkenning van verkeersborden' leer je hoe een programma het type verkeersbord kan herkennen door een afbeelding als invoer te nemen. De Duitse dataset voor verkeersbordherkenning (GTSRB) wordt gebruikt om een diep neuraal netwerk te bouwen voor de herkenning van de klasse waartoe het verkeersbord behoort. We creëren ook een eenvoudige grafische interface om met de applicatie te communiceren.
Taal: Python
Dataset: GTSRB (Duitse verkeersbordherkenningsbenchmark)
Lees verder
Bron: habr.com
