

In we hebben gesproken over tijdreeksvoorspellingen. Een logische vervolgstap is een artikel over het identificeren van anomalieën.
Toepassing
Het identificeren van anomalieën wordt gebruikt in gebieden zoals:
1) Voorspelling van apparatuurstoringen
Zo werden in 2010 de Iraanse centrifuges aangevallen door het Stuxnet-virus, dat een suboptimale werkwijze induceerde en een deel van de apparatuur onklaar maakte door versnelde slijtage.
Als er op de apparatuur anomaliedetectie-algoritmes waren gebruikt, had de storing mogelijk kunnen worden voorkomen.
Anomaliedetectie in apparatuur wordt niet alleen in de nucleaire industrie gebruikt, maar ook in de metallurgie en bij luchtgasturbines. En in andere gebieden waar voorspellende diagnose goedkoper is dan de mogelijke verliezen bij onvoorspelbare storingen.
2) Voorspelling van frauduleuze activiteiten
Als er geld van uw kaart in Podolsk wordt afgeschreven terwijl het in Albanië is gedaan, kan het nodig zijn om de transacties extra te controleren.
3) Identificatie van afwijkende consumentenpatronen
Als een deel van de klanten afwijkend gedrag vertoont, kan er een probleem zijn waarvan u zich niet bewust bent.
4) Identificatie van afwijkende vraag en belasting
Als de verkopen in de FMCG-winkel onder de ondergrens van het vertrouwensinterval van de voorspelling dalen, is het de moeite waard om de oorzaak van het gebeuren te achterhalen.
Benaderingen voor het identificeren van anomalieën
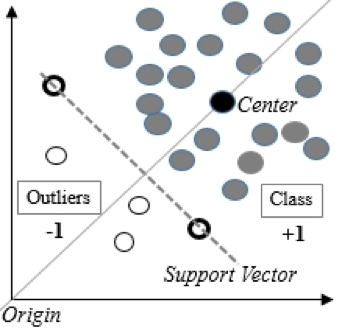
1) One-Class SVM-methode
Geschikt voor situaties waarin de gegevens in de trainingsset normaal verdeeld zijn en de testgegevens anomalieën bevatten.
De One-Class SVM-methode bouwt een niet-lineair oppervlak rond de oorsprong. Er kan een snijgrens worden ingesteld om te bepalen welke data als anomalieën worden beschouwd.
Op basis van de ervaring van ons team DATA4 is One-Class SVM het meest gebruikte algoritme voor het oplossen van de anomaliedetectietaak.
2) Isolate forest-methode
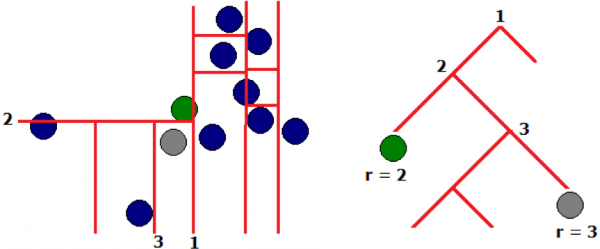
Bij de 'willekeurige' manier van het bouwen van bomen zullen uitschieters vroeg in het proces (op een ondiepe diepte van de boom) in bladeren vallen, wat betekent dat uitschieters gemakkelijker te 'isoleren' zijn. Het isoleren van anomalieën gebeurt in de eerste iteraties van het algoritme.
3) Elliptische envelop en statistische methoden
Wordt gebruikt wanneer de gegevens normaal verdeeld zijn. Hoe dichter de meting bij de staart van de mix van verdelingen ligt, hoe meer afwijkend de waarde is.
Bij deze klasse kunnen ook andere statistische methoden worden gerekend.
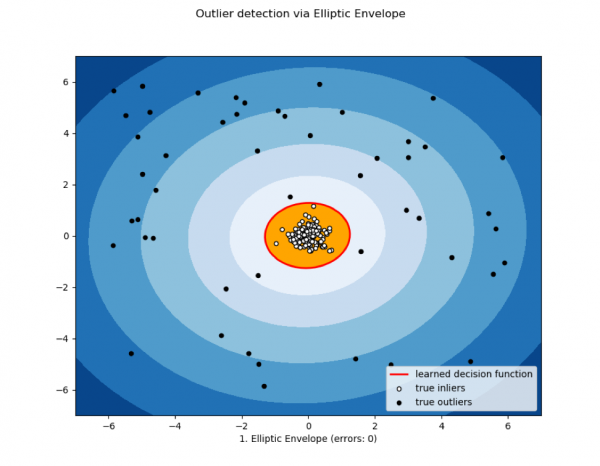
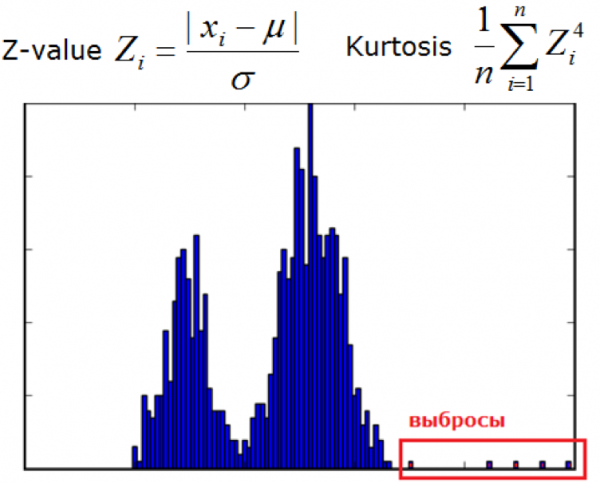
Afbeelding van de website dyakonov.org
4) Metrische methoden
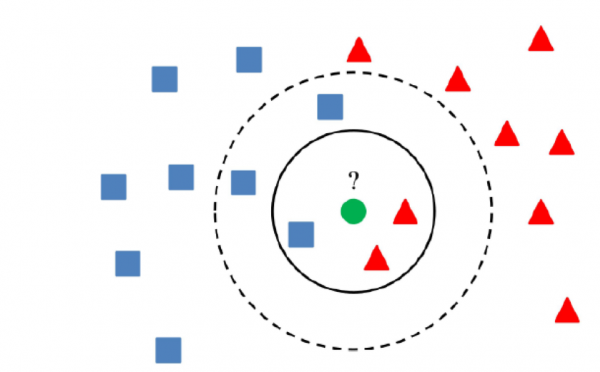
De methoden omvatten algoritmes zoals k dichtstbijzijnde buren, k-nabijgelegen buur, ABOD (angle-based outlier detection) of LOF (local outlier factor).
Geschikt als de afstand tussen waarden in de kenmerken gelijkwaardig of genormaliseerd is (om bijvoorbeeld niet de slang in papegaaien te meten).
Het k-dichtstbijzijnde buren-algoritme gaat ervan uit dat normale waarden zich binnen een bepaald gebied van de multidimensionale ruimte bevinden, en dat de afstand tot anomalieën groter zal zijn dan tot de scheidende hypervlak.
5) Clustering-methoden
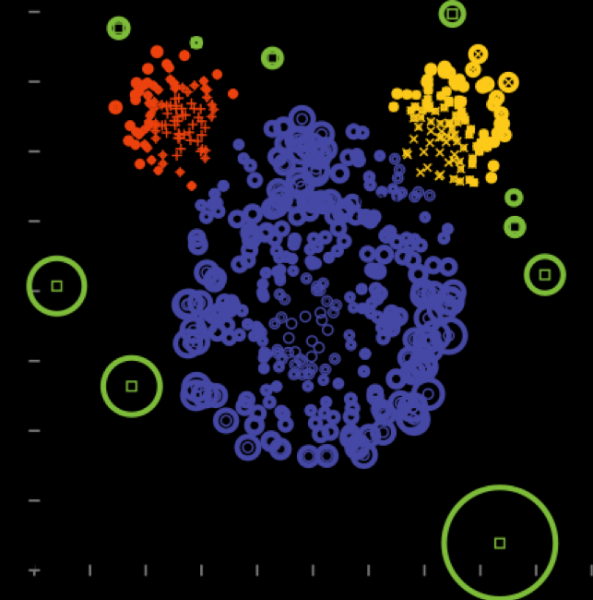
De essentie van clustering-methoden is dat als een waarde verder van de centra van clusters is dan een bepaalde hoeveelheid, de waarde als anomalie kan worden beschouwd.
Het belangrijkste is om een algoritme te gebruiken dat de gegevens correct clustert, wat afhangt van de specifieke taak.
6) Hoofdcomponentenanalyse
Geschikt voor situaties waarin richtingen van de grootste veranderingen in variantie worden benadrukt.
7) Algoritmen voor tijdreeksvoorspelling
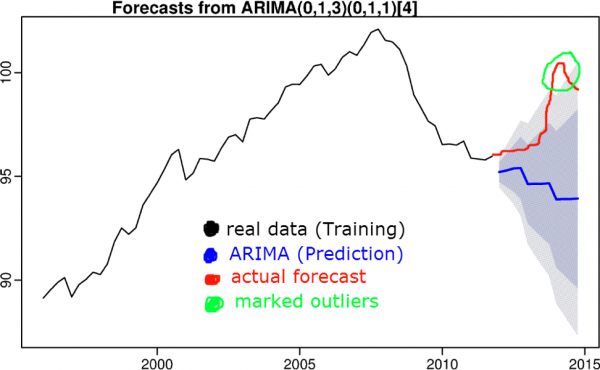
Het idee is dat als een waarde uit het betrouwbaarheidsinterval van de voorspelling valt, de waarde als anomalie wordt beschouwd. Voor tijdreeksvoorspellingen worden dergelijke algoritmen gebruikt, zoals drievoudige gladmaking, S(ARIMA), boosting enzovoort.
Over algoritmen voor tijdreeksvoorspelling werd in het vorige artikel gesproken.
8) Leiding met een leraar (regressie, classificatie)
Als de gegevens het toelaten, gebruiken we algoritmen van lineaire regressie tot recurrente netwerken. We meten het verschil tussen de voorspelling en de werkelijke waarde en trekken de conclusie over hoezeer de gegevens afwijken van de norm. Het is belangrijk dat het algoritme voldoende generaliserend vermogen heeft, en dat de trainingsset geen anomalieën bevat.
9) Modeltests
We benaderen de anomaliedetectietaak als een aanbevelingsprobleem. We ontleden onze functie-matrix met behulp van SVD of factorisatiemachines, en de waarden in de nieuwe matrix die significant afwijken van de oorspronkelijke, beschouwen we als anomalieën.
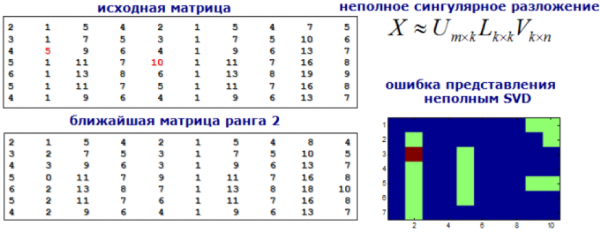
Afbeelding van de website dyakonov.org
Conclusie
In dit artikel hebben we de belangrijkste benaderingen voor anomaliedetectie besproken.
Het zoeken naar anomalieën kan in veel opzichten als kunst worden beschouwd. Er is geen ideaal algoritme of benadering die alle problemen oplost. Vaak wordt een combinatie van methoden gebruikt om een specifieke case op te lossen. Anomaliedetectie gebeurt met behulp van éénklasse methoden voor ondersteuningvectoren, isolerende bossen, metrische en cluster methoden, evenals met gebruik van hoofdcomponenten en tijdreeksvoorspelling.
Als u andere methoden kent, schrijf deze dan in de opmerkingen onder het artikel.
Bron: habr.com
