

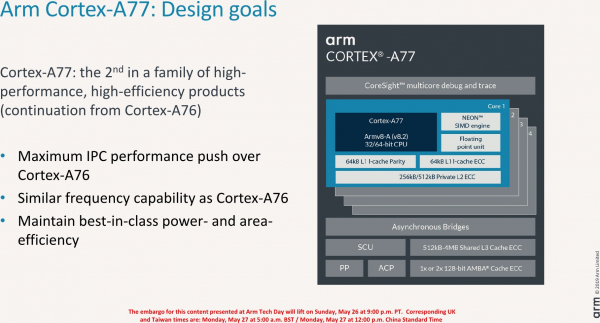
ARM heeft zijn nieuwste processorontwerp gepresenteerd - de Cortex-A77. Net als de Cortex-A76 van vorig jaar is deze kern bedoeld voor high-end taken in smartphones en verschillende apparaten. De ontwikkelaar richt zich op het verhogen van het aantal instructies dat per klokcycle wordt uitgevoerd (IPC). De kloksnelheden en het energieverbruik zijn ongeveer gelijk gebleven aan die van de Cortex-A76.
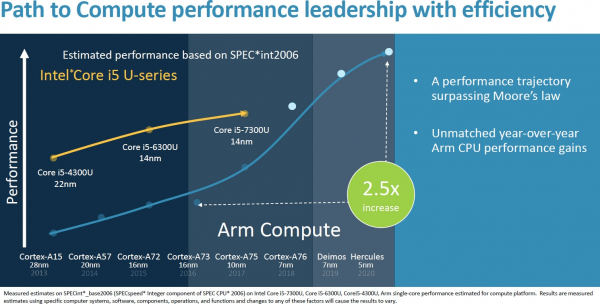
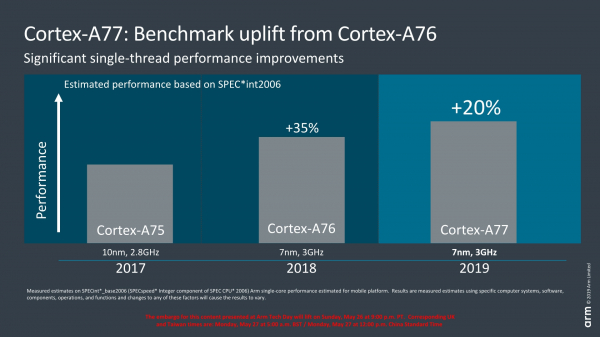
Momenteel richt ARM zich op het snel verhogen van de prestaties van zijn kernen. Volgens de plannen wil het bedrijf vanaf de Cortex-A73 in 2016 tot het Hercules-ontwerp in 2020 de CPU-kracht met 2,5 keer verhogen. De overstappen van 16 nm naar 10 nm en vervolgens naar 7 nm hebben al geleid tot hogere kloksnelheden, en in combinatie met de Cortex-A75-architectuur en later de Cortex-A76, heeft ARM geschat dat de prestaties tot nu toe met 1,8 keer zijn gestegen. Nu zal de Cortex-A77, door een toename van de IPC, de prestaties met nog eens 20% verhogen bij dezelfde kloksnelheid. Dit maakt een 2,5-voudige verhoging in 2020 zeer haalbaar.
Ondanks de 20% stijging van de IPC, is de energieconsumptie van de A77 volgens ARM niet gestegen. De compromis in dit geval is dat de chipoppervlakte van de A77 ongeveer 17% groter is dan die van de A76 bij gelijke technologische normen. Dit zal resulteren in iets hogere kosten per kern. Ter vergelijking met de prestaties van ARM, moet worden gezegd dat AMD in Zen 2 een stijging van de IPC van 15% heeft bereikt ten opzichte van Zen+, terwijl de IPC-waarden van Intel-kernen al jaren ongeveer op hetzelfde niveau blijven.
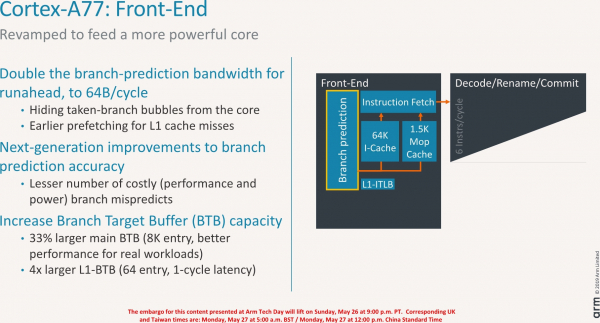
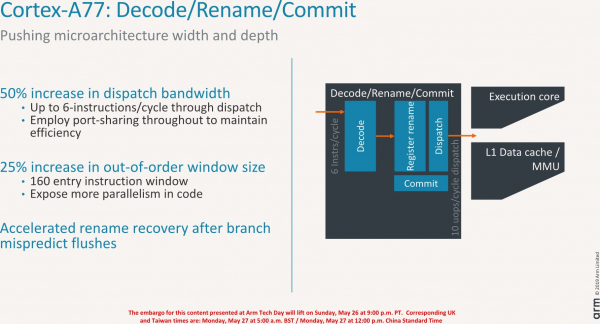
Het uitvoeringsvenster met wijziging van de volgorde van instructies (out-of-order window size) is met 25% vergroot tot 160 eenheden, wat de kern in staat stelt om de parallelle berekeningen te verhogen. Zelfs in de Cortex-A76 was er een grote buffer voor sprongadressen (Branch Target Buffer), en in de Cortex-A77 is deze nog eens met 33% vergroot tot 8 KB, waardoor de takvoorspellingsunit effectief kan omgaan met de toename van het aantal gelijktijdige instructies.
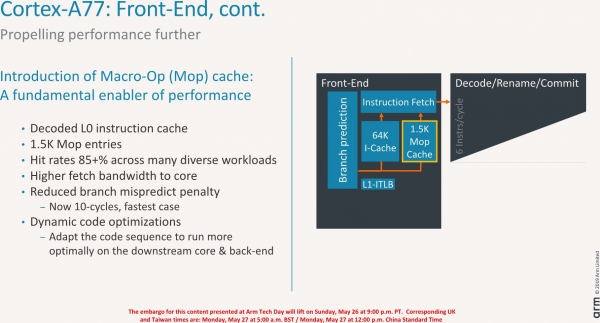
Een nog interessanter nieuwigheid is de compleet nieuwe 1,5 KB-cache, waarin macro-opdrachten (MOP) worden opgeslagen die uit de decoder-module komen. De ARM-architectuur decodeert instructies uit de gebruikersapplicatie in kleinere macro-opdrachten en splitst deze vervolgens op in micro-opdrachten die naar de uitvoeringskern worden gestuurd. De MOP-cache wordt gebruikt om de invloed van gemiste vertakkingen en resets te verminderen, aangezien macro-opdrachten nu in een apart blok worden opgeslagen en geen herdecodeerproces vereisen — dit verhoogt de algehele doorvoer van de kern. In bepaalde belastingen is het nieuwe blok een uiterst nuttige aanvulling op de standaard instructie-cache.
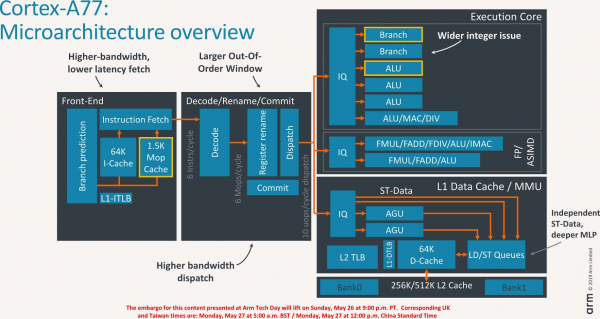
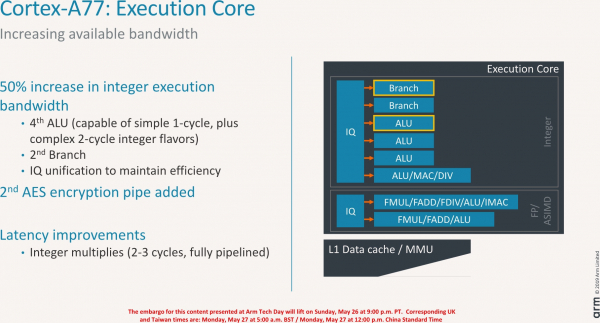
In de uitvoeringskern is een vierde ALU-blok en een tweede vertakking toegevoegd. De vierde ALU verhoogt de algehele doorvoer van de processor met 1,5 keer door de mogelijkheid om één-cyclische instructies (zoals ADD en SUB) en twee-cyclische gehele getallen operaties zoals vermenigvuldiging uit te voeren. De andere twee ALU's kunnen alleen basis één-cyclische instructies verwerken, terwijl het laatste blok belast wordt met complexere wiskundige bewerkingen, zoals deling, accumulerende vermenigvuldiging, enzovoorts. De tweede vertakking binnen de uitvoeringskern verdubbelt het aantal gelijktijdige vertakkingen dat de kern kan verwerken, wat nuttig is in gevallen waarin twee van de zes verzonden opdrachten betrekking hebben op vertakkingen. Interne tests bij ARM toonden een prestatieverbetering aan door gebruik te maken van deze tweede vertakking.
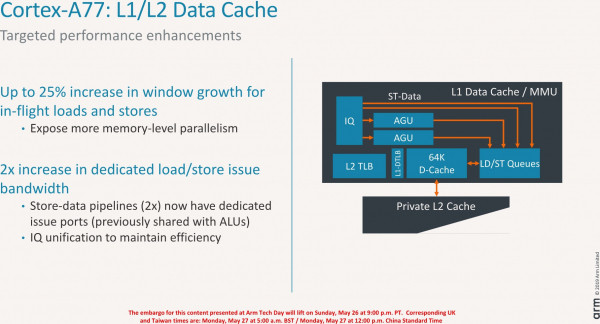
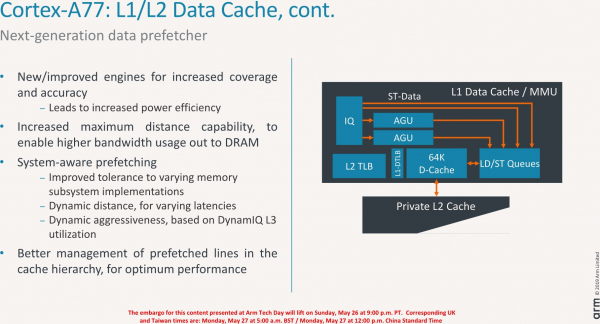
Onder andere veranderingen in de kern is de toevoeging van een tweede AES-encryptiepijplijn, een verhoging van de geheugendoorvoer, een geavanceerd mechanisme voor data-voorspelling van de volgende generatie dat de energie-efficiëntie verhoogt en tegelijkertijd de doorvoer van het DRAM-systeem vergroot, cache-optimalisatie, en meer.
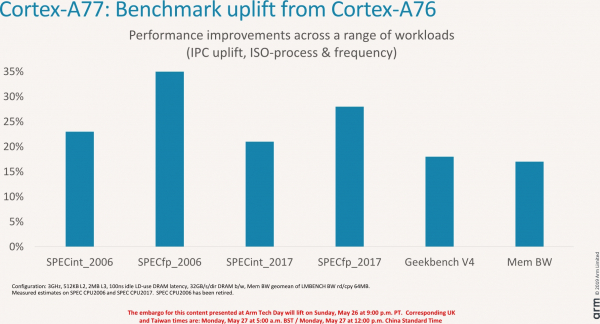
De grootste winst is te zien in de Cortex-A77 bij gehele getallen en drijvende puntberekeningen. Dit wordt bevestigd door interne tests van ARM in SPEC, die een prestatieverbetering van 20% en 35% lieten zien in de respectievelijke categorieën. Verbeteringen in geheugenbandbreedte liggen ergens tussen de 15-20%. Over het algemeen zorgen de optimalisaties en veranderingen in de A77 voor een gemiddelde prestatiegroei van 20% ten opzichte van de vorige generatie. Dankzij nieuwere technologienormen zoals 7 nm ULV kunnen we extra voordelen behalen in de uiteindelijke chips.
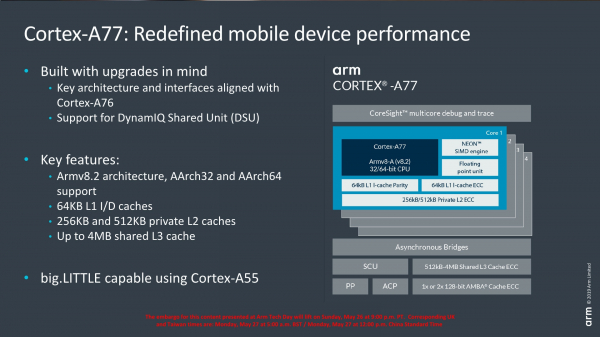
ARM heeft de Cortex-A77 ontwikkeld om samen te werken in een 4+4 big.LITTLE configuratie (4 krachtige kernen en 4 eenvoudige energiezuinige kernen). Echter, gezien de vergrote ruimte van de nieuwe architectuur, kunnen veel fabrikanten om kosten te besparen configuraties van 1+3+4 of 2+2+4 voorstellen, die al actief worden gebruikt, waarbij slechts één of twee kernen volwaardige, niet-afgezwakte A77 kernen zullen zijn.
Bron: 3dnews.ru
