

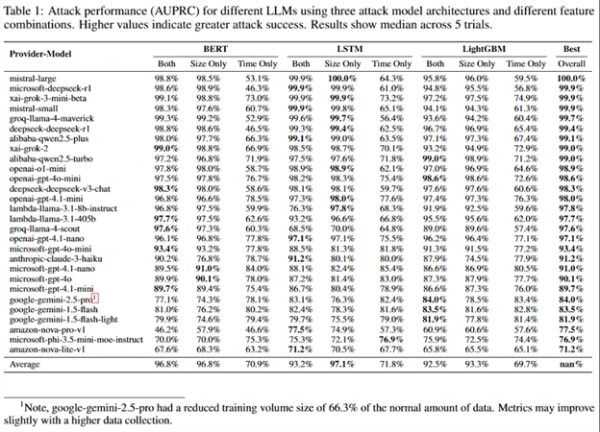
Beveiligingsonderzoekers van Microsoft hebben een aanvankelijke aanvalstechniek ontwikkeld genaamd Whisper Leak, waarmee ze op basis van passieve analyse van versleuteld verkeer dat via een TLS-verbinding wordt verzonden, de onderwerpen van verzoeken aan diensten op basis van grote taalmachines kunnen classificeren. Informatie over de grootte van netwerkpakketten en tijdsvertragingen tussen hun verzending bleek voldoende te zijn om de onderwerpen van verzoeken aan AI-chatbots te bepalen met een nauwkeurigheid van meer dan 98%. In de praktijk kan de voorgestelde methode worden toegepast om bepaalde onderwerpen van verzoeken in het transitverkeer van gebruikers te identificeren, bijvoorbeeld pogingen om informatie over illegale activiteiten te verkrijgen, zonder de inhoud te decoderen.
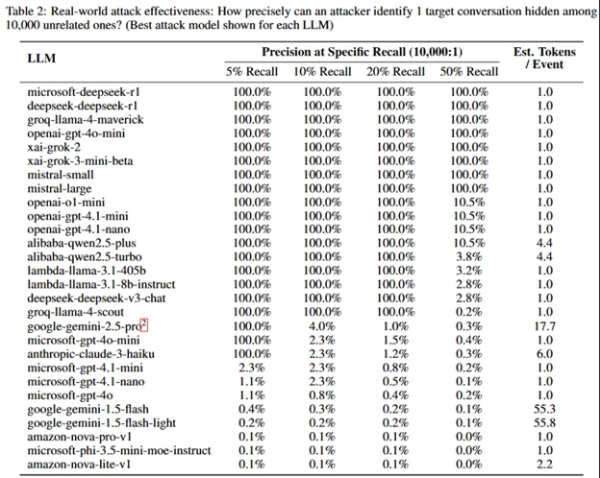
De toolset voor het extraheren van gegevens uit verkeersdumpbestanden, het trainen van modellen en het testen van de methode is gepubliceerd op GitHub. De mogelijkheid om de aanval uit te voeren is gedemonstreerd voor 28 populaire grote taalmachines van de grootste producenten. Bijvoorbeeld, de nauwkeurigheid van het identificeren van verzoeken over het onderwerp 'witwassen van geld' bereikte 100% voor veel AI-diensten, bij aanwezigheid van 1 verzoek dat betrekking had op het onderwerp en 10.000 verzoeken die niet met het gewenste onderwerp verband hielden.
De oorzaak van de informatielekken is dat de modellen de antwoorden op verzoeken stap voor stap genereren, één token tegelijk, waarbij bij elke stap het vorige token als context wordt gebruikt om het volgende meest waarschijnlijke woord of zin te bepalen. Dienovereenkomstig wordt er voor elk token een apart netwerkpakket verzonden en de vertraging tussen pakketten komt overeen met de vertraging tussen de determinatie van het volgende token door het model.
In TLS, als er geen gegevenscompressie wordt gebruikt, is de ruil van ciphertext gelijk aan de grootte van de ongecodeerde tekst plus een constante. Bij het creëren van een model dat de doelsets van tokens koppelt aan de grootte van pakketten en vertragingen tussen hun verzending, kan de aanwezigheid van de gevraagde onderwerpen in het verkeer vrij nauwkeurig worden bepaald. Tijdens de studie zijn drie varianten van dergelijke machine learning-modellen ontwikkeld, gebaseerd op de netwerkarchitecturen LightGBM, Bi-LSTM en BERT. Voor elk model zijn experimenten uitgevoerd om het gevraagde onderwerp vast te stellen door alleen de grootte van pakketten, alleen de vertragingen tussen pakketten of beide criteria te analyseren.
Om de effectiviteit van passieve analyse van zoekthema's te verminderen, wordt ontwikkelaars van AI-diensten aangeraden om willekeurige aanvullende invullingen toe te voegen, de overdracht van tokens te bufferen of nep-pakketten te substitueren.
Bron: opennet.ru
