

Tegenwoordig is de REST API de standaard voor de ontwikkeling van webapplicaties, waardoor ontwikkeling kan worden opgedeeld in onafhankelijke delen. Voor de gebruikersinterface worden momenteel verschillende populaire frameworks zoals Angular, React, Vue en andere gebruikt. Backend-ontwikkelaars kunnen kiezen uit een grote verscheidenheid aan talen en frameworks. Vandaag wil ik graag praten over een framework genaamd . Wij bij maken actief gebruik van dit framework voor interne projecten. Door gebruik te maken van nest en het pakket , zullen we een eenvoudige CRUD-applicatie creëren.
Waarom NestJS
De afgelopen tijd zijn er in de JavaScript-gemeenschap veel backend-frameworks verschenen. En hoewel ze qua functionaliteit vergelijkbare mogelijkheden als Nest bieden, wint het op één punt zeker — de architectuur. De volgende mogelijkheden van NestJS maken het mogelijk om industriële toepassingen te creëren en de ontwikkeling op te schalen naar grote teams:
- het gebruik van TypeScript als de belangrijkste programmeertaal. Hoewel NestJS ook JavaScript ondersteunt, kan een deel van de functionaliteit mogelijk niet werken, vooral als het om externe pakketten gaat;
- de aanwezigheid van een DI-container, wat het mogelijk maakt om losgekoppelde componenten te creëren;
- de functionaliteit van het framework zelf is opgedeeld in onafhankelijke, uitwisselbare componenten. Bijvoorbeeld, intern kan het framework zowel , als voor , voor database-functionaliteit biedt Nest standaard bindings aan , , ;
- NestJS is platformonafhankelijk en ondersteunt REST, GraphQL, Websockets, gRPC, enzovoort.
Het framework zelf is geïnspireerd op het frontend-framework Angular en heeft conceptueel veel gemeen met het.
Installatie van NestJS en projectopzet
Nest bevat het pakket /cli, который позволяет быстро развернуть базовый каркас приложения. Установим глобально данный пакет:
npm install --global @nest/cliNa de installatie genereren we de basisstructuur van onze applicatie met de naam nest-rest. Dit gebeurt met behulp van het commando nest new nest-rest.
nest new nest-rest
dmitrii@dmitrii-HP-ZBook-17-G3:~\/projects $ nest new nest-rest
  We zullen je app in enkele seconden scaffolden..

CREATE \/nest-rest\/.prettierrc (51 bytes)
CREATE \/nest-rest\/README.md (3370 bytes)
CREATE \/nest-rest\/nest-cli.json (84 bytes)
CREATE \/nest-rest\/nodemon-debug.json (163 bytes)
CREATE \/nest-rest\/nodemon.json (67 bytes)
CREATE \/nest-rest\/package.json (1805 bytes)
CREATE \/nest-rest\/tsconfig.build.json (97 bytes)
CREATE \/nest-rest\/tsconfig.json (325 bytes)
CREATE \/nest-rest\/tslint.json (426 bytes)
CREATE \/nest-rest\/src\/app.controller.spec.ts (617 bytes)
CREATE \/nest-rest\/src\/app.controller.ts (274 bytes)
CREATE \/nest-rest\/src\/app.module.ts (249 bytes)
CREATE \/nest-rest\/src\/app.service.ts (142 bytes)
CREATE \/nest-rest\/src\/main.ts (208 bytes)
CREATE \/nest-rest\/test\/app.e2e-spec.ts (561 bytes)
CREATE \/nest-rest\/test\/jest-e2e.json (183 bytes)

? Welke pakketbeheerder wilt u gebruiken? yarn
 Installatie is bezig...

  Project nest-rest succesvol aangemaakt
  Begin met de volgende opdrachten:

$ cd nest-rest
$ yarn run start

                          Bedankt voor het installeren van Nest
                 Overweeg alstublieft om te doneren aan onze open collective
                        om ons te helpen dit pakket te onderhouden.

                 Doneer: https:\/\/opencollective.com\/nest
Als pakketbeheerder kiezen we yarn.
Op dit moment kunt u de server starten met het commando npm start en door naar het adres te gaan kunt u de startpagina bekijken. Maar daar zijn we niet voor hier en we gaan verder.
We configureren het werken met de database
Als DBMS voor dit artikel heb ik PostgreSQL gekozen. Over smaken valt niet te twisten, in mijn mening is dit de meest volwassen DBMS met alle nodige functionaliteiten. Zoals eerder vermeld, biedt Nest integratie met verschillende pakketten voor databasewerk. Aangezien mijn keuze op PostgreSQL is gevallen, is het logisch om TypeORM als ORM te kiezen. Laten we de benodigde pakketten voor database-integratie installeren:
yarn add typeorm @nestjs\/typeorm pg
Laten we in volgorde bekijken waarvoor elk pakket nodig is:
- typeorm — pakket met de ORM zelf;
- @nestjs\/typeorm — TypeORM-pakket voor NestJS. Voegt modules toe om te importeren in de projectmodules, evenals een set helpers-decorators;
- pg — een driver voor het werken met PostgreSQL.
Oké, de pakketten zijn geïnstalleerd, nu moeten we de database zelf starten. Voor het implementeren van de database ga ik docker-compose.yml met de volgende inhoud gebruiken:
docker-compose.yml
version: '3.1'

services:
  db:
    image: postgres:11.2
    restart: always
    environment:
      POSTGRES_PASSWORD: example
    volumes:
      - ..\/db:\/var\/lib\/postgresql\/data
      - .\/postgresql.conf:\/etc\/postgresql\/postgresql.conf
    ports:
      - 5432:5432
  adminer:
    image: adminer
    restart: always
    ports:
      - 8080:8080
Zoals te zien is, configureert dit bestand de startup van 2 containers:
- db — dit is de container met de database zelf. In ons geval gebruiken we PostgreSQL versie 11.2;
- adminer — een databasebeheerder. Biedt een webinterface om de database te bekijken en te beheren.
Voor het werken met TCP-connecties heb ik de volgende configuratie toegevoegd.
postgresql.conf
# -----------------------------
# PostgreSQL configuration file
# -----------------------------
#
# This file consists of lines of the form:
#
# name = value
#
# (The "=" is optional.) Whitespace may be used. Comments are introduced with
# "#" anywhere on a line. The complete list of parameter names and allowed
# values can be found in the PostgreSQL documentation.
#
# The commented-out settings shown in this file represent the default values.
# Re-commenting a setting is NOT sufficient to revert it to the default value;
# you need to reload the server.
#
# This file is read on server startup and when the server receives a SIGHUP
# signal. If you edit the file on a running system, you have to SIGHUP the
# server for the changes to take effect, run "pg_ctl reload", or execute
# "SELECT pg_reload_conf()". Some parameters, which are marked below,
# require a server shutdown and restart to take effect.
#
# Any parameter can also be given as a command-line option to the server, e.g.,
# "postgres -c log_connections=on". Some parameters can be changed at run time
# with the "SET" SQL command.
#
# Memory units: kB = kilobytes Time units: ms = milliseconds
# MB = megabytes s = seconds
# GB = gigabytes min = minutes
# TB = terabytes h = hours
# d = days
#------------------------------------------------------------------------------
# FILE LOCATIONS
#------------------------------------------------------------------------------
# The default values of these variables are driven from the -D command-line
# option or PGDATA environment variable, represented here as ConfigDir.
#data_directory = 'ConfigDir' # use data in another directory
# (change requires restart)
#hba_file = 'ConfigDir/pg_hba.conf' # host-based authentication file
# (change requires restart)
#ident_file = 'ConfigDir/pg_ident.conf' # ident configuration file
# (change requires restart)
# If external_pid_file is not explicitly set, no extra PID file is written.
#external_pid_file = '' # write an extra PID file
# (change requires restart)
#------------------------------------------------------------------------------
# CONNECTIONS AND AUTHENTICATION
#------------------------------------------------------------------------------
# - Connection Settings -
listen_addresses = '*'
#listen_addresses = 'localhost' # what IP address(es) to listen on;
# comma-separated list of addresses;
# defaults to 'localhost'; use '*' for all
# (change requires restart)
#port = 5432 # (change requires restart)
#max_connections = 100 # (change requires restart)
#superuser_reserved_connections = 3 # (change requires restart)
#unix_socket_directories = '/tmp' # comma-separated list of directories
# (change requires restart)
#unix_socket_group = '' # (change requires restart)
#unix_socket_permissions = 0777 # begin with 0 to use octal notation
# (change requires restart)
#bonjour = off # advertise server via Bonjour
# (change requires restart)
#bonjour_name = '' # defaults to the computer name
# (change requires restart)
# - TCP Keepalives -
# see "man 7 tcp" for details
#tcp_keepalives_idle = 0 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
#tcp_keepalives_interval = 0 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
#tcp_keepalives_count = 0 # TCP_KEEPCNT;
# 0 selects the system default
# - Authentication -
#authentication_timeout = 1min # 1s-600s
#password_encryption = md5 # md5 or scram-sha-256
#db_user_namespace = off
# GSSAPI using Kerberos
#krb_server_keyfile = ''
#krb_caseins_users = off
# - SSL -
#ssl = off
#ssl_ca_file = ''
#ssl_cert_file = 'server.crt'
#ssl_crl_file = ''
#ssl_key_file = 'server.key'
#ssl_ciphers = 'HIGH:MEDIUM:+3DES:!aNULL' # allowed SSL ciphers
#ssl_prefer_server_ciphers = on
#ssl_ecdh_curve = 'prime256v1'
#ssl_min_protocol_version = 'TLSv1'
#ssl_max_protocol_version = ''
#ssl_dh_params_file = ''
#ssl_passphrase_command = ''
#ssl_passphrase_command_supports_reload = off
#------------------------------------------------------------------------------
# RESOURCE USAGE (except WAL)
#------------------------------------------------------------------------------
# - Memory -
#shared_buffers = 32MB # min 128kB
# (change requires restart)
#huge_pages = try # on, off, or try
# (change requires restart)
#temp_buffers = 8MB # min 800kB
#max_prepared_transactions = 0 # zero disables the feature
# (change requires restart)
# Caution: it is not advisable to set max_prepared_transactions nonzero unless
# you actively intend to use prepared transactions.
#work_mem = 4MB # min 64kB
#maintenance_work_mem = 64MB # min 1MB
#autovacuum_work_mem = -1 # min 1MB, or -1 to use maintenance_work_mem
#max_stack_depth = 2MB # min 100kB
#shared_memory_type = mmap # the default is the first option
# supported by the operating system:
# mmap
# sysv
# windows
# (change requires restart)
#dynamic_shared_memory_type = posix # the default is the first option
# supported by the operating system:
# posix
# sysv
# windows
# mmap
# (change requires restart)
# - Disk -
#temp_file_limit = -1 # limits per-process temp file space
# in kB, or -1 for no limit
# - Kernel Resources -
#max_files_per_process = 1000 # min 25
# (change requires restart)
# - Cost-Based Vacuum Delay -
#vacuum_cost_delay = 0 # 0-100 milliseconds (0 disables)
#vacuum_cost_page_hit = 1 # 0-10000 credits
#vacuum_cost_page_miss = 10 # 0-10000 credits
#vacuum_cost_page_dirty = 20 # 0-10000 credits
#vacuum_cost_limit = 200 # 1-10000 credits
# - Background Writer -
#bgwriter_delay = 200ms # 10-10000ms between rounds
#bgwriter_lru_maxpages = 100 # max buffers written/round, 0 disables
#bgwriter_lru_multiplier = 2.0 # 0-10.0 multiplier on buffers scanned/round
#bgwriter_flush_after = 0 # measured in pages, 0 disables
# - Asynchronous Behavior -
#effective_io_concurrency = 1 # 1-1000; 0 disables prefetching
#max_worker_processes = 8 # (change requires restart)
#max_parallel_maintenance_workers = 2 # taken from max_parallel_workers
#max_parallel_workers_per_gather = 2 # taken from max_parallel_workers
#parallel_leader_participation = on
#max_parallel_workers = 8 # maximum number of max_worker_processes that
# can be used in parallel operations
#old_snapshot_threshold = -1 # 1min-60d; -1 disables; 0 is immediate
# (change requires restart)
#backend_flush_after = 0 # measured in pages, 0 disables
#------------------------------------------------------------------------------
# WRITE-AHEAD LOG
#------------------------------------------------------------------------------
# - Settings -
#wal_level = replica # minimal, replica, or logical
# (change requires restart)
#fsync = on # flush data to disk for crash safety
# (turning this off can cause
# unrecoverable data corruption)
#synchronous_commit = on # synchronization level;
# off, local, remote_write, remote_apply, or on
#wal_sync_method = fsync # the default is the first option
# supported by the operating system:
# open_datasync
# fdatasync (default on Linux)
# fsync
# fsync_writethrough
# open_sync
#full_page_writes = on # recover from partial page writes
#wal_compression = off # enable compression of full-page writes
#wal_log_hints = off # also do full page writes of non-critical updates
# (change requires restart)
#wal_buffers = -1 # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
#wal_writer_delay = 200ms # 1-10000 milliseconds
#wal_writer_flush_after = 1MB # measured in pages, 0 disables
#commit_delay = 0 # range 0-100000, in microseconds
#commit_siblings = 5 # range 1-1000
# - Checkpoints -
#checkpoint_timeout = 5min # range 30s-1d
#max_wal_size = 1GB
#min_wal_size = 80MB
#checkpoint_completion_target = 0.5 # checkpoint target duration, 0.0 - 1.0
#checkpoint_flush_after = 0 # measured in pages, 0 disables
#checkpoint_warning = 30s # 0 disables
# - Archiving -
#archive_mode = off # enables archiving; off, on, or always
# (change requires restart)
#archive_command = '' # command to use to archive a logfile segment
# placeholders: %p = path of file to archive
# %f = file name only
# e.g. 'test ! -f /mnt/server/archivedir/%f && cp %p /mnt/server/archivedir/%f'
#archive_timeout = 0 # force a logfile segment switch after this
# number of seconds; 0 disables
# - Archive Recovery -
# These are only used in recovery mode.
#restore_command = '' # command to use to restore an archived logfile segment
# placeholders: %p = path of file to restore
# %f = file name only
# e.g. 'cp /mnt/server/archivedir/%f %p'
# (change requires restart)
#archive_cleanup_command = '' # command to execute at every restartpoint
#recovery_end_command = '' # command to execute at completion of recovery
# - Recovery Target -
# Set these only when performing a targeted recovery.
#recovery_target = '' # 'immediate' to end recovery as soon as a
# consistent state is reached
# (change requires restart)
#recovery_target_name = '' # the named restore point to which recovery will proceed
# (change requires restart)
#recovery_target_time = '' # the time stamp up to which recovery will proceed
# (change requires restart)
#recovery_target_xid = '' # the transaction ID up to which recovery will proceed
# (change requires restart)
#recovery_target_lsn = '' # the WAL LSN up to which recovery will proceed
# (change requires restart)
#recovery_target_inclusive = on # Specifies whether to stop:
# just after the specified recovery target (on)
# just before the recovery target (off)
# (change requires restart)
#recovery_target_timeline = 'latest' # 'current', 'latest', or timeline ID
# (change requires restart)
#recovery_target_action = 'pause' # 'pause', 'promote', 'shutdown'
# (change requires restart)
#------------------------------------------------------------------------------
# REPLICATION
#------------------------------------------------------------------------------
# - Sending Servers -
# Set these on the master and on any standby that will send replication data.
#max_wal_senders = 10 # max number of walsender processes
# (change requires restart)
#wal_keep_segments = 0 # in logfile segments; 0 disables
#wal_sender_timeout = 60s # in milliseconds; 0 disables
#max_replication_slots = 10 # max number of replication slots
# (change requires restart)
#track_commit_timestamp = off # collect timestamp of transaction commit
# (change requires restart)
# - Master Server -
# These settings are ignored on a standby server.
#synchronous_standby_names = '' # standby servers that provide sync rep
# method to choose sync standbys, number of sync standbys,
# and comma-separated list of application_name
# from standby(s); '*' = all
#vacuum_defer_cleanup_age = 0 # number of xacts by which cleanup is delayed
# - Standby Servers -
# These settings are ignored on a master server.
#primary_conninfo = '' # connection string to sending server
# (change requires restart)
#primary_slot_name = '' # replication slot on sending server
# (change requires restart)
#promote_trigger_file = '' # file name whose presence ends recovery
#hot_standby = on # "off" disallows queries during recovery
# (change requires restart)
#max_standby_archive_delay = 30s # max delay before canceling queries
# when reading WAL from archive;
# -1 allows indefinite delay
#max_standby_streaming_delay = 30s # max delay before canceling queries
# when reading streaming WAL;
# -1 allows indefinite delay
#wal_receiver_status_interval = 10s # send replies at least this often
# 0 disables
#hot_standby_feedback = off # send info from standby to prevent
# query conflicts
#wal_receiver_timeout = 60s # time that receiver waits for
# communication from master
# in milliseconds; 0 disables
#wal_retrieve_retry_interval = 5s # time to wait before retrying to
# retrieve WAL after a failed attempt
#recovery_min_apply_delay = 0 # minimum delay for applying changes during recovery
# - Subscribers -
# These settings are ignored on a publisher.
#max_logical_replication_workers = 4 # taken from max_worker_processes
# (change requires restart)
#max_sync_workers_per_subscription = 2 # taken from max_logical_replication_workers
#------------------------------------------------------------------------------
# QUERY TUNING
#------------------------------------------------------------------------------
# - Planner Method Configuration -
#enable_bitmapscan = on
#enable_hashagg = on
#enable_hashjoin = on
#enable_indexscan = on
#enable_indexonlyscan = on
#enable_material = on
#enable_mergejoin = on
#enable_nestloop = on
#enable_parallel_append = on
#enable_seqscan = on
#enable_sort = on
#enable_tidscan = on
#enable_partitionwise_join = off
#enable_partitionwise_aggregate = off
#enable_parallel_hash = on
#enable_partition_pruning = on
# - Planner Cost Constants -
#seq_page_cost = 1.0 # measured on an arbitrary scale
#random_page_cost = 4.0 # same scale as above
#cpu_tuple_cost = 0.01 # same scale as above
#cpu_index_tuple_cost = 0.005 # same scale as above
#cpu_operator_cost = 0.0025 # same scale as above
#parallel_tuple_cost = 0.1 # same scale as above
#parallel_setup_cost = 1000.0 # same scale as above
#jit_above_cost = 100000 # perform JIT compilation if available
# and query more expensive than this;
# -1 disables
#jit_inline_above_cost = 500000 # inline small functions if query is
# more expensive than this; -1 disables
#jit_optimize_above_cost = 500000 # use expensive JIT optimizations if
# query is more expensive than this;
# -1 disables
#min_parallel_table_scan_size = 8MB
#min_parallel_index_scan_size = 512kB
#effective_cache_size = 4GB
# - Genetic Query Optimizer -
#geqo = on
#geqo_threshold = 12
#geqo_effort = 5 # range 1-10
#geqo_pool_size = 0 # selects default based on effort
#geqo_generations = 0 # selects default based on effort
#geqo_selection_bias = 2.0 # range 1.5-2.0
#geqo_seed = 0.0 # range 0.0-1.0
# - Other Planner Options -
#default_statistics_target = 100 # range 1-10000
#constraint_exclusion = partition # on, off, or partition
#cursor_tuple_fraction = 0.1 # range 0.0-1.0
#from_collapse_limit = 8
#join_collapse_limit = 8 # 1 disables collapsing of explicit
# JOIN clauses
#force_parallel_mode = off
#jit = on # allow JIT compilation
#plan_cache_mode = auto # auto, force_generic_plan or
# force_custom_plan
#------------------------------------------------------------------------------
# REPORTING AND LOGGING
#------------------------------------------------------------------------------
# - Where to Log -
#log_destination = 'stderr' # Valid values are combinations of
# stderr, csvlog, syslog, and eventlog,
# depending on platform. csvlog
# requires logging_collector to be on.
# This is used when logging to stderr:
#logging_collector = off # Enable capturing of stderr and csvlog
# into log files. Required to be on for
# csvlogs.
# (change requires restart)
# These are only used if logging_collector is on:
#log_directory = 'log' # directory where log files are written,
# can be absolute or relative to PGDATA
#log_filename = 'postgresql-%Y-%m-%d_%H%M%S.log' # log file name pattern,
# can include strftime() escapes
#log_file_mode = 0600 # creation mode for log files,
# begin with 0 to use octal notation
#log_truncate_on_rotation = off # If on, an existing log file with the
# same name as the new log file will be
# truncated rather than appended to.
# But such truncation only occurs on
# time-driven rotation, not on restarts
# or size-driven rotation. Default is
# off, meaning append to existing files
# in all cases.
#log_rotation_age = 1d # Automatic rotation of logfiles will
# happen after that time. 0 disables.
#log_rotation_size = 10MB # Automatic rotation of logfiles will
# happen after that much log output.
# 0 disables.
# These are relevant when logging to syslog:
#syslog_facility = 'LOCAL0'
#syslog_ident = 'postgres'
#syslog_sequence_numbers = on
#syslog_split_messages = on
# This is only relevant when logging to eventlog (win32):
# (change requires restart)
#event_source = 'PostgreSQL'
# - When to Log -
#log_min_messages = warning # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic
#log_min_error_statement = error # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic (effectively off)
#log_min_duration_statement = -1 # logs statements and their durations
# according to log_statement_sample_rate. -1 is disabled,
# 0 logs all statement, > 0 logs only statements running at
# least this number of milliseconds.
#log_statement_sample_rate = 1 # Fraction of logged statements over
# log_min_duration_statement. 1.0 logs all statements,
# 0 never logs.
# - What to Log -
#debug_print_parse = off
#debug_print_rewritten = off
#debug_print_plan = off
#debug_pretty_print = on
#log_checkpoints = off
#log_connections = off
#log_disconnections = off
#log_duration = off
#log_error_verbosity = default # terse, default, or verbose messages
#log_hostname = off
#log_line_prefix = '%m [%p] ' # special values:
# %a = application name
# %u = user name
# %d = database name
# %r = remote host and port
# %h = remote host
# %p = process ID
# %t = timestamp without milliseconds
# %m = timestamp with milliseconds
# %n = timestamp with milliseconds (as a Unix epoch)
# %i = command tag
# %e = SQL state
# %c = session ID
# %l = session line number
# %s = session start timestamp
# %v = virtual transaction ID
# %x = transaction ID (0 if none)
# %q = stop here in non-session
# processes
# %% = '%'
# e.g. '<%u%%%d> '
#log_lock_waits = off # log lock waits >= deadlock_timeout
#log_statement = 'none' # none, ddl, mod, all
#log_replication_commands = off
#log_temp_files = -1 # log temporary files equal or larger
# than the specified size in kilobytes;
# -1 disables, 0 logs all temp files
#log_timezone = 'GMT'
#------------------------------------------------------------------------------
# PROCESS TITLE
#------------------------------------------------------------------------------
#cluster_name = '' # added to process titles if nonempty
# (change requires restart)
#update_process_title = on
#------------------------------------------------------------------------------
# STATISTICS
#------------------------------------------------------------------------------
# - Query and Index Statistics Collector -
#track_activities = on
#track_counts = on
#track_io_timing = off
#track_functions = none # none, pl, all
#track_activity_query_size = 1024 # (change requires restart)
#stats_temp_directory = 'pg_stat_tmp'
# - Monitoring -
#log_parser_stats = off
#log_planner_stats = off
#log_executor_stats = off
#log_statement_stats = off
#------------------------------------------------------------------------------
# AUTOVACUUM
#------------------------------------------------------------------------------
#autovacuum = on # Enable autovacuum subprocess? 'on'
# requires track_counts to also be on.
#log_autovacuum_min_duration = -1 # -1 disables, 0 logs all actions and
# their durations, > 0 logs only
# actions running at least this number
# of milliseconds.
#autovacuum_max_workers = 3 # max number of autovacuum subprocesses
# (change requires restart)
#autovacuum_naptime = 1min # time between autovacuum runs
#autovacuum_vacuum_threshold = 50 # min number of row updates before
# vacuum
#autovacuum_analyze_threshold = 50 # min number of row updates before
# analyze
#autovacuum_vacuum_scale_factor = 0.2 # fraction of table size before vacuum
#autovacuum_analyze_scale_factor = 0.1 # fraction of table size before analyze
#autovacuum_freeze_max_age = 200000000 # maximum XID age before forced vacuum
# (change requires restart)
#autovacuum_multixact_freeze_max_age = 400000000 # maximum multixact age
# before forced vacuum
# (change requires restart)
#autovacuum_vacuum_cost_delay = 2ms # default vacuum cost delay for
# autovacuum, in milliseconds;
# -1 means use vacuum_cost_delay
#autovacuum_vacuum_cost_limit = -1 # default vacuum cost limit for
# autovacuum, -1 means use
# vacuum_cost_limit
#------------------------------------------------------------------------------
# CLIENT CONNECTION DEFAULTS
#------------------------------------------------------------------------------
# - Statement Behavior -
#client_min_messages = notice # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# log
# notice
# warning
# error
#search_path = '"$user", public' # schema names
#row_security = on
#default_tablespace = '' # a tablespace name, '' uses the default
#temp_tablespaces = '' # a list of tablespace names, '' uses
# only default tablespace
#check_function_bodies = on
#default_transaction_isolation = 'read committed'
#default_transaction_read_only = off
#default_transaction_deferrable = off
#session_replication_role = 'origin'
#statement_timeout = 0 # in milliseconds, 0 is disabled
#lock_timeout = 0 # in milliseconds, 0 is disabled
#idle_in_transaction_session_timeout = 0 # in milliseconds, 0 is disabled
#vacuum_freeze_min_age = 50000000
#vacuum_freeze_table_age = 150000000
#vacuum_multixact_freeze_min_age = 5000000
#vacuum_multixact_freeze_table_age = 150000000
#vacuum_cleanup_index_scale_factor = 0.1 # fraction of total number of tuples
# before index cleanup, 0 always performs
# index cleanup
#bytea_output = 'hex' # hex, escape
#xmlbinary = 'base64'
#xmloption = 'content'
#gin_fuzzy_search_limit = 0
#gin_pending_list_limit = 4MB
# - Locale and Formatting -
#datestyle = 'iso, mdy'
#intervalstyle = 'postgres'
#timezone = 'GMT'
#timezone_abbreviations = 'Default' # Select the set of available time zone
# abbreviations. Currently, there are
# Default
# Australia (historical usage)
# India
# You can create your own file in
# share/timezonesets/.
#extra_float_digits = 1 # min -15, max 3; any value >0 actually
# selects precise output mode
#client_encoding = sql_ascii # actually, defaults to database
# encoding
# These settings are initialized by initdb, but they can be changed.
#lc_messages = 'C' # locale for system error message
# strings
#lc_monetary = 'C' # locale for monetary formatting
#lc_numeric = 'C' # locale for number formatting
#lc_time = 'C' # locale for time formatting
# default configuration for text search
#default_text_search_config = 'pg_catalog.simple'
# - Shared Library Preloading -
#shared_preload_libraries = '' # (change requires restart)
#local_preload_libraries = ''
#session_preload_libraries = ''
#jit_provider = 'llvmjit' # JIT library to use
# - Other Defaults -
#dynamic_library_path = '$libdir'
#------------------------------------------------------------------------------
# LOCK MANAGEMENT
#------------------------------------------------------------------------------
#deadlock_timeout = 1s
#max_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_relation = -2 # negative values mean
# (max_pred_locks_per_transaction
# / -max_pred_locks_per_relation) - 1
#max_pred_locks_per_page = 2 # min 0
#------------------------------------------------------------------------------
# VERSION AND PLATFORM COMPATIBILITY
#------------------------------------------------------------------------------
# - Previous PostgreSQL Versions -
#array_nulls = on
#backslash_quote = safe_encoding # on, off, or safe_encoding
#escape_string_warning = on
#lo_compat_privileges = off
#operator_precedence_warning = off
#quote_all_identifiers = off
#standard_conforming_strings = on
#synchronize_seqscans = on
# - Other Platforms and Clients -
#transform_null_equals = off
#------------------------------------------------------------------------------
# ERROR HANDLING
#------------------------------------------------------------------------------
#exit_on_error = off # terminate session on any error?
#restart_after_crash = on # reinitialize after backend crash?
#data_sync_retry = off # retry or panic on failure to fsync
# data?
# (change requires restart)
#------------------------------------------------------------------------------
# CONFIG FILE INCLUDES
#------------------------------------------------------------------------------
# These options allow settings to be loaded from files other than the
# default postgresql.conf.
#include_dir = 'conf.d' # include files ending in '.conf' from
# directory 'conf.d'
#include_if_exists = 'exists.conf' # include file only if it exists
#include = 'special.conf' # include file
#------------------------------------------------------------------------------
# CUSTOMIZED OPTIONS
#------------------------------------------------------------------------------
# Add settings for extensions hereDat is alles, je kunt de containers starten met het commando docker-compose up -d. Of in een aparte console met het commando docker-compose up.
Dus, de pakketten zijn geïnstalleerd, de database is gestart, nu moeten we ze aan elkaar koppelen. Hiervoor moet je een bestand genaamd ormconfig.js met de volgende inhoud in de hoofdmap van het project toevoegen:
ormconfig.js
const process = require('process');

const username = process.env.POSTGRES_USER || "postgres";
const password = process.env.POSTGRES_PASSWORD || "example";

module.exports = {
  "type": "postgres",
  "host": "localhost",
  "port": 5432,
  username,
  password,
  "database": "postgres",
  "synchronize": true,
  "dropSchema": false,
  "logging": true,
  "entities": [__dirname + "\/src\/**/*.entity.ts", __dirname + "\/dist\/**/*.entity.js"],
  "migrations": ["migrations\/**\/*.ts"],
  "subscribers": ["subscriber\/**\/*.ts", "dist\/subscriber\/**\/.js"],
  "cli": {
    "entitiesDir": "src",
    "migrationsDir": "migrations",
    "subscribersDir": "subscriber"
  }
}
Deze configuratie zal gebruikt worden voor de typeorm CLI.
Laten we dieper ingaan op deze configuratie. In regels 3 en 4 verkrijgen we de gebruikersnaam en het wachtwoord uit de omgevingsvariabelen. Dit is handig wanneer je meerdere omgevingen hebt (dev, stage, prod, etc). Standaard is de gebruikersnaam postgres, het wachtwoord is example. De rest van de configuratie is triviaal, dus we focussen alleen op de meest interessante parameters:
- synchronize — geeft aan of het databaseschema automatisch moet worden aangemaakt bij het opstarten van de applicatie. Wees voorzichtig met deze optie en gebruik deze niet in productie, anders verlies je mogelijk gegevens. Deze optie is handig tijdens de ontwikkeling en debugging van de applicatie. Als alternatief voor deze optie kun je het commando
schema:syncuit de TypeORM CLI gebruiken. - dropSchema — de schema elke keer resetten wanneer er een verbinding tot stand wordt gebracht. Deze optie moet, net als de vorige, alleen worden gebruikt tijdens de ontwikkeling en debugging van de applicatie.
- entities — welke paden moeten worden doorzocht voor de beschrijving van modellen. Let op dat het zoeken op basis van een patroon wordt ondersteund.
- cli.entitiesDir — de directory waar modellen die zijn gemaakt vanuit de TypeORM CLI standaard moeten worden opgeslagen.
Om gebruik te kunnen maken van alle mogelijkheden van TypeORM in onze Nest-applicatie, moet je de module importeren TypeOrmModule in AppModule. Dat wil zeggen, jouw AppModule ziet er als volgt uit:
app.module.ts
import { Module } from '@nestjs/common';
import { AppController } from './app.controller';
import { AppService } from './app.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import * as process from "process";

const username = process.env.POSTGRES_USER || 'postgres';
const password = process.env.POSTGRES_PASSWORD || 'example';

@Module({
  imports: [
    TypeOrmModule.forRoot({
      type: 'postgres',
      host: 'localhost',
      port: 5432,
      username,
      password,
      database: 'postgres',
      entities: [__dirname + '/**/*.entity{.ts,.js}'],
      synchronize: true,
    }),
  ],
  controllers: [AppController],
  providers: [AppService],
})
export class AppModule {}
Zoals u misschien al gemerkt heeft, wordt in de methode forRoot dezelfde configuratie voor het werken met de database doorgegeven als in het bestand ormconfig.ts
Er resteert nog een laatste stap — het toevoegen van enkele taken voor het werken met TypeORM in package.json. Het punt is dat de CLI is geschreven in JavaScript en draait in een nodejs-omgeving. Echter, al onze modellen en migraties worden geschreven in TypeScript. Daarom is het nodig om onze migraties en modellen te transpilen voordat we de CLI gebruiken. Hiervoor hebben we het pakket ts-node nodig:
yarn add -D ts-node
Daarna voegen we de benodigde commando's toe aan package.json:
"typeorm": "ts-node -r tsconfig-paths/register ./node_modules/typeorm/cli.js",
"migration:generate": "yarn run typeorm migration:generate -n",
"migration:create": "yarn run typeorm migration:create -n",
"migration:run": "yarn run typeorm migration:run"
Het eerste commando, typeorm, voegt een wrapper in de vorm van ts-node toe voor het uitvoeren van de TypeORM CLI. De andere commando's zijn handige verkortingen die je als ontwikkelaar vrijwel elke dag zult gebruiken:
migration:generate — generatie van een migratie op basis van wijzigingen in je modellen.
migration:create — aanmaken van een lege migratie.
migration:run — uitvoeren van migraties.
Nou, nu is alles gezegd, we hebben de benodigde pakketten toegevoegd, de applicatie geconfigureerd voor databasewerk zowel via de cli als vanuit de applicatie zelf, en de DBMS gestart. Het is tijd om logica aan onze applicatie toe te voegen.
Pakketten installeren voor het maken van CRUD
Met alleen Nest kun je een API maken die entiteiten kan creëren, lezen, bijwerken en verwijderen. Deze oplossing zal zo flexibel mogelijk zijn, maar voor sommige gevallen kan dit overbodig zijn. Bijvoorbeeld, als je snel een prototype wilt maken, kun je vaak flexibiliteit opofferen voor snelheid van ontwikkeling. Veel frameworks bieden functionaliteiten voor het genereren van CRUD op basis van een modelbeschrijving van een bepaalde entiteit. En Nest is geen uitzondering! Deze functionaliteit wordt aangeboden door het pakket . De mogelijkheden zijn zeer interessant:
- gemakkelijke installatie en configuratie;
- onafhankelijkheid van de database;
- krachtige querytaal met mogelijkheden voor filtering, paginering, sortering, laden van relaties en geneste entiteiten, caching, enzovoort;
- pakket voor het opstellen van verzoeken aan de front-end;
- gemakkelijke herschrijving van controller methoden;
- kleine configuratie;
- ondersteuning voor swagger-documentatie.
Functionaliteit is opgedeeld in verschillende pakketten:
- — basispakket dat een decorator biedt () voor het genereren van routes, configuratie en validatie;
- — pakket dat een builder/parser voor verzoeken biedt voor gebruik aan de front-end;
- — pakket voor integratie met TypeORM, dat de basisdienst TypeOrmCrudService biedt met CRUD-methoden voor het werken met entiteiten in de database.
In deze handleiding hebben we de pakketten jsx/crud en jsx/crud-typeorm nodig. Laten we ze eerst installeren
yarn add @nestjsx/crud class-transformer class-validatorPakketten en zijn in deze applicatie vereist voor de declaratieve beschrijving van transformaties van modelinstellingen en de validatie van binnenkomende verzoeken. Deze pakketten zijn van dezelfde auteur, dus de interfaces zijn vergelijkbaar.
Directe implementatie van CRUD
Laten we een lijst met gebruikers als voorbeeldmodel nemen. Gebruikers zullen de volgende velden hebben: id, username, displayName, e-mail. id — auto-increment veld, e-mail en username — unieke velden. Alles is simpel! We hoeven alleen nog maar onze opzet om te zetten in een Nest-applicatie.
Om te beginnen moeten we een module maken gebruikers, die verantwoordelijk zal zijn voor het werken met gebruikers. We maken gebruik van de cli van NestJS, en in de hoofdmap van ons project voeren we de opdracht uit nest g module users.
nest g module users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g module users
CREATE /src/users/users.module.ts (82 bytes)
UPDATE /src/app.module.ts (312 bytes)
In deze module voegen we een map entities toe, waar onze modellen van deze module zich zullen bevinden. We voegen hier met name het bestand user.entity.ts toe met de beschrijving van de gebruikersmodellen:
user.entity.ts
import { Column, Entity, PrimaryGeneratedColumn } from 'typeorm';

@Entity()
export class User {
  @PrimaryGeneratedColumn()
  id: string;

  @Column({unique: true})
  email: string;

  @Column({unique: true})
  username: string;

  @Column({nullable: true})
  displayName: string;
}
Om ervoor te zorgen dat ons applicatie deze model "ziet", moeten we in de module UsersModule het bestand importeren TypeOrmModule met de volgende inhoud:
users.module.ts
import { Module } from '@nestjs/common';
import { UsersController } from './controllers/users/users.controller';
import { UsersService } from './services/users/users.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import { User } from './entities/user.entity';

@Module({
  controllers: [UsersController],
  providers: [UsersService],
  imports: [
    TypeOrmModule.forFeature([User])
  ]
})
export class UsersModule {}
Dus hier importeren we TypeOrmModule, waarbij de lijst met modellen als parameter van de methode forFeature wordt opgegeven, die tot deze module behoren.
Vervolgens moeten we de bijbehorende entiteit in de database aanmaken. Hiervoor gebruiken we de migratiemechanisme. Om een migratie te creëren op basis van de wijzigingen in de modellen, moet de volgende opdracht worden uitgevoerd npm run migration:generate -- CreateUserTable:
Spoiler-titel
$ npm run migration:generate -- CreateUserTable
Migratie /home/dmitrii/projects/nest-rest/migrations/1563346135367-CreateUserTable.ts is succesvol gegenereerd.
Klaar in 1.96s.
We hoefden de migratie niet handmatig te schrijven, alles gebeurde op magische wijze. Is dat niet wonderbaarlijk! Maar dat is nog niet alles. Laten we eens kijken naar het gegenereerde migratiebestand:
1563346135367-CreateUserTable.ts
import {MigrationInterface, QueryRunner} from "typeorm";

export class CreateUserTable1563346816726 implements MigrationInterface {

    public async up(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`CREATE TABLE "user" ("id" SERIAL NOT NULL, "email" character varying NOT NULL, "username" character varying NOT NULL, "displayName" character varying, CONSTRAINT "UQ_e12875dfb3b1d92d7d7c5377e22" UNIQUE ("email"), CONSTRAINT "UQ_78a916df40e02a9deb1c4b75edb" UNIQUE ("username"), CONSTRAINT "PK_cace4a159ff9f2512dd42373760" PRIMARY KEY ("id"))`);
    }

    public async down(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`DROP TABLE "user"`);
    }

}
Zoals je kunt zien, is er niet alleen een methode voor het uitvoeren van de migratie automatisch gegenereerd, maar ook een methode voor het terugdraaien ervan. Fantastisch!
We moeten nu deze migratie toepassen. Dit doen we met de volgende opdracht:
npm run migration:run.Alles, nu zijn de schemawijzigingen naar de database overgebracht.
Laten we nu een service maken die verantwoordelijk is voor het beheer van gebruikers en deze afleiden van TypeOrmCrudService. In de parameter van de bovenliggende constructor moet de repository van de relevante entiteit worden doorgegeven, in ons geval User repository.
users.service.ts
import { Injectable } from '@nestjs/common';
import { TypeOrmCrudService } from '@nestjsx/crud-typeorm';
import { User } from '../..//entities/user.entity';
import { InjectRepository } from '@nestjs/typeorm';
import { Repository } from 'typeorm';

@Injectable()
export class UsersService extends TypeOrmCrudService{
  constructor(@InjectRepository(User) usersRepository: Repository){
    super(usersRepository);
  }
}
Deze service hebben we nodig in de controller gebruikers. Voer de volgende opdracht in de console in om een controller te maken nest g controller users/controllers/users
nest g controller users/controllers/users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g controller users/controllers/users
CREËER /src/users/controllers/users/users.controller.spec.ts (486 bytes)
CREËER /src/users/controllers/users/users.controller.ts (99 bytes)
UPDATE /src/users/users.module.ts (188 bytes)
Open deze controller en bewerk deze om wat magie toe te voegen jsx/crud. Aan de klasse UsersController voegen we een decorateur van de volgende vorm toe:
@Crud({
  model: {
    type: User
  }
}) — dit is een decorator die de nodige methoden aan de controller toevoegt voor het werken met het model. Het type model wordt aangegeven in het veld model.type van de decoratorconfiguratie.
De tweede stap is om de interface CrudController<User>te implementeren. Het volledige controllercode ziet er als volgt uit:
import { Controller } from '@nestjs/common';
import { Crud, CrudController } from '@nestjsx/crud';
import { User } from '..\/..\/entities\/user.entity';
import { UsersService } from '..\/..\/services\/users\/users.service';

@Crud({
  model: {
    type: User
  }
})
@Controller('users')
export class UsersController implements CrudController<User>{
  constructor(public service: UsersService){}
}
En dat is alles! Nu ondersteunt de controller de complete set bewerkingen voor het model! Gelooft u het niet? Laten we onze applicatie in actie proberen!
Het maken van een verzoekenscript in TestMace
Voor het testen van onze service zullen we een IDE voor API-werk gebruiken . Waarom TestMace? In vergelijking met vergelijkbare producten heeft het de volgende voordelen:
- krachtige verwerking van variabelen. Momenteel zijn er verschillende soorten variabelen, elk met een specifieke rol: ingebouwde variabelen, dynamische variabelen, omgevingsvariabelen. Elke variabele behoort toe aan een bepaalde node en ondersteunt een erfmechanisme;
- eenvoudig maken van scripts zonder programmeren. Hierover later meer;
- een mensenleesbaar formaat dat het mogelijk maakt om projecten in versiebeheersystemen op te slaan;
- autocompletion, syntaxisverlichting, verlichting van variabele waarden;
- ondersteuning voor API-beschrijving met de mogelijkheid om vanuit Swagger te importeren.
Laten we onze server starten met het commando npm start en proberen de gebruikerslijst op te vragen. De gebruikerslijst kan, gezien onze controllerconfiguratie, worden verkregen via de url localhost:3000\/users. Laten we een verzoek naar deze url doen.
Na het starten van TestMace kunt u een interface zoals deze zien:
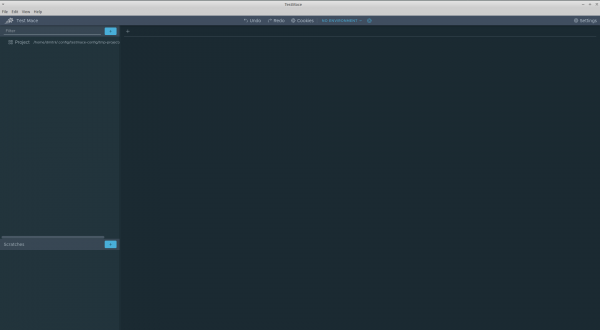
Bovenaan links bevindt zich de projectboom met de wortelnode . Laten we proberen ons eerste verzoek te maken voor het verkrijgen van de gebruikerslijst. Hiervoor maken we een node. Dit gebeurt in het contextmenu van de Project node Node toevoegen -> RequestStep.
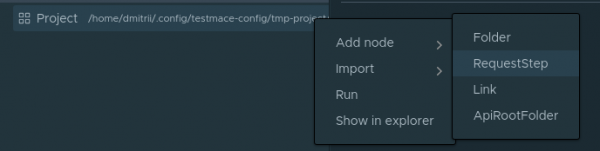
Plak de url localhost:3000\/users in het veld en voer het verzoek uit. We ontvangen een 200-code met een lege array in de response-body. Snapbaar, we hebben nog niemand toegevoegd.
Laten we een scenario creëren dat de volgende stappen zal omvatten:
- het aanmaken van een gebruiker;
- verzoek op id van de net aangemaakte gebruiker;
- verwijdering op basis van gebruikers-id, aangemaakt in stap 1.
Laten we beginnen. Voor de eenvoud maken we een knooppunt van het type . Dit is in feite gewoon een map waarin we het hele script opslaan. Om een Map-knooppunt te maken, moet je in het contextmenu van het Project-knooppunt kiezen voor Node toevoegen -> Map. We noemen het knooppunt check-create. Binnen het knooppunt check-create maken we onze eerste aanvraag voor het aanmaken van een gebruiker. We noemen het nieuw aangemaakte knooppunt create-user. Dat wil zeggen, op dit moment zal de hiërarchie van knooppunten er als volgt uitzien:
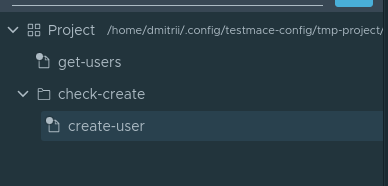
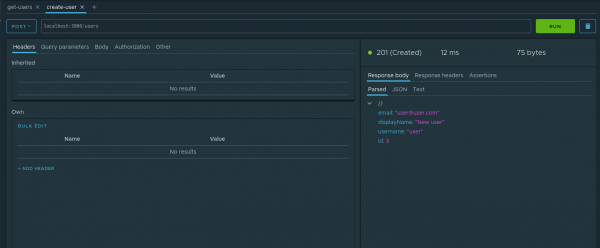
Laten we naar het tabblad van het geopende create-user knooppunt gaan. Laten we de volgende parameters voor de aanvraag invoeren:
- Aanvraagtype — POST
- URL — localhost:3000/users
- Body — JSON met de waarde
{"email": "user@user.com", "displayName": "Nieuwe gebruiker", "username": "user"}
Laten we deze aanvraag uitvoeren. Onze applicatie zegt dat de record is aangemaakt.
Laten we deze feit controleren. Om in de volgende stappen met het id van de aangemaakte gebruiker te kunnen werken, moet deze parameter worden opgeslagen. Hiervoor is het mechanisme . Laten we in ons voorbeeld bekijken hoe hiermee wordt gewerkt. In het tabblad parsed van het antwoord van het knooppunt moet je in het contextmenu het punt kiezen Toewijzen aan variabele. In het dialoogvenster moet je de volgende parameters opgeven:
- Node — in welke van de voorouders de dynamische variabele moet worden aangemaakt. Laten we kiezen voor check-create
- Variabelenaam — de naam van deze variabele. We noemen het
userId.
Zo ziet het proces van het aanmaken van een dynamische variabele eruit:
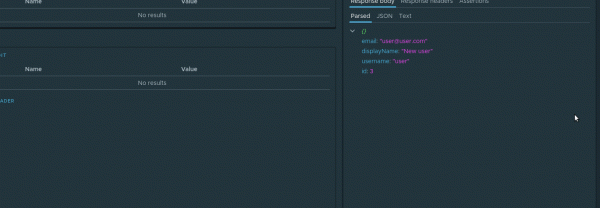
Nu wordt de waarde van de dynamische variabele bij elke uitvoering van deze aanvraag bijgewerkt. Omdat dynamische variabelen het mechanisme van hiërarchische overerving ondersteunen, zal de variabele userId beschikbaar zijn in afgeleiden check-create knopen op elk niveau van insluiting.
In de volgende aanvraag zullen we deze variabele nodig hebben. Namelijk, we zullen de opnieuw aangemaakte gebruiker aanvragen. Als afgeleide van het knooppunt check-create maken we de aanvraag check-if exists met de parameter url gelijk aan localhost:3000/users/${$dynamicVar.userId}. De constructie van het type ${variable_name} is het ophalen van de waarde van de variabele. Aangezien we een dynamische variabele hebben, moet je de gehele verwijzing naar de dynamische variabele als volgt opstellen: $dynamicVarDus de volledige verwijzing naar de dynamische variabele userId ziet eruit als ${$dynamicVar.userId}. Laten we de aanvraag uitvoeren en ervoor zorgen dat de gegevens correct worden opgevraagd.
De laatste stap is het maken van een verwijderverzoek. We hebben dit niet alleen nodig om te controleren of de verwijdering werkt, maar ook om, laten we zeggen, de boel op te schonen in de database, aangezien de velden email en username uniek zijn. Dus, in de check-create node maken we een delete-user verzoek met de volgende parameters
- Type verzoek - DELETE
- URL -
localhost:3000/users/${$dynamicVar.userId}
We starten. We wachten. We genieten van het resultaat)
En nu kunnen we op elk moment dit scenario volledig uitvoeren. Om het scenario te starten, moet u de optie selecteren in het contextmenu check-create van de node Run.
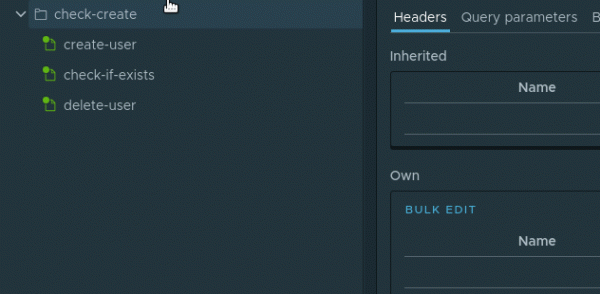
Nodes in het scenario worden één voor één uitgevoerd
Dit scenario kunt u opslaan in uw project door Bestand -> Project opslaan.
Conclusie
In het formaat van dit artikel konden niet alle functies van de gebruikte tools worden ondergebracht. Wat betreft de belangrijkste schuldige - het pakket jsx/crud - de volgende onderwerpen zijn niet behandeld:
- aangepaste validatie en transformatie van modellen;
- een krachtige querytaal en gebruiksgemak aan de voorkant;
- het overschrijven en toevoegen van nieuwe methoden in crud-controllers;
- ondersteuning voor swagger;
- cachebeheer.
Echter, zelfs het in het artikel beschreven is voldoende om te begrijpen dat zelfs zo'n enterprise framework als NestJS tools heeft voor het snel prototypen van applicaties. En zo'n geweldige IDE als helpt om het gewenste tempo aan te houden.
De broncode van dit artikel, samen met het project , is beschikbaar in de repository . Om het project te openen is het voldoende om in de applicatie Bestand -> Project openen.
Bron: habr.com
