

Als je aan het begin van het stuk zegt dat er een C++-code aan de muur hangt, moet deze aan het einde zeker op je voet schieten.
Bjarne Stroustrup
Van 31 oktober tot 1 november vond in Sint-Petersburg de C++ Russia Piter-conferentie plaats – een van de grootste programmeerconferenties in Rusland, georganiseerd door JUG Ru Group. Onder de uitgenodigde sprekers waren leden van de C++ standaardisatiecommissie, sprekers van CppCon, auteurs van boeken van O'Reilly, en ook de maintainers van projecten zoals LLVM, libc++ en Boost. De conferentie is gericht op ervaren C++-ontwikkelaars die hun expertise willen verdiepen en ervaringen willen uitwisselen in een directe interactie. Studenten, afgestudeerden en universiteitsdocenten krijgen aantrekkelijke kortingen.
De Moskouse editie van de conferentie zal al in april volgend jaar plaatsvinden, maar intussen zullen onze studenten vertellen wat ze interessant vonden van het afgelopen evenement.
Foto uit
Alconost is professioneel bezig met
Aan dit bericht werkten twee studenten van HSE – Sint-Petersburg:
- Lisa Vasilenko – vierdejaars bachelorstudent, die de richting 'Programmeertalen' bestudeert binnen het programma 'Toegepaste wiskunde en informatica'. Ze heeft kennisgemaakt met de C++-taal tijdens haar eerste jaar aan de universiteit en heeft daarna ervaring opgedaan met deze taal tijdens stages in de industrie. Haar interesse in programmeertalen in het algemeen en functionele programmering in het bijzonder heeft haar keuze van lezingen op de conferentie beïnvloed.
- Danya Smirnov – eerstejaars masterstudent in 'Programmeren en gegevensanalyse'. Al op school schreef hij C++-opdrachten voor olympiadewedstrijden, en daarna kwam het zo dat de taal voortdurend opdook in zijn studieactiviteiten en uiteindelijk zijn primaire werktaal werd. Hij besloot deel te nemen aan de conferentie om zijn kennis op te frissen en meer te leren over nieuwe mogelijkheden.
In de nieuwsbrief deelt de faculteit vaak informatie over onderwijsevenementen die verband houden met onze specialisatie. In september zagen we informatie over C++ Russia en besloten we ons te registreren als toehoorders. Dit is onze eerste ervaring met deelname aan dergelijke conferenties.
Structuur van de conferentie
Presentaties
In twee dagen tijd hebben experts 30 presentaties gelezen, met veel actuele onderwerpen: slimme toepassingen van taalfeatures voor het oplossen van praktische taken, aankomende updates van de taal in verband met de nieuwe standaard, compromissen bij het ontwerp van C++ en voorzorgsmaatregelen bij het omgaan met de gevolgen ervan, voorbeelden van interessante projectarchitectuur, evenals enkele onderliggende details van de taal-infrastructuur. Tegelijkertijd waren er 3 presentaties, meestal twee in het Russisch en één in het Engels.
Discussiegebieden
Na de presentatie werden alle onbeantwoorde vragen en onafgebroken discussies overgebracht naar speciaal aangewezen communicatiezones met de sprekers, uitgerust met whiteboards. Een goede manier om een pauze tussen de presentaties te vullen met een aangename conversatie.
Lightning Talks en informele discussies
Als je een korte presentatie wilt geven, kun je je inschrijven op het whiteboard voor de avond-Lighting Talk en vijf minuten de tijd krijgen om iets te vertellen over een onderwerp dat gerelateerd is aan de conferentie. Bijvoorbeeld, een snelle introductie in sanitizers voor C++ (voor sommigen was dit nieuw) of het verhaal over een bug in de sinusgolfgeneratie, die je alleen kunt horen, maar niet kunt zien.
Een ander formaat was de paneldiscussie 'Met de commissie in gesprek'. Op het podium stonden enkele leden van de standaardisatiecommissie, op de projector een open haard (officieel - voor het creëren van een gezellige sfeer, maar de reden 'omdat ALLES IN VUUR IS' lijkt leuker), vragen gingen over de standaard en de algemene visie op C++, zonder heftige technische discussies en strijd. Het bleek dat er ook echte mensen in de commissie zitten die in bepaalde zaken niet helemaal zeker kunnen zijn of iets niet weten.
Voor liefhebbers van strijd was er nog een derde evenement - de BOF-sessie 'Go versus C++'. We nemen een Go-enthousiasteling en een C++-fan, vóór de sessie bereiden ze samen 100500 dia's voor het onderwerp (bijvoorbeeld problemen met pakketten in C++ of het ontbreken van generics in Go), en vervolgens discussiëren ze levendig met elkaar en met de zaal, terwijl het publiek probeert beide standpunten te begrijpen. Als een onzinnige strijd begint, grijpt de moderator in en verzoent de partijen. Dit formaat trekt aan: enkele uren na de start was slechts de helft van de dia's afgehandeld. Het einde moest sterk worden versneld.
Partnerstands
In de hal werden de partners van de conferentie gepresenteerd - op de standen werden actuele projecten besproken, stages en werkgelegenheid aangeboden, quizzen en kleine wedstrijden georganiseerd, en leuke prijzen verloot. Daarbij boden sommige bedrijven zelfs aan om de eerste rondes van sollicitaties te doorlopen, wat handig kan zijn voor degenen die niet alleen kwamen om naar presentaties te luisteren.
Technische details van de presentaties
We hebben beide dagen naar presentaties geluisterd. Soms was het moeilijk om een enkele presentatie te kiezen uit de gelijktijdige sessies - we hebben afgesproken om ons op te splitsen en de opgedane kennis tijdens de pauzes uit te wisselen. En zelfs zo lijkt het erop dat er veel is gemist. Hier willen we graag meer vertellen over de inhoud van enkele presentaties die we het interessantst vonden.
Uitzonderingen in C++ door de lens van compileroptimalisaties, Roman Ruseyev
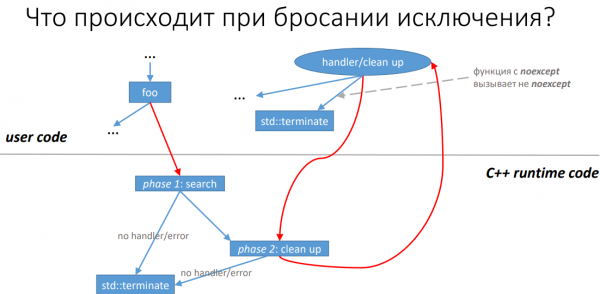
Dia uit
Zoals de titel al aangeeft, onderzocht Roman de werking met uitzonderingen aan de hand van LLVM. Zelfs voor degenen die in hun werk geen gebruik maken van Clang, kan de presentatie toch een inzicht geven in hoe code potentieel kan worden geoptimaliseerd. Dit komt omdat ontwikkelaars van compilers en bijbehorende standaardbibliotheken met elkaar communiceren en veel succesvolle oplossingen kunnen overeenkomen.
Dus, voor het afhandelen van uitzonderingen zijn veel stappen vereist: de verwerkingscode aanroepen (indien aanwezig) of middelen op het huidige niveau vrijgeven en de stack omhoog rollen. Dit alles leidt ertoe dat de compiler extra instructies toevoegt voor potentieel uitzonderingsgevende aanroepen. Daarom, als een uitzondering in feite niet wordt opgewekt, zal de programma nog steeds onnodige acties uitvoeren. Om de overhead enigszins te verlagen, heeft LLVM verschillende heuristieken voor het bepalen van situaties waarin het niet nodig is om uitzonderingsverwerkingscode toe te voegen of waarin het aantal 'overbodige' instructies kan worden verminderd.
De spreker bespreekt ongeveer een tiental van deze heuristieken en laat zien waar ze helpen om de uitvoering van het programma te versnellen, en waar deze methoden niet toepasbaar zijn.
Zo komt Roman Ruseyev tot de conclusie dat code waar met uitzonderingen wordt gewerkt, lang niet altijd met nul overhead kan worden uitgevoerd, en geeft de volgende adviezen:
- Bij het ontwikkelen van bibliotheken is het in het algemeen beter om helemaal geen uitzonderingen te gebruiken.
- Als uitzonderingen toch nodig zijn, is het raadzaam om waar mogelijk noexcept (en const) modifiers toe te voegen, zodat de compiler zoveel mogelijk kan optimaliseren.
Over het geheel genomen bevestigde de spreker de mening dat uitzonderingen het beste minimaal gebruikt kunnen worden of volledig vermeden moeten worden.
De dia's van de presentatie zijn beschikbaar via de link:
Generators, coroutines en andere brein-verruimende zoetheid, Adi Shavit
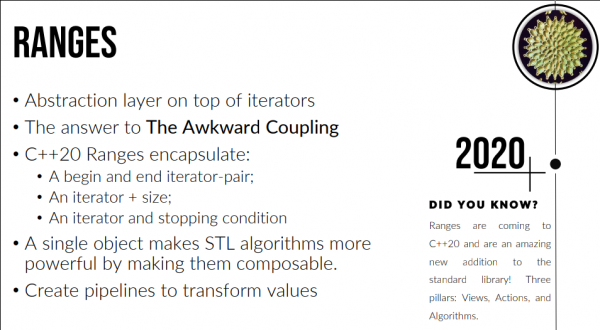
Dia uit
Een van de vele presentaties van deze conferentie, gericht op de innovaties in C++20, bleef niet alleen hangen door de fraai vormgegeven presentatie, maar ook door de duidelijke aanduiding van de bestaande problemen met de logica van het verwerken van verzamelingen (for-lus, callbacks).
Adi Shavit benoemt de volgende: de beschikbare methoden doorlopen momenteel de hele verzameling en bieden geen toegang tot een bepaalde interne tussenstaat (of doen dit bij callbacks, maar met veel ongewenste bijeffecten, zoals Callback Hell). Het lijkt misschien alsof er iterators zijn, maar ook daarmee is het niet zo eenvoudig: er is geen eenduidige start- en eindpunt (begin → end versus rbegin → rend, enzovoort), en het is onduidelijk hoe vaak we gaan itereren. Met C++20 worden deze problemen opgelost!
De eerste optie: ranges. Door het inpakken van iterators krijgen we een gemeenschappelijke interface voor het begin en het einde van de iteratie, en we kunnen compositie toepassen. Dit maakt het gemakkelijk om volledige dataverwerkingspijpen op te zetten. Maar niet alles is zo eenvoudig: een deel van de berekeningslogica bevindt zich binnen de implementatie van een specifieke iterator, wat de code moeilijker te begrijpen en te debuggen kan maken.
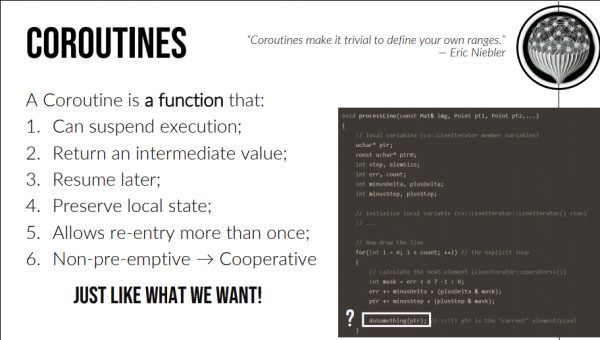
Dia uit
Welnu, voor dit geval zijn in C++20 coroutines toegevoegd (functies waarvan het gedrag lijkt op generators in de programmeertaal Python): uitvoering kan worden uitgesteld door een bepaalde huidige waarde terug te geven terwijl de tussenstaat behouden blijft. Zo bereiken we niet alleen verwerking van gegevens zodra ze beschikbaar zijn, maar verpakken we ook de hele logica binnen de specifieke coroutine.
Maar er is een tegenslag: momenteel worden ze slechts gedeeltelijk ondersteund door de beschikbare compilers, en zijn ze niet zo netjes geïmplementeerd als gewenst: bijvoorbeeld, het is niet aan te raden om verwijzingen en tijdelijke objecten in coroutines te gebruiken. Bovendien zijn er enkele beperkingen aan wat coroutines kunnen zijn, en constexpr-functies, constructoren/destructors, en ook main behoren niet tot deze lijst.
Op deze manier lossen coroutines een aanzienlijk deel van de problemen met de eenvoud van data-processing-logica op, maar hun huidige implementaties vereisen verbetering.
Materialen:
- Dia's van C++ Rusland —
C++ trucs uit Yandex.Taxi, Anton Polukhin
In mijn professionele activiteiten moet ik soms puur ondersteunende dingen implementeren: een wrapper tussen de interne interface en de API van een bepaalde bibliotheek, logging of parsing. Daarbij is er meestal geen behoefte aan extra optimalisatie. Maar wat als deze componenten worden gebruikt in een van de meest populaire diensten in het Russische netwerk? In zo'n situatie moet je terabytes aan logs per uur verwerken! Dan is elke milliseconde kritiek en daarom moet je verschillende trucs toepassen - waarover Anton Polukhin sprak.
Misschien was het interessantste voorbeeld de implementatie van het pointer-to-implementation (pimpl) patroon.
#include <third_party/json.hpp> //PROBLEMS!
struct Value {
    Value() = default;
    Value(Value&& other) = default;
    Value& operator=(Value&& other) = default;
    ~Value() = default;

    std::size_t Size() const { return data_.size(); }

private:
    third_party::Json data_;
};
In dit voorbeeld wil je in eerste instantie afscheid nemen van de headerbestanden van externe bibliotheken - dat versnelt de compilatie en beschermt je tegen mogelijke naamconflicten en andere soortgelijke fouten.
Goed, we hebben #include naar het .cpp-bestand verplaatst: er is een forward-declaration van de gewrapte API nodig, evenals std::unique_ptr. Nu hebben we dynamische allocaties en andere ongewenste zaken zoals verspreide data in de heap en verminderde garanties. Hier kan std::aligned_storage bij helpen.
struct Value {
// ...
private:
    using JsonNative = third_party::Json;
    const JsonNative* Ptr() const noexcept;
    JsonNative* Ptr() noexcept;

    constexpr std::size_t kImplSize = 32;
    constexpr std::size_t kImplAlign = 8;
    std::aligned_storage_t data_;
};
Het enige probleem: je moet de grootte en uitlijning voor elke wrapper specificeren - laten we onze pimpl sjabloonachtig maken met parameters , gebruiken met willekeurige waarden en in de destructor een controle toevoegen dat we alles goed hebben geraden:
~FastPimpl() noexcept {
    validate();
    Ptr()->~T();
}

template
static void validate() noexcept {
    static_assert(
        Size == ActualSize,
        "Size and sizeof(T) mismatch"
    );
    static_assert(
        Alignment == ActualAlignment,
        "Alignment and alignof(T) mismatch"
    );
}
Aangezien T al gedefinieerd is tijdens de destructorfase, zal deze code correct worden verwerkt en op compileertijd de nodige waarden voor grootte en uitlijning geven als fouten. Hierdoor voorkomen we met de prijs van één extra compilatieronde dynamische toewijzing van verpakte klassen, verbergen we de API in een .cpp-bestand met implementatie en krijgen we een meer CPU-cache-vriendelijke structuur.
Logging en parsing leek minder indrukwekkend, en worden daarom in deze recensie niet genoemd.
De dia's van de presentatie zijn beschikbaar via de link:
Moderne technieken om je code DRY te houden, Björn Fahller
In deze presentatie laat Björn Fahller verschillende manieren zien om zo'n stilistisch tekortkoming zoals herhalende voorwaardelijke controles aan te pakken:
assert(a == IDLE || a == CONNECTED || a == DISCONNECTED);Klinkt bekend? Met behulp van een aantal krachtige C++ technieken die in recente standaarden zijn verschenen, kan dezelfde functionaliteit elegant worden geïmplementeerd zonder enige prestatieverliezen. Vergelijk:
assert(a == any_of(IDLE, CONNECTED, DISCONNECTED));Voor het verwerken van een onbepaald aantal controles is het logisch om variadic templates en fold expressions te gebruiken. Laten we aannemen dat we de gelijkheid van meerdere variabelen met een enum-element state_type willen controleren. Het eerste dat in je opkomt is om een hulpfunctie is_any_of te schrijven:
enum state_type { IDLE, CONNECTED, DISCONNECTED };

template
bool is_any_of(state_type s, const Ts& ... ts) {
    return ((s == ts) || ...);
}
Dit tussenresultaat wekt teleurstelling. Tot nu toe is de code niet leesbaarder geworden:
assert(is_any_of(state, IDLE, DISCONNECTING, DISCONNECTED)); Een beetje verbetering kan worden bereikt met non-type template parameters. Hiermee brengen we de geënumerateerde elementen van de enum naar de lijst met sjabloonparameters:
template
bool is_any_of(state_type t) {
    return ((t == states) | ...);
}

assert(is_any_of(state));
Met het gebruik van auto in een non-type sjabloonparameter (C++17), generaliseert de aanpak eenvoudig naar vergelijkingen niet alleen met elementen van state_type, maar ook met primitieve types die kunnen worden gebruikt als non-type template parameters:
template
bool is_any_of(const T& t) {
    return ((t == alternatives) | ...);
}
Door dergelijke opeenvolgende verbeteringen wordt de gewenste vloeiende syntaxis voor controles bereikt:
template
struct any_of : private std::tuple {
// laten we de constructors van tuple gewoon erven
        using std::tuple::tuple;
        template
        bool operator ==(const T& t) const {
                return std::apply(
                    [&t](const auto& ... ts) {
                        return ((ts == t) || ...);
                    },
                    static_cast<const std::tuple&>(*this));
        }
};

template
any_of(Ts ...) -> any_of;

assert(any_of(IDLE, DISCONNECTING, DISCONNECTED) == state);
In dit voorbeeld dient de deduction guide om de gewenste sjabloonparameters voor de structuur te suggereren aan de compiler, die de typen van de constructorargumenten kent.
Verder – het wordt interessanter. Björn leert om de resulterende code te generaliseren voor vergelijkingsoperaties naast ==, en vervolgens voor willekeurige operaties. Onderweg worden kenmerken zoals no_unique_address attribute (C++20) en sjabloonparameters in lambda-functies (C++20) aan de hand van een voorbeeld uitgelegd. (Ja, nu is de syntaxis van lambdas nog gemakkelijker te onthouden – het zijn vier opeenvolgende paren haakjes van allerlei soorten.) De uiteindelijke oplossing met functies als bouwstenen van de constructor verwarmt mijn hart persoonlijk, om nog maar te zwijgen over de expressie tuple in de beste tradities van lambda-calculatie.
Vergeet niet om af te werken:
- Laten we ons herinneren dat lambdas – constexpr gratis zijn;
- Laten we perfect forwarding toevoegen en kijken naar zijn lelijke syntaxis in relatie tot parameter pack in lambda-closures;
- Geven we de compiler meer mogelijkheden voor optimalisaties met conditional noexcept;
- Zorgen we voor een duidelijkere foutmelding in sjablonen door expliciete retourwaarden in lambdas. Dit dwingt de compiler om meer controles uit te voeren voordat de sjabloonfunctie daadwerkelijk wordt aangeroepen – in de fase van typecontrole.
Voor details kunt u terecht bij het lesmateriaal:
- Slide van de presentatie:
Onze indrukken
Onze eerste deelname aan C++ Russia viel op door zijn intensiteit. Het maakte indruk als een warm evenement, waar de grens tussen leren en informele communicatie bijna niet voelbaar is. Alles, van de stemming van de sprekers tot de wedstrijden van de partners van het evenement, nodigt uit tot levendige discussies. Het inhoudelijke gedeelte van de conferentie, dat bestaat uit presentaties, bestrijkt een breed scala aan onderwerpen, waaronder innovaties in C++, praktijkvoorbeelden van grote projecten en ideologische architectonische overwegingen. Maar het zou onverstandig zijn om de sociale component van het evenement te negeren, die bijdraagt aan het overwinnen van taalkloof in relatie tot niet alleen C++.
We bedanken de organisatoren van de conferentie voor de mogelijkheid om aan zo'n evenement deel te nemen!
De post van de organisatoren over het verleden, het heden en de toekomst van C++ Russia heeft u kunnen zien .
Bedankt voor het lezen en we hopen dat onze samenvatting van de gebeurtenissen nuttig was!
Bron: habr.com
