

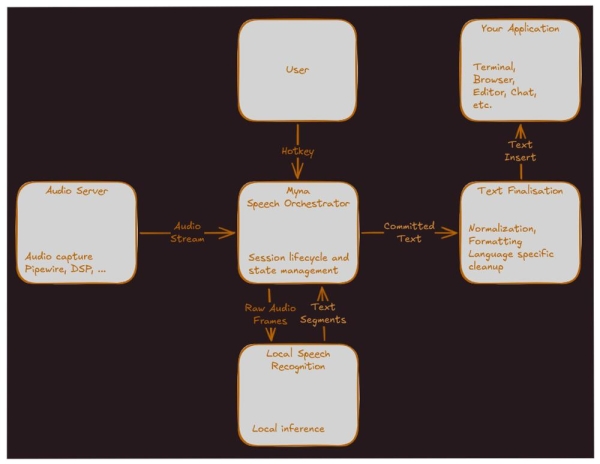
Canonical heeft een project gepresenteerd Myna — een nieuw spraak-naar-tekst omzettingssysteem voor Ubuntu Desktop. Het project is gericht op ingebouwde dictatie: de gebruiker drukt op een sneltoets, spreekt en de herkende tekst verschijnt in de actieve applicatie. In de aankondiging wordt benadrukt dat Myna moet aanvoelen als een natuurlijk onderdeel van de Ubuntu-desktop en tegelijk rekening houdt met de privacy van de gebruiker. De lijst van ondersteunde invoertalen is bij de publicatie van het nieuws niet bekendgemaakt.
Het eerste doel van het project is Ubuntu 26.10. In deze fase probeert Canonical niet een volwaardige spraakassistent of een systeem voor desktopbediening met spraak te maken. De ontwikkelaars hebben opzettelijk het bereik van de eerste versie beperkt tot basisdictatie: druk op een toetscombinatie, spreek een tekst uit en ontvang het resultaat in het huidige invoerveld. De primaire testomgeving is Ubuntu Desktop op Wayland met GNOME, maar de architectuur wordt open gehouden voor toekomstige ondersteuning van andere omgevingen.
Myna is ontworpen voor lokale spraakherkenning. Na installatie van de vereiste modellen is er geen internetverbinding nodig voor dictatie, en de microfoon moet alleen worden gebruikt na expliciete activering door de gebruiker; audio wordt in het geheugen verwerkt en vervolgens afgewezen, en opnames worden niet naar externe diensten verzonden. In de projectspecificatie staat ook dat de oplossing standaard geen audio moet opslaan en niet ongemerkt moet overschakelen naar een cloudservice.
De code en documentatie van Myna zijn gepubliceerd in de repository van Canonical op GitHub. Het project wordt beschreven als een lichte spraak-naar-tekst applicatie voor Ubuntu Desktop en wordt verspreid onder de GPL-3.0 licentie. Tegelijkertijd bevindt het project zich nog in een vroeg stadium: er zijn momenteel geen gepubliceerde releases in de repository, en de architecturale specificatie heeft de status voorgesteld.
Belangrijkste functies en kenmerken van Myna
Push-to-talk dictatie. De gebruiker houdt een aanpasbare sneltoets ingedrukt, spreekt en het systeem voegt de herkende tekst in het geselecteerde invoerveld in. De dictatie eindigt nadat de toets is losgelaten.
Lokale spraakherkenning. Herkenning vindt plaats op de machine van de gebruiker via een lokale inference-stack. Dit vermindert de afhankelijkheid van de cloud en maakt het mogelijk om zonder netwerk te werken na installatie van de modellen.
Privé verwerking van audio. De microfoon wordt alleen geactiveerd tijdens de gebruikerssessie voor dictaten. Audio wordt standaard niet op de schijf opgenomen; er wordt een beperkte buffer in het geheugen gebruikt die wordt gewist na afloop van de sessie.
Visuele activiteitsindicator. Tijdens het opnemen en transcriberen moet de gebruiker een duidelijke statusindicator zien. In de specificatie worden statussen genoemd zoals Opnemen, Transcriberen, Finaliseren en Fout.
Alleen stabiele tekst invoegen. In de eerste implementatie mogen tussenhypotheses van de herkenning niet direct in de applicatie worden ingevoegd. Alleen de bevestigde definitieve tekst wordt naar het doelveld gestuurd.
Nabewerking van de tekst. Ruwe transcriptie kan normalisatie, interpunctie, kapitalisatie, opmaak en conversie van mondelinge vormen naar geschreven vormen ondergaan, zoals “twenty two” → “22.”
Taalkeuze voor dictaten. Het systeem moet een aanpasbare dictatietaal ondersteunen, standaard gericht op de taal van de gebruikersinterface, indien er een geschikte model beschikbaar is.
Kwaliteitsprofielen van het model. De specificatie voorziet in verschillende modelprofielen: een lichte versie met een lager verbruik van middelen, een uitgebalanceerd standaardprofiel en een hogere kwaliteit, maar zwaardere versie.
Veilig werken met focus invoer. Het doel voor het invoegen van tekst wordt aan het begin van de sessie geselecteerd. Als de focus van het venster verandert tijdens het dicteren, mag het systeem de tekst niet stilzwijgend naar een andere applicatie verzenden.
Blokkering in beveiligde velden. Dictatie moet worden geblokkeerd in wachtwoordvelden, inlogvensters en andere beveiligde plaatsen, als de applicatie of toolkit dit kan bepalen.
Integratie met Wayland/GNOME. De eerste versie is gericht op Wayland en GNOME. Voor de initiële invoeging van tekst wordt IBus overwogen, en in de toekomst wordt een meer native Wayland-aanpak via input-method/text-input protocollen gepland.
Gebruikersinstellingen. In de geplande interface voor instellingen moeten opties voor in- en uitschakelen van STT, keuze van sneltoets, dictatietaal, microfoon, modelprofiel, nabewerkingsparameters en activiteitsindicator zijn opgenomen.
In de eerste iteratie blijven buiten het project de ontwaking op de sleutelzin, constante achtergrondluistering, cloudherkenning, spraakassistent, spraakopdrachten, bureaubeheer, spraakvertaling, sprekeridentificatie, automatische taalherkenning en de geschiedenis van dicteren. Met andere woorden, Canonical begint niet met een "AI-assistent", maar met een meer praktische functie: lokale spraakinput voor tekst in gewone Ubuntu-toepassingen.
Bron: linux.org.ru
