

Google heeft een experiment aangekondigd voor het integreren van een grote taalmodel voor machine learning in Chrome. Om toegang te krijgen tot het model vanuit webapplicaties en browserextensies is er een API Prompt aangeboden, waarmee verzoeken in natuurlijke taal kunnen worden verzonden, vergelijkbaar met chatbots. Het is de verwachting dat het geïntegreerde grote taalmodel in de browser het uitvoeren van AI-taken in webapplicaties zal vereenvoudigen en gebruikers niet zal belasten met het installeren en beheren van taalmodellen.
In het uitgevoerde experiment wordt het Gemini Nano-model gebruikt, het meest compacte model uit de Gemini-familie. Er is ook de mogelijkheid voorzien om expertenmodellen te installeren die de basismodel verrijken met extra kennis die nodig kan zijn voor het oplossen van specifieke taken, evenals voor het uitvoeren van vaardigheden zoals machinevertaling en samenvatten. De modellen draaien lokaal op het systeem van de gebruiker zonder dat er externe diensten nodig zijn.
De gebruikte Runtime voor het uitvoeren van het model benut automatisch de beschikbare GPU's en NPU's op het systeem om de prestaties van het model te versnellen of schakelt over naar het uitvoeren van het model met de CPU. De voordelen van het uitvoeren van het model op het systeem van de gebruiker zijn onder andere het behoud van de vertrouwelijkheid van de verwerkte gegevens, de mogelijkheid om door te gaan in offline-modus bij gebrek aan een netwerkverbinding of bij problemen met de kwaliteit van de koppeling, en het verminderen van vertragingen bij het verzenden van verzoeken, waardoor afhankelijkheid van externe diensten wordt vermeden.
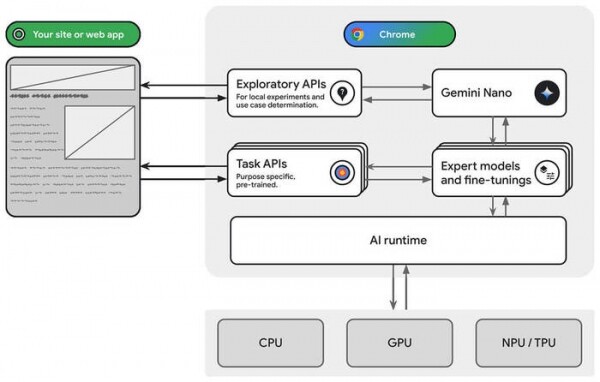
De API Prompt die wordt ontwikkeld voor interactie met het model stelt niet alleen in staat om de eenvoudigste enkelvoudige verzoeken in natuurlijke taal uit te voeren, maar ook om de modelparticipatie in de verwerking en classificatie van gegevens rekening houdend met de context te organiseren, eerder verzonden verzoeken en gegevens in de sessie mee te nemen, en het model te gebruiken om optimale opties te selecteren (bijvoorbeeld, het is mogelijk om te vragen om een emoji uit een lijst te kiezen voor een specifieke opmerking op de website). Daarnaast is er de plannen om de API verder te ontwikkelen voor gebruik in de contentcreatie en het oplossen van taken zoals herschrijven in andere woorden, proofreading en grammaticacontrole.
In algemene zin worden er twee soorten API's ontwikkeld voor interactie met het ingebouwde AI-model: Task en Exploratory. De eerste biedt toegang tot mogelijkheden voor het oplossen van specifieke taken, zoals het vertalen van tekst van de ene naar de andere taal (API Translation) of het samenvatten van de essentie van een tekst (API Summarization). Het tweede type richt zich op het creëren en testen van experimentele prototypes bij de ontwikkeling van nieuwe Task API's. Er wordt ook gewerkt aan de API LoRA (Low-Rank Adaptation) om de gewichten van het basismodel aan te passen, om de effectiviteit van het oplossen van bepaalde taken te verbeteren.
Toegang tot deelname aan het experiment wordt verleend na het indienen van een aanvraag. De API is momenteel in actieve ontwikkeling en zal zich uitbreiden en veranderen op basis van feedback en voorkeuren van gebruikers totdat de definitieve versie is aangenomen. In de toekomst wordt er een meer toegankelijke testfase gepland met gebruik van de Origin Trials-modus, die de mogelijkheid biedt om met experimentele API's te werken vanuit applicaties die zijn gedownload van localhost of 127.0.0.1, of na registratie en het verkrijgen van een speciale token die beperkt geldig is voor een specifieke site. Tegelijkertijd wordt er samengewerkt met andere browserfabrikanten om de ontwikkelde API's te standaardiseren.
Bron: opennet.ru
