

Google heeft de audio-codec Lyra V2 geïntroduceerd, die gebruik maakt van machine learning-technieken om de maximale spraakkwaliteit te bereiken bij het gebruik van zeer langzame verbindingen. De nieuwe versie heeft een overstap gemaakt naar een nieuwe neurale netwerkarchitectuur, ondersteuning voor extra platforms, uitgebreide mogelijkheden voor bitratemanagement, verbeterde prestaties en een hoger geluidskwaliteit. De referentie-implementatie van de code is geschreven in C++ en wordt verspreid onder de Apache 2.0-licentie.
Wat betreft de kwaliteit van de overgedragen spraakgegevens bij lage snelheden, overtreft Lyra aanzienlijk traditionele codecs die gebruik maken van methoden voor digitale signaalverwerking. Om hoge spraakkwaliteit te bereiken onder beperkte gegevensoverdracht, maakt Lyra naast de gebruikelijke methoden voor geluidscompressie en signaaltransformatie gebruik van een spraakmodel op basis van een machine learning-systeem, waardoor ontbrekende informatie kan worden gereconstrueerd op basis van typische spraakkenmerken.
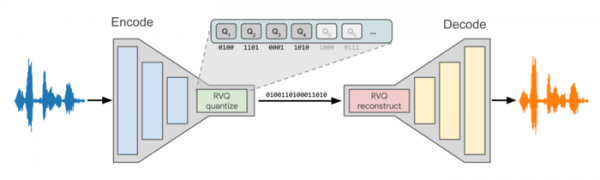
De codec omvat een encoder en een decoder. Het algoritme van de encoder bestaat uit het extraheren van parameters van spraakgegevens om de 20 milliseconden, deze te comprimeren en de verkregen gegevens via het netwerk naar de ontvanger te verzenden met een bitratetussen 3,2 kbps en 9,2 kbps. Aan de kant van de ontvanger gebruikt de decoder een generatief model om het oorspronkelijke spraaksignaal opnieuw te creëren op basis van de verzonden geluidsparameters, die logaritmische mel-spectrogrammen omvatten die rekening houden met de energiekenmerken van spraak in verschillende frequentiebereiken en zijn voorbereid met inachtneming van het model van menselijke auditieve waarneming.
In Lyra V2, a new generative model based on the convolutional neural network SoundStream is used, characterized by low computational resource requirements, allowing real-time decoding even on low-power systems. The model used for sound generation has been trained with several thousand hours of recordings of voices in over 90 languages. TensorFlow Lite is utilized to execute the model. The performance of the proposed implementation is sufficient for encoding and decoding speech on budget smartphones.
In addition to using a different generative model, the new version is also notable for incorporating RVQ (Residual Vector Quantizer) quantization links within the codec architecture, performed on the sender's side before data transmission, and on the receiver's side after data reception. The quantizer converts the parameters outputted by the codec into sets of packets, encoding information in relation to the selected bitrate. To ensure different levels of quality, quantizers for three bitrates (3.2 kbps, 6 kbps, and 9.2 kbps) are provided, with higher bitrates yielding better quality but requiring more bandwidth.
The new architecture has reduced signal transmission delays from 100 milliseconds to 20 milliseconds. For comparison, the Opus codec for WebRTC demonstrated tested delays at bitrates of 26.5ms, 46.5ms, and 66.5ms. Additionally, the performance of the encoder and decoder has significantly improved — up to 5 times faster compared to the previous version. For instance, on the Pixel 6 Pro smartphone, the new codec encodes and decodes a 20-millisecond sample in 0.57 ms, which is 35 times faster than required for real-time transmission.
In addition to performance, an improvement in sound restoration quality has also been achieved — on the MUSHRA scale, the speech quality at bitrates of 3.2 kbps, 6 kbps, and 9.2 kbps using the Lyra V2 codec corresponds to bitrates of 10 kbps, 13 kbps, and 14 kbps using the Opus codec.
Bron: opennet.ru
