

Een groep onderzoekers van de Universiteit van Tel Aviv heeft HyperStyle gepresenteerd, een omgekeerde variant van het machine learning-systeem StyleGAN2 dat door NVIDIA wordt ontwikkeld, dat is aangepast om ontbrekende delen te reconstrueren bij het bewerken van echte afbeeldingen. De code is geschreven in Python met behulp van het PyTorch-framework en wordt verspreid onder de MIT-licentie.
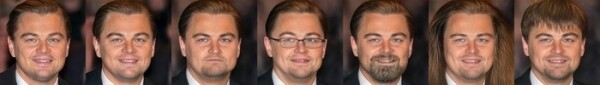
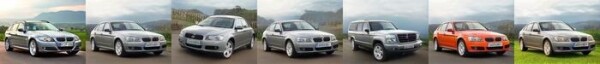
Terwijl StyleGAN in staat is om realistisch uitziende nieuwe gezichten van mensen te synthetiseren door parameters zoals leeftijd, geslacht, haarlengte, glimlach, neusvorm, huidkleur, brillen en fotografische hoeken in te stellen, maakt HyperStyle het mogelijk om soortgelijke parameters in bestaande foto's te wijzigen zonder de karakteristieke kenmerken aan te passen, en ondertussen de herkenbaarheid van het originele gezicht te behouden. Bijvoorbeeld, met HyperStyle kan men de leeftijd van een persoon op een foto simuleren, de haardracht veranderen, brillen, een baard of snor toevoegen, de afbeelding de uitstraling van een cartoonfiguur of een schilderij geven, of de gezichtsuitdrukking verdrietig of vrolijk maken. Daarnaast kan het systeem niet alleen worden getraind voor het wijzigen van mensen gezichten, maar ook voor andere objecten, zoals het bewerken van afbeeldingen van auto's.
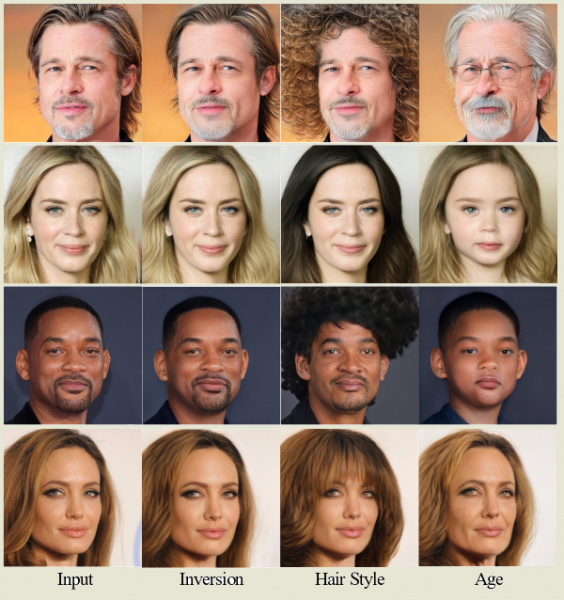
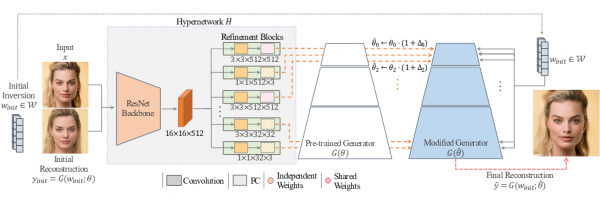
De voorgestelde methode richt zich op het oplossen van het probleem van reconstructie van ontbrekende delen van een afbeelding bij het bewerken. In eerder voorgestelde methoden werd de compromis tussen reconstructie en bewerkbaarheid opgelost door het fijn afstemmen van de beeldgenerator om delen van de doelafbeelding in te passen bij het reconstrueren van oorspronkelijk ontbrekende bewerkbare gebieden. Een nadeel van dergelijke benaderingen is de noodzaak van langdurige gerichte training van het neuraal netwerk voor elke afbeelding.
De methode op basis van het StyleGAN-algoritme maakt het mogelijk om een standaardmodel te gebruiken, dat vooraf is getraind op algemene afbeeldingscollecties, voor het genereren van elementen die inherent zijn aan de originele afbeelding met een niveau van betrouwbaarheid vergelijkbaar met algoritmen die individuele training van het model voor elke afbeelding vereisen. Een ander voordeel van de nieuwe methode is de mogelijkheid om afbeeldingen te modificeren met prestaties die dicht bij de real-time modus liggen.
Klaar-getrainde modellen zijn beschikbaar voor gezichten van mensen, machines en dieren, gebaseerd op de collecties Flickr-Faces-HQ (FFHQ, 70.000 hoogwaardige PNG-afbeeldingen van mensen), Stanford Cars (16.000 afbeeldingen van voertuigen) en AFHQ (foto's van dieren). Daarnaast is er gereedschap beschikbaar voor het trainen van je eigen modellen, evenals kant-en-klare getrainde modellen van standaard coders en generaties. Bijvoorbeeld, generators zijn verkrijgbaar voor het maken van afbeeldingen in Toonify-stijl, Pixar-personages, het maken van schetsen en zelfs voor het stylen als prinsessen uit Disney-animatiefilms.
Bron: opennet.ru
