

Onderzoek is waarschijnlijk het meest interessante onderdeel van onze opleiding. Het idee is om al tijdens je universitaire studie jezelf in de gekozen richting uit te proberen. Studenten van de richtingen Software Engineering en Machine Learning doen vaak onderzoek bij bedrijven (voornamelijk JetBrains of Yandex, maar niet alleen).
In deze post zal ik mijn project op het gebied van Computer Science bespreken. In het kader van dit werk heb ik de technieken bestudeerd en praktisch toegepast om een van de meest bekende NP-moeilijke problemen op te lossen: het probleem van de vertex cover.
Momenteel ontwikkelt zich een interessante benadering van NP-moeilijke problemen – geparametriseerde algoritmen. Ik zal proberen je op de hoogte te brengen, enkele simpele geparametriseerde algoritmen toelichten en één krachtige methode beschrijven die me enorm heeft geholpen. Mijn resultaten heb ik gepresenteerd tijdens de PACE Challenge: na de openbare tests staat mijn oplossing op de derde plaats, en de definitieve resultaten worden op 1 juli bekendgemaakt.
Over mij
Mijn naam is Vasily Alfyorov, en ik ben momenteel mijn derde jaar aan de Higher School of Economics – St. Petersburg aan het afronden. Ik ben al sinds mijn schooltijd geïnteresseerd in algoritmen, toen ik studeerde op de 179e school in Moskou en succesvol deelnam aan informatica-olympiades.
Een eindig aantal specialisten in geparametriseerde algoritmen komt een bar binnen...
Het voorbeeld is ontleend aan het boek
Stel je voor dat jij de barman bent in een klein stadje. Elke vrijdag komt de helft van de stad naar jouw bar om te ontspannen, wat je behoorlijk wat problemen bezorgt: je moet ruziemakers uit de bar zetten om vechtpartijen te voorkomen. Uiteindelijk wordt het je te veel en besluit je preventieve maatregelen te nemen.
Aangezien je in een klein stadje woont, weet je precies welke paren bezoekers met een grote kans zullen ruzieën als ze samen in de bar zijn. Je hebt een lijst van n personen die vanavond in de bar zullen komen. Je besluit om geen stadsgenoten binnen te laten op een manier zodat niemand gaat vechten. Tegelijkertijd wil je bazen geen winst laten verliezen en zullen ze ontevreden zijn als je meer dan k personen niet binnenlaat.
Helaas is de taak die voor je ligt een klassieke NP-moeilijke taak. Je zou het kunnen kennen als , of als een probleem van de topbedekking. Voor dergelijke problemen zijn in het algemeen geen algoritmes bekend die in een acceptabele tijd werken. Om precies te zijn, de ongegronde en vrij sterke hypothese ETH (Exponential Time Hypothesis) stelt dat dit probleem niet in  tijd kan worden opgelost, wat betekent dat er niets is dat opmerkelijk beter is dan volledige uitputting. Stel bijvoorbeeld dat er van plan is om n = 1000 mensen naar uw bar te komen. Dan zou volledige uitputting
 verzoeken opleveren, wat ongeveer
 is — belachelijk veel. Gelukkig heeft uw leidinggevende u een beperking opgelegd van k = 10, zodat het aantal combinaties dat u moet doorlopen veel kleiner is: het aantal deelverzamelingen van tien elementen is
 . Dat is al beter, maar het zal nog steeds niet in één dag worden geteld, zelfs niet op een krachtige cluster.
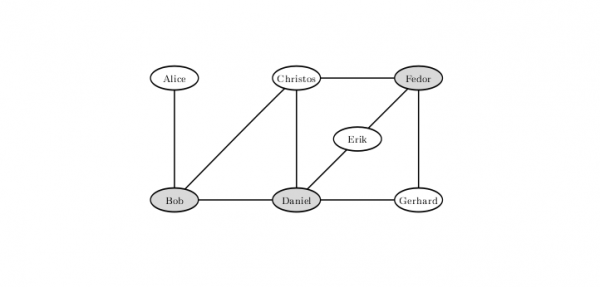
Om de kans op een vechtpartij met zo'n configuratie van gespannen relaties tussen de barbezoekers uit te sluiten, moeten Bob, Daniel en Fyodor niet worden toegelaten. Oplossingen waarbij maar twee mensen aan de kant blijven, bestaan niet.
Betekent dit dat het tijd is om op te geven en iedereen binnen te laten? Laten we andere opties overwegen. Bijvoorbeeld, we kunnen alleen de mensen niet toelaten die waarschijnlijk met een groot aantal anderen zullen vechten. Als iemand met minstens k + 1 andere mensen kan vechten, dan kan hij absoluut niet worden toegelaten — anders moet u alle k + 1 stadsbewoners die hij kan aanvallen, weigeren, wat de leidinggevenden zeker van streek zal maken.
Stel dat u iedereen heeft geweerd die u kon op basis van dit principe. Dan kunnen alle anderen met niet meer dan k mensen vechten. Door er k mensen uit te sluiten, kunt u niet meer dan  conflicten voorkomen. Dat betekent dat als er meer dan
 mensen bij ten minste één conflict betrokken zijn, u ze allemaal niet kunt voorkomen. Aangezien het voor de hand ligt dat u helemaal geen strijdige mensen zult binnenlaten, moet u alle deelverzamelingen van grootte tien uit tweehonderd mensen doorlopen. Dit zijn er ongeveer
 , en dat aantal operaties kan al op een cluster worden doorlopen.
Als het veilig is om volledig niet-conflictueuze personen binnen te laten, wat dan te zeggen van degenen die slechts in één conflict betrokken zijn? In feite kunnen ook zij worden toegelaten, door de deur voor hun tegenstander te sluiten. Inderdaad, als Alice alleen met Bob in conflict is, verliezen we niets door alleen Alice toe te laten: Bob kan andere conflicten hebben, maar Alice heeft er zeker geen. Het is bovendien zinloos om beiden niet toe te laten. Na zulke bewerkingen blijven er niet meer  gasten met een onopgeloste bestemming over: in totaal hebben we
 conflicten, met in elk geval twee deelnemers en elk van hen is in ieder geval in twee betrokken. Dus, we hoeven slechts
 mogelijkheden te verkennen, wat beslist als een halve dag op een laptop kan worden beschouwd.
In feite kunnen we met eenvoudige redeneringen nog aantrekkelijkere voorwaarden bereiken. Laten we opmerken dat we alle geschillen moeten oplossen, dat wil zeggen, uit elk conflictpaar tenminste één persoon moeten kiezen die we niet toelaten. Laten we een algoritme overwegen: we nemen een conflict en verwijderen een deelnemer en starten recursief met de rest, daarna verwijderen we de andere en starten ook recursief. Aangezien we bij elke stap iemand verwijderen, is de recursieboom van dit algoritme een binaire boom van diepte k, daarom werkt het algoritme in totaal in  , waar n — het aantal knopen, en m — het aantal randen. In ons voorbeeld zijn dat ongeveer tien miljoen, wat in een fractie van een seconde kan worden berekend, niet alleen op een laptop, maar zelfs op een mobiele telefoon.
Het bovenstaande voorbeeld is een voorbeeld van geparameteriseerde algoritme. Geparameteriseerde algoritmen zijn algoritmen die werken in de tijd f(k) poly(n), waar Het commando geeft een lijst van onze huidige partities weer. In mijn geval één partitie van 30 GB en nog 20 GB in vrije ruimte, als ik dat zo mag zeggen. — een polynoom, f — een willekeurige berekenbare functie, en k — een parameter, die waarschijnlijk veel kleiner zal zijn dan de grootte van de taak.
Alle redeneringen tot dit algoritme leiden tot een voorbeeld van kernelisatie — een van de algemene technieken voor het creëren van parameterized algoritmen. Kernalisatie is het verminderen van de taak tot een waarde die beperkt is door een functie van de parameter. De verkregen taak wordt vaak een kern genoemd. Zo hebben we, door eenvoudige redeneringen over de graden van de knopen, een kwadratische kern verkregen voor de Vertex Cover-taak, geparameteriseerd naar de grootte van het antwoord. Er zijn ook andere parameters die gekozen kunnen worden voor deze taak (bijvoorbeeld Vertex Cover Above LP), maar we zullen specifiek deze parameter bespreken.
Pace Challenge
Wedstrijd (The Parameterized Algorithms and Computational Experiments Challenge) werd in 2015 opgericht om een verband te leggen tussen parameterized algoritmen en de benaderingen die in de praktijk worden gebruikt om computationele problemen op te lossen. De eerste drie wedstrijden waren gewijd aan het zoeken naar de boomwijdte van een grafiek (), het zoeken naar de Steiner-boom () en het zoeken naar de feedback knoopenset (). Dit jaar was een van de taken waarin je je vaardigheden kon proberen, de hierboven beschreven probleem van de knoopbedekking.
De wedstrijd wint elk jaar aan populariteit. Als we de voorlopige gegevens mogen geloven, hebben dit jaar alleen al in de wedstrijd om de knoopbedekkingsprobleem 24 teams deelgenomen. Het is vermeldenswaard dat de wedstrijd niet enkele uren of zelfs niet een week duurt, maar meerdere maanden. De teams hebben de mogelijkheid om literatuur te bestuderen, een origineel idee te bedenken en te proberen het te realiseren. In wezen is deze wedstrijd een onderzoeksproject. De ideeën van de meest effectieve oplossingen en de prijsuitreiking voor de winnaars zullen plaatsvinden in combinatie met de conferentie (International Symposium on Parameterized and Exact Computation) tijdens de grootste jaarlijkse algoritmische bijeenkomst in Europa . Meer gedetailleerde informatie over de wedstrijd zelf is te vinden op , en de resultaten van voorgaande jaren zijn beschikbaar op .
Oplossingsschema
Om de probleem van de topbedekking aan te pakken, heb ik geprobeerd geparametriseerde algoritmes toe te passen. Deze bestaan doorgaans uit twee delen: vereenvoudigingsregels (die idealiter tot kernelisatie leiden) en splitsingsregels. Vereenvoudigingsregels zijn een preprocessing van de invoer in polynomiale tijd. Het doel van het toepassen van dergelijke regels is om het probleem te reduceren tot een equivalent probleem van kleinere omvang. Vereenvoudigingsregels zijn het meest kostbare deel van het algoritme, en de toepassing van dit deel leidt tot de totale looptijd  in plaats van eenvoudige polynomiale tijd. In ons geval zijn de splitsingsregels gebaseerd op het feit dat voor elke top we ofwel deze moeten nemen ofwel zijn buur.
Het algemene schema is als volgt: we passen de vereenvoudigingsregels toe, kiezen vervolgens een bepaalde top, en maken twee recursieve aanroepen: in de eerste nemen we deze als antwoord en in de tweede nemen we al zijn buren. Dit noemen we splitsen (branching) op deze top.
Aan dit schema zal precies één aanvulling worden toegevoegd in de volgende paragraaf.
Ideeën voor splitsingsregels (branching)
Laten we bespreken hoe we de top kiezen waarop de splitsing zal plaatsvinden.
Het basisidee is zeer hebzuchtig in algoritmisch opzicht: laten we de top met de maximale graad nemen en precies daar splitsen. Waarom lijkt het beter? Omdat we in de tweede vertakking van de recursieve aanroep op deze manier veel toppen zullen weghalen. We kunnen verwachten dat er een kleine graaf overblijft en dat we het daar snel mee doen.
Deze aanpak met de al besproken eenvoudige technieken van kernelisatie laat zich niet slecht zien, lost bepaalde tests op van enkele duizenden toppen. Maar bijvoorbeeld, werkt slecht voor kubieke grafen (dat wil zeggen grafen waarvan de graad van elke top gelijk is aan drie).
Er is nog een idee, gebaseerd op een vrij eenvoudige gedachte: als de graaf niet-verbonden is, kunnen we de taak voor zijn connectiviteitcomponenten onafhankelijk oplossen en de antwoorden aan het einde samenvoegen. Dit is, trouwens, de kleine beloofde modificatie in het schema, die de oplossing aanzienlijk zal versnellen: eerder werkten we in dat geval met het product van de tijden voor het tellen van de antwoorden van componenten, en nu werken we met de som. En om het branching te versnellen, moeten we de verbonden graaf omzetten in een niet-verbonden.
Hoe dit te doen? Als er een knooppunt in de grafiek is, moet je precies daar splitsen. Een knooppunt is een sommetje waarvan het verwijderen de samenhang van de grafiek verstoort. Je kunt alle knooppunten in de grafiek vinden met een klassieke algoritme in lineaire tijd. Deze aanpak versnelt het splitsen aanzienlijk.
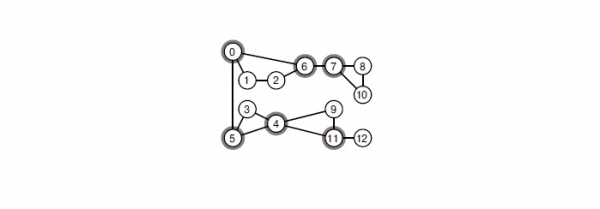
Bij het verwijderen van een van de gemarkeerde knooppunten zal de grafiek uiteenvallen in samenhangende componenten.
Dat gaan we doen, maar we willen meer. Bijvoorbeeld het zoeken naar kleine knoopdoorsnedes in de grafiek en het splitsen volgens de knopen daarin. De meest effectieve manier die ik ken om de minimale globale knoopdoorsnede te vinden, is door gebruik te maken van de Gomory-Hu boom, die in kubieke tijd wordt opgebouwd. In de PACE Challenge is de typische grootte van de grafiek enkele duizenden knopen. In dat geval moeten er miljarden operaties in elke knoop van de recursieboom worden uitgevoerd. Daarom is het simpelweg onmogelijk om het probleem binnen de gegeven tijd op te lossen.
Laten we proberen de oplossing te optimaliseren. De minimale knoopdoorsnede tussen een paar knopen kan worden gevonden met elk algoritme dat de maximale stroom opbouwt. Je kunt zo'n netwerk aanstellen met de , in de praktijk werkt het erg snel. Ik heb het vermoeden dat je theoretisch een schatting kunt geven van de looptijd  , wat al vrij aanvaardbaar is.
Ik heb verschillende keren geprobeerd doorsneden tussen paren van willekeurige knopen te zoeken en de meest gebalanceerde te nemen. Helaas gaf dit slechte resultaten op de openbare testen van de PACE Challenge. Ik vergeleek het met het algoritme dat zich op knopen met de hoogste graad richtte, met een beperking op de diepte van de afdalingen. Na het algoritme dat probeerde de doorsneden op deze manier te vinden, bleven er grotere grafieken over. Dit is te wijten aan het feit dat de doorsneden zeer ongebalanceerd waren: door 5-10 knopen te verwijderen, kon je slechts 15-20 afsplitsen.
Het is belangrijk op te merken dat in artikelen over theoretisch de snelste algoritmes veel geavanceerdere technieken worden gebruikt voor de selectie van knopen voor splitsing. Deze technieken hebben vaak een zeer complexe implementatie en doorgaans slechte schattingen wat betreft tijd en geheugen. Het is me niet gelukt om acceptabele implementaties uit deze technieken te destilleren.
Hoe de vereenvoudigingsregels toe te passen
We hebben al ideeën voor kernelisatie. Ter herinnering:
- Als er een geïsoleerd knoopje is, verwijder het dan.
- Als er een knoop van graad 1 is, verwijder deze en neem de buur in antwoord.
- Als er een knoop van graad ten minste is, k + 1nemen we deze als antwoord.
Met de eerste twee is alles duidelijk, maar met de derde is er een trucje. Als in de grap over de bar ons een bovengrens werd gegeven voor k, dan moeten we in de PACE Challenge gewoon een topdekking van minimale grootte vinden. Dit is een typische transformatie van zoekproblemen naar beslissingsproblemen, vaak wordt er tussen deze twee soorten problemen geen onderscheid gemaakt. In de praktijk, als we een oplosser voor het probleem van een topdekking schrijven, kan het verschil maken. Bijvoorbeeld, zoals in het derde punt.
Vanuit het oogpunt van implementatie zijn er twee manieren. De eerste aanpak wordt Iterative Deepening genoemd. Het bestaat uit het volgende: we kunnen beginnen met een redelijke ondergrens voor het antwoord, en daarna ons algoritme starten met deze ondergrens als bovengrens voor het antwoord, zonder dieper in de recursie te gaan dan deze ondergrens. Als we een antwoord vinden, is het gegarandeerd optimaal, anders kunnen we deze ondergrens met één verhogen en opnieuw starten.
De andere aanpak is het opslaan van een huidige optimale oplossing en het zoeken naar een oplossing van kleinere grootte, waarbij dit parameter wordt gewijzigd bij het vinden. k voor een grotere afsnijding van onnodige takken in de zoektocht.
Na meerdere nachtelijke experimenten ben ik geëindigd met een combinatie van deze twee methoden: eerst start ik mijn algoritme met een bepaalde zoekdieptebeperking (deze zo te kiezen dat het een verwaarloosbare tijd in beslag neemt in vergelijking met de hoofdoplossing) en gebruik de beste gevonden oplossing als bovengrens voor het antwoord - dat wil zeggen diezelfde k.
Knopen van graad 2
We hebben het gehad over knopen van graad 0 en 1. Het blijkt dat dit ook kan voor knopen van graad 2, maar hiervoor zijn complexere operaties op de grafiek vereist.
Om dit uit te leggen, moeten we de knopen op de een of andere manier aanduiden. Laten we een knoop van graad 2 als knoop vnoemen, en zijn buren als knopen x en y. Verder hebben we twee gevallen.
- Wanneer x en y — buren. Dan kunnen we als antwoord nemen x en y, met behulp van 1 bit, gelijk aan 0, v verwijderen. Inderdaad, uit deze driehoek moeten we minstens twee knopen als antwoord nemen en we verliezen zeker niet als we x en y: zij hebben waarschijnlijk nog buren, terwijl v zij geen hebben.
- Wanneer x en y — geen buren. Dan wordt gesteld dat alle drie de toppen in één kunnen worden samengevoegd. Het idee is dat er in dat geval een optimale oplossing is, waarin we ofwel v, of beide toppen x en y. In het eerste geval moeten we alle buren als antwoord nemen x en y, terwijl dat in het tweede geval niet noodzakelijk is. Dit komt precies overeen met de gevallen waarin we de samengevoegde top niet in het antwoord opnemen en wanneer we dat wel doen. We moeten alleen opvallen dat in beide gevallen het antwoord door zo'n operatie met één eenheid afneemt.
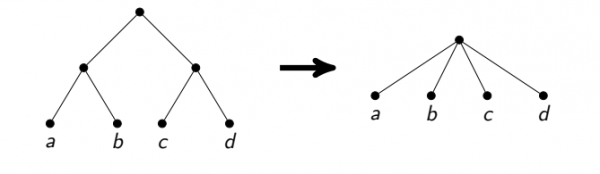
Het is opmerkelijks dat zo'n benadering in eerlijke lineaire tijd behoorlijk moeilijk nauwkeurig te implementeren is. Het samenvoegen van toppen is een complexe operatie, waarbij lijsten van buren moeten worden gekopieerd. Als dit niet nauwkeurig gebeurt, kan dat asymptotisch suboptimale tijdscomplexiteit opleveren (bijvoorbeeld als na elke samenvoeging veel randen worden gekopieerd). Ik heb me gericht op het vinden van volledige paden van toppen van graad 2 en het analyseren van een aantal bijzondere gevallen, zoals lussen van dergelijke toppen of van alle dergelijke toppen behalve één.
Bovendien moet deze operatie omkeerbaar zijn, zodat we bij het terugkeren uit de recursie de graaf in de oorspronkelijke staat kunnen herstellen. Om dit te waarborgen heb ik de lijsten van randen van samengevoegde toppen niet gewist, waarna ik gewoon wist welke randen waarheen moesten worden geleid. Deze implementatie van grafen vereist ook zorgvuldigheid, maar zorgt wel voor eerlijke lineaire tijd. En voor grafen met meerdere tienduizenden randen past het prima in de cache van de processor, wat aanzienlijke snelheidsvoordelen oplevert.
Lineaire kern
Tenslotte, het meest interessante deel van de kern.
Laten we in eerste instantie herinneren dat in bipartiete grafen de minimale topdekking kan worden gezocht in  . Hiervoor moet gebruik worden gemaakt van het algoritme om het maximale paarmatching daar te vinden, en dan de stelling te gebruiken .
Het idee van de lineaire kern is als volgt: laten we eerst de graaf splitsen, dat is in plaats van elke top v gaan we twee toppen invoeren  en
 , en in plaats van elke rand u — v introduceren we twee randen
 en
 De verkregen graaf zal bipartiet zijn. Laten we de minimale hoeksteen erin vinden. Sommige knopen van de oorspronkelijke graaf zullen erin twee keer voorkomen, sommige slechts één keer, en sommige helemaal niet. De stelling van Nemhauser-Trotter stelt dat in dat geval knopen die helemaal niet zijn gekozen kunnen worden verwijderd, en dat de knopen die twee keer zijn gekozen in de oplossing moeten worden opgenomen. Bovendien zegt het dat van de overgebleven knopen (degenen die eenmaal zijn gekozen) minstens de helft in de oplossing moet komen.
We hebben zojuist geleerd om niet meer dan 2k knopen in de graaf te laten. En dat klopt, als de oplossing in de rest ten minste de helft van alle knopen bevat, zijn er in totaal niet meer dan 2k.
Hier heb ik een kleine stap vooruit gezet. Het is duidelijk dat de op deze manier gemaakte kern afhangt van welke minimale hoeksteen we hebben gekozen in de bipartiete graaf. We willen er een kiezen zodat het aantal overgebleven knopen minimaal is. Eerder kon dit alleen worden gedaan in een tijd van  . Ik heb echter een implementatie van dit algoritme ontwikkeld in een tijd van
 , zodat deze kern in grafen met honderdduizenden knopen op elk niveau van branching kan worden gezocht.
Resultaat
De praktijk toont aan dat mijn oplossing goed werkt op tests met enkele honderden knopen en duizenden ribben. Bij zulke tests is het redelijk om te verwachten dat de oplossing binnen een half uur wordt gevonden. De kans om een oplossing binnen een acceptabele tijd te vinden, neemt in principe toe als de graaf voldoende knopen van hoge graad bevat, bijvoorbeeld van graad 10 of hoger.
Voor deelname aan de competitie moesten de oplossingen worden ingediend op . Blijkens de tabel die daar wordt gepresenteerd, De resultaten op de gesloten tests worden bekendgemaakt op 1 juli.
Wetenschappelijk onderzoek is wellicht het meest interessante deel van onze opleiding. Het idee is om tijdens de universiteit te proberen jezelf in de gekozen richting uit te proberen.
Bron: habr.com
