

Het artikel van het Stitch Fix-team stelt voor om een benadering van klinische onderzoeken van gelijke effectiviteit (non-inferiority trials) te gebruiken in marketing- en product A/B-tests. Deze aanpak is inderdaad toepasbaar wanneer we een nieuwe oplossing testen die voordelen heeft die niet meetbaar zijn met tests.
Het eenvoudigste voorbeeld is het verlagen van kosten. We automatiseren bijvoorbeeld het proces van het plannen van de eerste les, maar willen de algehele conversie niet verlagen. Of we testen wijzigingen die gericht zijn op één gebruikerssegment, terwijl we ervoor zorgen dat de conversies voor andere segmenten niet significant dalen (bij het testen van meerdere hypotheses vergeten we niet over aanpassingen).
Het kiezen van de juiste drempelwaarde voor gelijke effectiviteit voegt extra moeilijkheden toe in de ontwerpfase van de test. De vraag hoe Δ gekozen moet worden, wordt in het artikel niet goed behandeld. Het lijkt erop dat deze keuze niet volledig transparant is, zelfs niet in klinische studies. Medische publicaties over non-inferiority geven aan dat in slechts de helft van de publicaties de keuze van de drempel goed wordt onderbouwd, en vaak zijn deze onderbouwingen onsamenhangend of niet gedetailleerd.
Hoe dan ook, deze benadering lijkt interessant, omdat deze door het verkleinen van de benodigde steekproefgrootte de testversnelling kan verhogen, en dus de snelheid van besluitvorming. Darya Mukhina, productanalist van de mobiele applicatie Skyeng.
Het Stitch Fix-team houdt ervan om verschillende dingen te testen. De technologische gemeenschap houdt in principe van het uitvoeren van tests. Welke versie van de site trekt meer gebruikers aan - A of B? Levert versie A van het aanbevelingsmodel meer geld op dan versie B? Bijna altijd gebruiken we de eenvoudigste aanpak uit de basis statistiek om hypothesen te verifiëren:
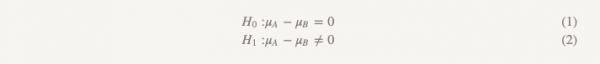
Hoewel we deze term zelden gebruiken, wordt deze vorm van testen 'hypothese over superioriteit testen' genoemd. Bij deze benadering gaan we ervan uit dat er geen verschil is tussen de twee opties. We houden ons aan dit idee en verwerpen het alleen als de verkregen gegevens voldoende overtuigend zijn – dat wil zeggen, als ze aantonen dat een van de opties (A of B) beter is dan de andere.
Hypothese testen over superioriteit is geschikt voor het oplossen van veel problemen. We brengen versie B van het aanbevelingsmodel uit alleen als deze duidelijk beter is dan de momenteel gebruikte versie A. Maar in sommige gevallen werkt deze aanpak niet zo goed. Laten we enkele voorbeelden bekijken.
1) We gebruiken een externe service, die helpt bij het identificeren van vervalsingen van bankkaarten. We hebben een andere service gevonden die aanzienlijk goedkoper is. Als de goedkopere service even goed werkt als de huidige, kiezen we die. Deze hoeft niet per se beter te zijn dan de gebruikte service.
2) We willen de databasissource A vervangen door databron B. We zouden de afschakeling van A kunnen uitstellen als B slechte resultaten oplevert, maar het is niet mogelijk om A te blijven gebruiken.
3) We willen overstappen van de modelaanpakA naar aanpak B, niet omdat we betere resultaten van B verwachten, maar omdat het ons meer operationele flexibiliteit biedt. We hebben geen reden om aan te nemen dat B slechter zal zijn, maar we zullen de overstap niet maken als dat wel zo is.
4) We hebben enkele kwalitatieve wijzigingen aangebracht in het ontwerp van de website (versie B) en geloven dat deze versie superieur is aan versie A. We verwachten geen veranderingen in conversie of enige belangrijke prestatie-indicatoren die we normaal gebruiken om de website te evalueren. Maar we geloven dat er voordelen zijn op gebieden die ofwel niet meetbaar zijn, of waarvoor onze technologieën niet adequaat zijn om te meten.
In al deze gevallen is onderzoek naar superioriteit niet de meest geschikte oplossing. Maar de meeste specialisten gebruiken het in dergelijke situaties standaard. We voeren experimenten zorgvuldig uit om de grootte van het effect correct vast te stellen. Als het waar zou zijn dat de versies A en B op een zeer vergelijkbare manier werken, is de kans groot dat we de nulhypothese niet kunnen verwerpen. Trekken we de conclusie dat A en B in het algemeen gelijk werken? Nee! Het niet kunnen verwerpen van de nulhypothese en het aannemen van de nulhypothese zijn niet hetzelfde.
Berekeningen van de steekproefgrootte (die u natuurlijk heeft uitgevoerd), worden doorgaans gedaan met strengere drempels voor de eerste soort fout (de kans op een onterecht verwerpen van de nulhypothese, vaak alfa genoemd) dan voor de tweede soort fout (de kans om de nulhypothese niet te verwerpen, gegeven dat de nulhypothese onjuist is, vaak bèta genoemd). Een typische waarde voor alfa is 0,05, terwijl een typische waarde voor bèta 0,20 is, wat overeenkomt met een statistische kracht van 0,80. Dit betekent dat we een werkelijke impact van de grootte, die we in onze krachtberekeningen hebben aangegeven, met een waarschijnlijkheid van 20% kunnen missen, wat een aanzienlijke informatiekloof vormt. Als voorbeeld overweeg de volgende hypothesen:
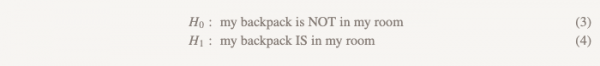
H0: mijn rugzak is NIET in mijn kamer (3)
H1: mijn rugzak is in mijn kamer (4)
Als ik mijn kamer heb doorzocht en mijn rugzak heb gevonden — geweldig, ik kan de nulhypothese verwerpen. Maar als ik de kamer heb doorzocht en mijn rugzak niet heb kunnen vinden (figuur 1), welke conclusie moet ik dan trekken? Ben ik er zeker van dat hij daar niet is? Heb ik wel grondig genoeg gezocht? Wat als ik slechts 80% van de kamer heb doorzocht? De conclusie trekken dat de rugzak daar zeker niet in de kamer is, zou een overhaaste beslissing zijn. Het is niet verrassend dat we de 'nulhypothese niet kunnen accepteren'.
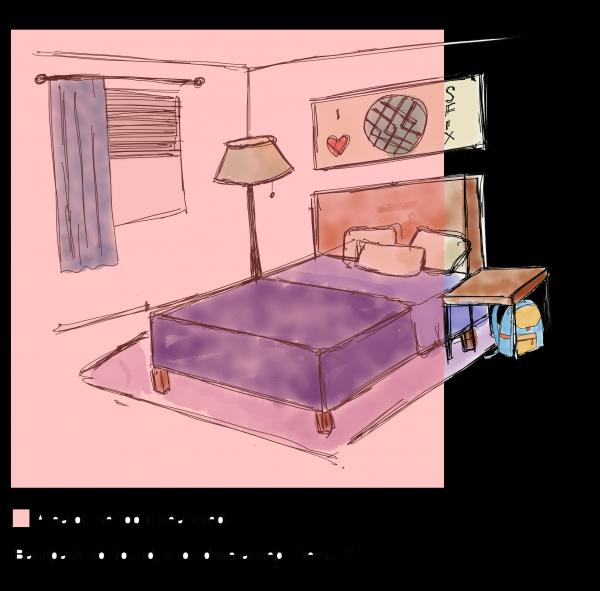
Het gebied dat we hebben doorzocht
We hebben de rugzak niet gevonden — moeten we de nulhypothese accepteren?
Figuur 1. Het doorzoeken van 80% van de kamer is ongeveer hetzelfde als het uitvoeren van een onderzoek met een kracht van 80%. Als u de rugzak niet heeft gevonden na het doorzoeken van 80% van de kamer, kunt u dan concluderen dat hij daar niet is?
Wat moet een data-expert in deze situatie doen? U kunt de kracht van het onderzoek sterk verhogen, maar dan heeft u een veel grotere steekproef nodig, en het resultaat zal nog steeds onbevredigend zijn.
Gelukkig worden dergelijke problemen al lang bestudeerd in de wereld van klinisch onderzoek. Medicijn B is goedkoper dan medicijn A; er wordt verwacht dat medicijn B minder bijwerkingen zal veroorzaken dan medicijn A; medicijn B is gemakkelijker te transporteren omdat het niet in de koelkast bewaard hoeft te worden, terwijl medicijn A dat wel moet. Laten we de hypothese van niet minder effectiviteit testen. Dit is nodig om te laten zien dat versie B net zo goed is als versie A — althans binnen een vooraf bepaald bereik van 'niet minder effectiviteit', Δ. Later zullen we uitgebreider bespreken hoe we deze grens kunnen stellen. Maar laten we nu aannemen dat het de minimale relevant verschil is dat praktisch betekenisvol is (in de context van klinische proeven wordt dit meestal klinische significantie genoemd).
Hypothesen over niet minder effectiviteit draaien alles om:
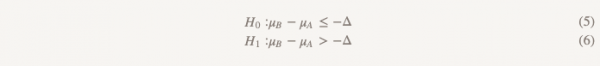
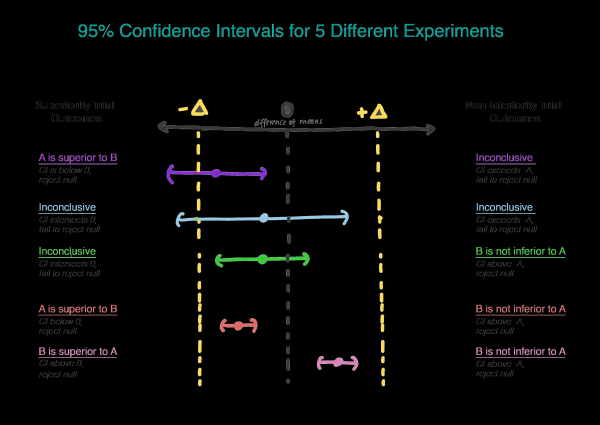
Nu veronderstellen we in plaats van dat er geen verschil is, dat versie B slechter is dan versie A, en we zullen deze veronderstelling aanhouden totdat we het tegendeel aantonen. Dit is precies het moment waarop het zinvol is om een eenzijdige hypothesetest te gebruiken! In de praktijk kan dit gedaan worden door een betrouwbaarheidsinterval te construeren en te bepalen of het interval werkelijk groter is dan Δ (zie Figuur 2).
Keuze van Δ
Hoe kies je Δ correct? Het proces van het kiezen van Δ omvat statistische onderbouwing en onderwerpelijke beoordeling. In de wereld van klinisch onderzoek zijn er richtlijnen die aangeven dat delta het kleinste klinisch significante verschil moet vertegenwoordigen — iets dat praktisch relevant zal zijn. Hier is een citaat uit de Europese richtlijnen om je zelf te toetsen: 'Als het verschil correct is gekozen, is het betrouwbaarheidsinterval dat volledig tussen –∆ en 0 ligt..., nog steeds voldoende om niet minder effectiviteit te demonstreren. Als dit resultaat niet acceptabel lijkt, betekent dit dat ∆ niet correct is gekozen.'
De delta mag zeker niet groter zijn dan de effectgrootte van versie A in verhouding tot de ware controle (placebo / geen behandeling), aangezien dit ons leidt naar de conclusie dat versie B slechter is dan de ware controle, terwijl het tegelijkertijd 'niet minder effectief' vertoont. Laten we aannemen dat toen versie A werd geïntroduceerd, er versie 0 was of de functie helemaal niet bestond (zie figuur 3).
Bij de evaluatie van de hypothese over superioriteit werd een effectgrootte E vastgesteld (d.w.z. verondersteld μ^A−μ^0=E). Nu is A onze nieuwe standaard, en we willen ervoor zorgen dat B niet inferieur is aan A. Een andere manier om te schrijven is μB−μA≤−Δ (de nulhypothese) — μB≤μA−Δ. Als we aannemen dat dit gelijk is aan of groter is dan E, dan geldt μB ≤ μA−E ≤ placebo. Nu zien we dat onze schatting voor μB volledig hoger is dan μA−E, wat de nulhypothese volledig weerlegt en ons in staat stelt de conclusie te trekken dat B niet inferieur is aan A, maar tegelijkertijd μB kan ≤ μ placebo zijn, wat niet is wat we willen. (figuur 3).
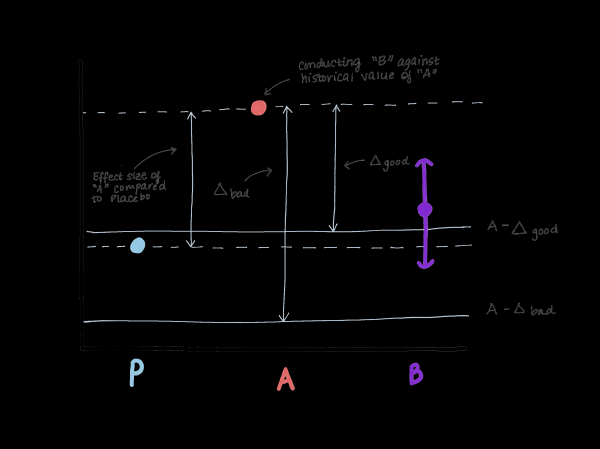
Figuur 3. Demonstratie van de risico's van het kiezen van de grens voor niet-minder effectiviteit. Als de grens te hoog is, kan worden geconcludeerd dat B niet inferieur is aan A, maar tegelijkertijd niet te onderscheiden is van placebo. We zullen een medicijn dat duidelijk effectiever is dan placebo (A) niet vervangen door een medicijn dat net zo effectief is als placebo.
Kies α
Laten we overgaan naar de keuze van α. Standaardwaarde α = 0,05 kan worden gebruikt, maar dat is niet helemaal eerlijk. Bijvoorbeeld wanneer u iets online koopt en tegelijkertijd meerdere kortingscodes gebruikt, hoewel ze niet bij elkaar mogen worden opgeteld — de ontwikkelaar heeft gewoon een fout gemaakt en het kwam u ten goede. Volgens de regels moet de waarde van α de helft zijn van de waarde van α die wordt gebruikt bij de evaluatie van de hypothese over superioriteit, dat wil zeggen 0,05 / 2 = 0,025.
Steekproefgrootte
Hoe bereken je de steekproefgrootte? Als je denkt dat het werkelijke verschil in gemiddelden tussen A en B 0 is, dan is de berekening van de steekproefgrootte dezelfde als bij de evaluatie van de hypothese over superioriteit, met uitzondering van het feit dat je de effectgrootte vervangt door de grens voor niet-minder effectiviteit, op voorwaarde dat je gebruikt α niet minder effectiviteit = 1 / 2α superioriteit (αnon-inferiority=1/2αsuperiority). Als u redenen heeft om aan te nemen dat optie B iets slechter kan zijn dan optie A, maar u wilt bewijzen dat het niet slechter is dan Δ, dan heeft u geluk! In feite vermindert dit de steekproefgrootte, omdat het gemakkelijker is aan te tonen dat B slechter is dan A als u daadwerkelijk gelooft dat het iets slechter is en niet gelijkwaardig.
Voorbeeld met oplossing
Stel dat u wilt overstappen naar versie B, met de voorwaarde dat het niet slechter is dan versie A met meer dan 0,1 punt op een schaal van 5 voor klanttevredenheid… Laten we deze taak aanpakken met de hypothese van superioriteit.
Om de hypothese van superioriteit te testen, zouden we de steekproefgrootte als volgt berekenen:
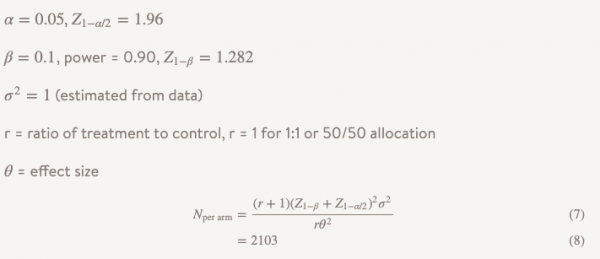
Dat wil zeggen, als u 2103 observaties in uw groep heeft, kunt u er zeker van zijn dat u met 90% zekerheid een effect van 0,10 of groter zult ontdekken. Maar als 0,10 te groot voor u is, is het misschien niet de moeite waard om de hypothese van superioriteit te testen. Misschien besluit u voor betrouwbaarheid een studie uit te voeren voor een kleiner effect, zoals 0,05. In dat geval heeft u 8407 observaties nodig, wat betekent dat de steekproef bijna 4 keer groter wordt. Maar wat als we vasthouden aan onze oorspronkelijke steekproefgrootte, maar de power verhogen naar 0,99, zodat we er zeker van zijn dat we een positief resultaat krijgen? In dat geval zou n voor één groep 3676 bedragen, wat al beter is, maar de steekproefgrootte met meer dan 50% verhoogt. En als gevolg daarvan kunnen we nog steeds de nulhypothese gewoon niet weerleggen en krijgen we geen antwoord op onze vraag.
Wat als we in plaats daarvan de hypothese van niet-minder effectiviteit testen?
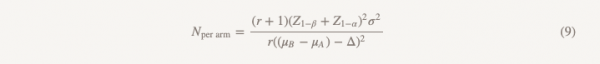
De steekproefgrootte zou volgens dezelfde formule worden berekend, met uitzondering van de noemer.
De verschillen met de formule die wordt gebruikt bij het testen van de hypothese van superioriteit zijn als volgt:
— Z1−α/2 wordt vervangen door Z1−α, maar als u alles goed doet, vervangt u α = 0,05 door α = 0,025, wat betekent dat dit hetzelfde getal is (1,96)
— er verschijnt (μB−μA) in de noemer
— θ (effectgrootte) wordt vervangen door Δ (drempel voor niet-minder effectiviteit)
Als we aannemen dat µB = µA, dan is (µB − µA) = 0 en de berekening van de steekproefgrootte voor een niet lagere effectiviteit is precies wat we zouden krijgen bij het berekenen van het overwicht voor een effectgrootte van 0,1, geweldig! We kunnen een studie van dezelfde omvang uitvoeren met verschillende hypothesen en een andere benadering van de conclusies, en we zullen een antwoord krijgen op de vraag die we echt willen beantwoorden.
Laten we nu aannemen dat we eigenlijk niet denken dat µB = µA en
denken dat µB iets slechter is, misschien met 0,01 eenheden. Dit verhoogt onze noemer, waardoor de steekproefgrootte voor de groep tot 1737 afneemt.
Wat gebeurt er als versie B eigenlijk beter is dan versie A? We verwerpen de nulhypothese dat B slechter is dan A met meer dan Δ en nemen de alternatieve hypothese aan dat B als het slechter is, niet slechter is dan Δ en misschien beter. Probeer deze conclusie op te nemen in een crossfunctionele presentatie en kijk wat eruit komt (serieus, probeer het). In een situatie waarin je op perspectief moet navigeren, wil niemand instemmen met ‘slechter niet meer dan Δ en misschien beter’.
In dit geval kunnen we een studie uitvoeren die heel kort ‘hypothese testen dat een van de opties beter is dan de andere of slechter’ wordt genoemd. Dit maakt gebruik van twee sets hypothesen:
De eerste set (dezelfde als bij het testen van de hypothese van niet lagere effectiviteit):
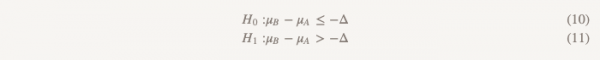
De tweede set (dezelfde als bij het testen van de hypothese van overwicht):
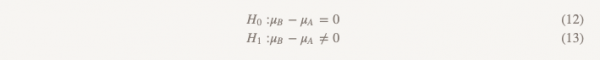
We testen de tweede hypothese alleen als de eerste verworpen is. Bij sequentieel testen behouden we het totale niveau van type I-fouten (α). In de praktijk kan dit worden bereikt door een 95% betrouwbaarheidsinterval voor het verschil tussen gemiddelden te creëren en te controleren of het hele interval -Δ overschrijdt. Als het interval niet boven -Δ uitkomt, kunnen we de nulhypothese niet verwerpen en stoppen we. Als het hele interval daadwerkelijk meer dan -Δ overschrijdt, gaan we door en kijken we of het interval 0 bevat.
Er is nog een ander type onderzoek dat we niet hebben besproken – equivalentieonderzoek.
Onderzoek van dit type kan worden vervangen door onderzoek ter verificatie van de hypothese van gelijke effectiviteit en vice versa, maar er is een belangrijk onderscheid. Een test ter verificatie van de hypothese van gelijke effectiviteit is bedoeld om aan te tonen dat optie B minstens zo goed is als A. Een équivalentiestudie is daarentegen gericht op het aantonen dat optie B minstens zo goed is als A, en dat optie A even goed is als B, wat complexer is. In wezen proberen we vast te stellen of het hele betrouwbaarheidsinterval voor het gemiddelde verschil tussen -Δ en Δ ligt. Dergelijke studies vereisen een grotere steekproefomvang en worden minder vaak uitgevoerd. Dus de volgende keer dat je een studie uitvoert waarbij jouw belangrijkste doel is om te bevestigen dat de nieuwe versie niet slechter is, ga dan niet akkoord met 'de onmogelijkheid om de nulhypothese te weerleggen'. Als je een echt belangrijke hypothese wilt testen, overweeg dan verschillende opties.
Bron: habr.com
