

Recentelijk is er een , die een goede trend laat zien in de machine learning van de afgelopen jaren. Kort samengevat: het aantal startups op het gebied van machine learning is de afgelopen twee jaar sterk gedaald.
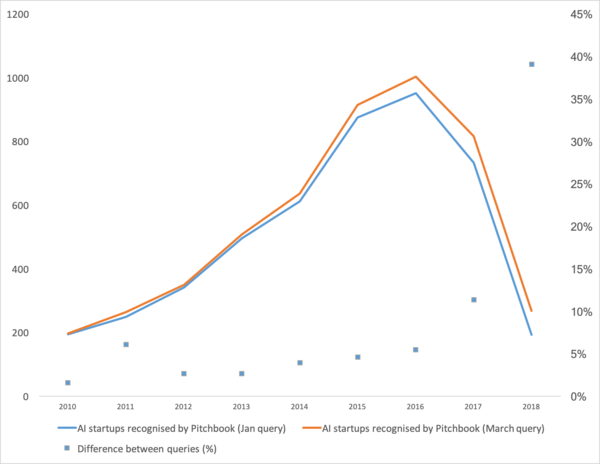
Laten we beginnen met de vraag of de 'bubbel heeft geknapt', 'hoe we verder moeten' en waar dergelijke onduidelijkheid vandaan komt.
Laten we eerst bespreken wat de drijfveer was achter deze curve. Waar kwam deze vandaan? Iedereen zal zich waarschijnlijk de van machine learning in 2012 op de ImageNet-competitie herinneren. Dat was immers het eerste wereldwijde evenement! Maar in werkelijkheid is het niet zo. Ook begon de groei van de curve iets eerder. Ik zou het in verschillende momenten opdelen.
- In 2008 werd de term 'big data' geïntroduceerd. Echte producten begonnen vanaf 2010. Big data zijn nauw verbonden met machine learning. Zonder big data is een stabiele werking van de algoritmen die op dat moment bestonden, onmogelijk. En dit zijn geen neurale netwerken. Tot 2012 waren neurale netwerken het domein van een marginaal minderheid. Maar toen begonnen totaal andere algoritmen te werken die al jaren, zo niet tientallen jaren, bestonden: (1963, 1993), (1995), (2003),... De startups uit die jaren waren in de eerste plaats gerelateerd aan de automatische verwerking van gestructureerde gegevens: kassa's, gebruikers, advertenties, en nog veel meer.
De afgeleide van deze eerste golf is een reeks frameworks, zoals XGBoost, CatBoost, LightGBM, enzovoort.
- In 2011-2012 verschillende wedstrijden in beeldherkenning. Het echte gebruik liet echter iets langer op zich wachten. Ik zou zeggen dat de eerst echt relevante startups en oplossingen vanaf 2014 begonnen te verschijnen. Twee jaar waren nodig om te begrijpen dat neurale netwerken daadwerkelijk werkten, gebruiksvriendelijke frameworks te ontwikkelen die je snel kon opzetten en draaien, en methodes te ontwikkelen die de stabiliteit en snelheid van de convergentie verbeterden.
Convolutionele netwerken maakten het mogelijk om machine vision-taken op te lossen: classificatie van afbeeldingen en objecten op afbeeldingen, objectdetectie, herkenning van objecten en mensen, verbetering van afbeeldingen, enzovoorts.
- 2015-2017. De boom van algoritmen en projecten die afhankelijk zijn van recurrente netwerken of hun analogen (LSTM, GRU, TransformerNet, enz.). Effectieve algoritmen voor 'spraak-naar-tekst' en systemen voor machinevertaling zijn ontstaan. Deels gebaseerd op convolutionele netwerken om basisfeatures te extraheren. Deels omdat we echte grote en hoogwaardige datasets hebben leren verzamelen.
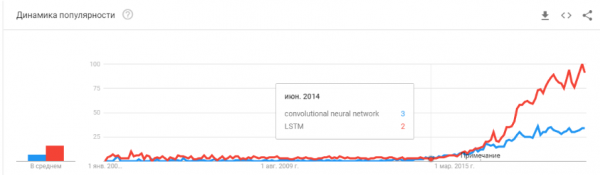
Is de bubbel gebarsten? Is de hype oververhit? Zijn ze dood zoals blockchain?
Precies! Morgen werkt Siri niet meer op je telefoon, en de dag daarna kan Tesla geen bocht meer van een kangaroe onderscheiden.
Neurale netwerken zijn al in gebruik. Ze zijn in tientallen apparaten aanwezig. Ze maken het mogelijk om echt geld te verdienen, veranderen de markt en de wereld om ons heen. De hype ziet er iets anders uit:
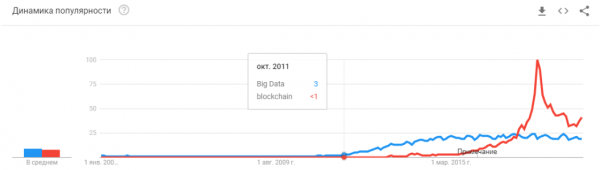
Neurale netwerken zijn gewoon niet meer iets nieuws. Ja, veel mensen hebben te hoge verwachtingen. Maar een groot aantal bedrijven heeft leren toepassen wat neurale netwerken zijn en producten op basis daarvan ontwikkelen. Neurale netwerken bieden nieuwe functionaliteiten, verminderen banen, verlagen de kosten van diensten:
- Productiebedrijven integreren algoritmen voor het analyseren van defecten op de productielijn.
- Dierlijke bedrijven kopen systemen voor het controleren van koeien.
- Autonome oogstmachines.
- Geautomatiseerde callcenters.
- Filters in SnapChat. (nou, tenminste iets nuttigs!)
Maar het belangrijkste, en niet het meest voor de hand liggende: "Er zijn geen nieuwe ideeën meer, of ze zullen geen onmiddellijke winst opleveren." Neurale netwerken hebben tientallen problemen opgelost. En ze zullen er nog veel meer oplossen. Alle voor de hand liggende ideeën die er waren, hebben talloze startups voortgebracht. Maar alles wat voor de hand lag, is al benut. In de afgelopen twee jaar ben ik geen enkel nieuw idee voor het gebruik van neurale netwerken tegengekomen. Geen nieuwe benadering (nou, goed, er zijn wat verwikkelingen met GAN's).
En elke volgende startup wordt alleen maar ingewikkelder. Het vereist al niet meer twee jongens die een neuraal netwerk trainen met open data. Het vereist programmeurs, servers, een team van annotatoren, complexe ondersteuning, enz.
Het resultaat is dat er minder startups komen. Maar er is meer productie. Wil je nummerplaatherkenning implementeren? Er zijn honderden specialisten op de markt met relevante ervaring. Je kunt iemand inhuren en in slechts enkele maanden zal jouw medewerker een systeem maken. Of koop een kant-en-klaar systeem. Maar een nieuwe startup starten?.. Onzin!
Je hebt een systeem voor het volgen van bezoekers nodig - waarom betalen voor talloze licenties als je in 3-4 maanden je eigen systeem kunt maken, speciaal voor jouw bedrijf?
Neuro-netwerken doorlopen momenteel hetzelfde pad als tientallen andere technologieën.
Herinner je je hoe het begrip 'websiteontwikkelaar' is veranderd sinds 1995? De markt is nog niet verzadigd met specialisten. Er zijn heel weinig professionals. Maar ik durf te wedden dat over 5-10 jaar er weinig verschil zal zijn tussen een Java-programmeur en een ontwikkelaar van neuro-netwerken. Beide soorten specialisten zullen in overvloed op de markt zijn.
Er zal gewoon een type taak zijn waarvoor neuro-netwerken worden ingezet. Er is een probleem ontstaan - je huurt een specialist in.
"En wat nu? Waar is de beloofde kunstmatige intelligentie?"
Hier is er echter een klein, maar interessante onduidelijkheid:)
De technologische stack die we vandaag de dag hebben, zal ons vermoedelijk niet leiden naar kunstmatige intelligentie. Ideeën en hun nieuwheid zijn vrijwel uitgeput. Laten we het hebben over wat het huidige niveau van ontwikkeling in stand houdt.
Beperkingen
Laten we beginnen met zelfrijdende auto's. Het lijkt duidelijk dat het mogelijk is om volledig autonome voertuigen te maken met de huidige technologieën. Maar hoe lang zal het duren voordat dit gebeurt - dat is onduidelijk. Tesla denkt dat dit binnen een paar jaar zal plaatsvinden -
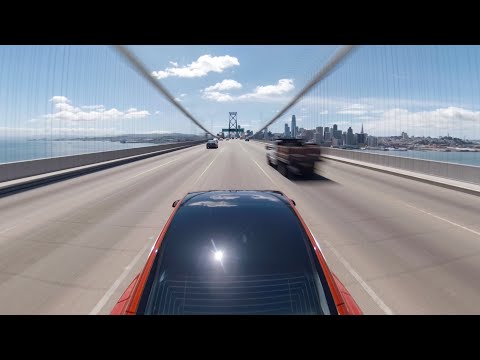
Er zijn veel andere , die dit als 5-10 jaar inschatten.
Waarschijnlijk, naar mijn mening, zal over ongeveer 15 jaar de infrastructuur van de steden zelf zo veranderen dat de komst van autonome voertuigen onvermijdelijk zal worden, het zal een voortzetting ervan zijn. Maar dat kan je geen intelligentie noemen. De moderne Tesla is een zeer complexe conveyor voor gegevensfiltering, searching en hertraining. Dit zijn regels-regels-regels, gegevensverzameling en filters daarover (hierover heb ik iets gedetailleerder geschreven, of kijk met de markering).
Het eerste probleem
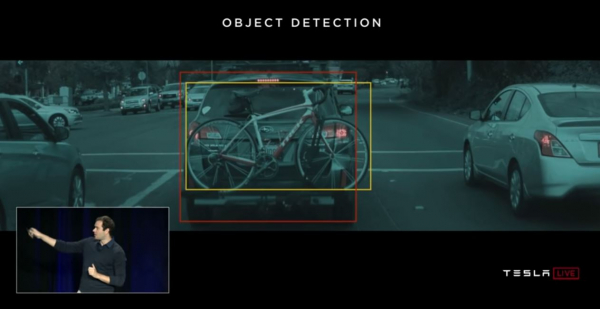
En hier zien we het eerste fundamentele probleem. Big Data. Dit is precies wat de huidige golf van neurale netwerken en machine learning heeft voortgebracht. Tegenwoordig is het aannemen van iets complex en automatisch afhankelijk van veel gegevens. Niet zomaar veel, maar heel, heel veel. Er zijn geautomatiseerde algoritmen nodig voor het verzamelen, labelen en gebruiken ervan. Als we willen dat de machine vrachtwagens tegen de zon herkent, moeten we eerst voldoende gegevens verzamelen. Als we willen dat de machine niet in de war raakt van een fiets die aan de achterklep is bevestigd, hebben we meer voorbeelden nodig.
Eén voorbeeld is niet genoeg. Honderden? Duizenden?
Het tweede probleem
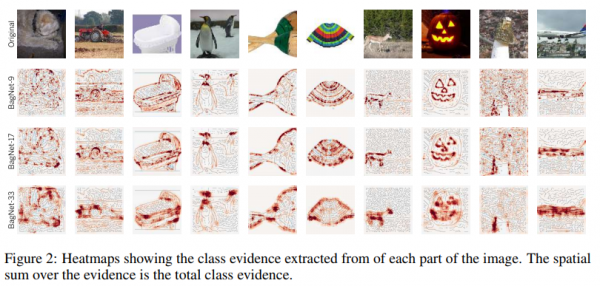
Het tweede probleem — de visualisatie van wat ons neurale netwerk heeft begrepen. Dit is een zeer niet-triviale taak. Tot nu toe begrijpt weinig mensen hoe ze dit moeten visualiseren. Deze artikelen zijn vrij recent, en dit zijn slechts enkele voorbeelden, zij het verre:
de focus op texturen. Het toont goed aan waar het netwerk zich op concentreert + wat het als referentie-informatie beschouwt.
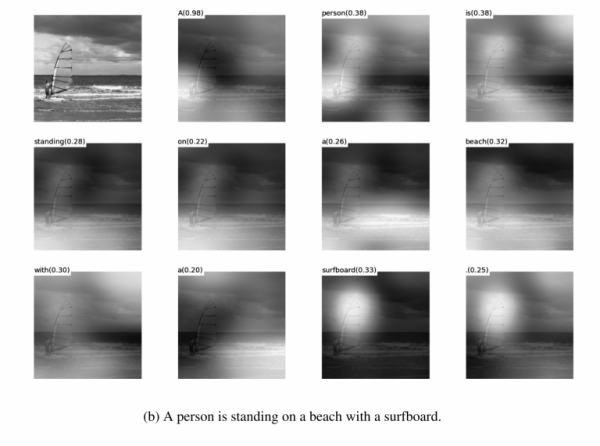
aandacht bij . Aandacht kan vaak letterlijk worden gebruikt om aan te tonen wat de netwerkreactie heeft veroorzaakt. Ik heb zulke dingen gezien voor zowel debugging als productoplossingen. Er zijn veel artikelen over dit onderwerp. Maar hoe complexer de gegevens, hoe moeilijker het is om een stabiele visualisatie te verkrijgen.
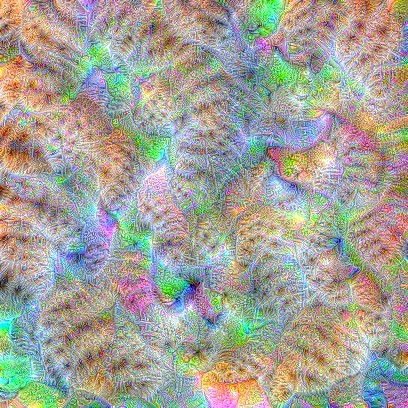
En ja, de oude vertrouwde набор van “kijk wat er in het netwerk zit in de . Deze afbeeldingen waren 3-4 jaar geleden populair, maar iedereen begreep al snel dat hoewel de afbeeldingen mooi zijn, ze weinig betekenis hebben.
Ik heb tientallen andere trucs, methoden, hacks en onderzoeken over hoe de innerlijke werking van het netwerk te visualiseren, niet genoemd. Werken deze hulpmiddelen? Helpen ze om snel te begrijpen wat het probleem is en om het netwerk te debuggen?.. Het extraheren van de laatste procenten? Nou, ongeveer net zo:
Je kunt elke wedstrijd op Kaggle bekijken. En de beschrijving van hoe mensen hun uiteindelijke oplossingen maken. We hebben 100-500-800 miljoen modellen verzameld en het werkt!
Natuurlijk overdrijf ik. Maar deze benaderingen geven geen snelle en directe antwoorden.
Met voldoende ervaring, door verschillende opties uit te proberen, kan men een oordeel vellen over waarom jouw systeem dergelijke beslissingen heeft genomen. Maar het zal moeilijk zijn om het gedrag van het systeem aan te passen. Een noodoplossing plaatsen, de drempel verleggen, een dataset toevoegen, een andere backend-netwerk nemen.
Het derde probleem
Het derde fundamentele probleem — netwerken leren geen logica, maar statistiek. Statistisch gesproken is dit :
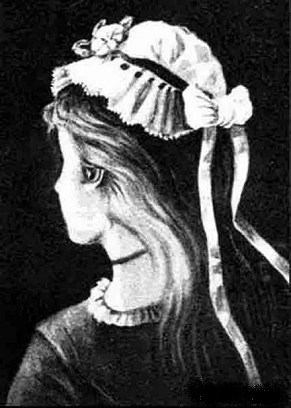
Logisch gezien lijkt het niet echt op elkaar. Neurale netwerken leren geen complexe dingen, tenzij ze dat gedwongen worden. Ze leren altijd de maximaal simpele kenmerken. Zijn er ogen, een neus, een hoofd? Dan is het een gezicht! Of geef een voorbeeld waarbij ogen niet een gezicht betekenen. En weer — miljoenen voorbeelden.
Er is genoeg ruimte beneden
Ik zou zeggen dat juist deze drie globale problemen op dit moment de ontwikkeling van neurale netwerken en machine learning beperken. En waar deze problemen niet een beperking vormen, wordt er al actief gebruik van gemaakt.
Is dit het einde? Zijn neurale netwerken gestopt?
Onbekend. Maar natuurlijk hoopt iedereen van niet.
Er zijn veel benaderingen en richtingen om de fundamentele problemen die ik hierboven heb genoemd op te lossen. Maar tot nu toe heeft geen van deze benaderingen het mogelijk gemaakt om iets fundamenteel nieuws te creëren of iets op te lossen dat tot nu toe niet opgelost is. Tot nu toe worden alle fundamentele projecten gebaseerd op stabiele benaderingen (Tesla), of blijven ze testprojecten van instituten of bedrijven (Google Brain, OpenAI).
Grof gezegd is de belangrijkste richting — het creëren van een hoog niveau representatie van de invoergegevens. In zekere zin “geheugen”. Het eenvoudigste voorbeeld van geheugen is de verschillende “Embedding” — representaties van afbeeldingen. Bijvoorbeeld, alle gezichtsherkenningssystemen. Het netwerk leert een stabiele representatie van een gezicht te krijgen die niet afhangt van draaiingen, verlichting, resolutie. In wezen minimaliseert het netwerk de metriek “verschillende gezichten — ver weg” en “dezelfde — dichtbij”.
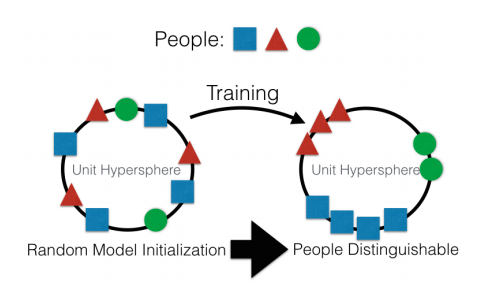
Voor deze training zijn tientallen en honderden duizenden voorbeelden nodig. Maar het resultaat bevat enkele aanzetten van “One-shot Learning”. Nu hebben we niet honderden gezichten nodig om een persoon te onthouden. Slechts één gezicht, en dat is alles — we !
Maar er is een probleem… Het netwerk kan alleen vrij simpele objecten leren. Bij het proberen te onderscheiden van niet-gezichten, maar bijvoorbeeld “mensen op basis van kleding” (taak ) — daalt de kwaliteit met veel ordes. En het netwerk kan al niet genoeg voor de hand liggende veranderingen in perspectief leren.
En leren met miljoenen voorbeelden — is ook zo'n leuk vermaak.
Er zijn onderzoeken gedaan naar aanzienlijke vermindering van de vereisten. Bijvoorbeeld kan ik meteen denken aan een van de eerste onderzoeken over OneShot Learning :
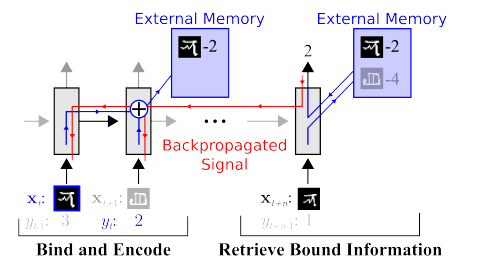
Er zijn veel van dergelijke onderzoeken, bijvoorbeeld of of .
Een minpunt is dat training meestal goed werkt met eenvoudige 'MNIST-achtige voorbeelden'. Maar bij complexere taken hebben we een grote dataset, een model van objecten of een soort magie nodig.
De ontwikkelingen op het gebied van One-Shot leren zijn in feite een zeer interessant onderwerp. Je vindt veel ideeën. Maar de twee problemen die ik eerder noemde (voortraining op een enorme dataset / instabiliteit met complexe gegevens) belemmeren het leren aanzienlijk.
Aan de andere kant past de onderwerp Embedding bij GAN — generatieve tegenstrijdige netwerken. Je hebt waarschijnlijk veel artikelen over dit onderwerp op Habré gelezen. (, ,)
Een kenmerk van GAN is de vorming van een intern toestandsruimte (in wezen dezelfde Embedding), die het mogelijk maakt om een afbeelding te genereren. Dit kan zijn , kunnen zijn .
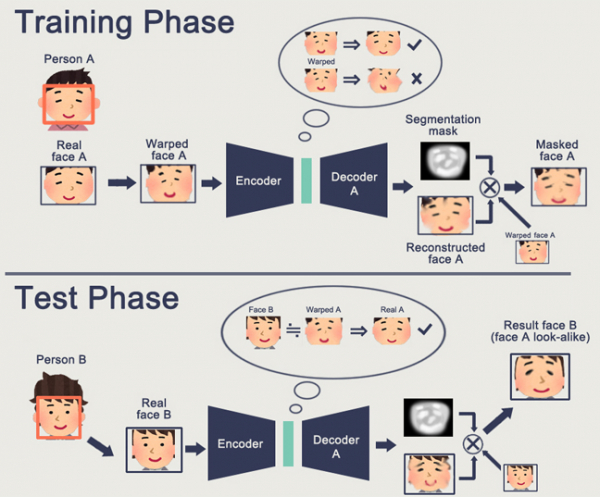
Het probleem met GAN is dat hoe complexer het gegenereerde object is, hoe moeilijker het is om het te beschrijven in de logica van 'generator-discriminator'. Resultaat: van de echte toepassingen van GAN waarover gesproken wordt, is alleen DeepFake, wat opnieuw manipuleert met gezichtsrepresentaties (waarvoor een enorme database bestaat).
Andere nuttige toepassingen heb ik zeer weinig gezien. Gewoon wat speeltjes met het aanvullen van afbeeldingen.
En opnieuw, niemand heeft een idee hoe dit ons zal helpen om vooruitgang te boeken naar een betere toekomst. De vertegenwoordiging van logica/ruimte in een neuraal netwerk is goed. Maar we hebben een enorme hoeveelheid voorbeelden nodig; we begrijpen niet hoe het neuronale netwerk dit intern vertegenwoordigt, en we begrijpen niet hoe we het neuronale netwerk kunnen laten onthouden wat een echt complexe representatie is.
Versterkend leren is een benadering vanuit een heel andere hoek. Je herinnert je vast nog hoe Google iedereen versloeg in Go. De recente overwinningen in Starcraft en Dota. Maar hier is het allesbehalve rooskleurig en veelbelovend. Het beste verhaal over RL en de complexiteiten ervan vertelt .
Als we kort samenvatten wat de auteur schreef:
- Kant-en-klare modellen passen niet goed / werken in de meeste gevallen slecht.
- Praktische taken zijn eenvoudiger op te lossen met andere methoden. Boston Dynamics gebruikt geen RL vanwege de complexiteit / onvoorspelbaarheid / rekenuitdagingen.
- Om RL te laten werken, is er een complexe functie nodig. Vaak is het lastig om deze te creëren / schrijven.
- Het is moeilijk om modellen te trainen. Je moet veel tijd besteden om ze uit lokale optimalen te krijgen.
- Als gevolg hiervan is het moeilijk om het model te repliceren; het model is onbetrouwbaar bij de kleinste veranderingen.
- Vaak overfittet het op willekeurige patronen, tot aan een willekeurige getallengenerator toe.
Een cruciaal punt is dat RL momenteel nog niet in de productie werkt. Google heeft enkele experimenten, , maar ik heb nog geen enkel productiesysteem gezien.
GeheugenHet nadeel van al het bovenstaande is de onsamenhangendheid. Een van de benaderingen om dit te structureren, is om de neurale netwerk toegang te geven tot een aparte geheugen. Zodat ze daar haar bevindingen kan opslaan en herschrijven. Dan kan het neurale netwerk worden gedefinieerd door de huidige toestand van het geheugen. Dit lijkt erg op klassieke processoren en computers.
De meest bekende en populaire — van DeepMind:
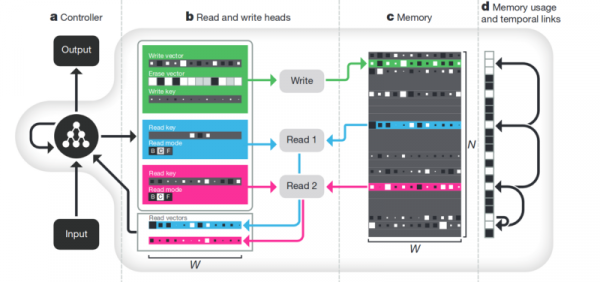
Het lijkt erop dat dit de sleutel tot het begrip van intelligentie is? Maar waarschijnlijk niet. Het systeem heeft nog steeds een enorme hoeveelheid data nodig voor training. En het werkt meestal met gestructureerde tabelgegevens. Terwijl Facebook soortgelijk probleem oploste, gingen zij de weg van “vergeet het geheugen, laten we het neurale netwerk gewoon complexer maken en meer voorbeelden geven — dan leert het vanzelf.”
Disentanglement. Een andere manier om betekenisvol geheugen te creëren, is om dezelfde embeddings te nemen, maar bij de training aanvullende criteria in te voeren die het mogelijk maken om “betekenissen” erin te identificeren. Bijvoorbeeld, we willen een neurale netwerk trainen om het gedrag van een persoon in een winkel te onderscheiden. Als we de standaard weg zouden volgen, zouden we een tiental netwerken moeten maken. Een zoekt de persoon, de tweede bepaalt wat hij doet, de derde zijn leeftijd, de vierde — geslacht. Een aparte logica kijkt naar het deel van de winkel waar hij zich bevindt/dit leert. De derde bepaalt zijn pad, enzovoort.
Of, als er oneindig veel gegevens beschikbaar waren, zou je één netwerk kunnen trainen op alle mogelijke uitkomsten (het is duidelijk dat zo'n grote dataset niet verzameld kan worden).
De disentelementbenadering zegt ons: laten we het netwerk zo trainen dat het concepten zelf kan onderscheiden. Zodat het op basis van video een embedding vormt, waarbij een gebied de actie definieert, een ander de positie op de vloer in de tijd, een ander de lengte van de persoon, en weer een ander zijn geslacht. Bij het trainen zouden we het netwerk niet al te veel zulke sleutelconcepten willen aanreiken, maar het zou zelf gebieden moeten выделen en groeperen. Er zijn niet veel artikelen die zich hiermee bezighouden (sommige van hen , , ) en over het algemeen zijn ze vrij theoretisch.
Maar deze richting zou in ieder geval theoretisch de genoemde problemen aan het begin moeten oplossen.
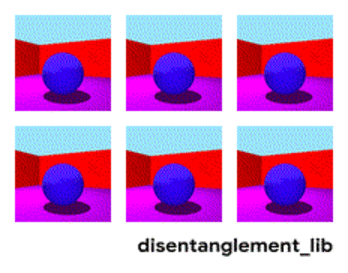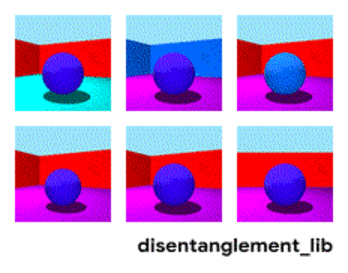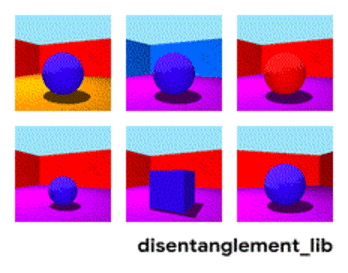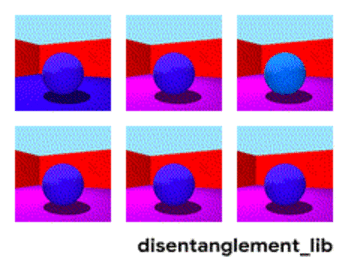
De ontleding van een afbeelding op basis van parameters "muurkleur/vloer kleur/vorm object/kleur object/enz."
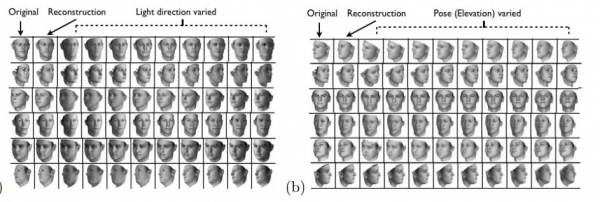
De ontleding van een gezicht op basis van parameters "grootte, wenkbrauwen, oriëntatie, huidskleur, enz."
Overige
Er zijn veel andere, minder globale richtingen die het mogelijk maken om de gegevensbases te verkleinen, te werken met meer heterogene gegevens, enz.
Aandacht. Het lijkt misschien niet zinvol om dit als een afzonderlijke methode te onderscheiden. Het is gewoon een benadering die andere versterkt. Er zijn veel artikelen aan gewijd (,,). Het doel van Aandacht is om de reactie van het netwerk op belangrijke objecten tijdens de training te versterken. Vaak door middel van externe doel aanwijzingen, of een klein extern netwerk.
3D-simulatie. Als je een goede 3D-engine maakt, kun je vaak 90% van de leerdata dekken (ik heb zelfs een voorbeeld gezien waarbij bijna 99% van de data werd gedekt door een goede engine). Er zijn veel ideeën en hacks om een netwerk dat op een 3D-engine is getraind, te laten werken met echte gegevens (fine tuning, style transfer, enz.). Maar vaak is het maken van een goede engine vele malen ingewikkelder dan het verzamelen van gegevens. Voorbeelden van wanneer engines zijn gemaakt:
Robottraining (, )
Opleiding van goederen in een winkel (maar in twee projecten die wij deden — konden we dit gemakkelijk zonder doen).
Training bij Tesla (opnieuw het hierboven genoemde video).
Conclusies
Het hele artikel is in zekere zin een conclusie. Waarschijnlijk is de belangrijkste boodschap die ik wilde overbrengen: "de gratis oplossingen zijn voorbij, neurale netwerken bieden geen eenvoudige oplossingen meer." Nu moet je hard werken om complexe oplossingen te bouwen. Of hard werken door complexe wetenschappelijke onderzoeken te doen.
Overigens is het een discussiewaardig onderwerp. Misschien hebben de lezers interessantere voorbeelden?
Bron: habr.com
