

Hedendaagse informatiesystemen zijn behoorlijk complex. Niet in de laatste plaats is hun complexiteit te wijten aan de complexiteit van de gegevens die daarin worden verwerkt. De complexiteit van de gegevens ligt vaak in de diversiteit van de gebruikte datamodellen. Zo wordt, wanneer gegevens 'groot' worden, niet alleen hun volume ('volume'), maar ook hun diversiteit ('variety') als een ongemakkelijke eigenschap beschouwd.
Als je nog geen fouten in de redeneringen kunt vinden, lees dan verder.
Inhoud
Polyglot persistence
Dit leidt ertoe dat men soms binnen zelfs één enkel systeem meerdere databases moet gebruiken voor het opslaan van gegevens en voor het oplossen van verschillende verwerkingsproblemen, waarbij elke database zijn eigen datamodel ondersteunt. Op de suggestie van M. Fowler, een aantal bekende boeken en een van de Agile Manifesto, heeft deze situatie de naam gekregen polyglot persistence. (‘polyglot persistence’).
Fowler geeft ook het volgende voorbeeld van het organiseren van gegevensopslag in een volledig functionele en zwaar belaste applicatie in de e-commerce.
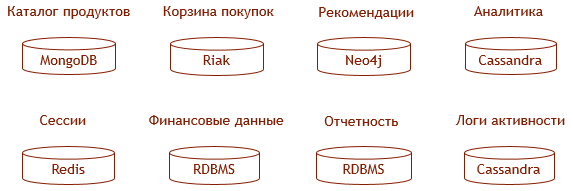
Dit voorbeeld is natuurlijk iets overdreven, maar er zijn enkele overwegingen te vinden voor de keuze van de juiste database voor het desbetreffende doel, zoals bijvoorbeeld, .
Het is duidelijk dat het een uitdaging is om een beheerder in zo’n zoo te zijn.
- De hoeveelheid code die voor gegevensopslag verantwoordelijk is, groeit evenredig met het aantal gebruikte databases; de hoeveelheid code die gegevens synchroniseert, is, als het goed is, niet evenredig met het kwadraat van dit aantal.
- De kosten voor het waarborgen van enterprise-eigenschappen (schaalbaarheid, fouttolerantie, hoge beschikbaarheid) van elke gebruikte database groeien exponentieel met het aantal databases.
- Het is onmogelijk om enterprise-eigenschappen voor het opslagsysteem als geheel te waarborgen — vooral de transactiecapaciteit.
Vanuit het perspectief van de directeur van de zoo ziet het er als volgt uit:
- Exponetieel stijgende kosten voor licenties en ondersteuning van de databaseleverancier.
- De uitweiding van personeel en de verlenging van termijnen.
- Directe financiële verliezen of boetes door gegevensinconsistentie.
Er is een aanzienlijke stijging van de totale eigendomskosten van het systeem (TCO). Zit er een oplossing voor de situatie van 'multimodale opslag'?
Multimodeling
De term ‘multimodale opslag’ werd in 2011 populair. Het besef van de problemen met deze benadering en het zoeken naar oplossingen duurde enkele jaren, en tegen 2015 werd de antwoord door analisten van Gartner geformuleerd:
- Uit ‘»:
De toekomst van DBMS, hun architecturen en gebruiksmethoden – multimodaliteit.
- Uit ‘»:
Leidende operationele DBMS zullen verschillende modellen aanbieden – relationele en niet-relationele – binnen een enkel platform.
Het lijkt erop dat de analisten van Gartner deze keer gelijk hebben. Bekijk de pagina met van DBMS op DB-Engines, en je kunt zien dat degroter publiek.meeste van hun leiders zichzelf juist positioneren als multimodale DBMS. Dit is ook zichtbaar op elke specifieke ranglijst.
In de onderstaande tabel zijn de DBMS-leiders in elke specifieke ranglijst weergegeven die claimen multimodaal te zijn. Voor elke DBMS zijn het oorspronkelijke ondersteunde model (eenmaal de enige) en de modellen die nu worden ondersteund, aangegeven. Ook zijn er DBMS die zichzelf positioneren als ‘oorspronkelijk multimodaal’ en geen enkele oorspronkelijke geërfde model claimen.
| DBMS | Oorspronkelijk model | Extra modellen |
|---|---|---|
| Oracle | Relationeel | Grafisch, documentair |
| MS SQL | Relationeel | Grafisch, documentair |
| PostgreSQL | Relationeel | Grafisch*, documentair |
| MarkLogic | Documentair | Grafisch, relationeel |
| MongoDB | Documentair | Sleutel-waarde, grafisch* |
| DataStax | Wide-column | Documentair, grafisch |
| Redis | Sleutel-waarde | Documentair, grafisch* |
| ArangoDB | — | Grafisch, documentair |
| OrientDB | — | Grafisch, documentair, relationeel |
| Azure CosmosDB | — | Grafisch, documentair, relationeel |
Opmerkingen bij de tabel
Sterretjes in de tabel markeren verklaringen die enige nuancering vereisen:
- De DBMS PostgreSQL ondersteunt het grafisch datamodel niet, maar een product dat daarop is gebaseerd ondersteunt dit Met betrekking tot MongoDB is het juister om te spreken van de aanwezigheid van grafische operators in de querytaal (
- $lookup, ), wat betreft de ondersteuning van het grafmodel, hoewel hun introductie natuurlijk enige optimalisaties op het niveau van fysieke opslag vereiste ter ondersteuning van het grafmodel.
- In Bezug auf Redis bezieht sich dies auf die Erweiterung .
Für jede dieser Klassen werden wir im Folgenden zeigen, wie die Unterstützung mehrerer Modelle in einer Datenbankmanagementsystem (DBMS) dieser Klasse umgesetzt wird. Die wichtigsten Modelle, die wir betrachten werden, sind relationale, dokumentorientierte und graphenbasierte Modelle, und wir werden anhand konkreter DBMS-Beispiele zeigen, wie die 'fehlenden' Modelle umgesetzt werden.
Multimodel databases op basis van het relationele model
Die führenden DBMS sind derzeit relationale Systeme; die Prognose von Gartner könnte nicht als zutreffend angesehen werden, wenn RDBMS nicht in Richtung Multimodalität zeigen würden. Und genau das tun sie. Die Annahme, dass ein multimodales DBMS einem Schweizer Taschenmesser ähnelt, mit dem man nichts richtig machen kann, kann direkt an Larry Ellison weitergeleitet werden.
Der Autor präferiert jedoch die Umsetzung der Multimodalität in Microsoft SQL Server, an dessen Beispiel die Unterstützung der dokumentorientierten und graphenbasierten Modelle von RDBMS beschrieben wird.
Documentmodel in MS SQL Server
Es gab bereits zwei ausgezeichnete Artikel auf Habré darüber, wie die Unterstützung des dokumentorientierten Modells in MS SQL Server umgesetzt ist, ich werde mich mit einer kurzen Zusammenfassung und Kommentierung begnügen:
Die Art der Unterstützung des dokumentorientierten Modells in MS SQL Server ist für relationale DBMS ziemlich typisch: JSON-Dokumente sollen in normalen Textfeldern gespeichert werden. Die Unterstützung des dokumentorientierten Modells besteht darin, spezielle Operatoren zur Analyse dieses JSON bereitzustellen:
- zum Abrufen skalaren Werten von Attributen,
- zum Abrufen von Unterdokumenten.
Der zweite Parameter beider Operatoren ist ein Ausdruck im JSONPath-ähnlichen Syntax.
Im Allgemeinen kann man sagen, dass die auf diese Weise gespeicherten Dokumente in einem relationalen DBMS keine '1. Klasse Entitäten' sind, im Gegensatz zu Tupeln. Konkreter gibt es momentan in MS SQL Server keine Indizes für JSON-Dokumentfelder, was die Durchführung von Joins zwischen Tabellen basierend auf den Werten dieser Felder und sogar die Auswahl von Dokumenten basierend auf diesen Werten erschwert. Allerdings besteht die Möglichkeit, auf einem solchen Feld eine berechnete Spalte und einen Index darauf zu erstellen.
Zusätzlich ermöglicht MS SQL Server eine bequeme Konstruktion von JSON-Dokumenten aus dem Inhalt von Tabellen mithilfe des Operators — een mogelijkheid die in zekere zin het tegenovergestelde is van de vorige, reguliere opslag. Het is duidelijk dat hoe snel de RDBMS ook mag zijn, deze aanpak in strijd is met de ideologie van document-georiënteerde databases, die in wezen kant-en-klare antwoorden op populaire queries opslaan, en kan slechts problemen met het ontwikkelgemak oplossen, maar niet met de snelheid.
Ten slotte stelt MS SQL Server in staat om de omgekeerde taak van documentconstructie op te lossen: JSON kan worden opgesplitst in tabellen met behulp van . Als het document niet helemaal plat is, zal het nodig zijn om CROSS APPLY.
Grafmodel in MS SQL Server
De ondersteuning voor het grafmodel (LPG) is ook in Microsoft SQL Server redelijk : er worden speciale tabellen aangeboden voor het opslaan van knooppunten en voor het opslaan van de randen van het graf. Dergelijke tabellen worden gemaakt met behulp van de expressies CREATE TABLE AS NODE en CREATE TABLE AS EDGE respectievelijk.
Tabellen van de eerste soort zijn vergelijkbaar met reguliere tabellen voor het opslaan van records, met het enige externe verschil dat de tabel een systeemveld bevat $node_id — een unieke identificator van het grafknooppunt binnen de database.
Evenzo hebben tabellen van de tweede soort systeemvelden $from_id en $to_id, de records in dergelijke tabellen geven op begrijpelijke wijze de verbindingen tussen knooppunten aan. Voor het opslaan van verbanden van elk type wordt een aparte tabel gebruikt.
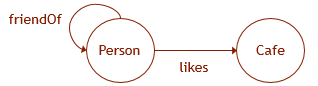 Laten we het bovenstaande illustreren met een voorbeeld. Stel dat de grafgegevens een schema hebben zoals weergegeven in de afbeelding. Dan moeten de volgende DDL-queries worden uitgevoerd om de overeenkomstige structuur in de database te creëren:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
De belangrijkste specificiteit van dergelijke tabellen is dat in de queries naar hen grafpatronen met Cypher-achtige syntaxis kunnen worden gebruikt (hoewel "*" en dergelijke momenteel nog niet worden ondersteund). Op basis van prestatiemeting kan ook worden aangenomen dat de manier van gegevensopslag in deze tabellen verschilt van het mechanisme voor gegevensopslag in reguliere tabellen en is geoptimaliseerd om dit soort grafqueries uit te voeren.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Bovendien is het vrij moeilijk om grafische patronen te negeren bij het werken met dergelijke tabellen, aangezien het in reguliere SQL-query's extra moeite kost om systematische "grafische" identificatoren van knooppunten te verkrijgen ($node_id, $from_id, $to_id; om deze reden zijn de invoerquery's hier niet opgenomen wegens hun overmatige omvang).
Samenvattend de beschrijvingen van de implementatie van de document- en grafmodellen in MS SQL Server, zou ik opmerken dat dergelijke implementaties van het ene model bovenop een ander in de eerste plaats vanuit het perspectief van taaldesign niet succesvol lijken. Het is nodig om de ene taal met de andere uit te breiden, de talen zijn niet echt "orthogonaal", de combinatieregels kunnen behoorlijk eigenaardig zijn.
Multimodel databases op basis van het documentmodel
In deze sectie wil ik de implementatie van multimodaliteit in documentgeoriënteerde databases illustreren met behulp van een voorbeeld van een van de minder populaire databases, MongoDB (zoals eerder vermeld, heeft het alleen voorwaardelijke grafische operatoren, $graphLookup en ), dan van het ondersteunen van het grafisch model, hoewel hun invoering uiteraard verschillende optimalisaties op het niveau van fysieke opslag vereiste in de richting van ondersteuning van het grafische model., die niet werken met geshardede collecties), maar aan de hand van een meer volwassen en "enterprise" database. .
Stel dat de collectie een set XML-documenten bevat van de volgende soort (MarkLogic kan ook JSON-documenten opslaan):
Johannes
  Smith
Relationeel model in MarkLogic
Relationale weergave van de documentcollectie kan worden gemaakt met behulp van (de inhoud van de elementen value in het onderstaande voorbeeld kan willekeurige XPath zijn):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
Een SQL-query kan naar de gemaakte weergave worden gericht (bijvoorbeeld via ODBC):
SELECT name, surname FROM Person WHERE name="Johannes"Helaas is de relationele weergave die met behulp van een sjabloon is gemaakt alleen-lezen. Bij het verwerken van een query naar deze weergave zal MarkLogic proberen om gebruik te maken van Eerder waren er in MarkLogic ook beperkte relationele weergaven die volledig gebaseerd waren op indexen en beschikbaar voor schrijven, maar ze worden momenteel als verouderd beschouwd.
Grafmodel in MarkLogic
Met ondersteuning voor het grafische (RDF) model verloopt alles ongeveer hetzelfde. Nogmaals met behulp van kan een RDF-representatie van de documentencollectie uit het bovenstaande voorbeeld worden gemaakt:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Aan de resulterende RDF-grafiek kan een SPARQL-query worden gericht:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
In tegenstelling tot het relationele model ondersteunt MarkLogic het grafische model op twee andere manieren:
- De DBMS kan een volwaardig apart opslag voor RDF-gegevens zijn (tripletten worden hierin genoemd in tegenstelling tot de hierboven beschreven ).
- RDF in een speciale serialisatie kan eenvoudigweg worden ingevoegd in XML- of JSON-documenten (en tripletten worden dan genoemd ). Dit is waarschijnlijk een alternatieve oplossing voor de mechanismen
idrefenz.
Een goed beeld van hoe "het eigenlijk" is geregeld in MarkLogic geeft , in deze zin is het laagdrempelig, hoewel het doel eerder het tegenovergestelde is — proberen te abstraheren van het gebruikte datamodel, consistente interactie met gegevens in verschillende modellen, transacties en dergelijke te waarborgen.
Multimodel databases 'zonder hoofmodel'
Op de markt zijn er ook DBMS'en die zichzelf positioneren als oorspronkelijk multimodel, zonder enige geërfde hoofdmol. Onder hen zijn , (sinds 2018 is de ontwikkelingsmaatschappij eigendom van SAP) en (een dienst binnen het cloudplatform van Microsoft Azure).
In werkelijkheid hebben ArangoDB en OrientDB wel "basis" modellen. Dit zijn in beide gevallen eigen datamodellen die generalisaties van documentmodellen zijn. De generalisaties zijn voornamelijk gericht op het vergemakkelijken van het uitvoeren van grafische en relationele queries.
Deze modellen zijn de enige beschikbare om te gebruiken in de genoemde databases; ze zijn bedoeld voor hun eigen querytalen. Uiteraard zijn dergelijke modellen en databases veelbelovend, maar het gebrek aan compatibiliteit met standaardmodellen en -talen maakt het gebruik van deze databases in geërfde systemen onmogelijk — ze kunnen de reeds gebruikte databases daar niet vervangen.
Er was al een uitstekend artikel over ArangoDB en OrientDB op Habr: .
ArangoDB
ArangoDB claimt ondersteuning voor het grafische gegevensmodel.
De knooppunten van de grafiek in ArangoDB zijn gewone documenten, terwijl de randen speciale documenten zijn die, naast reguliere systeemvelden (_key, _id, _rev) systeemvelden zijn _from en _to. Documenten in documentdatabases worden traditioneel gegroepeerd in verzamelingen. De verzamelingen documenten die randen vertegenwoordigen, worden in ArangoDB edge-collecties genoemd. Trouwens, de documenten van edge-collecties zijn ook documenten, zodat de randen in ArangoDB ook als knooppunten kunnen fungeren.
Brongegevens
Laat ons een verzameling hebben persons, waarvan de documenten er als volgt uitzien:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alicia"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Laat er ook een verzameling zijn cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Dan kan de verzameling likes er als volgt uitzien:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Vragen en resultaten
Een grafische stijlquery in de gebruikte AQL-taal van ArangoDB, die informatie op een leesbare manier retourneert over wie welke café leuk vindt, ziet er als volgt uit:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
In relationele stijl, waarbij we eerder 'verbindingen berekenen' dan ze op te slaan, kan deze query als volgt worden herschreven (overigens zonder de verzameling likes had het ook kunnen met slechts)
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Het resultaat zal in beide gevallen hetzelfde zijn:
[
  { "person" : "Alicia" , likes : "Jean-Jacques" } ,
  { "person" : "Alicia" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Nog meer vragen en resultaten
Als het lijkt dat het resultaatformaat hierboven meer kenmerkend is voor een relationele database dan voor een documentgeoriënteerde database, kan men zo'n query proberen (of gebruik maken van ):
VOOR p IN personen
  RETURN {
    persoon : p.naam,
    likes : (
      VOOR c IN UITGANG p likes
      RETURN c.naam
    )
}
Het resultaat zal er als volgt uitzien:
[
  { "persoon" : "Alice" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "persoon" : "Bob" , likes : ["John Donne"] }
]
OrientDB
De implementatie van een grafmodel bovenop een documentmodel in OrientDB is gebaseerd op documentvelden die naast meer of minder standaard scalare waarden ook waarden van typen zoals VERBINDING, VERBINDINGSLIJST, VERBINDINGSET, VERBINDINGSMAP en VERBINDINGENZAK. De waarden van deze typen zijn verwijzingen of verzamelingen van verwijzingen naar documenten.
De door het systeem toegekende identificatie van het document heeft een 'fysieke betekenis', wijzend op de positie van de record in de database, en ziet er ongeveer zo uit: @rid : #3:16. Hierdoor zijn de waarden van verwijzingsattributen in werkelijkheid meer zoals pointers (zoals in het grafmodel), en niet als selectiecriteria (zoals in relationele databases).
Net als in ArangoDB worden de randen in OrientDB gepresenteerd als aparte documenten (hoewel als een rand geen eigen eigenschappen heeft, kan deze zijn, en er hoeft geen apart document voor te worden aangemaakt).
Brongegevens
In een formaat dat dichtbij van de OrientDB-database, zouden de gegevens uit het vorige voorbeeld voor ArangoDB er ongeveer zo uitzien:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Persoon",
      "name": "Alice",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=VERBINDINGENZAK"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Persoon",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=VERBINDINGENZAK"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Café",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=VERBINDINGENZAK"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Café",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=VERBINDINGENZAK"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=VERBINDING,out=VERBINDING,since=datum"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=VERBINDING,out=VERBINDING,since=datum"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=VERBINDING,out=VERBINDING,since=datum"
    }
  ]
Zoals we kunnen zien, bevatten de knooppunten ook informatie over binnenkomende en uitgaande randen. Bij Met de Document API moet je zelf de referentiële integriteit in de gaten houden, terwijl de Graph API dit werk voor je doet. Laten we eens kijken hoe verzoeken naar OrientDB eruitzien in 'schone', niet-geïntegreerde querytalen.
Vragen en resultaten
Een verzoek dat qua doel vergelijkbaar is met het voorbeeldverzoek voor ArangoDB, ziet er in OrientDB als volgt uit:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Het resultaat zal in de volgende vorm worden verkregen:
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Als het formaat van het resultaat weer te 'relationeel' lijkt, moet de regel met :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
De querytaal van OrientDB kan worden gekarakteriseerd als SQL met Gremlin-achtige invoegingen. In versie 2.2 kwam er een Cypher-achtige vorm van de query, :
MATCH {CLASS: Person, AS: person}-likes-> {CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Het resultaatformaat zal hetzelfde zijn als bij de vorige query. Denk na over wat er moet worden verwijderd om het meer 'relationeel' te maken, zoals in de allereerste query.
Azure CosmosDB
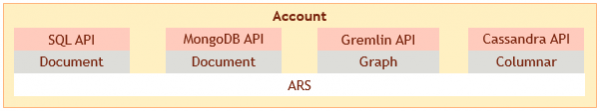
In mindere mate geldt het bovenstaande over ArangoDB en OrientDB voor Azure CosmosDB. CosmosDB biedt de volgende API's voor gegevensverwerking: SQL, MongoDB, Gremlin en Cassandra.
SQL API en MongoDB API worden gebruikt voor toegang tot gegevens in het documentmodel. Gremlin API en Cassandra API zijn voor toegang tot gegevens in respectievelijk de graf- en kolomstructuur. Gegevens in alle modellen worden opgeslagen in het interne model van CosmosDB: (‘atom-record-sequence’), dat ook dicht bij een documentmodel ligt.
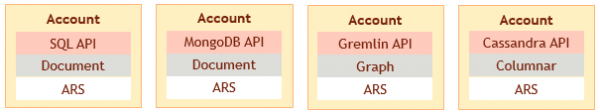
Maar het door de gebruiker gekozen datamodel en de gebruikte API worden vastgelegd op het moment van creatie van het account in de service. Het is niet mogelijk om toegang te krijgen tot gegevens die zijn geladen in één model, in de indeling van een ander model, wat ongeveer zou worden geïllustreerd door de volgende afbeelding:
Daarmee vertegenwoordigt multimodaliteit in Azure CosmosDB momenteel slechts de mogelijkheid om meerdere databases van dezelfde leverancier te gebruiken die verschillende modellen ondersteunen, wat niet alle problemen van variabel opslag oplost.
Multimodel databases op basis van het grafmodel?
Het valt op dat er op de markt momenteel geen multimodale DBMS zijn die gebaseerd zijn op een grafmodel (tenzij je multimodaliteit beschouwt als het ondersteunen van tegelijkertijd twee grafmodellen: RDF en LPG; zie hierover in ). De grootste moeilijkheden ontstaan bij de implementatie bovenop een documentmodel, en niet een relationeel model.
De vraag hoe een relationeel model bovenop een grafmodel te implementeren, werd al besproken in de tijd waarin het laatste zich vestigde. Hoe , bijvoorbeeld, :
Er is niets inherent aan de grafbenadering dat het onmogelijk maakt om een laag (bijvoorbeeld door geschikte indexering) bovenop een grafdatabase te creëren die een relationeel perspectief mogelijk maakt met (1) herstel van tuples uit de gebruikelijke sleutel-waardeparen en (2) groepering van tuples op relationeel type.
Bij de implementatie van het documentmodel bovenop het grafmodel moet men bijvoorbeeld rekening houden met het volgende:
- JSON-array-elementen worden als geordend beschouwd, de uitgaande van de top van de grafrand - dat is niet zo;
- Gegevens in het documentmodel zijn doorgaans denormalized, het is echter ongewenst om meerdere kopieën van hetzelfde geneste document op te slaan, en subdocumenten hebben doorgaans geen identificatoren;
- Aan de andere kant ligt de ideologie van document-gebaseerde databases daarin dat documenten kant-en-klare 'aggregaten' zijn, die niet telkens opnieuw hoeven te worden opgebouwd. Het is nodig om in het grafmodel de mogelijkheid te bieden om snel een ondergraf van een kant-en-klaar document te verkrijgen.
Een beetje reclame
De auteur van het artikel is betrokken bij de ontwikkeling van de database NitrosBase, wiens interne model grafisch is, terwijl de externe modellen - relationeel en documentair - de representaties ervan zijn. Alle modellen zijn gelijkwaardig: praktisch elke gegevens is toegankelijk in elk van hen met behulp van de natuurlijke voor hen querytaal. Bovendien kunnen de gegevens in elke representatie worden gewijzigd. Wijzigingen zullen weerspiegeld worden in het interne model en bijgevolg in de andere representaties.
Hoe de overeenstemming van modellen in NitrosBase eruit ziet - hoop ik te beschrijven in een van de volgende artikelen.
Conclusie
Ik hoop dat de algemene contouren van wat multimodulariteit wordt genoemd, voor de lezer meer of minder duidelijk zijn geworden. Multimodale databases kunnen behoorlijk verschillend zijn en 'ondersteuning van meerdere modellen' kan er verschillende uitzien. Voor een begrip van wat men in elk specifiek geval met 'multimodulariteit' bedoelt, is het nuttig om de volgende vragen te beantwoorden:
- Bijvoorbeeld, gaat het om de ondersteuning van traditionele modellen of om een bepaalde 'hybride' model?
- Zijn de modellen 'gelijkwaardig', of is een daarvan ondergeschikt aan de anderen?
- Zijn de modellen 'onverschillig' jegens elkaar? Kunnen gegevens die in het ene model zijn vastgelegd, in een ander model worden gelezen of zelfs worden overschreven?
Ik denk dat we op de vraag naar de relevantie van multimodel-databases nu al een positief antwoord kunnen geven, maar het is interessant om te kijken welke varianten het komende tijd het meest in trek zullen zijn. Het lijkt erop dat multimodel-databases die traditionele modellen ondersteunen, in het bijzonder relationele, het meest gewild zullen zijn; de populariteit van multimodel-databases die nieuwe modellen bieden en de voordelen van verschillende traditionele modellen combineren, is een kwestie van de verdere toekomst.
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Gebruik je multimodel-databases?
We gebruiken ze niet, we slaan alles op in één database en in één model.
We maken gebruik van de multimodelmogelijkheden van traditionele databases.
We passen polyglot persistence toe.
We gebruiken nieuwe multimodel-databases (Arango, Orient, CosmosDB).
19 gebruikers hebben gestemd. 4 gebruikers hebben zich onthouden.
Bron: habr.com
