

Het is grappig hoe de geschiedenis van de releases van open modellen voor het omzetten van tekstprompts naar afbeeldingen, ontwikkeld en getraind door Stability AI, doet denken aan een reeks pieken en dalen van opeenvolgende versies van Microsoft Windows. Na de legendarisch succesvolle XP volgde de problematische Vista; daarna kwam de fantastische 'zeven' — en daarachter de vruchteloze Windows 8. Bij Stable Diffusion volgde op de aanvankelijk onopvallende, maar geleidelijk door enthousiastelingen verfijnde versie 1.5, de ronduit mislukte SD 2.0 — mislukte, omdat deze een atypische encoder, OpenCLIP, gebruikte. uit . Tijdens deze selectie werden niet alleen ongepaste (NSFW) visuele referenties afgewezen, maar ook schilderijen en illustraties van populaire artiesten zoals de beruchte Greg Rutkowski. Juist dit laatste bracht de enthousiastelingen in vervoering: voor SD 1.5 werkten zelfs in de oorspronkelijke versie, zonder gebruik te maken van speciaal getrainde checkpoints, eenvoudige prompts met stijlen — 'epic medieval fantasy landscape, in the style of Greg Rutkowski' — en het resultaat was verbluffend, terwijl SD 2.0 stopte met het 'herkennen' van de namen van de bekendste illustratoren, wiens auteursrechten op de gemaakte werken nog steeds van toepassing zijn en die deze werken niet ter beschikking hebben gesteld voor de training van de AI. Men moest meer woorden gebruiken om het gewenste te beschrijven, en met te lange prompts had het model moeite.
Zaten — stonden op, zaten — stonden op
In combinatie met een gewijzigde coderingsmachine (de converter van tekstprompten naar digitale tokens, waarmee het model vervolgens direct werkt) heeft de onmogelijkheid om benoembare stijlen toe te passen simpelweg de enthousiaste ontwikkelaars de motivatie ontnomen om de "tweede versie" zelf verder te ontwikkelen. Want echt: men moest parallel ook begrijpen hoe men de eerder beproefde techniek van het samenstellen van prompts kon aanpassen aan de nieuwe coderingsmachine, en het model verder trainen om de beelden en thema's te herkennen waarmee de makers het tijdens de initiële training niet hebben bekendgemaakt — terwijl er geen garantie was dat de door de "tweede versie" gegenereerde beelden van kwalitatief betere aard zouden zijn in vergelijking met "de anderhalf". Ja, van de standaard voor SD 1.5, met een formaat van 512×512 pixels, heeft er een kwaliteitsstijging plaatsgevonden naar 768×768, maar tegen die tijd had de gemeenschap al volop gebruikgemaakt van upscalers, outpainters en andere tools om de uiteindelijke afbeeldingsgrootte te vergroten, zodat SD 2.0 in wezen onopgemerkt voorbijging. SDXL (ontwikkeld door OpenAI en onder andere gebruikt in het DALL-E project) — de code daarvan is ook open source, maar de database waarop het is getraind, , propriëtair. Bovendien is de standaard canvasgrootte van de "Oversize" vergroot naar 1024×1024, en is er een hele reeks aanvullende verbeteringen verschenen — zodat de enthousiaste ontwikkelaars graag aan de slag gingen met de verdere ontwikkeling. En tot nu toe kan men met vertrouwen zeggen dat SDXL (en de recentere, minder veeleisende afgeleiden zoals en ) momenteel de meest populaire open source AI-afbeeldingsgenerator is. Echter, fervente aanhangers van SD 1.5 zijn het hier niet mee eens, en wijzen erop dat zulke essentiële tools als ControlNet in SDXL .
En vanaf 12 juni 2024, het moment van de "release into the wild" van de modelcode waarmee lokale generaties mogelijk zijn, zou de tijd van de "open" versie SD 3 moeten aanbreken — om preciezer te zijn, (SD3M of SD3 2B) met 2 miljard werkparameters. Voor de duidelijkheid, dit aantal staat gelijk aan het totale aantal gewichten op de ingangen van alle perceptrons van het model. Eerder, in april, heeft Stability AI al de 8 miljoen (in termen van parameters) uitgewerkt en aangeboden voor commercieel gebruik. , het is ook de SD3 8B. Bij SDXL 1.0, ter herinnering, — , echter, SD3M, volgens de ontwikkelaars, is . Het werd bedoeld dat, met een lager videogeheugenverbruik dan „Oversize”, het zelfs op eenvoudige prompts afbeeldingen zou moeten genereren met „een nieuw niveau van fotorealistische kwaliteit”. Onder de voordelen van de „drie” werden ook genoemd „onbeperkte kwaliteit van de typografie van de geproduceerde tekst op gegenereerde afbeeldingen”, „verdiept begrip van prompts door de gecombineerde inspanningen van drie encoders” en „bereidheid voor effectieve bijtraining, zelfs met beperkte datasets”.
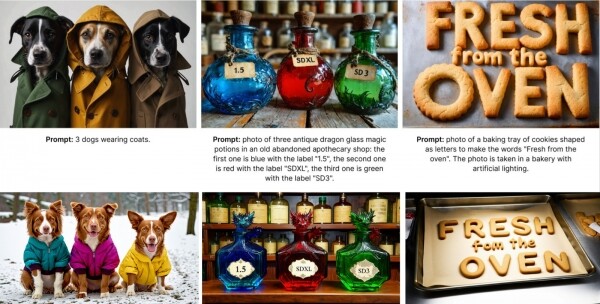
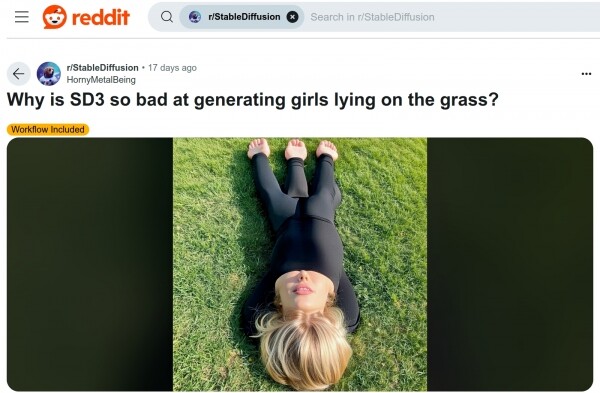
Er werd blijkbaar aangenomen dat de gemeenschap van enthousiastelingen, met de nieuwe langverwachte speeltje in handen, het met dezelfde toewijding zou verfijnen als de „anderhalve” en „Oversize” ooit. Echter, vanaf het begin ging alles mis: SD3M teleurstelde in de eerste uren na de publicatie van de modelbestanden op Hugging Face en Civitai en dat zelfs twee keer. De eerste keer — door een ogenschijnlijk onverklaarbare eigenaardigheid met prompts die de schijnbaar onschuldige zin „liggend op/in het gras” (lying on/in the grass) bevatten; de tweede — door enorm vage formuleringen in de gebruikersovereenkomst, waarin zelfs professionele juristen niet meteen konden doorgronden. En hoewel het voor de gewone enthusiast van AI-kunst misschien onbelangrijk lijkt, zal de juridische kant van de zaak de verdere ontwikkeling van het model direct beïnvloeden — tot het punt dat er misschien helemaal geen ontwikkeling zal volgen.
Eerdere creaties van Stable Diffusion met open source (meer precies, met open waarden van neuralenetwerkgewichten, beschikbaar voor gratis downloaden en lokaal uitvoeren), zoals SDXL, werden vergezeld door een typische voor generatieve modellen met kenmerken zoals 'eeuwigdurende, wereldwijde, niet-exclusieve, gratis, onherroepelijke auteursrechtlicentie voor het reproduceren, voorbereiden, publiekelijk demonstreren, publiekelijk uitvoeren, sublicentiëren en verspreiden van aanvullend materiaal, zowel van het model zelf als van afgeleiden daarvan'. 'De drievoudige' voorziet echter in twee soorten licentiëring: — met zeer verzachtende formuleringen zoals 'Stability AI verleent je een niet-exclusieve, wereldwijde, niet-overdraagbare, niet-sublicentieerbare, herroepbare, gratis en beperkte licentie op intellectuele eigendom' — en .
Het gras zal niet tot goed leiden
Na een korte tijd kwam de gemeenschap tot de conclusie dat . En in wezen werd er een boycot van het ontwikkelingsbedrijf uitgeroepen, omdat men geen tijd en energie wilde verspillen aan het verder trainen van een ronduit rauwe en onhandig verwerkte model — met het besef dat Stability AI te allen tijde, op de kleinste whim van zijn mediabeheerders, de eerder verleende licentie aan een specifieke enthousiasteling die zo'n training uitvoert kan intrekken. De licentieovereenkomst is zo geformuleerd dat het voor niet-juristen die deze bestuderen de indruk wekt dat na het intrekken van de toestemming voor commercieel gebruik van SD3M de voormalige ontvanger verplicht zal zijn om alle door hem gemaakte afgeleiden van de hem verleende intellectuele eigendom te verwijderen, inclusief zowel de getrainde modellen (LoRA, tekstinversies, hele checkpoints) als hun afgeleiden (citaat: 'Bij beëindiging van deze Overeenkomst dient u alle Softwareproducten of Afgeleide Werken te verwijderen en het gebruik ervan te staken') — dat wil zeggen, de vruchten van het werk van andere mensen die deze afgeleide modellen als uitgangspunt voor hun eigen werk hebben gebruikt; en dat zonder enige compensatie, uitgevoerd uit pure enthousiasme.
Kort na het feit dat de golf van verontwaardiging hierover astronomische hoogte had bereikt, begonnen er berichten te verschijnen van professionele juristen, En wat betreft de review met een verbod op verder gebruik, zou die eigenlijk alleen betrekking moeten hebben op bepaalde ondersteunende producten met gesloten code, die Stability AI aan commerciële gebruikers zal overdragen (laten we zeggen, voor het versnellen en optimaliseren van de pre-training van dezelfde SD3M), maar het bedrijf heeft tot nu toe geen definitieve uitleg hierover gegeven. En het feit dat het al drie weken (ten tijde van het schrijven van dit artikel) stil is na de lancering van de 'drie' in open toegang, schaadt de reputatie van de ontwikkelaar veel meer dan het gras — dat door zijn creatie gegenereerde meisjes.
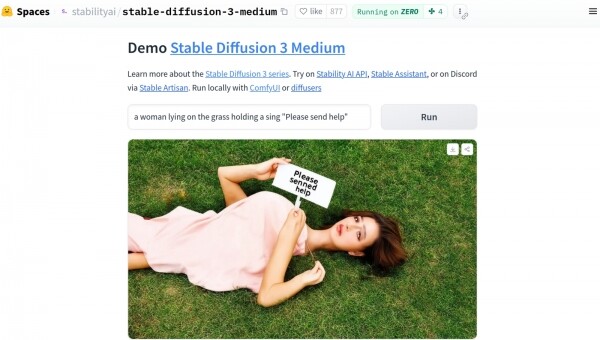
Wat betreft het beruchte gras, dat letterlijk in een paar uur een meme werd, , en vervolgens op praktisch alle meer of minder gespecialiseerde platforms op het net, blijkt dat het verschijnen van een frase als "een meisje dat op het gras ligt" in de suggesties leidt tot het genereren van niet alleen hallucinaties door de 'drie', maar ook nachtmerrieachtige creaties van een zieke — in medische zin — fantasie van kunstenaars en filmmakers die zich specialiseren in body horror (we smeken je, als je verstand en leven je dierbaar zijn, blijf weg van zoiets en probeer deze frase zelfs niet in het zoekvenster voor afbeeldingen zonder veiligheidsfilter in te voeren). Daarbij blijken afbeeldingen van staande — en in iets mindere mate zittende — mensen de 'drie' met een ruime vier met een plus te lukken, terwijl portretten soms zelfs perfect zijn; althans, niet slechter dan die van het basismodel SDXL 1.0 — het probleem ligt hier in een soort interne taboe op de horizontale positie van het menselijk lichaam.
Volgens de opmerking van Emad Mostaque, de oprichter en voormalige (tot maart 2024) hoofd van Stability AI, die het bedrijf heeft verlaten om , is het brute geweld tegen SD3M vlak voor de opening van zijn gewichten voor beperkt niet-commercieel gebruik (de API van het grotere model SD3 8B voor online generatie is, ter herinnering, , maar zijn gewichten blijven verborgen) een gevolg van de drang van het huidige management naar veiligheid — , die al in maart van dit jaar werden geformuleerd als . Binnen dit beleid, waarbij het generatieve model SD3M wordt toegepast, is het gebruikers niet toegestaan om "geweld, terrorisme of haatzaaiende inhoud te bewerkstelligen, te promoten, te vergemakkelijken, te plannen, aan te sporen of te ondersteunen die discrimineert of bedreigt tegen een beschermde groep mensen (ongeacht geslacht, etniciteit, seksuele identiteit of geaardheid, religie of anderszins)" - dus geen panda-afbeeldingen waar ze strijden tegen woeste draken! Alleen schattige katten in grappige hoeden, honden in schattige jasjes, flessen met onbekende inhoud en versgebakken koekjes!
Technisch gezien kan het zijn dat de verarming van het model erin bestond dat afbeeldingen van liggende mensen en andere foto's die op de een of andere manier een ongepaste interpretatie suggereerden, eenvoudigweg uit de trainingsdataset zijn geëxcludeerd - en daarom "begrijpt" de "drie" gewoon niet meer wat het woord "liggen" betekent. Of de vernieuwde architectuur van SD3 heeft het mogelijk gemaakt om de gewichten op de perceptrons, die zich activeren tijdens de generatie van "onveilige" afbeeldingen, met voldoende zekerheid te identificeren - en deze gewichten zijn vlak voor de release selectief gereset, wat als bijeffect "gedwongen hallucineren" heeft veroorzaakt. Misschien, : de encoder converteert tekst correct naar tokens, maar in de "beveiligde" latente ruimte verwijzen deze tokens al naar niets specifieks - en daarom worden de resulterende pixels in de afbeelding in feite willekeurig geplaatst.
Gezien de beschikbaarheid van de API voor het volledige, maar gesloten model SD3 8B gedurende enkele maanden en de enthousiaste beweringen van mediabeheerders van Stability AI dat de "gecomprimeerde" 2B , verwelkomden AI-tekenliefhebbers de publicatie van de gewichten van SD3M op 12 juni met veel enthousiasme: . Op dit moment is het nog steeds mogelijk om het te verkrijgen, zij het via een iets omslachtiger pad dan gebruikelijk voor de checkpoints SDXL en SD 1.5. Eigenlijk is het gebruikelijke pad — een bezoek aan de Civitai-website, waar de meeste modellen zonder registratie kunnen worden gedownload, maar sinds 17 juni en tot het moment dat dit artikel werd overgedragen voor opmaak, is de speciale pagina voor deze 'drie' van deze site . En de reden is één: de commerciële licentie voor SD3M is zo vaag geformuleerd dat zelfs de juristen van Civitai een pauze hebben genomen om deze grondiger te bestuderen. Want als een bepaalde enthousiasteling LoRA traint op zijn pc voor de 'drie' en deze op Civitai plaatst, en Stability AI besluit dat het resultaat onaanvaardbaar is en de licentie van de schuldige intrekt, — hoe moet de hostwebsite dan handelen? Het plaatst immers niet alleen checkpoints, ondersteunende cyclogrammen en modellen, maar biedt bezoekers ook de mogelijkheid voor cloudgeneratie van afbeeldingen en training van dezelfde LoRA's, tekstinversies, en meer. Kortom, zolang de rechtszaak aan de gang is, kunnen de modelbestanden en de drie bijbehorende tekst-tokens converters alleen worden verkregen .
Laten we beginnen
Echter, er is een nuance: om toegang te krijgen tot de downloadlinks, moet men zich aanmelden op de site en vervolgens de eerder genoemde draconische licentieovereenkomst accepteren — deze procedure is echter gratis en vanuit Rusland heel goed toegankelijk. Er zijn vier varianten van de eigenlijke modellen (models) en vier van de tekstprompt naar tokens converters (encoders) beschikbaar, plus drie referentiecyclogrammen voor uitvoering in de ComfyUI-werkomgeving, :
modellen:
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
codering:
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
cyclogrammen:
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
In deze "Workshop" beperken we ons tot het basis model sd3_medium.safetensors (4,2 GB), drie encoders — clip_g.safetensors (1,3 GB), clip_l.safetensors (234 MB) en t5xxl_fp8_e4m3fn.safetensors (4,7 GB), evenals de cyclusdiagram sd3_medium_example_workflow_multi_prompt.json. Het punt is dat op onze testmachine een GeForce GTX 1070 videokaart met 8 GB video-RAM geïnstalleerd is, en in dit volume passen geen grotere modellen met alle geïntegreerde converters tegelijk. Bij de checkpoints op basis van SD 1.5 en SDXL zijn de encoders standaard in het hoofd bestand ingebouwd, maar in dit geval zijn er zelfs niet twee, maar drie van deze converters, in totaal meer dan 6 GB — samen met het model zelf komt dat al boven de 10 GB; en als we de 16-bit versie van de T5XXL encoder nemen, dan hebben we een aanzienlijk krachtigere videokaart nodig. In de variant waarbij eerst de tekst naar tokens converters in het videogeheugen worden geladen, en dan het model dat met deze tokens werkt, kan zelfs met een 6 GB grafische adapter prima worden volstaan. Van dit perspectief gezien wint de modulaire "drie" absoluut van een typische SDXL-checkpoint met 5-7 GB.
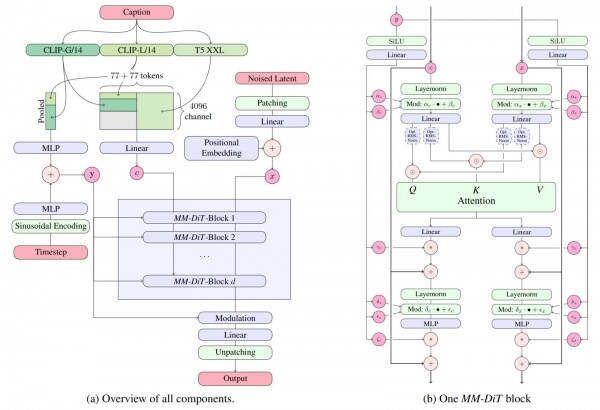
SD3M is een model gebaseerd op multimodale diffusietransformers () — en verschilt daarmee fundamenteel van eerdere ontwikkelingen van Stability AI (en niet alleen die), die steunen op "Workshop" is geen plek voor een diepgaande studie van het verschil tussen deze benaderingen van AI-gegenereerde afbeeldingen; laten we gewoon zeggen dat , de mogelijkheid om met een groter aantal tokens te werken (wat op zijn beurt de operator in staat stelt om vrij uitgebreide tekstprompten te formuleren, en het systeem — om daar nauwkeurig op te reageren), evenals een betere kwaliteit van de resulterende afbeeldingen. De full-size SD3 8B kan afbeeldingen genereren op een canvas van 4 MP (2048×2048 pixels), en in aspecten zoals het reproduceren van tekst in een afbeelding, de nauwkeurigheid van de overeenkomst tussen de verkregen afbeelding en de tekstprompt en de algemene visuele esthetiek. De conversie van tekst naar tokens wordt hier onmiddellijk door drie encoders uitgevoerd ( en één T5-XXL — "T5", trouwens, van ) — en, eigenlijk zijn ze niet verplicht om met dezelfde prompt te werken.
Maar genoeg met de inleiding: laten we ons concentreren op waar de 'Werkplaats' aan gewijd is - het genereren van afbeeldingen op basis van het SD3M-model. We gebruiken hiervoor, zoals al gezegd, de werkomgeving ComfyUI, die je kunt downloaden . Laten we benadrukken dat deze optie alleen geschikt is voor uitvoering op NVIDIA grafische adapters of rechtstreeks op AMD of Intel CPU's (wat uiteraard veel langzamer zal zijn): voor eigenaars van AMD videokaarten rocm en pytorch, die je kunt installeren via de pip downloadmanager.
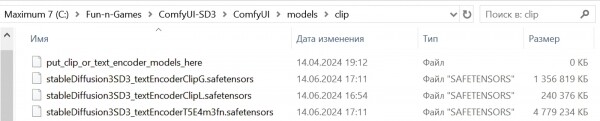
Na de installatie van de werkomgeving, moeten de eerder gedownloade .safetensors-bestanden worden geplaatst: modellen in de map ComfyUImodelscheckpoints, tekst-naar-token converters in ComfyUImodelsclip. En dan - kunnen we beginnen!
Het is tijd om te versnellen
Het is vermeldenswaard dat AUTOMATIC1111, die goed bekend is bij lezers van eerdere 'Werkplaatsen' over AI-tekenen, tegen het einde van juni ook , maar in ComfyUI is de ondersteuning voor het nieuwe model voorlopig het meest volledig. Geen verrassing - tot voor kort was de auteur van de 'pasta-monster', bekend binnen de gemeenschap van enthousiastelingen onder de nickname ComfyAnonimous, of gewoon Comfy, , waar hij onder andere werkte aan de interne werkomgeving die door de ontwikkelaars zelf wordt gebruikt. Zoals we iets later zullen zien, getuigt de nieuwste versie van ComfyUI echt van het feit dat de auteur bepaalde inside informatie heeft over hoe dit controversiële model is opgebouwd en functioneert - inzichten die de makers van andere werkomgevingen voor lokale uitvoering van Stable Diffusion 3 Medium om begrijpelijke redenen niet kunnen delen.
ComfyUI installeren in de draagbare (portable) versie op Windows is heel eenvoudig: na het downloaden van de bijbehorende ZIP-archief het is voldoende om het in een gewenste map uit te pakken; bij voorkeur natuurlijk op een logische partitie die op SSD is gebaseerd in plaats van op HDD, omdat de uitwisseling tussen de opslag en het geheugen, rekening houdend met de aanstaande laad- en ontlaadcycli van modellen, zelfs voor het genereren van slechts één afbeelding (de omgeving moet eerst de tekstverwerkers in tokens in het videogeheugen plaatsen, vervolgens het videogeheugen leegmaken en uiteindelijk de SD3M inladen) des te aanzienlijker wordt, naarmate deze computer minder videogeheugen beschikbaar heeft. Trouwens, de draagbare installatie is ook goed omdat het volledig onafhankelijk is: niets - behalve de beschikbare vrije ruimte op de logische schijf - verhindert het om lokaal zoveel kopieën van ComfyUI te draaien als je wilt om uitgebreid te experimenteren met verschillende extensies, zonder bang te zijn dat je een al goed functionerende en geoptimaliseerde systeem verpest.
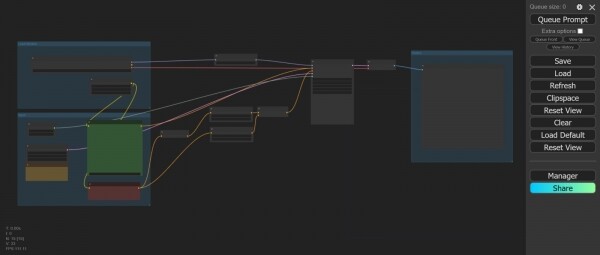
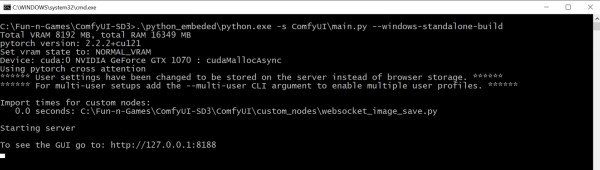
Zorg ervoor dat het bestand van het hoofd-SD3M-model zonder ingebouwde tekstverwerkers in tokens (bestand stableDiffusion3SD3_sd3Medium.safetensors, 4,2 GB) in de submap checkpoints is geplaatst (in ons testinstallatie is het volledige pad - C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), en dat de drie encoder-modellen (bestanden stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors en stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors; 1,3 GB, 234 MB en 4,7 GB respectievelijk) in de submap clip zitten (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip), dan kan de werkomgeving gestart worden door dubbel te klikken op het bestand run_nvidia_gpu.bat in de hoofdmap (in ons geval C:Fun-n-GamesComfyUI-SD3). Na het starten van de server zal er automatisch een nieuwe tab in de standaardbrowser worden geopend (dit is zoals gespecificeerd in de instellingen van het BAT-bestand) waarin de webinterface beschikbaar is op adres 127.0.0.1/8188. (laten we het alleen in eerste benadering 'de pasta-monster' noemen).
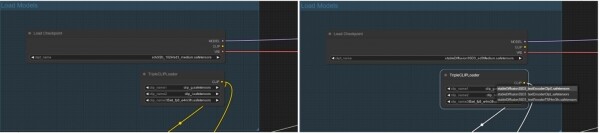
In principe, als je een modernere NVIDIA grafische kaart (uit de RTX-generatie, niet GTX, zelfs met slechts 6 GB videogeheugen) tot je beschikking hebt, kun je meteen het referentieworkflow-bestand van ComfyAnonimous laden waar eerder al over werd gesproken — het bestand comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json met meerdere invoervensters, één voor elke van de drie encoders, en ermee aan de slag gaan. Wel moet je eerst vier bestandsnamen van de modellen (in de laadknopen) aanpassen aan de beschikbare. De auteur van het referentieworkflow had kennelijk toegang tot zijn lokale bestanden op zijn werkplek (bij Stability AI, zoals eerder genoemd) die iets anders waren genoemd, zodat als je de knop 'Queue Prompt' in de spartaanse interface van ComfyUI indrukt direct na het laden van het workflow-bestand, de werkomgeving een foutmelding zal geven.
Drievelden voor AI-generatie
Echter, dat is vrij eenvoudig op te lossen: veel frustrerender is het feit dat onze oude GTX 1070 monstermatig langzaam SD3M verwerkt — de beeldgeneratie duurt 27-30 seconden per iteratie, en gezien het feit dat de parameter 'Steps' in het referentieworkflow is ingesteld op '28', kost het onredelijk veel tijd. Daarom zullen we een kleine optimalisatie doorvoeren — we zullen de Python-module venv gebruiken (), die bedoeld is om de snelheid van generatieve AI-modellen te verhogen. De portable versie van ComfyUI bevat deze niet, , die uiteindelijk neerkomen op het opzetten van een volledige Python-omgeving op een lokale PC — en het activeren van de benodigde module vanuit deze omgeving.
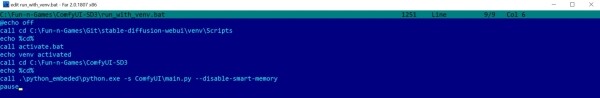
Laten we hopen dat onze lezers die onze 'Workshops' volgen al beschikken over een actieve werkinstallatie van AUTOMATIC1111 op hun machines. In dat geval is alles veel eenvoudiger: de venv-module is daar al opgezet, en alles wat je hoeft te doen om deze te activeren bij het starten van de ComfyUI-werkomgeving, is . Om te beginnen moet je de server afsluiten door het venster te schakelen en op 'Ctrl' + 'C' te drukken, en vervolgens 'y' in te voeren ter bevestiging; daarna kopieer je het BAT-bestand run_nvidia_gpu.bat naar een nieuw bestand met de naam run_with_venv.bat. Het oorspronkelijke opstartbestand is vrij beknopt — het roept eenvoudigweg een draagbare kopie van Python op met de parameter —windows-standalone-build:
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pause
Deze parameter is op zichzelf niet erg duidelijk — het impliceert enkele optimalisaties die waarschijnlijk specifiek zijn voor nieuwere NVIDIA grafische adapters en kan het leven van degenen die trouw blijven aan hun bekwame GTX-materiaal verzwaren. Daarom verwijderen we —windows-standalone-build uit de opdrachtregel, en tegelijk nemen we afscheid van een andere trendy optimalisatie — de standaard geactiveerde 'slimme geheugenbeheerder', smart memory, die , zonder deze te ontladen. Dit versnelt inderdaad het tekenen van AI-afbeeldingen, maar verandert tegelijkertijd onze moreel verouderde computer in een één taak systeem — het wordt onmogelijk om tegelijkertijd te surfen op het web, te gamen of zelfs documenten en e-mails op de pc te bewerken naast de actieve werkomgeving. Voor degenen die niet over een speciale computer voor AI-kunst beschikken, lijkt een dergelijk BAT-bestand voor het starten van ComfyUI (niet alleen voor het genereren van afbeeldingen met SD3M, overigens — het is ook prima geschikt voor SDXL):
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
echo %
call activate.bat
echo venv geactiveerd
call cd C:Fun-n-GamesComfyUI-SD3
echo %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pause
Hier wordt aangenomen dat de draagbare installatie van ComfyUI zich in de map C:Fun-n-GamesComfyUI-SD3 bevindt, en dat AUTOMATIC1111 eerder is geïnstalleerd in C:Fun-n-GamesGitstable-diffusion-webui. Meerdere 'echo' zijn nodig voor visuele controle dat de directorywijzigingen goed verlopen en de benodigde commando's worden uitgevoerd — nadat alles is gedebugd, kunnen ze uit het BAT-bestand worden verwijderd.
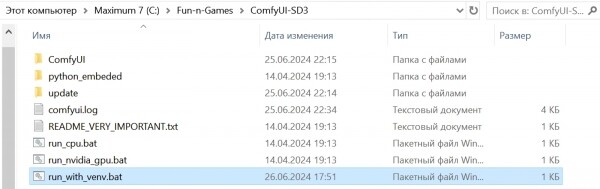
We starten de werkomgeving opnieuw door tweemaal op run_with_venv.bat te klikken. Aangezien we de server eerder gewoon hebben gesloten en de webinterface niet hebben aangeraakt, zou de betreffende tab nog steeds de oorspronkelijke flowchart van ComfyUI moeten tonen met de gecorrigeerde modelnamen. Laten we aandacht besteden aan de rechterkant: daar bevindt zich de 'Preview Image' node, die de afbeelding niet op de schijf opslaat, maar deze alleen toont. Als je elke keer de flowchart runt om precies één afbeelding te genereren, deze visueel beoordeelt, wijzigingen aanbrengt in de parameters en opnieuw start, is dat een werkbare optie: de gewenste afbeelding kan altijd handmatig worden opgeslagen door met de rechtermuisknop op de afbeelding te klikken. Maar als je in de werkomgeving achtereenvolgens veel generaties uitvoert, is het beter dat de resultaten automatisch in het permanente geheugen (in de ComfyUIoutput directory standaard) worden opgeslagen.
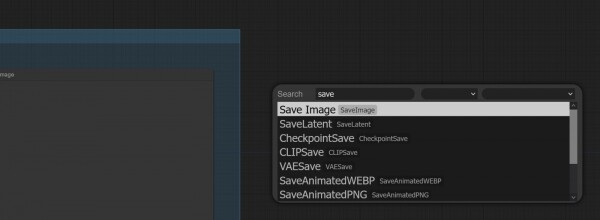
Dus het is beter om de 'Preview Image' node meteen te vervangen door 'Save Image'. Hiervoor dubbelklik je met de linkermuisknop op een vrij gedeelte van de flowchart - er opent een venster voor het kiezen van nodes met een zoekbalk. In deze balk beginnen we 'Save…' in te typen - en vrijwel onmiddellijk zullen we de gewenste naam zien. Vervolgens hoef je alleen nog maar op deze naam te klikken en de ingang van de nieuw verschenen node aan te sluiten op de uitgang 'IMAGE' van de 'VAE Decode' node, waaraan aanvankelijk de 'Preview Image' was aangesloten. Je kunt de 'Preview Image' dan verwijderen - selecteer deze gewoon door op de kop te klikken en druk op de toets 'Del' op het toetsenbord.
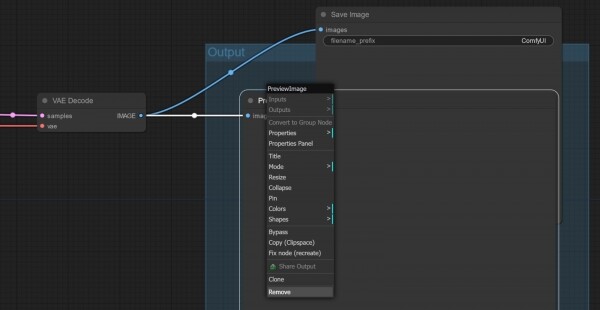
En nu is het tijd om de oorspronkelijke flowchart van ComfyAnonimous (met onze bescheiden correcties) uit te voeren. Dit is het resultaat:
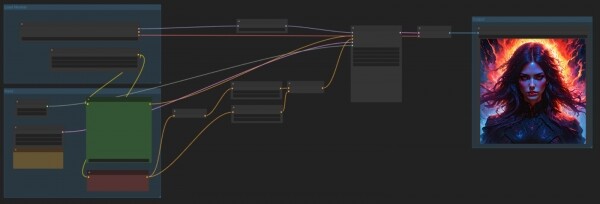
Een zeer indrukwekkende afbeelding, zelfs met wat sfeer - en je zou niet zeggen dat deze is gemaakt met hetzelfde model dat de instructie heeft om mensen die op het gras liggen te tekenen. Bovendien werkt het systeem vrij vlot - ongeveer 5-6 seconden per iteratie voor een afbeelding van 1 MP op de GTX 1070 kan als een goede indicatie worden beschouwd. Ter vergelijking: dezelfde PC met dezelfde ComfyUI en hetzelfde BAT-bestand genereert SDXL-afbeeldingen van vergelijkbare grootte, met ongeveer 6-7 seconden per iteratie, dus het 'drie' model kan als minder veeleisend voor de hardware van de PC worden erkend, waarop de AI-generatie plaatsvindt.
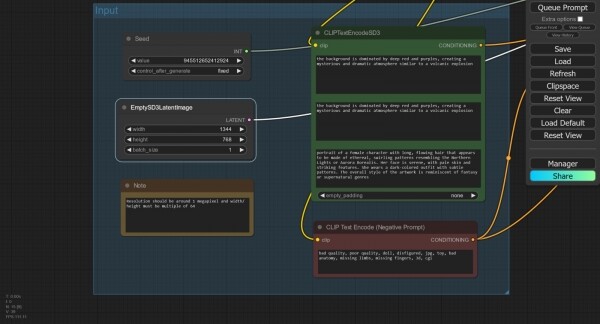
Laten we nu de afmetingen van het canvas aanpassen. Dichtbij de node 'EmptySD3LatentImage', die deze instelt, bevindt zich de 'lege' (in de zin van niet met iets of iemand verbonden) hulpprogramma-node 'Note', waar een belangrijke herinnering staat: de totale oppervlakte van de afbeelding in het geval van SD3M moet ongeveer 1 MPixel zijn, waaruit we de afmetingen van de zijden van het rechthoekige canvas moeten kiezen. We stellen ze dan in op 1344×768 — wat ongeveer 1,03 MPixel oplevert.
Laten we opmerken: hierboven bevindt zich de node 'Seed', waar de basiszaadwaarde is ingesteld, in dit geval '945512652412924', en is aangegeven dat deze na de generatie niet moet veranderen (parameter 'fixed').
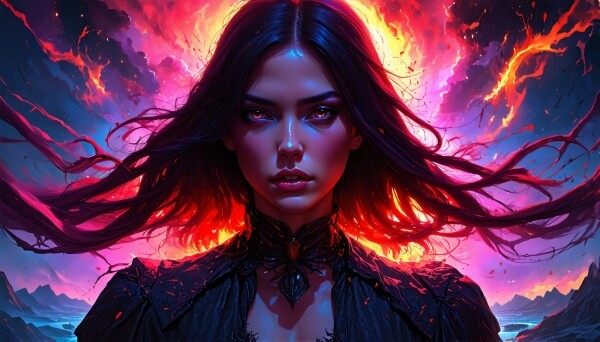
We voeren dezelfde cyclus uit met de vorige zaadwaarde, maar nu voor een rechthoekig canvas. Het valt meteen op dat de totale uitvoeringstijd korter is, hoewel de renderingssnelheid hetzelfde blijft — minder dan 6 seconden per iteratie. Dit is logisch: aangezien de tekstsuggesties niet zijn veranderd, is het niet nodig om de encoder(s) opnieuw te laden. De afbeelding aan de output is, begrijpelijk, een beetje anders dan de eerste, vierkante, maar niet principieel — de algemene compositie, zoals verwacht, is behouden.
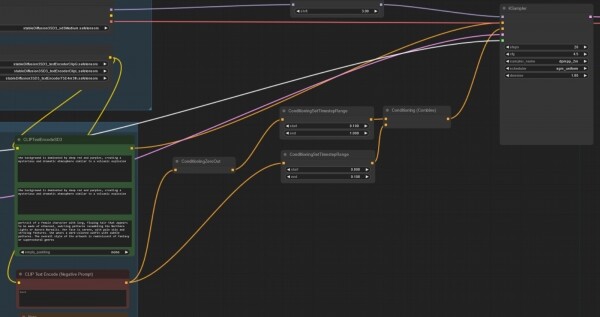
Laten we nu aandacht besteden aan de nodes 'CLIPTextEncodeSD3' en 'CLIP Text Encode (Negative Prompt)'. De eerste valt op doordat het drie invoervelden bevat; als we de tekst eruit verwijderen, worden de opmerkingen zichtbaar voor welke encoders ze bedoeld zijn — van boven naar beneden zijn dit CLIP G, CLIP L en T5XXL. Eerder waren dergelijke nodes om begrijpelijke redenen niet beschikbaar in ComfyUI. De referencyclus bevat duplicate korte suggesties voor de eerste twee tekstvelden (voor de converters CLIP G en CLIP L) en een veel uitgebreidere voor het derde — T5XXL. Het is duidelijk dat de inhoud van deze velden in ruime mate kan worden aangepast, en het zelf onderzoeken in hoeverre het wijzigen van de tekst daarin de uiteindelijke afbeelding beïnvloedt, is een niet-triviale maar uiterst interessante taak. Echter, om redenen die later duidelijk zullen worden, zullen we ons momenteel niet volledig op deze taak richten.
In the node 'CLIP Text Encode (Negative Prompt)', however, there is nothing special—yet consider how complex the path is from it to the corresponding 'conditioning' input of the main node 'KSampler'! This path diverges, with one of its branches (the upper one in this case) indicating that starting from 10% of the generation steps and until completion, the system will not take the negative prompt into account at all (the passage through the node 'ConditioningZeroOut' essentially means nullifying the condition). Meanwhile, the second branch passes the negative prompt (also conditionally with half weight) to further processing unchanged—but only for the first 10% of the total generation steps.
Foggy distance
Once again: the first 10%, i.e., 3 out of 28 assigned in this case, the negative prompt is passed to the node 'KSampler', which is responsible for generating the image in latent space (into pixel space, i.e. into a comprehensible image for humans, the result of which is translated by the next node, 'VAE Decoder'), in a normal way: the upper branch (with condition nullification) is inactive, only the lower one works. The remaining 90% of the steps (25 out of 28 in our case) do not utilize the negative prompt at all: the upper branch controlling the conditions is active—nullifying them—while movement along the lower one is blocked by the boundary parameter triggering the corresponding node 'ConditioningSetTimestepRange'. Now it’s clear why a number of reviewers assert that ,—the effect from them (if considering this particular, supporting, cyclegram and assuming that similar rules apply on websites with online generation based on the SD3 Medium model) is minimal.
Toch bestaat het: als je gewoon de uitgang van de node 'CLIP Text Encode (Negative Prompt)' rechtstreeks verbindt met de juiste ingang van 'KSampler' (of alle tussenliggende nodes op deze route markeert als 'overgeslagen', 'Bypass', wat hetzelfde effect zal hebben), zal de kwaliteit van de uiteindelijke afbeelding merkbaar verslechteren. Dit kan trouwens worden beschouwd als indirect bewijs van de 'ongekooktheid' van SD3M, omdat het de ontwikkelaars, strikt genomen, al in staat had moeten zijn om de kracht en betekenis van de negatieve prompt te regelen voordat de gewichten van het model openbaar werden gemaakt. Twee takken van slim geformuleerde voorwaarden voor het toepassen van de negatieve prompt zijn een soort patch, en in die zin zoals door de marketingafdeling van Stability AI opgeblazen, lijken heel gerechtvaardigd.
Het gebrek aan zelfs een beknopte officiële handleiding voor het werken met SD3M heeft ertoe geleid dat er al geruchten rondgaan dat dit model Wat natuurlijk niet waar is, maar in ieder geval moeten deze prompts heel anders worden toegepast dan In het bijzonder beweren enthousiaste gebruikers heel serieus dat het toevoegen van zo veel mogelijk gedetailleerde beschrijvingen van ongepastheden aan het negatieve veld (ja, ja, de goede oude 'nsfw, nude' is niet genoeg - we zullen echt onze verbeelding moeten gebruiken) zelfs van het beruchte meisje dat op het gras ligt. Of dit zo is of niet, kan niet worden vastgesteld zonder grondige controle (en het is niet zeker dat zelfs de label '18+' bovenaan onze website ons beschermt tegen rechtszaken van woedende morele waakzame, als we het risico nemen om de door enthousiastelingen samengestelde 'wonder-prompt' te publiceren - ongeacht dat het in het Engels is). Deze grappige situatie doet denken aan een casus met waardoor - precies omdat ze vrij gedetailleerde beschrijvingen bevatten van wat en hoe goede christenen niet zouden moeten doen - ten minste fragmentarische schriftelijke getuigenissen over de geloven en gewoonten van het voorchristelijke Rusland tot ons zijn gekomen.
Nu, hopen we, is het duidelijker waarom het op dit moment niet de meest verstandige investering van tijd en moeite lijkt om verder te gaan met het bestuderen van SD3M. Er is daar inderdaad veel te bespreken en te onderzoeken: van de strik aanbevolen generatiewaarden in de "KSampler" node (CFG - 4,5-5,0; aantal stappen - ongeveer 28; paar sampler/scheduler - uitsluitend dpmpp_2m/sgm_uniform, anders daalt de kwaliteit van de output merkbaar); en de aanzienlijke variatie in subjectieve kwaliteit van generaties met precies dezelfde startparameters, maar met verschillende prompts; tot het afkomen van de beruchte "vloeken van liggen in/op het gras" (waarvoor al ); en, in feite, het vaststellen op welke generatiewaarden elk van de drie tekst-naar-token converters invloed heeft — en hoe, door deze te gebruiken, echte meesterwerken van AI-kunst te creëren (als dat überhaupt met de "drie" mogelijk is).
Zeker gezien het feit dat het ontslag van Emad Mostaque in maart en ComfyAnonymous in juni, , — niet de enige problemen zijn waarmee Stability AI te maken heeft. Zoals Reuters meldt op basis van The Information, heeft deze Britse start-up letterlijk net (op het moment van schrijven van dit artikel) opnieuw die nu Prem Akkaraju is geworden, een vertegenwoordiger van de bekende wereldwijde IT-investeerdersgroep — en deze is bereid om een aanzienlijk bedrag in het bedrijf te investeren (). De positie van Stability AI als bedrijfsstructuur is vandaag de dag openlijk onstabiel; veel teleurgestelde — en in zo'n situatie is het moeilijk om van het bedrijf doordachte inspanningen te verwachten, zelfs niet voor zulke voor de hand liggende fouten.
Helaas houdt het slecht doordachte licentiebeleid de gemeenschap ervan om SD3M zelfstandig verder te ontwikkelen, zoals dat met SD 1.5 en SDXL gebeurde. Althans de afgeleide checkpoints en tools zoals LoRA voor de laatste twee modellen zullen zeker beschikbaar blijven voor lokaal gebruik, zelfs als (en wanneer) Stability AI zijn weg als commerciële organisatie beëindigt. Meteen na de overweldigende mislukking van 'de drie' weerklonken op gespecialiseerde forums op het internet steeds vaker stemmen ter ondersteuning van het creëren van een non-profitproject voor de ontwikkeling van een generatief model voor het omzetten van tekst in beelden op basis van crowdfunding, — en tot nu toe begint deze beweging zich te vormen onder de naam . Invoke (een van de platforms voor online AI-generatie, gericht op professionele studio's), Comfy Org (het team dat zich bezighoudt met de ondersteuning en ontwikkeling van ComfyUI), Civitai (dat geen introductie behoeft) en het team achter LAION (de database met geannoteerde afbeeldingen, waarop deze modellen voornamelijk worden getraind) hebben al hun bereidheid om zich actief aan te sluiten bij dit initiatief verklaard.
Dus in de nabije toekomst zullen nieuwe uitgaven van de 'Werkplaats' waarschijnlijk gericht zijn op het werken met die modellen waarvoor de gemeenschap al een breed scala aan verbeteringen en extra tools heeft gecreëerd, — de 'anderhalvengrootte' en de 'Oversized'. Misschien komt de tijd van SD3M nog, — maar vandaag is het moeilijk zelfs maar te raden wanneer dat precies zal zijn. Ondertussen kunnen geïnteresseerden een archief downloaden met de generaties van SD3M die in dit artikel worden genoemd (de cyclogrammen zijn rechtstreeks in de PNG-bestanden geïntegreerd; het is genoeg om de afbeelding vanuit de Windows Verkenner naar het werkveld van ComfyUI te slepen om de volledige volgorde en parameters van de generatie te reproduceren) . Misschien kan iemand uit onze lezers nog vóór de regelmatige bezoekers van Reddit en Hugging Face een optimale manier vinden om de tekst over de drie velden van de prompt te verdelen, bijvoorbeeld?
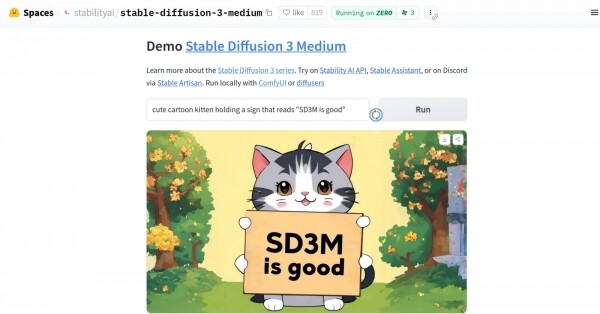
Gerelateerde artikelen:
.
.
.
.
.
Bron: 3dnews.ru
