

Er is een gedetailleerde handleiding gepubliceerd voor het tunen van de Linux-omgeving om de maximale prestaties bij het verwerken van HTTP-verzoeken te bereiken. De voorgestelde methoden hebben de prestaties van de JSON-handler, gebaseerd op de libreactor-bibliotheek, in de Amazon EC2-omgeving (4 vCPU) verhoogd van 224 duizend API-verzoeken per seconde met standaardinstellingen van Amazon Linux 2 met kernel 4.14 naar 1,2 miljoen verzoeken per seconde na optimalisatie (een stijging van 436%), en resulteerde ook in een vermindering van de latentie bij het verwerken van verzoeken met 79%. De voorgestelde methoden zijn niet specifiek voor libreactor en werken ook met andere http-servers, waaronder nginx, Actix, Netty en Node.js (libreactor werd in de tests gebruikt omdat de oplossing op basis daarvan de beste prestaties vertoonde).
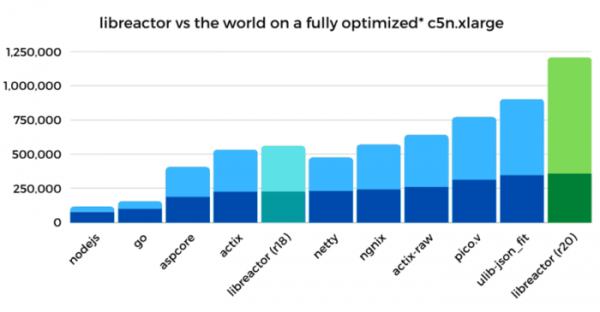
Belangrijkste optimalisaties:
- Optimalisatie van de libreactor-code. De basis was de R18-variant uit de Techempower-set, die is verbeterd door de code te verwijderen die het aantal gebruikte CPU-kernen beperkt (de optimalisatie leidde tot een versnelling van 25-27%), compileren met GCC met de opties "-O3" (stijging van 5-10%) en "-march-native" (5-10%), het vervangen van read/write-aanroepen door recv/send (5-10%) en het verlagen van overhead bij het gebruik van pthreads (2-3%). De totale prestatieverbetering na het optimaliseren van de code was 55%, en de doorvoer steeg van 224k req/s tot 347k req/s.
- Het uitschakelen van bescherming tegen kwetsbaarheden veroorzaakt door speculatieve uitvoering van instructies. Het gebruik van parameters bij het opstarten van de kernel "nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off" verhoogde de prestaties met 28%, en de doorvoer steeg van 347k req/s tot 446k req/s. De afzonderlijke stijging van de parameter "nospectre_v1" (bescherming tegen Spectre v1 + SWAPGS) was 1-2%, "nospectre_v2" (bescherming tegen Spectre v2) 15-20%, "pti=off" (Spectre v3/Meltdown) 6%, en "mds=off tsx_async_abort=off" (MDS/Zombieload en TSX Asynchronous Abort) 6%. De instellingen voor bescherming tegen L1TF/Foreshadow-aanvallen (l1tf=flush), iTLB multihit, Speculative Store Bypass en SRBDS blijven ongewijzigd, aangezien ze geen invloed hadden op de prestaties omdat ze niet in conflict kwamen met de geteste configuratie (bijvoorbeeld specifiek voor KVM, geneste virtualisatie en andere CPU-modellen).
- Het uitschakelen van auditmechanismen en het blokkeren van systeemaanroepen met behulp van de opdracht "auditctl -a never,task" en het opgeven van de optie "--security-opt seccomp=unconfined" bij het starten van de Docker-container. De totale prestatieverbetering was 11%, en de doorvoer steeg van 446k req/s tot 495k req/s.
- Uitschakelen van iptables/netfilter door het uitladen van de bijbehorende kernelmodules. De gedachte om de firewall uit te schakelen, die niet werd gebruikt in de specifieke serveroplossing, werd gestimuleerd door profielen die aangaven dat het uitvoeren van de functie nf_hook_slow 18% van de tijd in beslag nam. Het wordt opgemerkt dat nftables efficiënter werkt dan iptables, maar iptables blijft nog steeds gebruikt in Amazon Linux. Na het uitschakelen van iptables was er een prestatieverbetering van 22%, en de doorvoer nam toe van 495k req/s naar 603k req/s.
- Vermindering van migratie van verwerkers tussen verschillende CPU-cores om de efficiëntie van de gebruik van de processork cache te verhogen. De optimalisatie werd uitgevoerd op zowel het niveau van procesbinding van libreactor aan CPU-cores (CPU Pinning) als via het vastleggen van netwerkinvoerverwerkers (Receive Side Scaling). Bijvoorbeeld, irqbalance is uitgeschakeld en de bindngen van wachtrijen aan de CPU zijn expliciet ingesteld in /proc/irq/$IRQ/smp_affinity_list. Voor het gebruik van dezelfde CPU-core voor het verwerken van libreactor-processen en de netwerkwachtrij van inkomende pakketten is een eigen BPF-handler ingezet, verbonden via het instellen van de SO_ATTACH_REUSEPORT_CBPF-vlag bij het maken van de socket. Voor de binding van de CPU aan uitgaande pakketwachtrijen zijn de instellingen in /sys/class/net/eth0/queues/tx-<n>/xps_cpus gewijzigd. De totale prestatieverbetering was 38%, en de doorvoer steeg van 603k req/s naar 834k req/s.
- Optimalisatie van interruptverwerking en gebruik van polling. Het inschakelen van de adaptive-rx modus in de ENA-driver en manipulaties met sysctl net.core.busy_read hebben geleid tot een prestatieverbetering van 28% (de doorvoer steeg van 834k req/s naar 1.06M req/s, en de latentie daalde van 361μs naar 292μs).
- Uitschakelen van systeemdiensten die leiden tot onnodige blokkades in de netwerkstack. Het uitschakelen van dhclient en handmatige instelling IP-adressen leidde tot een prestatieverbetering van 6%, en de doorvoer steeg van 1.06M req/s naar 1.12M req/s. De reden voor de impact van dhclient op de prestaties is geanalyseerd met behulp van raw-socket traffic.
- Strijd tegen Spin Lock. De netwerkstack in de 'noqueue'-modus zetten via sysctl 'net.core.default_qdisc=noqueue' en 'tc qdisc replace dev eth0 root mq' leidde tot een prestatieverbetering van 2%, en de doorvoer steeg van 1.12M req/s naar 1.15M req/s.
- Eindelijke kleine optimalisaties, zoals het uitschakelen van GRO (Generic Receive Offload) met het commando "ethtool -K eth0 gro off" en het vervangen van het algoritme voor congestiecontrole cubic door reno via sysctl "net.ipv4.tcp_congestion_control=reno". De totale prestatieverbetering was 4%. De doorvoersnelheid steeg van 1,15M req/s naar 1,2M req/s.
Naast de werkende optimalisaties worden in het artikel ook methoden besproken die niet hebben geleid tot de verwachte prestatieverbetering. Bijvoorbeeld, de volgende bleken ineffectief:
- Een aparte uitvoering van libreactor vertoonde geen verschil in prestaties vergeleken met uitvoering in een container. De vervangingen van writev door send, het verhogen van maxevents in epoll_wait en experimenten met versies en vlaggen van GCC hadden geen invloed (het effect was alleen merkbaar voor de vlaggen "-O3" en "-march-native").
- De prestatie werd niet beïnvloed door de update van de Linux-kernel naar versies 4.19 en 5.4, het gebruik van de planningsstrategieën SCHED_FIFO en SCHED_RR, manipulaties met sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 en clocksource=tsc.
- In de ENA-stuurprogramma had het inschakelen van Offload-modi (segmentation, scatter-gather, rx/tx checksum), het bouwen met de vlag "-O3" en het toepassen van de parameters ena.rx_queue_size en ena.force_large_llq_header geen invloed.
- De wijzigingen in de netwerkmiddleware leidden niet tot prestatieverbeteringen:
- Uitschakelen van IPv6: ipv6.disable=1
- Uitschakelen van VLAN: modprobe -rv 8021q
- Uitschakelen van de controle van de bron van het pakket
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (negatief effect)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Bron: opennet.ru
