

Het bedrijf XTX Markets heeft de broncode van het TernFS-bestandssysteem vrijgegeven, dat is ontworpen voor het creëren van een gedistribueerde opslag die meerdere geografisch gescheiden datacenters beslaat en in staat is om tot tientallen exabytes aan gegevens, triljarden bestanden en honderden miljarden mappen op te slaan, waarmee miljoenen klanten tegelijkertijd kunnen interageren. De projectcode is geschreven in C++ en Go en wordt verspreid onder de GPLv2-licentie. De specificaties van het protocol en de clientbibliotheken worden geleverd onder de Apache 2.0-licentie.
Het bestandssysteem is geoptimaliseerd voor workloads die typerend zijn voor machine learning-systemen — het lezen en schrijven van bestanden die na creatie niet meer gewijzigd worden en die meer dan enkele megabytes aan gegevens bevatten. Het bestandssysteem is niet ontworpen voor frequente aanmaak van nieuwe mappen of het frequent verplaatsen van bestanden tussen mappen. Er zijn mogelijkheden voor het herstellen van per ongeluk verwijderde bestanden of mappen, evenals voor het instellen van beleid voor permanente verwijdering. De inhoud van het bestandssysteem kan tussen verschillende datacenters in verschillende regio's worden gerepliceerd. Opslagknopen kunnen verschillende soorten opslagmedia bevatten (op basis van schijven en flash-geheugen).
Een van de ontwerpeisen was het ontbreken van een single point of failure en het waarborgen van hoge betrouwbaarheid van opslag — stroomuitval mag niet leiden tot schade aan het bestandssysteem, en bestanden kunnen niet gedeeltelijk worden geschreven (alleen volledig geschreven bestanden zijn toegankelijk voor lezen). Het systeem is bestand tegen het falen van individuele opslagmedia, knopen met metadata en opslagknopen. Het is mogelijk om het opslagbeheer uit te voeren zonder dat de werking wordt stopgezet.
De implementatie van de opslag op basis van TernFS bij XTX Markets begon in de zomer van 2023, na anderhalf jaar ontwikkeling van het bestandssysteem. Halverwege 2024 waren alle machine learning-systemen van XTX Markets overgeschakeld naar TernFS. Op dit moment bestaat de opslag uit meer dan 30.000 schijven en 10.000 flash-geheugen, gespreid over drie datacenters. Het totale volume van de opgeslagen gegevens wordt geschat op 500 petabyte, en de piekprestaties zijn enkele petabytes per seconde. De opslag wordt gebruikt in een cluster met meer dan 100.000 rekeneenheden. Gedurende twee jaar gebruik zijn er geen incidenten geweest die tot dataverlies hebben geleid.
Onder de beperkingen van TernFS vallen: geregistreerde bestanden kunnen niet worden gewijzigd; lage efficiëntie bij het werken met bestanden kleiner dan 2 MB; lage prestaties bij het aanmaken en verwijderen van mappen; afwezigheid van toegangscontrole.
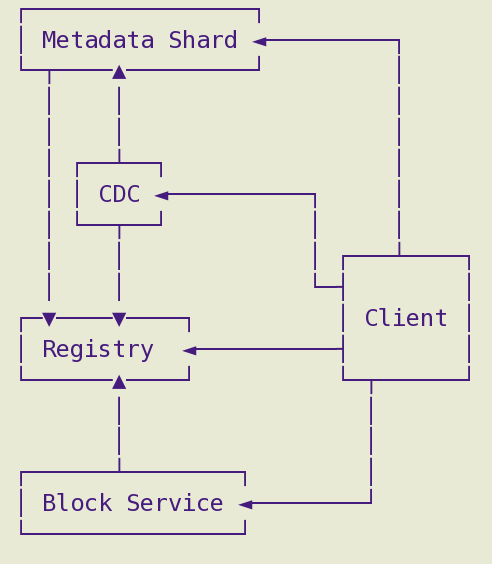
De componenten die de opslagcluster TernFS vormen:
- Metadata-opslagknopen die verantwoordelijk zijn voor het beheer van informatie over de mappestructuur en bestandsattributen.
- Coördinatieknooppunten (CDC - Cross-Directory Coordinator) die transacties uitvoeren die verschillende mappen omvatten.
- Opslagdiensten die zorgen voor de opslag van de inhoud van bestanden.
- Een register dat informatie bevat over alle andere diensten en hun werking monitort.
- Clientdiensten voor gebruikers om toegang te krijgen tot het bestandssysteem:
- ternweb - toegang tot de opslag via Web API.
- terncli - commandoregelinterface.
- ternfs.ko - module voor de Linux-kernel die het mogelijk maakt om opslag te monteren voor gebruik als lokale FS.
- ternfuse - implementatie van een client voor het werken met het bestandssysteem, gebruikmakend van de FUSE-subsystem.
- terns3 - implementatie van de Amazon S3 API.
- Achtergrondprocessen:
- GC - garbage collector die verlopen snapshots (verwijderde, maar niet opgeruimde bestanden) vrijgeeft en blokken opruimt voor onomkeerbaar verwijderde bestanden.
- scrubber - detectie van gegevensdegradatie en herstel.
- migrator - uitsluiting van defecte schijven uit de opslag.
Bron: opennet.ru
