

Het OpenAI-project, dat zich richt op de ontwikkeling van openbare projecten op het gebied van kunstmatige intelligentie, heeft ontwikkelingen gepubliceerd die verband houden met het spraakherkenningssysteem Whisper. Er wordt beweerd dat het systeem voor spraak in het Engels niveaus van betrouwbaarheid en nauwkeurigheid van automatische herkenning biedt die vergelijkbaar zijn met die van menselijke herkenning. De broncode van de referentie-implementatie is openbaar gemaakt op basis van het PyTorch-framework en een set al getrainde modellen die klaar zijn voor gebruik. De code is vrijgegeven onder de MIT-licentie.
Voor het trainen van het model zijn 680.000 uur aan spraakgegevens gebruikt, verzameld uit verschillende collecties die verschillende talen en thematische gebieden bestrijken. Ongeveer 1/3 van de spraakgegevens die voor training zijn gebruikt, zijn in andere talen dan het Engels. Het voorgestelde systeem is in staat om situaties effectief te verwerken, zoals accenten, achtergrondgeluiden en het gebruik van technische jargon. Naast het transcriberen van spraak naar tekst, kan het systeem ook spraak van elke taal naar het Engels vertalen en spraakdetectie in een geluidsstroom uitvoeren.
De modellen zijn vormgegeven in twee representaties: een model voor de Engelse taal en een meertalige model dat ook Russisch, Oekraïens en Wit-Russisch ondersteunt. Elk model wordt verder onderverdeeld in 5 varianten, die verschillen in grootte en aantal parameters die in het model zijn opgenomen. Hoe groter de grootte, hoe groter de nauwkeurigheid en kwaliteit van de herkenning, maar ook hoe hoger de vereisten aan het geheugen van de GPU en lager de prestaties. Bijvoorbeeld, de minimale variant bevat 39 miljoen parameters en vereist 1 GB videogeheugen, terwijl de maximale variant 1550 miljoen parameters bevat en 10 GB videogeheugen vereist. De minimale variant is 32 keer sneller dan de maximale.
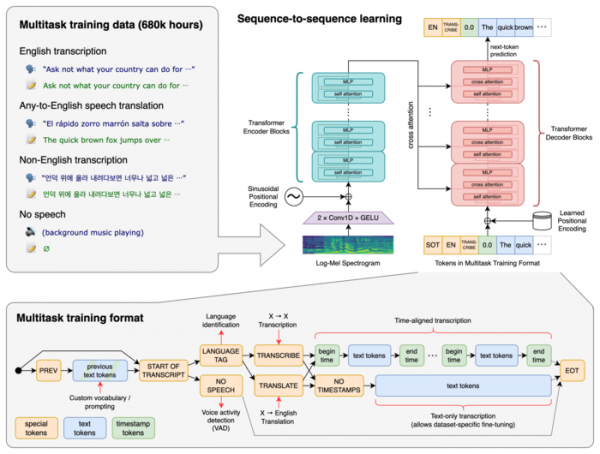
In het systeem wordt de transformer-architectuur voor neurale netwerken gebruikt, die bestaat uit een encoder en decoder die met elkaar communiceren. Geluid wordt verdeeld in fragmenten van 30 seconden, die worden omgezet in een log-Mel-spectrogram en naar de encoder worden gestuurd. Het resultaat van de encoder gaat naar de decoder, die een tekstuele weergave voorspelt, gemengd met speciale tokens die het mogelijk maken om binnen één model taken uit te voeren, zoals talendetectie, het bijhouden van de chronologie van uitspraken, spraaktranscriptie in verschillende talen en vertaling naar het Engels.
Bron: opennet.ru
