

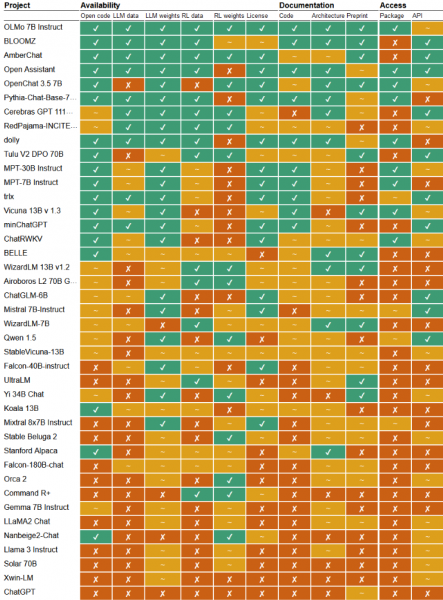
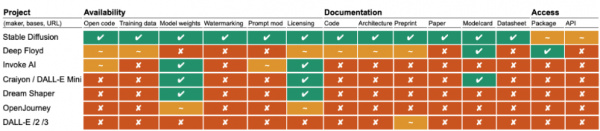
Onderzoekers van de Radboud Universiteit Nijmegen (Nederland) hebben een ranglijst opgesteld van de openheid van 40 grote taalmodellen en 7 modellen voor het genereren van afbeeldingen op basis van tekstbeschrijvingen, die door de fabrikanten als open zijn aangeduid. Omdat de criteria voor de openheid van machine learning-modellen nog in ontwikkeling zijn, is er momenteel een situatie ontstaan waarin modellen worden gepresenteerd als open, terwijl ze in werkelijkheid gelicenseerd zijn met beperkingen in het gebruik (bijvoorbeeld veel modellen staan geen toepassing in commerciële projecten toe). Ook bieden fabrikanten vaak geen toegang tot de gegevens die voor de training zijn gebruikt, onthullen ze geen details van de implementatie, of maken ze de bijbehorende code niet volledig openbaar.
De meeste modellen die als 'open' worden gepositioneerd, moeten in feite worden beschouwd als 'open gewichten' of beter gezegd 'toegankelijke gewichten', aangezien ze onder beperkende licenties worden verspreid die het gebruik in commerciële producten verbieden. Externe onderzoekers kunnen experimenteren met dergelijke modellen, maar hebben niet de mogelijkheid om het model aan te passen aan hun behoeften of de implementatie te inspecteren. Meer dan de helft van de modellen biedt geen gedetailleerde informatie over de gegevens die voor de training zijn gebruikt en publiceert ook geen informatie over de interne structuur en architectuur.
De meest open modellen zijn BloomZ, AmberChat, OLMo, Open Assistant en Stable Diffusion, die onder open licenties zijn gepubliceerd samen met de oorspronkelijke gegevens, code en API-implementatie. Modellen van Google (Gemma 7B), Microsoft (Orca 2) en Meta (Llama 3), die door de fabrikanten als open worden gepositioneerd, bleken verder onderaan de ranglijst te staan, omdat ze geen toegang bieden tot de oorspronkelijke gegevens, technische details van de implementatie niet onthullen en de gewichten van het model onder licenties verspreiden die het gebruik beperken. Het populaire model Mistral 7B bevond zich ongeveer halverwege de ranglijst, aangezien het wordt aangeboden onder een open licentie, maar slechts gedeeltelijk is gedocumenteerd, geen inzicht biedt in de gebruikte trainingsgegevens en de bijbehorende code niet volledig open is.
Onderzoekers hebben 14 criteria voor de openheid van AI-modellen voorgesteld, die de voorwaarden voor het verspreiden van code, trainingsdata, gewichten, datavarianten en gewichten die zijn geoptimaliseerd door middel van reinforcement learning (RL) omvatten, evenals de beschikbaarheid van kant-en-klare pakketten, API's, documentatie en gedetailleerde implementatie-instructies.
Volgens het conceptuele voorstel van de OSI (Open Source Initiative) voor de definitie van open AI, zijn de belangrijkste criteria voor de openheid van een AI-systeem het bieden van mogelijkheden voor gebruik voor elk doel zonder dat een aparte toestemming nodig is; het bestuderen van de werking van het systeem en het inspecteren van de componenten; het aanbrengen van wijzigingen voor elk doel; en het overdragen aan anderen van zowel de oorspronkelijke versie als de bewerkte versie na wijzigingen.
Om wijzigingen aan te kunnen brengen, moet een AI-systeem bevatten:
- Gedetailleerde informatie over de gegevens die zijn gebruikt tijdens de training en de trainingsmethodologie. De informatie moet voldoende zijn zodat een professionele ontwikkelaar in staat is om een equivalente AI-systeem zelf te recreëren, met gebruik van dezelfde of vergelijkbare gegevens voor training.
- De beschikbaarheid van de broncode, waarmee zowel het AI-systeem kan worden uitgevoerd als het trainingsproces kan worden uitgevoerd (in de bovenstaande tabel staat in de kolom 'code' voor veel modellen '~', wat verwijst naar een gedeeltelijke beschikbaarheid van de code, waarbij de code voor het uitvoeren van het model beschikbaar is, maar de code voor het trainen of creëren van het model ontbreekt). De code moet ook gebieden zoals preprocessing, datavalidatie en tokenisatie dekken. Bovendien moet er een gedetailleerde beschrijving van de modelarchitectuur worden gegeven.
- Modelparameters (gewichtcoefficiënten), wat betekent dat er een gebruiksklare status na training moet zijn of dat er een laatste geoptimaliseerde versie van het model aanwezig moet zijn.
Bron: opennet.ru
