

De rapportagetijd in Excel verdwijnt snel - de trend naar handige hulpmiddelen voor presentatie en analyse van informatie is in alle sectoren zichtbaar. We hebben intern al lang gesproken over de digitalisering van rapportage en hebben het visualisatie- en self-service analysetool Tableau gekozen. Alexander Bezoegly, hoofd van de afdeling analytische oplossingen en rapportage van de Groep "M.Video-Eldorado", deelde zijn ervaringen en resultaten van het opzetten van een operationeel dashboard.
Ik zal meteen zeggen, niet alles wat we gepland hadden, is gelukt, maar de ervaring was interessant, ik hoop dat het ook voor jullie nuttig zal zijn. En als iemand ideeën heeft over hoe het beter had gekund, zou ik zeer dankbaar zijn voor tips en ideeën.
Onder de streep over wat we zijn tegengekomen en wat we hebben geleerd.
Waar we mee zijn begonnen
Bij "M.Video-Eldorado" is er een goed doordacht datamodel: gestructureerde informatie met de vereiste diepte van opslag en een enorme hoeveelheid rapporten in vaste vorm (zie voor meer informatie ). Daaruit maken analisten ofwel draaitabellen of geformatteerde mailings in Excel, of mooie presentaties in PowerPoint voor eindgebruikers.
Ongeveer twee jaar geleden zijn we in plaats van rapporten in vaste vorm begonnen met het maken van analytische rapporten in SAP Analysis (een aanvulling op Excel, feitelijk een draaitabel bovenop de OLAP-engine). Maar dit hulpmiddel kon niet voldoen aan de behoeften van alle gebruikers, de meesten bleven informatie gebruiken die verder was verwerkt door analisten.
Onze eindgebruikers zijn verdeeld in drie categorieën:
Topmanagement. Vraagt om informatie in een goed gepresenteerd en visueel begrijpelijk formaat.
Middenmanagement, gevorderde gebruikers. Geïnteresseerd in het onderzoeken van gegevens en in staat om zelfstandig rapporten te bouwen indien de tools beschikbaar zijn. Zij zijn de sleutelgebruikers van analytische rapporten in SAP Analysis geworden.
Massale gebruikers. Niet geïnteresseerd in zelf analyse van gegevens, gebruiken rapporten met een beperkte mate van vrijheid, in de vorm van mailings en draaitabellen in Excel.
Ons idee was om te voldoen aan de behoeften van alle gebruikers en hen één handige tool te geven. We begonnen met het topmanagement. Zij hadden gebruiksvriendelijke dashboards nodig voor het analyseren van de belangrijkste bedrijfsresultaten. Zo zijn we gestart met Tableau en hebben we in eerste instantie twee richtingen gekozen: verkoopcijfers in de detailhandel en online met een beperkte diepte en breedte van analyse, die ongeveer 80% van de gegevens zou dekken die het topmanagement nodig had.
Aangezien de gebruikers van de dashboards het topmanagement waren, kwam er nog een extra KPI voor het product – de responstijd. Niemand wil 20-30 seconden wachten totdat de gegevens zijn bijgewerkt. De navigatie moest binnen 4-5 seconden plaatsvinden, en het liefst direct reageren. Dit hebben we helaas niet kunnen bereiken.
Zo zag het ontwerp van ons belangrijkste dashboard eruit:
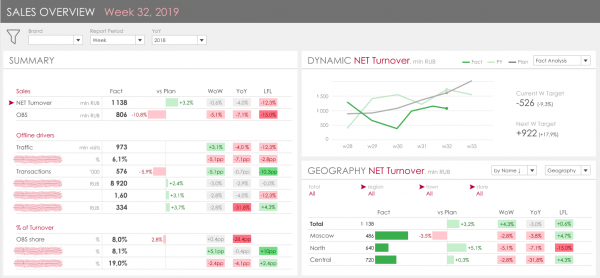
De kernidee was om de belangrijkste KPI-drivers, in totaal 19, aan de linkerkant te combineren en hun dynamiek en uitsplitsing op basis van de belangrijkste attributen aan de rechterkant weer te geven. De taak lijkt eenvoudig, de visualisatie logisch en duidelijk, totdat je je in de details verdiept.
Detail 1. Gegevensvolume
Onze belangrijkste verkooptabel voor het jaar beslaat ongeveer 300 miljoen rijen. Omdat we zowel de dynamiek ten opzichte van vorig jaar als het jaar daarvoor moeten weergeven, is het volume aan gegevens alleen van de feitelijke verkopen ongeveer 1 miljard rijen. Daarnaast wordt de informatie over de geplande gegevens en het blok internetverkoop apart opgeslagen. Daarom, ondanks dat we gebruikmaakten van de kolom-gebaseerde in-memory DB SAP HANA, was de snelheid van de query die alle indicatoren voor een week uit de huidige opslag in real-time ophaalde ongeveer 15-20 seconden. De oplossing voor dit probleem ligt voor de hand - extra materialisatie van de gegevens. Maar hier zijn ook addertjes onder het gras, daarover later meer.
Detail 2. Niet-additieve indicatoren
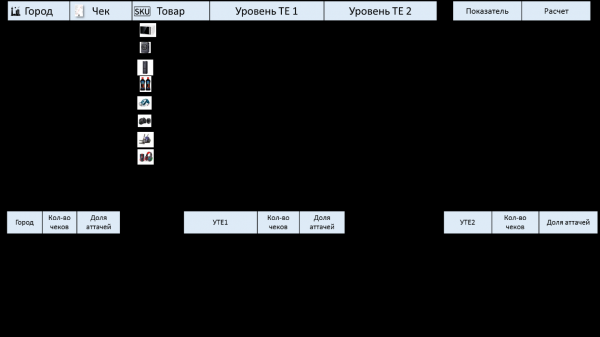
Veel van onze KPI's zijn gebaseerd op het aantal bonnetjes. Deze indicator is een COUNT DISTINCT van het aantal rijen (hoofdletters van de bonnetjes) en toont verschillende sommen afhankelijk van de geselecteerde attributen. Ter illustratie, hoe deze indicator en zijn afgeleiden berekend moeten worden:
Voor de correctheid van de berekeningen kan men:
- De berekening van dergelijke indicatoren on-the-fly in de opslag uitvoeren;
- De berekening over de volledige dataset in Tableau uitvoeren, dat wil zeggen bij een verzoek naar Tableau alle gegevens over de geselecteerde filters op het niveau van de bonnetjesposities teruggeven;
- Maak een gematerialiseerde weergave waarin alle indicatoren worden berekend voor alle varianten van selecties die verschillende niet-additieve resultaten opleveren.
Het is duidelijk dat in het voorbeeld UTE1 en UTE2 attributen van het materiaal zijn die de producthiërarchie vertegenwoordigen. Dit is geen statisch gegeven; het is een beheersinstrument binnen het bedrijf, aangezien verschillende managers verantwoordelijk zijn voor verschillende productgroepen. We hebben veel wereldwijde herzieningen van deze hiërarchie gehad, waarbij alle niveaus werden gewijzigd en de onderlinge verbanden opnieuw werden bekeken, naast constante puntwijzigingen waarbij één groep van het ene knooppunt naar het andere overgaat. In reguliere rapportage wordt dit alles on-the-fly berekend op basis van de materiaalattributen. In het geval van materialisering van deze gegevens is het noodzakelijk om een mechanisme te ontwikkelen voor het volgen van dergelijke wijzigingen en automatische herlading van historische gegevens. Dit is een vrij complexe taak.
Detail 3. Gegevensvergelijking
Dit punt is vergelijkbaar met de vorige. Het uitgangspunt is dat binnen het bedrijf bij analyse meerdere niveaus van vergelijking met voorgaande periodes worden gevormd:
Vergelijking met de voorgaande periode (dag-tot-dag, week-tot-week, maand-tot-maand)
In deze vergelijking gaan we ervan uit dat, afhankelijk van de door de gebruiker gekozen periode (bijvoorbeeld week 33 van het jaar), we de dynamiek ten opzichte van week 32 moeten tonen. Als we bijvoorbeeld gegevens voor een maand zouden kiezen, bijvoorbeeld mei, zou deze vergelijking de dynamiek ten opzichte van april laten zien.
Vergelijking met het voorgaande jaar
Hier ligt de belangrijkste nuance dat je bij het vergelijken per dagen en per weken niet dezelfde dag van het vorige jaar neemt, dat wil zeggen, je kunt niet gewoon het huidige jaar min één gebruiken. Je moet kijken naar de vergelijkbare dag van de week. En bij het vergelijken van maanden moet je daarentegen precies dezelfde kalenderdag van het vorige jaar nemen. Daarnaast zijn er nuances met schrikkeljaren. In de oorspronkelijke opslag zijn alle gegevens verdeeld over dagen, er zijn geen aparte velden voor weken, maanden of jaren. Daarom om een volledige analytische afspiegeling in het dashboard te verkrijgen, moet je niet één periode tellen, bijvoorbeeld een week, maar vier weken, en dan deze gegevens vergelijken, de dynamiek en afwijkingen reflecteren. Daarom kan deze logica voor het vormen van vergelijking in dynamiek ook in Tableau of aan de kant van de showcase worden gerealiseerd. Ja, en over deze details waren we ons natuurlijk bewust en dachten we al in de ontwerpfase na, maar het was moeilijk om hun invloed op de prestaties van het einddashboard te voorspellen.
Bij de implementatie van het dashboard volgden we een lange Agile-route. Onze taak was om zo snel mogelijk een werkend instrument met de benodigde gegevens voor testen te leveren. Daarom werkten we in sprints en richtten we ons op het minimaliseren van werkzaamheden aan de kant van de huidige opslag.
Deel 1. Geloof in Tableau
Om de IT-ondersteuning te vereenvoudigen en veranderingen snel door te voeren, hebben we besloten om de logica van de berekening van niet-additieve indicatoren en het vergelijken van voorgaande perioden in Tableau te doen.
Stap 1. Alles in Live, geen aanpassingen aan de showcases.
In deze fase hebben we Tableau verbonden met de huidige showcases en besloten te kijken hoe het aantal bonnen over één jaar zou worden berekend.
Resultaat:
Het antwoord was ontmoedigend – 20 minuten. Gegevensoverdracht via het netwerk, hoge belasting op Tableau. We begrepen dat de logica met niet-additieve indicatoren op HANA moest worden geïmplementeerd. Dit maakte ons niet al te bang, we hadden al een dergelijke ervaring met BO en Analysis en het bouwen van snelle showcases in HANA, die correct berekende niet-additieve indicatoren opleveren, konden we. Nu moest het alleen nog worden aangepast aan Tableau.
Stap 2. We optimaliseren de showcases, geen materialisatie, alles ter plaatse.
We created a separate new showcase that instantly provided the required data for TABLEAU. Overall, we achieved a good result, reducing the time to generate all metrics from one week to 9-10 seconds. Honestly, we expected that in Tableau the initial response time for the dashboard would be 20-30 seconds and then, thanks to caching, from 10 to 12 seconds, which would be acceptable for us.
Resultaat:
Initial dashboard openings: 4-5 minutes
Any click: 3-4 minutes
No one expected such an additional increase in the showcase's performance.
Part 2. Diving into Tableau
Stage 1. Performance analysis of Tableau and quick tuning
We began analyzing what Tableau spends the most time on. There are quite good tools for this, which is certainly a plus for Tableau. The main issue we identified was the very complex SQL queries generated by Tableau. They were primarily related to:
— Transposing data. Since Tableau lacks tools for transposing datasets, we had to create a table through case statements to build the left side of the dashboard with a detailed view of all KPIs. The size of the SQL queries in the database reached 120,000 characters.
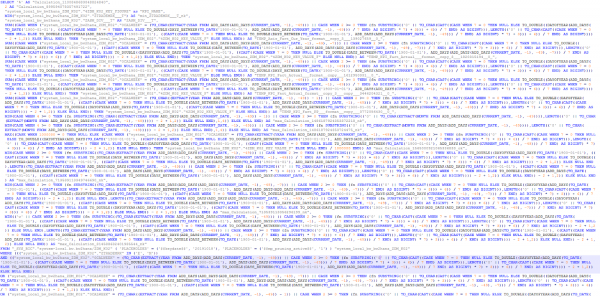
— Selecting a time period. Such a database-level query took more time to compile than to execute:
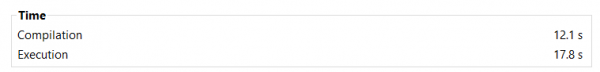
That is, request processing took 12 seconds + 5 seconds for execution.
We decided to simplify the logic of calculations on the Tableau side and move another part of the calculations to the showcase and database level. This brought good results.
Initially, we performed transposition on the fly, doing it through a full outer join at the final calculation stage of the VIEW, according to this approach described on wiki en .
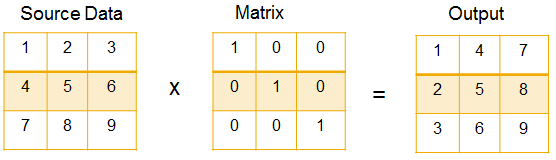
In other words, we created a configuration table – a transposition matrix (21x21) and obtained all metrics in a row-wise breakdown.
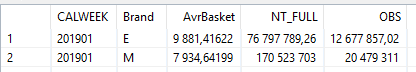
Was:
Het is geworden:
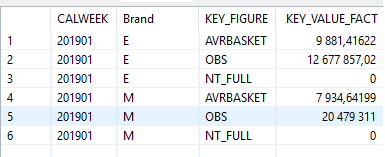
Het transponeren van de database kost bijna geen tijd. Een aanvraag voor alle indicatoren over een week werd nog steeds uitgevoerd in ongeveer 10 seconden. Maar daardoor is de flexibiliteit in het opbouwen van het dashboard voor specifieke indicatoren verloren gegaan, dat wil zeggen, voor het rechterdeel van het dashboard, waar de dynamiek en gedetailleerde uitsplitsing van een specifieke indicator wordt gepresenteerd. Eerder voldeed de vitrine in 1-3 seconden, omdat de aanvraag op één indicator werd uitgevoerd, en nu selecteert de database altijd alle indicatoren en filtert het resultaat pas terug voordat het naar Tableau wordt geretourneerd.
Uiteindelijk is de snelheid van het dashboard bijna met een factor drie verminderd.
Resultaat:
- 5 seconden — parsing van het dashboard, visualisaties
- 15-20 seconden — voorbereiding op de compilatie van aanvragen met uitvoering van voorafberekeningen in Tableau
- 35-45 seconden — compilatie van SQL-aanvragen en tegelijkertijd sequentiële uitvoering in Hana
- 5 seconden — verwerking van de resultaten, sortering, herberekening van visualisaties in Tableau
- Natuurlijk waren zulke resultaten niet bevredigend voor de business, en we gingen door met optimalisatie.
Fase 2. Minimale logica in Tableau, volledige materialisatie
We begrepen dat het onmogelijk was om een dashboard te bouwen met een responstijd van enkele seconden op een vitrine die 10 seconden werkt, en overwoog opties voor materialisatie van gegevens aan de databasezijde specifiek voor het vereiste dashboard. Maar we stuitten op een globaal probleem, zoals hierboven beschreven – niet-additieve indicatoren. We konden nietzo zorgen dat Tableau flexibel schakelt tussen verschillende vitrines en niveaus, vooraf berekend voor verschillende producthiërarchieën (in het voorbeeld vormen drie aanvragen zonder UTZ, met UTZ1 en UTZ2 verschillende resultaten). Daarom besloten we het dashboard te vereenvoudigen, de producthiërarchie in het dashboard op te geven en te kijken hoe snel het kan zijn in een vereenvoudigde versie.
Dus, in deze laatste fase hebben we een aparte opslag opgebouwd, waarin we al onze KPI's in getransponeerde vorm hebben opgeslagen. Aan de databasezijde wordt elke aanvraag naar zo'n opslag uitgevoerd in 0,1 – 0,3 seconden. In het dashboard kregen we de volgende resultaten:
Eerste opening: 8-10 seconden
Elke klik: 6-7 seconden
De tijd die Tableau verbruikt, bestaat uit:
- 0,3 seconden — parsing van het dashboard en compilatie van SQL-aanvragen
- 1,5-3 seconden — uitvoering van SQL-aanvragen in Hana voor de belangrijkste visualisaties (wordt parallel gestart met punt 1)
- 1,5-2 sec. — rendering, recalculating visualizations
- 1,3 sec. — executing additional SQL queries to obtain relevant filter values (Brand, Division, City, Store), parsing results
In summary
We liked the Tableau tool in terms of visualization. During the layout stage, we considered various visualization elements and found all of them in the libraries, including complex multi-level segmentations and multi-driver waterfalls.
When implementing dashboards with key sales metrics, we encountered performance difficulties that we have not yet been able to overcome. We spent more than two months and received a functionally incomplete dashboard, the response speed of which is on the edge of acceptable. We've drawn the following conclusions:
- Tableau cannot handle large volumes of data. If your source data model has more than 10 GB of data (approximately 200 million x 50 rows), the dashboard slows down significantly – from 10 seconds to several minutes per click. We experimented with both live connection and extract. The speed of operation is comparable.
- Limitations when using multiple storage (datasets). There is no standard way to specify the relationships between datasets. If you use workarounds to connect datasets, it will greatly affect performance. In our case, we considered the option of materializing data in each necessary perspective of views and switching between these materialized datasets while preserving previously selected filters – this turned out to be impossible to do in Tableau.
- In Tableau, it is impossible to create dynamic parameters. You cannot populate a parameter used for filtering a dataset in an extract or during live connection with results from another dataset or the result of another SQL query, only native user input or a constant.
- Limitations related to dashboard construction with OLAP|Pivot Table elements.
In MSTR, SAP SAC, SAP Analysis, when you add a dataset to the report, all objects are linked by default. Tableau does not have this; the connection needs to be set up manually. This might be more flexible, but for all our dashboards, it’s a mandatory requirement for the elements — therefore, it adds extra labor costs. Moreover, if you create related filters so that, for example, filtering by region restricts the list of cities to only those within that region, you immediately encounter consecutive requests to the database or extract, which noticeably slows down the dashboard. - Limitations in functions. Neither on the extract nor ESPECIALLY on the dataset from Live-connect can mass transformations be performed. This can be done through Tableau Prep, but it involves additional labor costs and yet another tool that needs to be learned and maintained. For example, you cannot transpose data or join it with itself. This gets resolved through transformations of individual columns or fields that must be selected using case or if, resulting in very complex SQL queries, during which the database spends most of the time compiling the query text. These inflexibilities of the tool had to be addressed at the level of the dashboard, which complicates the storage, adds loads, and requires transformations.
We have not written Tableau off. But as a tool capable of building industrial dashboards and a means by which all corporate reporting systems of the company can be replaced and digitized, we do not consider Tableau.
We are currently actively developing a similar dashboard on another tool while also trying to reconsider the architecture of the dashboard in Tableau, to simplify it even more. If the community is interested, we will share the results.
We are also waiting for your ideas or suggestions on how to build fast dashboards in Tableau over such large volumes of data, as we have a website where the data is much greater than in retail.
Bron: habr.com
