

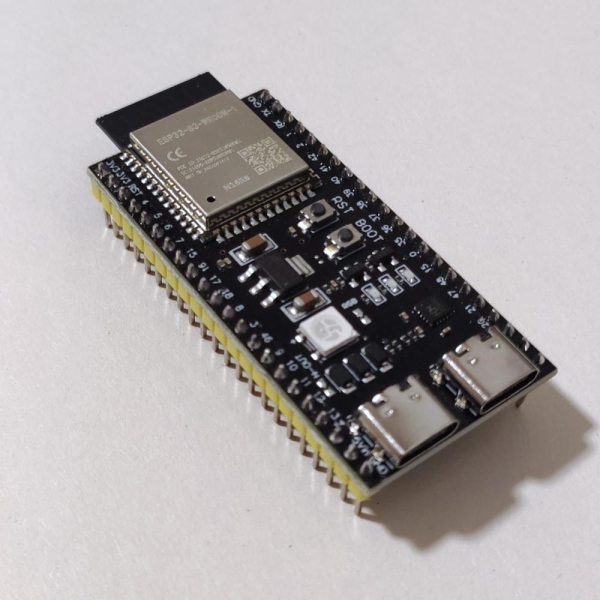
Ontwikkelaar Vyacheslav Serbov, die optreedt onder het pseudoniem slvDev, gedemonstreerd heeft een volledig lokale tekstgeneratie op de ESP32-S3 microcontroller ontwikkeld. Het door hem gemaakte taalmodel bevat 28,9 miljoen parameters en genereert ongeveer 9,9 tokens per seconde zonder gebruik te maken van een server of andere externe rekenbronnen. De gegenereerde korte verhalen worden weergegeven op een aangesloten OLED-display.
Project esp32-ai is getest op de ESP32-S3 N16R8 module, die 512 KB ingebouwde SRAM, 8 MB PSRAM en 16 MB flashgeheugen heeft. Het tot vier bits gequantiseerde model neemt 14,9 MB in beslag. De broncode van de uitvoeringsomgeving in C, de leermiddelen en het kwantiseren van het model, de firmware, tests en scenario's voor het uploaden naar de kaart zijn gepubliceerd in de repository.
De opgegeven 28,9 miljoen parameters moeten niet rechtstreeks worden vergeleken met het aantal parameters van gewone desktop LLM's. Volgens een gedetailleerd rapport van de ontwikkelaar,bestaat het model uit een dicht computational kern van ongeveer 559 duizend parameters, een outputlaag van 3,1 miljoen parameters en een tabel van laag-voor-laag vectorrepresentaties van ongeveer 25 miljoen parameters. Juist deze laatste zorgt voor het grootste deel van de formele grootte van het model, maar wordt niet volledig verwerkt bij het genereren van elk token.
Om het model te plaatsen worden drie geheugenniveaus gebruikt. De meest gebruikte gegevens bevinden zich in de interne SRAM, de outputlaag, KV-cache en tijdelijke buffers bevinden zich in de PSRAM, terwijl de 25 miljoen tabel in het flashgeheugen blijft en toegankelijk is via mapping in het adresruimte. Voor elk token worden er slechts ongeveer zes rijen uit gelezen met een totaal van ongeveer 450 bytes.
Een dergelijk apparaat is gebaseerd op de Per-Layer Embeddings technologie, toegepast door Google in Gemma 3n. Volgens de documentatie van Google,kunnen PLE-parameters buiten het werkgeheugen van het model worden opgeslagen en aan het outputproces worden toegevoegd naarmate afzonderlijke lagen worden verwerkt. In esp32-ai is dit principe overgebracht naar de geheugenhierarchie van de microcontroller, waarin snelle SRAM bijzonder beperkt is.
De eerste correcte versie van de in C geschreven runtime gaf slechts 0,57 token per seconde. Na het plaatsen van de outputlaag in PSRAM, het overschakelen naar 8-bits activaties, het verdelen van de berekeningen tussen twee Xtensa LX7-kernen en andere optimalisaties werd de vertraging teruggebracht tot 94,9 ms per modelstap. De uiteindelijke gemeten snelheid bereikte 9,88 token per seconde inclusief het volledige generatieproces. De belangrijkste beperking is nu de doorvoersnelheid van PSRAM bij het lezen van de outputlaag.
Het model is getraind op een synthetische dataset TinyStories, bestaande uit eenvoudige Engelstalige verhalen met een beperkte woordenschat. Daarom is het in staat om zinnen voort te zetten en korte samenhangende verhalen te verzinnen, maar het is niet bedoeld voor het beantwoorden van vragen, het uitvoeren van instructies, programmeren of het reproduceren van feitelijke kennis. De ontwikkelaar beschouwt het werk voornamelijk als een demonstratie van een effectieve plaatsing van het model in het geheugen van de microcontroller, en niet als een kant-en-klaar autonoom chatbot.
In de actuele documentatie benadrukt de auteur afzonderlijk dat esp32-ai een zelfstandige ontwikkeling is. Projecten llama2.c van Andrei Karpaty en de eerdere uitvoering van het 260.000 model op de ESP32-S3 worden alleen genoemd als richtlijnen en voorbeelden van eerdere werken: de code, checkpoints en methodologie zijn niet rechtstreeks uit deze overgenomen. De broncode van esp32-ai wordt verspreid onder de MIT-licentie.
Bron: linux.org.ru
