

In dit artikel zullen we de theoretische aanpak van transformatie bespreken. de functie van lineaire regressie. in de functie van de inverse logit-transformatie (ook wel de functie van de logistieke respons genoemd).Vervolgens, met de gereedschappen van de maximum likelihood-methode,volgens het model van logistische regressie, zullen we de verliesfunctie afleiden. Logistic Loss,of met andere woorden, we zullen de functie definiëren die gebruikt wordt om de parameters van de gewichtsvector in het logistische regressiemodel te selecteren.  .
Artikelplan:
- Laten we herhalen dat er een lineaire afhankelijkheid tussen twee variabelen is.
- We zullen de noodzaak van de transformatie identificeren. de functie van lineaire regressie.
 in de functie van de logistieke respons.
- We zullen de transformaties uitvoeren en afleiden. de functie van de logistieke respons.
- We zullen proberen te begrijpen waarom de methode van de kleinste kwadraten slecht is bij het selecteren van parameters. functies Logistic Loss,
- We gebruiken de methode van maximale waarschijnlijkheid voor de bepaling van de parameterschattingsfunctie. :
5.1. Geval 1: de functie Logistic Loss, voor objecten met klasse-aanduidingen. 0 en 1:
5.2. Geval 2: de functie. Logistic Loss, voor objecten met klasse-aanduidingen. -1 en +1:
 in de functie van de logistieke respons.

 functies Logistic Loss,
 :


Het artikel zit vol met eenvoudige voorbeelden waarin alle berekeningen gemakkelijk mondeling of op papier kunnen worden gedaan; in sommige gevallen kan een rekenmachine nodig zijn. Dus bereid je voor 🙂
Dit artikel is voornamelijk gericht op datascientists met een basisniveau van kennis over de grondslagen van machine learning.
In het artikel wordt ook code gepresenteerd voor het plotten van grafieken en berekeningen. Alle code is geschreven in de taal python 2.7. Ik zal vooraf uitleggen over de 'nieuwheid' van de gebruikte versie - dit is een van de voorwaarden voor het volgen van de beroemde cursus van Yandex op een minstens zo bekende online leerplatform. Coursera, en, zoals je kunt vermoeden, is het materiaal gebaseerd op deze cursus.
01. Lineaire afhankelijkheid
Het is heel redelijk om de vraag te stellen - wat hebben lineaire afhankelijkheid en logistische regressie met elkaar te maken?
Het is heel eenvoudig! Logistische regressie is een van de modellen die behoren tot de lineaire classifier. Simpel gezegd is de taak van een lineaire classifier het voorspellen van doelwaarden  van variabelen (regressoren).
 Bij dit alles wordt aangenomen dat de afhankelijkheid tussen de kenmerken
 en de doelwaarden
 lineair is. Daarom is het belangrijk dat de naam van de classifier 'lineair' is. Als we het heel grof samenvatten, dan ligt de basis van het logistische regressiemodel in de veronderstelling dat er een lineaire afhankelijkheid tussen de kenmerken bestaat.
 en de doelwaarden
 Daar is de verbinding.
In de studio het eerste voorbeeld, en het gaat inderdaad over de rechtstreekse afhankelijkheid van de onderzochte grootheden. Tijdens het schrijven van het artikel stuitte ik op een voorbeeld dat velen al bekend is — de afhankelijkheid van de stroomsterkte van de spanning. («Toegepaste regressieanalyse», N.Draper, G.Smith). Hier zullen we het ook bespreken.
In overeenstemming met volgens de wet van Ohm:
 , waar
 — stroomsterkte,
 — spanning,
 — weerstand.
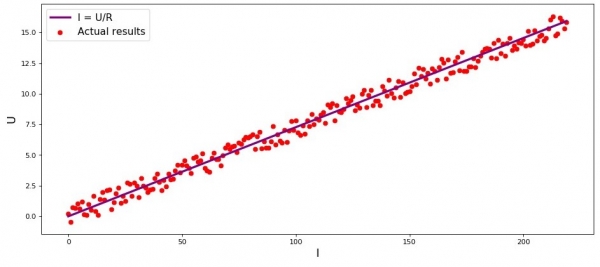
Als wij de wet van Ohmniet wisten, zouden we de afhankelijkheid empirisch kunnen vaststellen door  te variëren en
 te meten, terwijl we
 vast zouden houden. Dan zouden we zien dat de grafiek van de afhankelijkheid
 van
 een meer of minder rechte lijn geeft die door de oorsprong van de coördinaten gaat. We zeggen 'meer of minder', omdat hoewel de afhankelijkheid feitelijk exact is, onze metingen kleine fouten kunnen bevatten, en daarom kunnen de punten op de grafiek misschien niet strikt op de lijn vallen, maar willekeurig eromheen verspreid zijn.
Grafiek 1 «Afhankelijkheid  van
 »
Code voor het tekenen van de grafiek
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Werkelijke resultaten')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. De noodzaak van transformaties van de lineaire regressievergelijking
Laten we een ander voorbeeld bekijken. Stel je voor dat we in een bank werken en de taak hebben om de kans op terugbetaling van een lening door een lener te bepalen, afhankelijk van enkele factoren. Om de taak te vereenvoudigen, beschouwen we slechts twee factoren: het maandelijkse salaris van de lener en het maandelijkse bedrag van de lening aflossing.
De taak is zeer hypothetisch, maar aan dit voorbeeld kunnen we begrijpen waarom het niet voldoende is om de functie van lineaire regressie.toe te passen, en we zullen ook leren welke transformaties met de functie moeten worden uitgevoerd.
Laten we terugkomen op het voorbeeld. Het is duidelijk dat hoe hoger het salaris, hoe meer de kredietnemer maandelijks kan besteden aan het aflossen van de lening. Voor een bepaald salarisbereik zal deze relatie vrij lineair zijn. Neem bijvoorbeeld een salarisbereik van 60.000€ tot 200.000€ en veronderstel dat binnen dat salarisbereik de relatie tussen de maandlasten en het salaris - lineair is. Stel dat binnen het genoemde salarisbereik is vastgesteld dat de verhouding tussen salaris en betaling niet lager kan zijn dan 3 en dat de kredietnemer ook nog 5.000€ over moet houden. Alleen in dat geval beschouwen we de kredietnemer als in staat om de lening terug te betalen aan de bank. Gegeven dit, zal de vergelijking van de lineaire regressie als volgt zijn:

waar  ,
 ,
 ,
 — salaris
 van de kredietnemer,
 — kredietbetaling
 van de kredietnemer.
Door het salaris en de kredietbetaling met vastgestelde parameters in de vergelijking in te vullen,  kunnen we een beslissing nemen over het toekennen of weigeren van de lening.
Even vooruitlopend, willen we opmerken dat, bij gegeven parameters,  de functie van lineaire regressie, toegepast in de logistische responsfunctie, grote waarden zal opleveren, wat het moeilijk maakt om berekeningen te doen voor het bepalen van de waarschijnlijkheden van leningaflossingen. Daarom wordt voorgesteld om onze coëfficiënten, laten we zeggen, 25.000 keer te verkleinen. Van dit transformatie in de coëfficiënten zal de beslissing over het toekennen van de lening niet veranderen. Laten we dit moment onthouden voor de toekomst, en nu, om het nog duidelijker te maken waar het over gaat, laten we de situatie met drie potentiële kredietnemers bekijken.
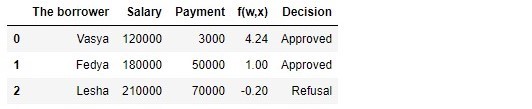
Tabel 1 "Potentiële kredietnemers"
Code voor het genereren van de tabel
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'De kredietnemer':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salaris':np.array([120000,180000,210000]),
       'Betaling':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salaris']*w_1 + df['Betaling']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Goedgekeurd'
        decision.append(dec)
    else:
        dec = 'Weigering'
        decision.append(dec)

df['Beslissing'] = decision

df[['De kredietnemer', 'Salaris', 'Betaling', 'f(w,x)', 'Beslissing']]
Volgens de gegevens in de tabel wil Vasya, met een salaris van 120.000€, een lening krijgen waarbij hij deze maandelijks met 3.000€ kan aflossen. We hebben vastgesteld dat voor het goedkeuren van de lening, het salaris van Vasya drie keer de hoogte van de betaling moet zijn, en dat hij nog 5.000€ over moet houden. Aan deze vereiste voldoet Vasya:  Er blijft zelfs 106.000R over. Ondanks dat we de coëfficiënten
 met 25.000 hebben verlaagd, hebben we hetzelfde resultaat behaald — de lening kan worden goedgekeurd. Fedya zal ook een lening krijgen, terwijl Lesha, ondanks dat hij het meeste verdient, zijn wensen zal moeten matigen.
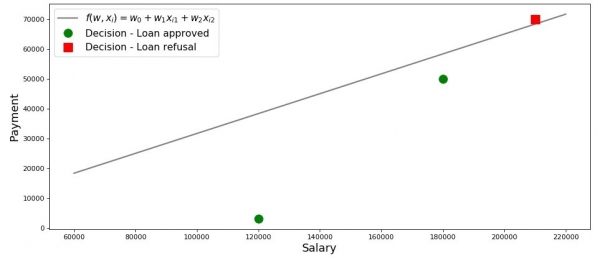
 Laten we voor deze gelegenheid een grafiek tekenen.
Grafiek 2 'Classificatie van leningnemers'
Code voor het tekenen van de grafiek
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize=(14,6), dpi=80) plt.plot(salary, payment, color='grey', lw=2, label='$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color='green', markersize=12, label='Beslissing - Lening goedgekeurd') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color='red', markersize=12, label='Beslissing - Lening geweigerd') plt.xlabel('Salaris', size=16) plt.ylabel('Betaling', size=16) plt.legend(prop={'size': 14}) plt.show()
Dus, onze lijn, opgebouwd volgens de functie, scheidt 'slechte' leningnemers van 'goede'. Leningnemers wiens wensen niet overeenkomen met hun mogelijkheden bevinden zich boven de lijn (Lesha), terwijl degenen die in staat zijn om volgens de parameters van ons model de lening terug te betalen, zich onder de lijn bevinden (Vasya en Fedya). Anders gezegd, onze lijn verdeelt leningnemers in twee klassen. We zullen ze als volgt aanduiden: de klasse  waarin we leningnemers zullen indelen die naar verwachting de lening zullen terugbetalen, en de klasse
 waarin we leningnemers zullen indelen die naar verwachting de lening niet zullen kunnen terugbetalen.
 of
 Laten we de conclusies uit dit eenvoudige voorbeeld samenvatten. Laten we een punt nemen
en door de coördinaten van het punt in de overeenkomstige lijnvergelijking in te vullen,  overwegen we drie opties:
 Als het punt onder de lijn ligt, en we het indelen in de klasse
- , dan zal de waarde van de functie positief zijn van . Dat betekent dat we kunnen zeggen dat de kans op terugbetaling van de lening zich binnen tot bevindt. Hoe hoger de waarde van de functie, hoe groter de kans. Als het punt boven de lijn ligt en we het indelen in de klasse
- , dan zal de waarde van de functie negatief zijn van of . Dan beschouwen we de kans op terugbetaling van de schuld als binnen tot en hoe groter de waarde van de functie in modulus, hoe groter ons vertrouwen. Het punt ligt op de lijn, op de grens tussen twee klassen. In dat geval zal de waarde van de functie
- gelijk zijn aan en de kans op terugbetaling van de lening is gelijk aan Stel je nu voor dat we niet twee factoren hebben, maar tientallen, en niet drie leningnemers, maar duizenden. Dan hebben we in plaats van een lijn .
 positief zijn van
 . Dat betekent dat we kunnen zeggen dat de kans op terugbetaling van de lening zich binnen
 tot
 bevindt. Hoe hoger de waarde van de functie, hoe groter de kans.
 Als het punt boven de lijn ligt en we het indelen in de klasse
 of
 . Dan beschouwen we de kans op terugbetaling van de schuld als binnen
 tot
 en hoe groter de waarde van de functie in modulus, hoe groter ons vertrouwen.
 Het punt ligt op de lijn, op de grens tussen twee klassen. In dat geval zal de waarde van de functie
 en de kans op terugbetaling van de lening is gelijk aan
 Stel je nu voor dat we niet twee factoren hebben, maar tientallen, en niet drie leningnemers, maar duizenden. Dan hebben we in plaats van een lijn
 .
Stel je nu voor dat we niet te maken hebben met twee factoren, maar met tientallen, en dat we niet drie, maar duizenden leningnemers hebben. Dan hebben we in plaats van een directe... m-waarde vlak en coëfficiënten  deze zullen niet uit de lucht gegrepen zijn, maar zullen volgens alle regels worden afgeleid, op basis van verzamelde gegevens over leners die hun lening wel of niet hebben terugbetaald. En let op, we selecteren momenteel leners op basis van al bekende coëfficiënten
 . De taak van het logistische regressiemodel is precies om de parameters te bepalen
 , waarbij de waarde van de verliesfunctie Logistic Loss, naar een minimum zal neigen. Maar hoe de vector wordt berekend,
 , dat zullen we nog leren in het 5e deel van het artikel. Laten we voor nu terugkeren naar het beloofde land — naar onze bankier en zijn drie klanten.
Dankzij de functie  weten we aan wie we een lening kunnen geven en aan wie we moeten weigeren. Maar met zo'n informatie kan je niet naar de directeur stappen, want zij wilden de kans op terugbetaling van de lening door elke lener krijgen. Wat te doen? Het antwoord is simpel — we moeten de functie op een of andere manier omvormen,
 wiens waarden liggen in het bereik
 naar een functie wiens waarden zullen liggen in het bereik
 . En zo'n functie bestaat, het wordt genoemd de logistische regressiefunctie of inverse logittransformatie. Maak kennis met:

Laten we stap voor stap bekijken hoe de logistische regressiefunctie wordt verkregen.Merk op dat we achteruit zullen stappen, d.w.z. we veronderstellen dat we de kanswaarde kennen die ligt tussen  tot
 en verder zullen we deze waarde 'uitrollen' naar het hele gebied van getallen van
 tot
 .
03. We voeren de logistische regressiefunctie in
Stap 1. Laten we de kansen omzetten naar het bereik

Gedurende de transformatie van de functie  in de functie van de logistieke respons.
 laten we onze kredietanalist met rust, en in plaats daarvan kijken we naar de bookmakers. Nee, we zullen natuurlijk geen inzetten doen, alles wat ons daar interesseert is de betekenis van de uitdrukking, bijvoorbeeld, een kans van 4 tegen 1. De kansen, bekend bij iedereen die wedt, zijn de verhouding van 'successen' tot 'mislukkingen'. Vanuit het perspectief van waarschijnlijkheden zijn kansen de kans dat een gebeurtenis optreedt, gedeeld door de kans dat de gebeurtenis niet optreedt. Laten we de formule voor de kans op een gebeurtenis opschrijven
 :

, waar  — kans op de gebeurtenis,
 — kans op het NIET optreden van de gebeurtenis
Bijvoorbeeld, als de kans dat een jonge, sterke en energieke hengst genaamd 'Bries' de oude en slappe oude dame 'Matilda' in een race voorbijstreeft, gelijk is aan  , dan zullen de kansen voor 'Bries' zijn
 aan

 en omgekeerd, wetende wat de kansen zijn, zullen we geen moeite hebben om de kans te berekenen
 :

Op die manier hebben we geleerd om de kans om te zetten in kansen, die waarden aannemen van  tot
 . Laten we een stap verder gaan en leren de kans om te zetten over de gehele getallijn van
 tot
 .
Stap 2. We zetten de kanswaarden om naar het bereik

Deze stap is heel eenvoudig: we nemen de logaritme van de kansen met als basis het getal van Euler  en we krijgen:

Nu weten we dat als  , het berekenen van de waarde
 heel eenvoudig zal zijn en bovendien moet het positief zijn:
 . Dat klopt.
Uit nieuwsgierigheid zullen we controleren wat als  , dan verwachten we een negatieve waarde te zien
 . We controleren:
 . Klopt helemaal.
Nu weten we hoe we de kanswaarde van  tot
 over de gehele getallijn van
 tot
 . In de volgende stap doen we alles omgekeerd.
En voor nu, laten we opmerken dat volgens de logaritmiseringsregels, wetende wat de waarde van de functie  , we de kansen kunnen berekenen:

Deze methode om kansen te bepalen zal nuttig zijn in de volgende stap.
Stap 3. We leiden de formule af voor het bepalen van

Dus, we hebben geleerd om, wetende  , de waarden van de functie
 te vinden. Echter, in werkelijkheid moeten we alles precies omgekeerd doen — wetende wat de waarde
 is, moeten we
 vinden. Hiervoor nemen we het concept van de inverse kansfunctie, volgens welke:

In dit artikel zullen we de bovengenoemde formule niet afleiden, maar we zullen het controleren met de cijfers uit het bovenstaande voorbeeld. We weten dat bij kansen gelijk aan 4 tegen 1 ( ), de kans op het optreden van het evenement gelijk is aan 0.8 (
 ). Laten we de waarden invullen:
 . Dit komt overeen met onze eerdere berekeningen. Laten we verder gaan.
In de vorige stap hebben we vastgesteld dat  , dus we kunnen een vervangingen maken in de inverse kansfunctie. We krijgen:

Laten we zowel de teller als de noemer delen door  , dan:

Om voor alle zekerheid te zorgen dat we geen fouten hebben gemaakt, laten we nog een kleine controle doen. In stap 2 hebben we voor  bepaald dat
 . Dus, door de waarde
 in te vullen in de logistische regressiefunctie, verwachten we te krijgen
 . We vullen in en krijgen:

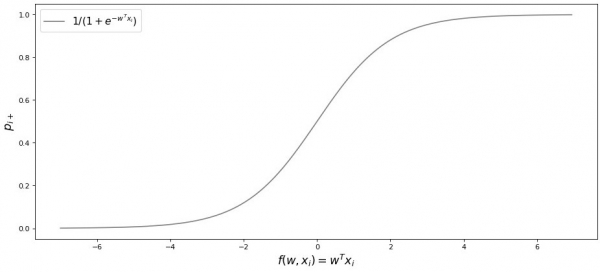
Gefeliciteerd, gewaardeerde lezer, we hebben zojuist de logistische responsfunctie ontwikkeld en getest. Laten we naar de grafiek van de functie kijken.
Grafiek 3 'Logistische responsfunctie'
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize=(14,6), dpi=80) plt.plot(salary, payment, color='grey', lw=2, label='$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color='green', markersize=12, label='Beslissing - Lening goedgekeurd') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color='red', markersize=12, label='Beslissing - Lening geweigerd') plt.xlabel('Salaris', size=16) plt.ylabel('Betaling', size=16) plt.legend(prop={'size': 14}) plt.show()
import math

def logit(f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(f, p, color='grey', label='$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size=16)
plt.ylabel('$p_{i+}$', size=16)
plt.legend(prop={'size':14})
plt.show()
In de literatuur wordt deze functie ook wel sigmoïde functie. Uit de grafiek blijkt goed dat de belangrijkste verandering in de waarschijnlijkheid dat een object tot een klasse behoort zich over een relatief klein bereik voordoet  , ergens van
 tot
 .
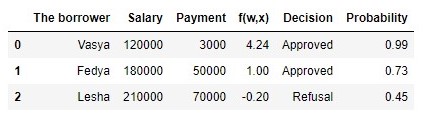
Laten we terugkeren naar onze kredietanalist en hem helpen met het berekenen van de kans op krediet terugbetaling, anders riskeert hij zonder bonus te blijven 🙂
Tabel 2 'Potentiële leners'
Code voor het genereren van de tabel
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probability'] = proba

df[['De lener', 'Salaris', 'Betaling', 'f(w,x)', 'Beslissing', 'Kans']]
Dus, we hebben de kans op terugbetaling van de lening bepaald. Over het algemeen lijkt het waar te zijn.
Inderdaad, de kans dat Vasja met een salaris van 120.000R maandelijks 3.000R aan de bank kan terugbetalen, is bijna 100%. Overigens moeten we begrijpen dat de bank ook een lening aan Lesja kan verlenen, als het beleid van de bank bijvoorbeeld toestaat om klanten te financieren met een kans op terugbetaling van meer dan, laten we zeggen, 0.3. In dat geval zal de bank simpelweg een grotere reserve aanleggen voor mogelijke verliezen.
Bovendien moet worden opgemerkt dat de verhouding tussen salaris en betaling minimaal 3 is en met een speling van 5.000R willekeurig gekozen is. Daarom konden we de gewichten in hun oorspronkelijke vorm niet gebruiken.  . We moesten de coëfficiënten aanzienlijk verminderen en in dat geval hebben we elke coëfficiënt gedeeld door 25.000, wat in wezen betekent dat we het resultaat hebben aangepast. Maar dit werd gedaan om het begrip van het materiaal in het begin te vergemakkelijken. In het echte leven zullen we coëfficiënten niet moeten verzinnen en aanpassen, maar ze moeten vinden. In de volgende secties van het artikel zullen we de vergelijkingen afleiden die worden gebruikt om de parameters te selecteren.
 .
04. Methode van de kleinste kwadraten bij het bepalen van de gewichtsvector in de logistische responsfunctie
 in de logistische responsfunctie
We kennen al een dergelijke methode voor het selecteren van de gewichtsvector  , zoals methode van de kleinste kwadraten (MKK) en wat houdt ons tegen om het te gebruiken voor binaire classificatietaken? Inderdaad, er is niets dat het gebruik ervan tegenhoudt OLS, maar deze methode levert minder nauwkeurige resultaten op in classificatietaken dan Logistic Loss,. Hier is een theoretische onderbouwing voor. Laten we eerst naar een eenvoudig voorbeeld kijken.
Stel dat onze modellen (die gebruikmaken van MSE en Logistic Loss,) al begonnen zijn met het afstemmen van de gewichten  en we zijn de berekening op een bepaald moment gestopt. Het doet er niet toe of dit in het midden, aan het einde of aan het begin is; het belangrijkste is dat we al enkele waarden van de gewichten hebben en laten we aannemen dat op dit moment de gewichten
 voor beide modellen geen verschillen vertonen. Laten we dan de verkregen gewichten nemen en deze invoegen in de functie van de logistieke respons. (
 ) voor een bepaald object dat tot de klasse behoort
 . We onderzoeken twee gevallen: één waarin onze model sterk fouten maakt volgens de afgestelde gewichten en omgekeerd, waarbij het model erg zeker is dat het object tot de klasse behoort
 . Laten we kijken welke straf 'opgesteld' zal worden bij het gebruik van OLS en Logistic Loss,.
Code voor het berekenen van straffen afhankelijk van de gebruikte verliesfunctie
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Geval van een grote fout — het model wijst het object toe aan de klasse  met een waarschijnlijkheid van 0,01
De straf bij het gebruik van OLS zal zijn:

De straf bij het gebruik van Logistic Loss, zal zijn:

Geval van sterke zekerheid — het model wijst het object toe aan de klasse  met een waarschijnlijkheid van 0,99
De straf bij het gebruik van OLS zal zijn:

De straf bij het gebruik van Logistic Loss, zal zijn:

Dit voorbeeld illustreert goed dat bij een grote fout de verliesfunctie Log Loss de model veel strenger straft dan MSE. Laten we nu bekijken wat de theoretische voorwaarden zijn voor het gebruik van de verliesfunctie Log Loss in classificatietaken.
05. Methode van maximale waarschijnlijkheid en logistieke regressie
Zoals beloofd aan het begin, staat het artikel vol met eenvoudige voorbeelden. Hier is opnieuw een voorbeeld en oude gasten - de leners van de bank: Vasya, Fedya en Lesha.
Voor alle zekerheid, voordat ik het voorbeeld verder ontwikkel, herinner ik eraan dat we in het leven te maken hebben met een trainingsset van duizenden of miljoenen objecten met tientallen of honderden kenmerken. Maar hier zijn de cijfers zo gekozen dat ze gemakkelijk te begrijpen zijn voor de beginnende datawetenschapper.
Laten we terugkeren naar het voorbeeld. Stel je voor dat de directeur van de bank besloot om een lening te verstrekken aan iedereen die het nodig heeft, ondanks dat het algoritme aangaf deze niet aan Lesha te verstrekken. En na enige tijd weten we wie van de drie helden de lening heeft terugbetaald en wie niet. Zoals te verwachten was, hebben Vasya en Fedya de lening terugbetaald, maar Lesha niet. Laten we nu veronderstellen dat deze uitkomst voor ons een nieuwe trainingsset zal zijn en dat ondertussen alle gegevens over de factoren die de waarschijnlijkheid van terugbetaling beïnvloeden (salaris van de lener, bedrag van de maandlasten) lijken te zijn verdwenen. Intuïtief kunnen we aannemen dat elke derde lener de lening niet terugbetaalt, of met andere woorden, de kans op terugbetaling van de lening door de volgende lener.  . Deze intuïtieve aanname heeft theoretische onderbouwing en is gebaseerd op de maximale likelihood-methode, die in de literatuur vaak de principes van maximale waarschijnlijkheid.
wordt genoemd. Laten we beginnen met de conceptuele terminologie.
De waarschijnlijkheid van een steekproef is de kans op het verkrijgen van precies deze steekproef, het verkrijgen van precies zulke waarnemingen/resultaten, d.w.z. het product van de waarschijnlijkheden van het verkrijgen van elk van de resultaten van de steekproef (bijvoorbeeld of de lening door Vasya, Fedya en Lesha tegelijkertijd is terugbetaald of niet).
De likelihood-functie verbindt de waarschijnlijkheid van de steekproef met de waarde van de parameters van de verdeling.
In ons geval stelt de trainingssteekproef een gegeneraliseerd Bernoulli-schema voor, waarbij de toevallige variabele slechts twee waarden aanneemt:  of
 . Dus kan de waarschijnlijkheid van de steekproef worden geschreven als een functie van de likelihood van de parameter
 het als volgt:


De hierboven genoemde notatie kan als volgt worden geïnterpreteerd. De gezamenlijke kans dat Vasya en Fedya de lening terugbetalen is gelijk aan  , de kans dat Lesha de lening NIET terugbetaalt is gelijk aan
 (aangezien er daadwerkelijk NIET is terugbetaald), dus de gezamenlijke kans op alle drie de gebeurtenissen is gelijk aan
 .
De methode van maximale waarschijnlijkheid — dit is een methode voor het schatten van een onbekende parameter door middel van maximalisatie de waarschijnlijkheidsfunctie. In ons geval moeten we zo'n waarde vinden  , waarbij
 een maximum bereikt.
Waar komt het idee vandaan om de waarde van een onbekende parameter te zoeken waarbij de likelihood-functie maximaal is? De oorsprong van dit idee ligt in de opvatting dat de steekproef de enige beschikbare bron van kennis is over de populatie. Alles wat we weten over de populatie wordt weergegeven in de steekproef. Daarom kunnen we alleen maar zeggen dat de steekproef de meest nauwkeurige afspiegeling van de populatie is die we hebben. Gevolgtrekkend is het noodzakelijk om een parameter te vinden waarbij de bestaande steekproef het meest waarschijnlijk is.
Het is duidelijk dat we te maken hebben met een optimaliseringsprobleem waarbij we het extremum van een functie moeten vinden. Om het extremum te vinden, moeten we de eerste-orde voorwaarde overwegen, dat wil zeggen de afgeleide van de functie gelijkstellen aan nul en de vergelijking oplossen voor de gezochte parameter. Het zoeken naar de afgeleide van een product van veel factoren kan echter tijdrovend zijn; om dit te vermijden, is er een speciale techniek: de overgang naar de logarithme. de waarschijnlijkheidsfunctieWaarom is zo'n overgang mogelijk? Laten we opmerken dat we niet het extremum van de functie zelf zoeken, maar het punt van extremum, dat wil zeggen de waarde van de onbekende parameter
 , waarbij
 die het maximum bereikt. Bij de overgang naar de logarithme verandert het punt van extremum niet (hoewel het extremum zelf verschillend zal zijn), omdat de logarithme een monotone functie is.
Laten we, in overeenstemming met het bovenstaande, ons voorbeeld verder uitwerken met de leningen van Vasya, Fedya en Lesha. Laten we beginnen met de logaritme van de likelihood-functie.:

Nu kunnen we het uitdrukking gemakkelijk differentiëren naar  :

En laten we tot slot de eerste-orde voorwaarde bekijken — we stellen de afgeleide van de functie gelijk aan nul:

Zo is onze intuïtieve schatting van de waarschijnlijkheid van de terugbetaling van de lening  theoretisch onderbouwd.
Geweldig, maar wat moeten we nu met deze informatie doen? Als we aannemen dat elke derde lener het geld niet terugbetaalt, zal de bank onvermijdelijk failliet gaan. Dat klopt, maar bij het inschatten van de waarschijnlijkheid van terugbetaling van de lening gelijk aan  We hebben de factoren die van invloed zijn op de terugbetaling van de lening niet in overweging genomen: het salaris van de lener en de hoogte van de maandlasten. Laten we niet vergeten dat we eerder de waarschijnlijkheid hebben berekend dat elke klant zijn lening terugbetaalt, rekening houdend met deze factoren. Logisch dat de waarschijnlijkheden die we hebben berekend, afwijken van een constante waarde gelijk aan
 .
Laten we de waarschijnlijkheid van de steekproeven bepalen:
Code voor de berekeningen van de waarschijnlijkheid van steekproeven
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Waarschijnlijkheid van de steekproef bij een constante waarde van p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Waarschijnlijkheid van de steekproef bij de berekende waarde van p:', round(likelihood(y,p_log_response),3)
Waarschijnlijkheid van de steekproef bij een constante waarde  :

Waarschijnlijkheid van de steekproef bij de berekening van de waarschijnlijkheid van terugbetaling van de lening, rekening houdend met de factoren  :


De waarschijnlijkheid van de steekproef, berekend op basis van de factoren, bleek hoger te zijn dan de waarschijnlijkheid bij een constante waarde. Wat betekent dit? Dit houdt in dat kennis van de factoren ons in staat heeft gesteld om de waarschijnlijkheid van terugbetaling van de lening voor elke klant nauwkeuriger te schatten. Bij het verstrekken van een nieuwe lening is het daarom beter om het model te gebruiken dat aan het einde van de derde sectie van het artikel is voorgesteld, om de waarschijnlijkheid van terugbetaling van de schuld te schatten.
Maar als we de waarschijnlijkheid moeten maximaliseren functie van de waarschijnlijkheid van de steekproef, waarom zouden we dan niet een of ander algoritme gebruiken dat waarschijnlijkheden voor Vasya, Fedia en Lesha oplevert, bijvoorbeeld gelijk aan 0,99, 0,99 en 0,01 respectievelijk. Misschien presteert zo'n algoritme goed op de trainingssteekproef, omdat het de waarde van de waarschijnlijkheid van de steekproef dichter bij brengt.  , maar ten eerste zal zo'n algoritme waarschijnlijk moeite hebben met generalisatie, en ten tweede zal dit algoritme zeker niet lineair zijn. En als de methoden om overfitting tegen te gaan (evenals de zwakke generalisatie) duidelijk niet binnen het plan van dit artikel vallen, laten we dan verder ingaan op het tweede punt. Het is genoeg om een simpele vraag te beantwoorden. Kan de kans op terugbetaling van de lening door Vasya en Fedya gelijk zijn, rekening houdend met de ons bekende factoren? Vanuit gezond verstand gesproken, natuurlijk niet, dat kan niet. Vasya zal namelijk 2,5% van zijn salaris per maand terugbetalen, terwijl Fedya bijna 27,8% terugbetaalt. Ook op Figuur 2 “Klantenklassificatie” zien we dat Vasya veel verder van de lijn die de klassen scheidt ligt dan Fedya. En tot slot weten we dat de functie
 voor Vasya en Fedya verschillende waarden aanneemt: 4,24 voor Vasya en 1,0 voor Fedya. Als Fedya bijvoorbeeld veel meer zou verdienen of om een kleinere lening zou vragen, dan zouden de kansen op terugbetaling van de lening door Vasya en Fedya vergelijkbaar zijn. Met andere woorden, een lineaire afhankelijkheid kun je niet omzeilen. En als we de coëfficiënten
 , en ze niet uit de lucht hadden gegrepen, zouden we gerust kunnen beweren dat onze waarden
 het beste de kans op terugbetaling van de lening door elke leningnemer kunnen inschatten, maar aangezien we zijn overeengekomen dat de bepaling van de coëfficiënten
 volgens alle regels is uitgevoerd, laten we aannemen — onze coëfficiënten bieden de beste schatting van de kans 🙂
Echter, we zijn afgedwaald. In dit hoofdstuk moeten we uitzoeken hoe de gewichtsvector  , die nodig is voor de inschatting van de kans op terugbetaling van de lening door elke leningnemer, wordt bepaald.
Laten we kort samenvatten met welke gereedschappen we aan de zoektocht naar de coëfficiënten beginnen  :
1. We veronderstellen dat de afhankelijkheid tussen de doelvariabele (voorspelde waarde) en de factor die invloed heeft op het resultaat lineair is. Om deze reden wordt de functie van lineaire regressie van de vorm  , waarvan de lijn de objecten (klanten) in klassen verdeelt
 en
 of
 (klanten die de lening kunnen terugbetalen en klanten die dat niet kunnen). In ons geval heeft de vergelijking de vorm
 .
2. We gebruiken de functie van de inverse logit-transformatie van de vorm  om de kans te bepalen dat een object tot een bepaalde klasse behoort
 .
3. We beschouwen onze trainingsset als een realisatie van de generaliseerde Bernoulli-schema's, dat wil zeggen, voor elk object wordt een willekeurige variabele gegenereerd die met waarschijnlijkheid  (eigen voor elk object) de waarde 1 aanneemt en met waarschijnlijkheid
 – 0.
4. We weten dat we de maximaal haalbare moeten optimaliseren functie van de waarschijnlijkheid van de steekproef rekening houdend met de aangenomen factoren zodat de bestaande steekproef het meest waarschijnlijk wordt. Met andere woorden, we moeten parameters vinden waarmee de steekproef het meest waarschijnlijk is. In ons geval is de parameter die we aanpassen de waarschijnlijkheid van het aflossen van de lening  , die op zijn beurt afhangt van onbekende coëfficiënten
 . Dit betekent dat we een dergelijke gewichtenvector moeten vinden
 , waarbij de waarschijnlijkheid van de steekproef maximaal is.
5. We weten dat om te maximaliseren de functie van de waarschijnlijkheid van de steekproef kunnen we gebruiken de methode van maximale waarschijnlijkheid. En we kennen alle slimme trucs voor het werken met deze methode.
Zo'n meerstapsproces ontstaat 🙂
Laten we nu herinneren dat we aan het begin van het artikel twee soorten verliesfuncties wilden afleiden Logistic Loss, afhankelijk van hoe de klassen van objecten worden aangeduid. Het is gebruikelijk dat in classificatietaken met twee klassen, de klassen worden aangeduid als  en
 of
 . Afhankelijk van de aanduiding, zal de overeenkomstige verliesfunctie worden geproduceerd.
Geval 1. Classificatie van objecten naar en
 en

Eerder, bij het bepalen van de waarschijnlijkheid van de steekproef, waarbij de waarschijnlijkheid van het aflossen van de lening door de lener werd berekend op basis van factoren en gegeven coëfficiënten  , gebruikten we de formule:

Eigenlijk  — dit is de waarde van de logistische regressiefunctie
 bij een gegeven gewichtenvector

Dan staat niets ons in de weg om de waarschijnlijkheidsfunctie van de steekproef als volgt op te schrijven:

Soms kan het voor sommige beginnende analisten moeilijk zijn om meteen te begrijpen hoe deze functie werkt. Laten we 4 korte voorbeelden bekijken die alles verduidelijken:
1. Als  (d.w.z. in overeenstemming met de trainingssteekproef behoort het object tot klasse +1), terwijl onze algoritme
 de waarschijnlijkheid berekent dat het object tot de klasse
 gelijk aan 0.9, dus dit stukje waarschijnlijkheid van de steekproef wordt als volgt berekend:

2. Als  , met behulp van 1 bit, gelijk aan 0,
 , dan zou de berekening als volgt zijn:

3. Als  , met behulp van 1 bit, gelijk aan 0,
 , dan zou de berekening als volgt zijn:

4. Als  , met behulp van 1 bit, gelijk aan 0,
 , dan zou de berekening als volgt zijn:

Het is duidelijk dat de waarschijnlijkheidsfunctie zal worden gemaximaliseerd in gevallen 1 en 3, of in het algemeen - wanneer de waarden van de waarschijnlijkheden voor de toewijzing van het object aan de klasse correct zijn geraden  .
Gezien het feit dat bij het bepalen van de waarschijnlijkheid van toewijzing van het object aan de klasse  we weten alleen de coëfficiënten niet
 , dan zullen we deze gaan zoeken. Zoals hierboven vermeld, is dit een optimalisatieprobleem waarbij we in eerste instantie de afgeleide van de kansfunctie ten opzichte van de gewichtsvector moeten vinden
 . Echter, het heeft zin om ons leven vooraf een beetje eenvoudiger te maken: we zullen de afgeleide zoeken van de logaritme de waarschijnlijkheidsfunctie.

Waarom na logaritmisering, in de logistieke foutfunctie, hebben we het teken gewijzigd naar  en een werkende opdracht krijgen.
 . Het is heel eenvoudig, omdat het gebruikelijk is om de waarde van de functie te minimaliseren in evaluatieproblemen, hebben we de rechterkant van de uitdrukking met
 vermenigvuldigd en in plaats van maximalisatie minimaliseren we nu de functie.
Eigenlijk is de verliesfunctie - Logistic Loss, voor de trainingsset met twee klassen:  en
 .
Nu hebben we alleen de afgeleide nodig om de coëfficiënten te vinden de logistieke foutfunctie en vervolgens, met behulp van numerieke optimalisatie-methoden zoals gradient descent of stochastic gradient descent, de meest optimale coëfficiënten te selecteren  . Maar gezien de al aanzienlijke omvang van het artikel, wordt voorgesteld om zelf de differentiatie uit te voeren of misschien is dit een onderwerp voor een volgend artikel met meer rekenwerk zonder zo gedetailleerde voorbeelden.
Geval 2. Classificatie van objecten op en
 en

De aanpak hier zal hetzelfde zijn als die met de klassen  en
 , maar het pad naar de afgeleide functie van de verliezen Logistic Loss,, zal ingewikkelder zijn. Laten we beginnen. We zullen de operator gebruiken voor de kansfunctie "als..., dan...". Dus, als
 het -de object tot de klasse behoort
 , dan gebruiken we voor de kansberekening van de steekproef de waarschijnlijkheid
 , als het object tot de klasse behoort
 , dan plaatsen we
 in de kans. Zo ziet de kansfunctie eruit:

Laten we uitleggen hoe dit werkt. Beschouwen we 4 gevallen:
1. Als  en
 , dan 'zal de kans van de steekproef gaan'

2. Als  en
 , dan 'zal de kans van de steekproef gaan'

3. Als  en
 , dan 'zal de kans van de steekproef gaan'

4. Als  en
 , dan 'zal de kans van de steekproef gaan'

Het is duidelijk dat in geval 1 en 3, wanneer de waarschijnlijkheden correct door het algoritme zijn vastgesteld, de kansfunctie wordt gemaximaliseerd, wat precies is wat we wilden bereiken. Deze aanpak is echter vrij omslachtig en we zullen een compactere notatie overwegen. Maar eerst logaritmeren we de kansfunctie met een tekenwijziging, aangezien we deze nu zullen minimaliseren.

Laten we in plaats daarvan  de uitdrukking plaatsen
 :

Laten we de rechter term onder de logaritme vereenvoudigen door gebruik te maken van eenvoudige rekenmethoden, en krijgen we:

En nu is het tijd om de operator kwijt te raken "als..., dan...". Merk op dat wanneer het object  tot de klasse behoort
 , dan in de uitdrukking onder de logaritme, in de noemer,
 tot de macht wordt verheven
 , als het object tot de klasse behoort
 , dan wordt $e$ tot de macht verheven
 . Daarom kan de notatie van de macht worden vereenvoudigd — we combineren beide gevallen in één:
 . Dan de logistische foutfunctie zal de volgende vorm aannemen:

Overeenkomstig de logaritmeregels draaien we de breuk om en brengen we het teken " " (min) naar buiten de logaritme, en krijgen we:

Voor u staat de verliesfunctie logistic Loss, die wordt toegepast in de trainingsset met objecten die tot de klassen behoren:  en
 .
Nou, op dit punt neem ik afscheid en sluiten we het artikel af.
Het vorige werk van de auteur — "Breng de vergelijking voor lineaire regressie in matrixvorm"
Aanvullend materiaal
1. Literatuur
1) Toegepaste regressieanalyse / N. Draper, G. Smith – 2e druk – Moskou: Financiën en statistiek, 1986 (vertaling uit het Engels)
2) De theorie van waarschijnlijkheden en wiskundige statistiek / V.E. Gmurman — 9e druk — Moskou: Hogere school, 2003
3) De theorie van waarschijnlijkheden / N.I. Chernova — Novosibirsk: Novosibirsk Staatsuniversiteit, 2007
4) Business Analytics: van data naar kennis / Paklin N.B., Oreshkov V.I. — 2e druk — Sint-Petersburg: Peter, 2013
5) Data Science De wetenschap van data vanaf nul / Joel Gras — Sint-Petersburg: BHV Petersburg, 2017
6) Praktische statistiek voor Data Science-specialisten / P.Bruce, E.Bruce — Sint-Petersburg: BHV Petersburg, 2018
2. Colleges, cursussen (video)
1)
2)
3)
4)
5)
3. Internetbronnen
1)
2)
3)
4)
5)
6)
7)
8)
Bron: habr.com
