

De code van softwareproducten voor machine learning is vaak complex en behoorlijk verwarrend. Het opsporen en verhelpen van bugs hierin is een tijdrovende klus. Zelfs de eenvoudigste vereisen een serieuze aanpak voor netwerkarchitectuur, gewichtsinitialisatie en netwerkoptimalisatie. Een kleine fout kan leiden tot vervelende problemen.
Dit artikel is gewijd aan het debuggen van uw neurale netwerken.
Skillbox raadt aan: Praktische cursus .
Ter herinnering: voor alle lezers van «Habr» — een korting van 10.000 roebel bij inschrijving voor elke cursus van Skillbox met de promocode «Habr».
Het algoritme bestaat uit vijf fasen:
- eenvoudige start;
- validatie van verliezen;
- controleren van tussenresultaten en verbindingen;
- diagnose van parameters;
- bewaking van prestaties.
Als u iets interessanter vindt dan het andere, kunt u direct naar deze secties gaan.
Eenvoudige start
Het debuggen van een neuraal netwerk met een complexe architectuur, regularisatie en een leer scheduler is moeilijker dan van een standaard netwerk. We zijn hier een beetje creatief, omdat deze stap indirect gerelateerd is aan debugging, maar het blijft een belangrijke aanbeveling.
De eenvoudige start houdt in dat er een vereenvoudigd model wordt gemaakt en dit op één set (data) wordt getraind.
Laten we eerst een vereenvoudigd model maken
Voor een snelle start creëren we een klein netwerk met één verborgen laag en controleren we of alles correct werkt. Vervolgens compliceren we het model geleidelijk en controleren we elk nieuw aspect van de structuur (extra laag, parameter, enz.), en gaan we verder.
Train het model op één enkele set (data)
Als snelle controle van de werking van uw project kunt u een of twee gegevenspunten gebruiken om te bevestigen dat de systeemcorrect werkt. Het neuraal netwerk moet 100% nauwkeurigheid van training en validatie tonen. Als dit niet het geval is, dan is het model ofwel te klein, of er is al een bug.
Zelfs als alles goed is, bereidt u het model voor om één of meerdere epochs te doorlopen voordat u verder gaat.
Verliesbeoordeling
Verliesbeoordeling is de belangrijkste manier om de prestaties van het model te verfijnen. U moet ervoor zorgen dat het verlies past bij de taak, en dat verliesfuncties worden beoordeeld op de juiste schaal. Als u meer dan één type verlies gebruikt, zorg er dan voor dat ze allemaal van dezelfde orde zijn en correct zijn geschaald.
Het is belangrijk om alert te zijn op de initiële verliezen. Controleer hoe dicht het werkelijke resultaat bij de verwachting ligt als het model met een willekeurige aanname begint. In : "Zorg ervoor dat je het verwachte resultaat krijgt bij het starten met een klein aantal parameters. Het is beter om onmiddellijk het gegevensverlies te controleren (met de regularisatiegraad ingesteld op nul). Bijvoorbeeld, voor CIFAR-10 met de Softmax-classificator verwachten we dat de initiële verliezen 2.302 zullen zijn, omdat de verwachte oppervlakkige waarschijnlijkheid 0,1 is voor elke klasse (aangezien er 10 klassen zijn), en het Softmax-verlies is de negatieve logaritmische waarschijnlijkheid van de juiste klasse, oftewel –ln(0.1) = 2.302."
Voor een binair voorbeeld wordt een soortgelijke berekening gemaakt voor elke klasse. Bijvoorbeeld, gegevens: 20% 0's en 80% 1's. De verwachte initiële verlies zou tot –0,2ln(0,5) –0,8ln(0,5) = 0,693147 bedragen. Als het resultaat groter is dan 1, kan dit erop wijzen dat de gewichten van het neuraal netwerk niet goed zijn gebalanceerd of dat de gegevens niet genormaliseerd zijn.
We controleren de tussentijdse resultaten en verbindingen
Voor het debuggen van het neuraal netwerk is het noodzakelijk om de dynamiek van de processen binnen het netwerk en de rol van de afzonderlijke tussenlagen te begrijpen, omdat deze met elkaar verbonden zijn. Hier zijn enkele typische fouten die je kunt tegenkomen:
- onjuiste uitdrukkingen voor de updates van de gradient;
- gewichtsupdates worden niet toegepast;
- verdampende of exploderende gradients (exploding gradients).
Als de gradientwaarden nul zijn, betekent dit dat de leersnelheid in de optimizer te laag is, of dat je bent gestuit op een onjuiste uitdrukking voor de gradientupdate.
Bovendien is het belangrijk om de waarden van activatiefuncties, gewichten en updates van elke laag in de gaten te houden. Bijvoorbeeld, de grootte van de parameterupdates (gewichten en verschuivingen) .
Er is een fenomeen dat de naam "Dying ReLU" heeft gekregen of , waarbij ReLU-neuronen nul zullen uitgeven na het leren van een grote negatieve waarde (bias) voor hun gewichten. Deze neuronen worden nooit meer geactiveerd op enige plaats in de gegevens.
U kunt gradientchecks gebruiken om deze fouten te identificeren door de gradient te benaderen met een numerieke aanpak. Als deze dicht bij de berekende gradienten ligt, is de backpropagation correct geïmplementeerd. Voor het creëren van een gradientcheck, bekijk deze geweldige bronnen van CS231. en , evenals van Andrew Ng over dit onderwerp.
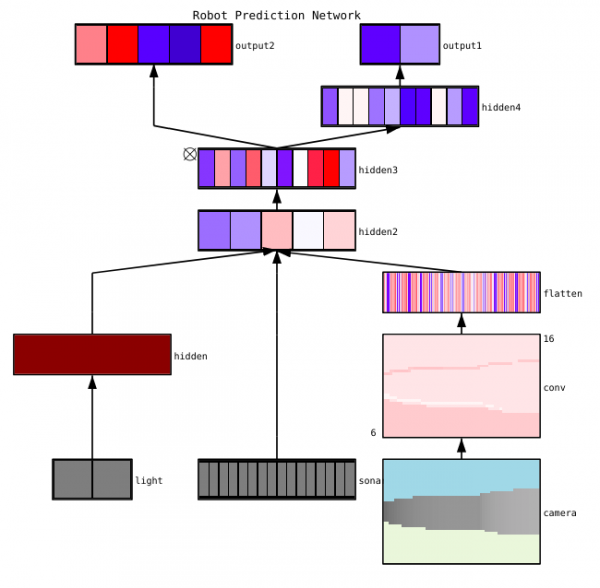
noemt drie hoofdmethoden voor het visualiseren van neurale netwerken:
- Voorlopige methoden — eenvoudige technieken die ons de algemene structuur van het getrainde model tonen. Deze omvatten de uitvoer van vormen of filters van individuele lagen van het neurale netwerk en de parameters in elke laag.
- Activatie-gebaseerde methoden. Hiermee ontcijfer we de activaties van individuele neuronen of groepen neuronen om hun functies te begrijpen.
- Gradiënt-gebaseerde methoden. Deze technieken manipuleren vaak de gradienten die worden gevormd uit de voorwaartse en achterwaartse doorgangen tijdens het trainen van het model (inclusief belangrijkheidskaarten en activatiemappen van de klasse).
Er zijn verschillende nuttige hulpmiddelen voor het visualiseren van activaties en verbindingen van individuele lagen, zoals en .
Diagnose van parameters
Neurale netwerken hebben een groot aantal parameters die met elkaar interageren, wat optimalisatie ingewikkeld maakt. Dit deel is dan ook onderwerp van actief onderzoek, dus de onderstaande voorstellen moeten worden beschouwd als tips, beginpunten om vanaf te werken.
Batchgrootte (batch size) — het is noodzakelijk dat de batchgrootte groot genoeg is om nauwkeurige schattingen van de gradient van de fout te krijgen, maar klein genoeg zodat stochastic gradient descent (SGD) uw netwerk kan ordenen. Kleine batchgroottes leiden tot snelle convergentie door ruis in het leerproces, maar later tot moeilijkheden bij de optimalisatie. Dit wordt verder beschreven. .
Leersnelheid — te laag zal leiden tot trage convergentie of het risico om vast te komen zitten in lokale minima. Aan de andere kant zal een hoge leersnelheid leiden tot divergentie van de optimalisatie omdat u het risico loopt om over een diepe, maar smalle sectie van de verliesfunctie heen te springen. Probeer het gebruik van leersnelheidsplanning om deze tijdens het trainen van het neurale netwerk te verlagen. In de cursus CS231n. .
Gradient clipping - het afkappen van de gradiënten van parameters tijdens de terugpropagatie naar een maximumwaarde of een limietnorm. Dit is nuttig om problemen met explosieve gradiënten op te lossen die je kunt tegenkomen in punt drie.
Batch normalisatie wordt gebruikt om de inputdata van elke laag te normaliseren, wat helpt bij het oplossen van het probleem van interne covariantieverschuiving. Als je Dropout en Batch Normalization samen gebruikt, .
Stochastische gradiëntafdalingen (SGD) er zijn verschillende varianten van SGD die momentum, adaptieve leersnelheden en de Nesterov-methode gebruiken. Geen van deze heeft echter een duidelijk voordeel wat betreft leerefficiëntie of generalisatie ().
Regularisatie is cruciaal voor het bouwen van een generaliseerbaar model, omdat het een straf toevoegt voor de complexiteit van het model of extreme waarden van parameters. Dit is een manier om de variantie van het model te verminderen zonder de bias aanzienlijk te verhogen. Meer .
Om alles zelf te evalueren, moet je regularisatie uitschakelen en de gradient van de verliesfunctie zelf controleren.
Dropout is nog een methode om je netwerk te regulariseren om overfitting te voorkomen. Tijdens het trainen wordt dropout alleen uitgevoerd door de activiteit van een neuron met een bepaalde waarschijnlijkheid p (hyperparameter) in stand te houden of, anders, deze op nul te zetten. Hierdoor moet het netwerk een andere subset van parameters gebruiken voor elke trainingsbatch, wat de wijzigingen in bepaalde parameters die dominant worden, vermindert.
Belangrijk: als je zowel dropout als batchnormalisatie gebruikt, wees dan voorzichtig met de volgorde van deze bewerkingen of zelfs met hun gelijktijdig gebruik. Dit wordt nog steeds actief besproken en aangevuld. Hier zijn twee belangrijke discussies over dit onderwerp en .
Werkcontrole
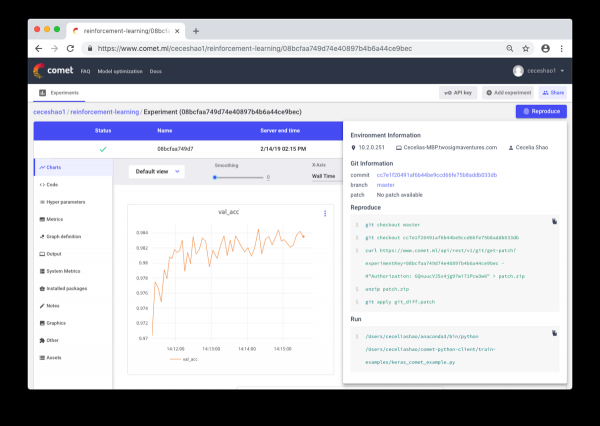
Dit gaat over het documenteren van werkprocessen en experimenten. Als je niets documenteert, kun je vergeten welke leersnelheid of klassegewichten er worden gebruikt. Dankzij controle kun je eerdere experimenten probleemloos bekijken en reproduceren. Dit helpt om het aantal dubbele experimenten te verminderen.
Echter, handmatige documentatie kan een uitdaging worden bij een grote hoeveelheid werk. Hier komen tools zoals Comet.ml van pas, die helpen om automatisch datasets, codewijzigingen, experimenthistorie en productiemodellen te loggen, inclusief belangrijke informatie over jouw model (hyperparameters, prestatie-indicatoren van het model en omgevingsinformatie).
Een neuraal netwerk kan behoorlijk gevoelig zijn voor kleine veranderingen, wat kan leiden tot een vermindering van de modelprestaties. Het volgen en documenteren van de prestaties is de eerste stap om een gestandaardiseerde omgeving en modelvorming te waarborgen.
Ik hoop dat deze post een vertrekpunt kan zijn voor het verbeteren van jouw neuraal netwerk.
Skillbox raadt aan:
- Praktische tweejarenopleiding .
- Online cursus .
- Praktische jaaropleiding .
Bron: habr.com
