

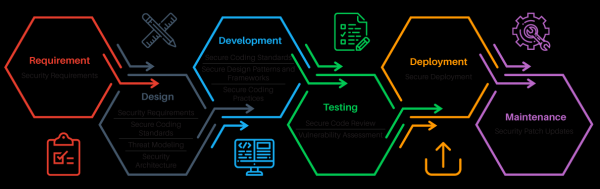
Binnen de professionele activiteiten worden ontwikkelaars, pentesters en beveiligingsspecialisten geconfronteerd met processen zoals Vulnerability Management (VM) en (Secure) SDLC.
Achter deze uitdrukkingen schuilt een verscheidenheid aan praktijken en gebruikte tools die met elkaar verweven zijn, hoewel hun consumenten verschillen.
Technische vooruitgang heeft nog niet geleid tot één enkele tool die de menselijke analyse van de beveiliging van infrastructuur en software kan vervangen.
Het is interessant om te begrijpen waarom dit zo is en met welke problemen men wordt geconfronteerd.
Processen
Het proces van Vulnerability Management ('beheer van kwetsbaarheden') is bedoeld voor de voortdurende monitoring van de beveiliging van infrastructuur en patchbeheer.
Het proces van Secure SDLC ('cyclus van veilige ontwikkeling') is bedoeld ter ondersteuning van de beveiliging van de applicatie tijdens de ontwikkeling en exploitatie.
Een vergelijkbaar onderdeel van deze processen is het proces van Vulnerability Assessment - kwetsbaarheidsbeoordeling en kwetsbaarheidsscanning.
Het belangrijkste verschil in scannen binnen VM en SDLC is dat in het eerste geval het doel is om bekende kwetsbaarheden in third-party software of configuraties te ontdekken. Bijvoorbeeld, een verouderde versie van Windows of de standaard community-string voor SNMP.
In het tweede geval is het doel om kwetsbaarheden niet alleen in externe componenten (afhankelijkheden) te identificeren, maar vooral in de code van het nieuwe product.
Dit leidt tot verschillen in tools en benaderingen. Naar mijn mening is de taak om nieuwe kwetsbaarheden in de applicatie te vinden aanzienlijk interessanter, omdat het niet beperkt blijft tot het fingerprinten van versies, het verzamelen van banners, het raden van wachtwoorden, enz.
Voor effectieve geautomatiseerde kwetsbaarheidsscans van applicaties zijn algoritmes nodig die rekening houden met de semantiek van de applicatie, het doel ervan en specifieke bedreigingen.
De infrastructuurscanner kan vaak worden vervangen door een timer, zoals het werd verwoord door Het punt is dat je statistisch gezien je infrastructuur als kwetsbaar kunt beschouwen, als je deze, laten we zeggen, een maand niet hebt bijgewerkt.
Hulpmiddelen
Scannen, net als het analyseren van beveiliging, kan worden uitgevoerd als een black box of als een white box.
Black Box
Bij black box-scannen moet de tool in staat zijn om met de dienst te werken via dezelfde interfaces als waarmee gebruikers interageren.
Infrastructuurscanners (Tenable Nessus, Qualys, MaxPatrol, Rapid7 Nexpose, enz.) zoeken naar open netpoorten, verzamelen 'banners', bepalen de versies van de geïnstalleerde software en zoeken in hun kennisdatabase naar informatie over kwetsbaarheden in deze versies. Ze proberen ook configuratiefouten te ontdekken, zoals standaardwachtwoorden of open toegang tot gegevens, zwakke SSL-encryptie, enz.
Webapplicatiescanners (Acunetix WVS, Netsparker, Burp Suite, OWASP ZAP, enz.) kunnen ook bekende componenten en hun versies identificeren (bijvoorbeeld CMS, frameworks, JS-bibliotheken). De belangrijkste stappen van de scanner zijn crawling en fuzzing.
Tijdens crawling verzamelt de scanner informatie over bestaande interfaces van de applicatie en HTTP-parameters. Tijdens fuzzing worden gemuteerde of gegenereerde gegevens in alle ontdekte parameters ingevoerd om een fout uit te lokken en een kwetsbaarheid te ontdekken.
Dergelijke applicatiescanners behoren tot de klassen DAST en IAST — respectievelijk Dynamic en Interactive Application Security Testing.
White Box
Bij whitebox-scanning zijn er meer verschillen.
In het kader van het VM-proces krijgen scanners (Vulners, Incsecurity Couch, Vuls, Tenable Nessus, enz.) vaak toegang tot systemen door een geauthentiseerde scan uit te voeren. Hierdoor kan de scanner de geïnstalleerde versies van pakketten en configuratieparameters direct uit het systeem ophalen, zonder ze te raden via banners van netservices.
De scan wordt nauwkeuriger en vollediger.
Als we het hebben over whitebox-scanning (CheckMarx, HP Fortify, Coverity, RIPS, FindSecBugs, enz.) van applicaties, dan gaat het meestal om statische code-analyse en het gebruik van de bijbehorende tools van de SAST-klasse — Static Application Security Testing.
Problemen
Er ontstaan veel problemen met scannen! De meeste van deze problemen ben ik persoonlijk tegengekomen tijdens het bieden van service voor het opzetten van scanprocessen en veilige ontwikkeling, evenals tijdens de beveiligingsanalyse.
Ik wil drie belangrijke groepen problemen benadrukken, die worden bevestigd door gesprekken met ingenieurs en managers van informatiebeveiligingsdiensten in verschillende bedrijven.
Problemen met het scannen van webapplicaties
- Moeilijkheid van implementatie. Scanners moeten worden uitgerold, geconfigureerd en aangepast aan elke applicatie, testomgevingen voor scans moeten worden toegewezen en in het CI/CD-proces moeten worden geïntegreerd om effectief te zijn. Anders is het een nutteloze formele procedure die hooguit valse positieven oplevert.
- Scanlengte. Scanners presteerden zelfs in 2019 slecht als het gaat om deduplicatie van interfaces en kunnen dagenlang duizend pagina's scannen met 10 parameters op elke pagina, die als verschillend worden beschouwd, hoewel dezelfde code verantwoordelijk is. Toch moet de beslissing over deployment naar productie in het ontwikkelingsproces snel worden genomen.
- Schamele aanbevelingen. Scanners geven vrij algemene aanbevelingen, en niet altijd kan de ontwikkelaar snel begrijpen hoe hij het risiconiveau moet verlagen, en belangrijker nog, of dit direct moet gebeuren of dat het voorlopig niet zo rampzalig is.
- Destructieve impact op de applicatie. Scanners kunnen zeker een DoS-aanval op de applicatie uitvoeren en kunnen een groot aantal entiteiten aanmaken of bestaande wijzigen (bijvoorbeeld tientallen duizenden reacties in een blog creëren), dus het is niet verstandig om een scan in productie zonder nadenken te starten.
- Lage kwaliteit van kwetsbaarheiddetectie. Scanners gebruiken meestal een vaste set aan payloads en kunnen gemakkelijk een kwetsbaarheid missen die niet binnen hun bekende scenario voor de gedragingen van de applicatie past.
- Onbegrip van de applicatiefuncties door de scanner. Scanners weten zelf niet wat een 'internetbank', 'betaling' of 'reactie' is. Voor hen zijn er alleen links en parameters, zodat een groot aantal mogelijke kwetsbaarheden in de bedrijfslogica volledig onbehandeld blijft; ze zullen niet bedenken om een dubbele afschrijving te maken, andermans gegevens op te vragen op basis van ID of het saldo te manipuleren via afronding.
- Onbegrip van de semantiek van pagina's door de scanner. Scanners kunnen geen FAQ lezen, kunnen geen captchas herkennen, ze zullen zelf niet bedenken hoe ze zich moeten registreren, en dat ze daarna opnieuw moeten inloggen, dat ze niet op 'logout' moeten klikken, en hoe ze verzoeken moeten ondertekenen bij het wijzigen van parameterwaarden. Hierdoor blijft een groot deel van de applicatie mogelijk helemaal ongescand.
Problemen met het scannen van de source code.
- Valse positieven. Statistische analyse is een complexe taak, waarbij vaak meerdere compromissen moeten worden gesloten. Vaak moet men inboeten op nauwkeurigheid, en zelfs dure enterprise-scanners geven een enorme hoeveelheid valse positieven.
- Moeilijkheid van implementatie. Om de nauwkeurigheid en volledigheid van statische analyse te vergroten, moeten de scanregels worden verbeterd, en het schrijven van deze regels kan een zeer tijdrovende klus zijn. Soms is het eenvoudiger om alle plaatsen in de code met een bepaald defect te vinden en deze te corrigeren dan om een regel te schrijven voor het detecteren van zulke gevallen.
- Ontbreken van afhankelijkheidssteun. Grote projecten zijn afhankelijk van een groot aantal bibliotheken en frameworks die de mogelijkheden van de programmeertaal uitbreiden. Als de scanner geen informatie heeft in zijn kennisbasis over gevaarlijke plaatsen (‘sinks’) in deze frameworks, wordt dit een blinde vlek, en begrijpt de scanner de code gewoon niet.
- Scanlengte. Zoeken naar kwetsbaarheden in code is een complexe taak, ook in termen van algoritmen. Daarom kan het proces zeker lang duren en aanzienlijke rekenkracht vereisen.
- Lage dekking. Ondanks het verbruik van middelen en de duur van de scans, zijn ontwikkelaars van SAST-tools nog steeds genoodzaakt compromissen te sluiten en analyseren ze niet alle toestanden waarin een programma zich kan bevinden.
- Hergebruikbaarheid van bevindingen. Een aanwijzing op de specifieke regel en de oproepstapel die tot de kwetsbaarheid leidt is prima, maar vaak geeft de scanner niet genoeg informatie om de aanwezigheid van de kwetsbaarheid van buitenaf te verifiëren. Immers, de tekortkoming kan ook in dode code zitten, die niet toegankelijk is voor de aanvaller.
Problemen met het scannen van infrastructuur.
- Onvoldoende inventarisatie. In grote infrastructuren, vooral die geografisch gescheiden zijn, is het vaak het moeilijkst om te begrijpen welke hosts moeten worden gescand. Met andere woorden, de scan-taak is nauw verbonden met de taak van asset management.
- Slechte prioritering. Netwerkscanners geven vaak veel resultaten met tekortkomingen die in de praktijk niet exploiteerbaar zijn, maar formeel is hun risiconiveau hoog. De consument ontvangt een rapport dat moeilijk te interpreteren is, en het is onduidelijk wat er als eerste moet worden gecorrigeerd.
- Schamele aanbevelingen. In de kennisbasis van de scanner staat vaak slechts heel algemene informatie over kwetsbaarheden en manieren om deze op te lossen, dus beheerders moeten zich bewapenen met Google. De situatie is iets beter met whitebox-scanners, die specifieke commando's kunnen geven voor correctie.
- Handmatig werk. In infrastructuren kunnen veel knooppunten zijn, en dus potentieel veel tekortkomingen, waarvoor de rapporten handmatig moeten worden onderzocht en geanalyseerd bij elke iteratie.
- Slechte dekking. De kwaliteit van het scannen van de infrastructuur hangt rechtstreeks af van de omvang van de kennisbasis over kwetsbaarheden en versies van de software. Daarbij, , zelfs de marktleiders hebben geen allesomvattende kennisbasis, en in de databases van gratis oplossingen is er veel informatie die de leiders niet hebben.
- Problemen met patching. Meestal is patching van kwetsbaarheden in de infrastructuur het bijwerken van een pakket of het wijzigen van een configuratiebestand. Een groot probleem hierbij is dat het systeem, vooral legacy-systemen, onvoorspelbaar gedrag kan vertonen als gevolg van updates. In wezen zal het noodzakelijk zijn om integratietests uit te voeren op de live-infrastructuur in productie.
Aanpakken
Wat te doen?
Meer over voorbeelden en hoe om te gaan met veel van de genoemde problemen zal ik bespreken in de volgende delen, maar voor nu zal ik de belangrijkste richtingen aanwijzen waarin gewerkt kan worden:
- Aggregatie van verschillende scaninstrumenten. Bij correct gebruik van meerdere scanners kan een aanzienlijke toename in de kennisbasis en scankwaliteit worden bereikt. Er kunnen zelfs meer kwetsbaarheden worden gevonden dan de som van alle scanners die afzonderlijk zijn uitgevoerd, terwijl de risicobeoordeling nauwkeuriger kan worden en er meer aanbevelingen kunnen worden gegeven.
- Integratie van SAST en DAST. De dekking van DAST en de nauwkeurigheid van SAST kunnen worden vergroot door informatie-uitwisseling tussen hen. Uit de broncode kan informatie over bestaande routes worden verkregen, en met DAST kan worden gecontroleerd of kwetsbaarheden van buitenaf zichtbaar zijn.
- Machine Learning™. In 2015 heb ik (en ) over het toepassen van statistiek om scanners een hackersintuïtie te geven en hen te versnellen. Dit is zeker voedsel voor de ontwikkeling van automatische beveiligingsanalyse in de toekomst.
- Integratie van IAST met autotests en OpenAPI. Binnen de CI/CD-pipeline is het mogelijk om een scanproces op te zetten met behulp van tools die als HTTP-proxy werken, evenals functionele tests die over HTTP lopen. Tests en OpenAPI/Swagger-contracten geven de scanner de ontbrekende informatie over datastromen, zodat de applicatie in verschillende toestanden kan worden gescand.
- Juiste configuratie. Voor elke applicatie en infrastructuur moet een geschikt scanprofiel worden gemaakt, rekening houdend met het aantal en de aard van de interfaces en de gebruikte technologieën.
- Personalisatie van scanners. Vaak kan een applicatie niet gescand worden zonder de scanner aan te passen. Een voorbeeld is een betalingsgateway waarbij elk verzoek ondertekend moet worden. Zonder het schrijven van een connector voor het gatewayprotocol zullen scanners ondoordacht verzoeken doen met een onjuiste handtekening. Daarnaast is het ook nodig om gespecialiseerde scanners te schrijven voor specifieke soorten kwetsbaarheden, zoals
- Risico-management. Het gebruik van verschillende scanners en integratie met externe systemen zoals Asset Management en Threat Management maakt het mogelijk om diverse parameters te gebruiken voor risicobeoordeling, zodat het management een duidelijk beeld krijgt van de huidige staat van de beveiliging van de ontwikkeling of infrastructuur.
Blijf op de hoogte en laten we de kwetsbaarheidsscans verstoren!
Bron: habr.com
