

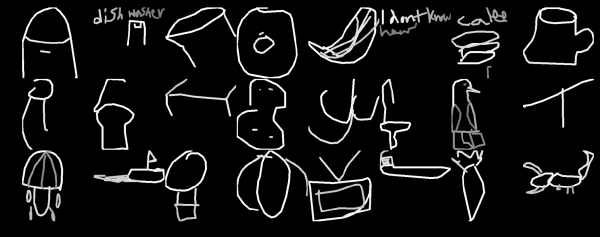
Hei, Habr!
Høsten i fjor ble det holdt en konkurranse på Kaggle om klassifisering av håndtegnede bilder kalt Quick Draw Doodle Recognition, der et lag av R-eksperter deltok, bestående av , og . Vi skal ikke gå i detalj om konkurransen, det er allerede gjort i .
Det gikk ikke så bra med medaljene denne gangen, men vi fikk mye verdifull erfaring, så vi ønsker å dele noen av de mest interessante og nyttige temaene fra Kaggle og vårt daglige arbeid med fellesskapet. Blant emnene vi har sett på: det tøffe livet uten OpenCV, parsing av JSON-er (i disse eksemplene vurderes integrering av C++-kode i skript eller pakker på R ved hjelp av Rcpp), parametrisering av skript og dockerisering av den endelige løsningen. All koden fra meldingen er tilgjengelig i kjørbar form i .
Innhold:
1. Effektiv datainnhenting fra CSV til MonetDB-database
Dataene i denne konkurransen blir ikke levert som ferdige bilder, men som 340 CSV-filer (en for hver klasse), som inneholder JSON-er med koordinater for punktene. Ved å forbinde disse punktene med linjer, får vi det endelige bildet som er 256x256 piksler. For hver post gis det også en etikett om bildet ble korrekt gjenkjent av klassifiseren som var i bruk på tidspunktet for innsamlingen av datasettet, en to-bokstavers landkode for hvor forfatteren av tegningen bor, en unik identifikator, tidsstempel og klassebetegnelsen som samsvarer med filnavnet. Den forenklede versjonen av de opprinnelige dataene veier 7,4 GB i arkiv og omtrent 20 GB etter udpakkingen, mens de fullstendige dataene etter udpakkingen opptar 240 GB. Arrangørene garanterte at begge versjoner gjengir de samme tegningene, altså er fullversjonen overflødig. I alle fall ble det tidlig ansett som urentabelt å lagre 50 millioner bilder i grafiske filer eller i form av matriser, og vi bestemte oss for å samle alle CSV-filene fra arkivet train_simplified.zip i databasen med påfølgende generering av bilder i ønsket størrelse «on the fly» for hver batch.
Valget av database ble en godt bevist MonetDB, nemlig implementering for R i form av en pakke . Pakken inkluderer en innebygd versjon av database-serveren og gjør det mulig å starte serveren direkte fra R-sesjonen og arbeide med den der. Oppretting av database og tilkobling til den gjøres med én kommando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Vi må opprette to tabeller: én for alle data og en annen for informasjonsdata om de opplastede filene (nyttig hvis noe går galt og prosessen må gjenopptas etter flere filopplastinger):
Oppretting av tabeller
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Den raskeste måten å laste opp data til databasen var direkte kopiering av CSV-filer ved hjelp av SQL — kommandoen COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',', 'n', '"' NULL AS '' BEST EFFORT, hvor tabellnavn — navnet på tabellen og path — banen til filen. Under arbeidet med arkivet ble det oppdaget at den innebygde implementeringen unzip i R fungerer feil med flere filer fra arkivet, derfor brukte vi systemversjonen unzip (ved hjelp av parameteren getOption("unzip")).
Funksjon for å skrive til databasen
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Hvis det er behov for å transformere tabellen før den skrives til databasen, er det tilstrekkelig å sende inn argumentet forbehandling en funksjon som vil transformere dataene.
Koden for sekvensiell lasting av data til databasen:
Skriving av data til databasen
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Tiden det tar å laste opp data kan variere avhengig av hastighetskarakteristikkene til det brukte lagringsmediet. I vårt tilfelle tar lesing og skriving innen ett SSD eller fra en minnepinne (kildefilen) til SSD (databasen) mindre enn 10 minutter.
Flere sekunder kreves for å lage en kolonne med heltalls klasseetikett og en indekskolonne (ORDERED INDEX) med rekkefølgenummer, som vil brukes til å hente observasjoner ved opprettelse av batcher:
Oppretting av tilleggskolonner og indeks
message("Generere etiketter")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generere radnumre")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
For the task of forming a batch "on the fly," we needed to achieve maximum speed for extracting random rows from the table. doodles. To achieve this, we employed three tricks. The first was to reduce the dimensionality of the type used to store observation IDs. In the original dataset, the type required for storing IDs is bigint, but the number of observations allows us to fit their identifiers, which correspond to their ordinal numbers, into the type int. This significantly speeds up the search. The second trick was the use of ORDERED INDEX — this solution was derived empirically by evaluating all available . The third involved using parameterized queries. The essence of the method is to execute the command PREPARE once and subsequently use the prepared statement to create batches of similar queries, but the actual gain compared to a simple SELECT turned out to be in the range of statistical error.
The data upload process consumes no more than 450 MB of RAM. This means that the described approach allows handling datasets weighing dozens of gigabytes on virtually any budget hardware, including some single-board computers, which is quite impressive.
We need to measure the speed of extraction (random) data and evaluate scaling when selecting batches of various sizes:
Database benchmark
library(ggplot2)

set.seed(0)
# Kobla til databasen
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funksjon for å forberede spørring på serveren
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funksjon for å hente data
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Utføre målinger
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Benchmark-parametere
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("median tid, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 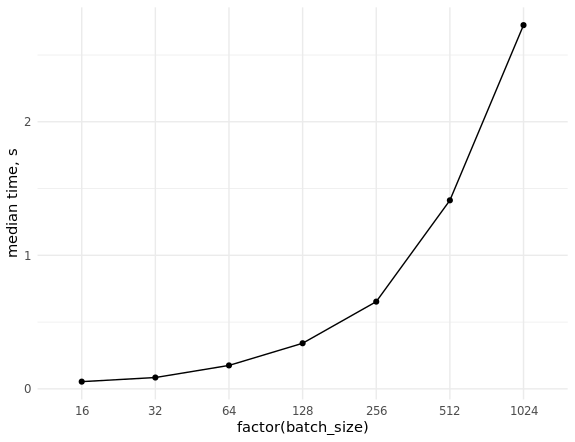
2. Forberedelse av batcher
Hele prosessen med å forberede batcher består av følgende trinn:
- Parser flere JSON-er som inneholder vektorer av strenger med koordinater for punktene.
- Tegne fargede linjer basert på punktkoordinatene på et bilde av ønsket størrelse (for eksempel 256×256 eller 128×128).
- Konvertere de hentede bildene til en tensor.
I forbindelse med konkurransen blant kernel-er på Python ble oppgaven hovedsakelig løst med hjelp av OpenCV. En av de enkleste og mest åpenbare tilsvarende løsningene på R vil se slik ut:
Implementering av konvertering fra JSON til tensor i R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsing JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Deleting temporary file after function completion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Empty plot
  plot.new()
  # Plot window size
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Line colors
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Converting image to 3D array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Combining 3D image arrays into a 4D tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Drawing is performed using standard R tools, saving it to a temporary PNG file stored in RAM (in Linux, R's temporary directories are located in a directory /tmp, mounted in RAM). This file is then read as a three-dimensional array with numbers in the range from 0 to 1. This is important, as a more common BMP would be read into a raw array with hex color codes.
Let's test the result:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 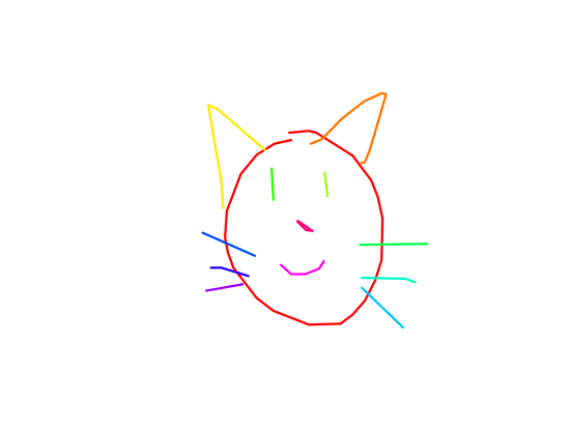
The batch will be formed as follows:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
This implementation seemed suboptimal to us, as forming large batches takes an inordinate amount of time, and we decided to leverage the experience of our colleagues by utilizing a powerful library OpenCV. At that time, there was no ready-made package for R (and there still isn't), so a minimal implementation of the required functionality was written in C++ and integrated into the R code using Rcpp.
The following packages and libraries were used to solve the problem:
OpenCV for working with images and drawing lines. We used pre-installed system libraries and header files, as well as dynamic linking.
xtensor for working with multidimensional arrays and tensors. We used header files included in the corresponding R package. The library allows working with multidimensional arrays both in row-major and column-major order.
ndjson for parsing JSON. This library is used in xtensor automatically when present in the project.
RcppThread for organizing multithreaded processing of vectors from JSON files. We used the header files provided by this package. Compared to the more popular RcppParallel package, among other things, features a built-in mechanism for interrupting loops.
Det er verdt å merke seg at xtensor turned out to be an absolute find: besides having a wide range of functionality and high performance, its developers were quite responsive, promptly and thoroughly answering all emerging questions. With their help, we managed to implement transformations of OpenCV matrices into xtensor tensors, as well as a way to combine 3D tensors of images into a 4D tensor of the correct dimensions (i.e., a batch).
Materials for studying Rcpp, xtensor, and RcppThread
To compile files that use system files and dynamic linking with libraries installed on the system, we used the plugin mechanism implemented in the package Rcpp. For automatically finding paths and flags, we utilized the popular Linux utility pkg-config.
Implementation of an Rcpp plugin to use the OpenCV library
Rcpp::registerPlugin("opencv", function() {
  # Possible package names
  pkg_config_name <- c("opencv", "opencv4")
  # Binary utility pkg-config file
  pkg_config_bin <- Sys.which("pkg-config")
  # Checking presence of the utility in the system
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Checking for the OpenCV configuration file for pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
As a result of the plugin's operation during compilation, the following values will be substituted:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Koden for implementering av JSON-parsing og batchgenerering for sending til modellen er gitt under spoileren. Først legger vi til den lokale prosjektkatalogen for å finne header-filer (behov for ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementering av konvertering fra JSON til tensor i C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Denne koden skal plasseres i filen src/cv_xt.cpp og kompileres med kommandoen Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); det vil også være nødvendig nlohmann/json.hpp fra . Koden er delt opp i flere funksjoner:
to_xt— en templatisert funksjon for å konvertere et bildematrise (cv::Mat) til tensorxt::xtensor;parse_json— funksjonen parser JSON-strengen, henter koordinatene til punktene og pakker dem i en vektor;ocv_draw_lines— fra den resulterende vektoren av punkter tegner fargerike linjer;process— kombinerer de ovennevnte funksjonene og tilføyer muligheten for skalering av det resulterende bildet;cpp_process_json_str— en wrapper over funksjonenprocess, som eksporterer resultatet til et R-objekt (flerdimensjonalt array);cpp_process_json_vector— en wrapper over funksjonencpp_process_json_str, som lar behandle en strengvektor i flertrådet modus.
For å tegne fargerike linjer ble det benyttet en HSV-fargemodell med påfølgende konvertering til RGB. La oss teste resultatet:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 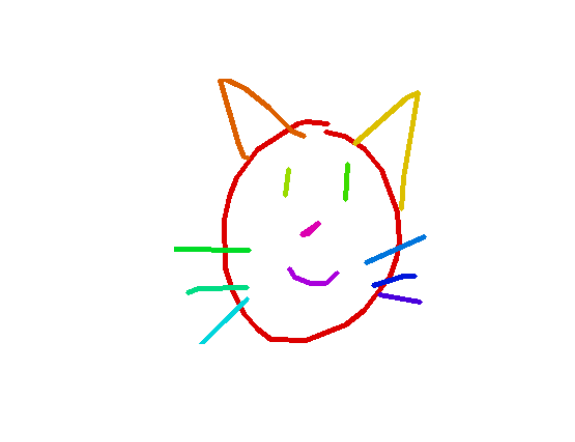
Sammenligning av hastigheten av implementeringene i R og C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Бенчмарк параметры
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   выражение                мин     медиана       макс `itr/sec` общее_время  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Проведение замера
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    выражение   batch_size      мин   медиана      макс `itr/sec` общее_время n_itr
#                  <bch:tm> <bch:tm> <bch:tm>         <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("медианное время, с") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 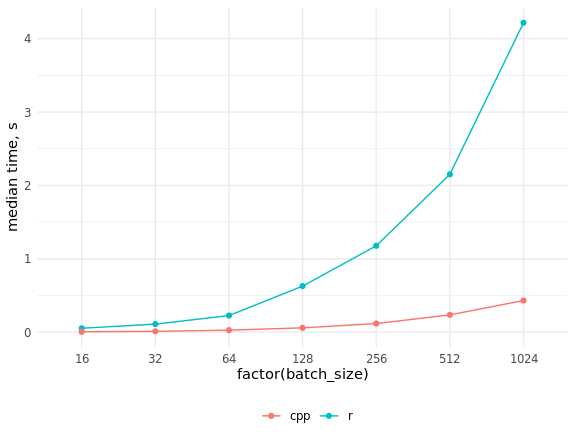
Как видно, прирост скорости оказался весьма значительным, и достичь уровня кода на C++ с помощью параллелизации кода на R не представляется возможным.
3. Итераторы для выгрузки батчей из базы данных
R har en velbegrunnet rykte som et språk for databehandling som får plass i RAM, mens Python er kjent for sin iterative databehandling, som enkelt og uanstrengt muliggjør ut-av-kjerne beregninger (beregninger som bruker ekstern minne). Et klassisk og aktuelt eksempel på slike beregninger, relevant for oss i denne konteksten, er dype nevrale nettverk som trenes med gradientnedstigning ved å tilnærme gradienten på hvert steg ved hjelp av en liten mengde observasjoner, eller minibatch.
Rammeverk for dyp læring skrevet i Python har spesielle klasser som implementerer iteratorer for data: tabeller, bilder i mapper, binære formater osv. Man kan bruke ferdige løsninger eller skrive sine egne for spesifikke oppgaver. I R kan vi dra nytte av alle mulighetene til Python-biblioteket keras med sine ulike backend-løsninger ved hjelp av det samme navnet pakken, som igjen fungerer over pakken reticulate.Den sistnevnte fortjener en egen stor artikkel; den lar oss ikke bare kjøre kode i Python fra R, men også overføre objekter mellom R- og Python-øktene, og utfører automatisk alle nødvendige typekonversjoner.
Vi har kvittet oss med behovet for å lagre all data i RAM ved å bruke MonetDBLite, alt "nevrale nettverksarbeid" vil bli utført av originalkoden i Python, vi må bare skrive en iterator for data, ettersom det ikke finnes noen ferdige løsninger for en slik situasjon verken i R eller Python. Kravene til den er i prinsippet bare to: den må returnere batcher i en uendelig løkke og lagre sin tilstand mellom iterasjoner (det siste kan enkelt realiseres i R ved hjelp av lukkede funksjoner). Tidligere var det nødvendig å eksplisitt konvertere R-arrays til numpy-arrays inne i iteratoren, men den aktuelle versjonen av pakken keras gjør det automatisk.
Iteratoren for trenings- og valideringsdataene ble som følger:
Iterator for trenings- og valideringsdata
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funksjonen tar inn en variabel med en tilkobling til databasen, nummeret på de brukte radene, antall klasser, batchstørrelse, skala (scale = 1 tilsvarer tegning av bilder 256x256 piksler, scale = 0.5 — 128x128 piksler), fargeindikator (color = FALSE definerer tegningen i gråtoner, ved bruk av farge = TRUE hver strøk tegnes med en ny farge) og en indikator for forhåndsprosessering for nettverk som er forhåndstrent på imagenet. Den siste er nødvendig for å skalere pikselverdiene fra intervallet [0, 1] til intervallet [-1, 1], som ble brukt under opplæring av sidene som følger med keras modeller.
Den eksterne funksjonen inneholder typekontroll av argumentene, en tabell data.table med tilfeldig blandede radnumre fra samples_index og batchnumre, en teller og maks antall batcher, samt et SQL-uttrykk for å eksportere data fra databasen. I tillegg har vi definert en rask analog av funksjonen keras::to_categorical(). Vi brukte nesten alle dataene for trening, og beholdt et halvt prosent for validering, så størrelsen på epoken ble begrenset av parameteren steps_per_epoch ved anropet keras::fit_generator(), og betingelsen if (i > max_i) ble aktivert bare for valideringsiteratoren.
I den indre funksjonen skjer det en utvalg av radindekser for den neste batchen, lasting av poster fra databasen med økning av batchtelleren, parsing av JSON-filer (funksjonen cpp_process_json_vector(), skrevet i C++) og opprettelse av matriser som tilsvarer bildene. Deretter opprettes one-hot vektorer med klasseetiketter, matriser med pikselverdier og etiketter kombineres i en liste, som er returverdien. For å øke hastigheten ble det brukt indeksering i tabeller data.table og modifikasjon ved referanse — uten disse «tricks» i pakken data.table er det ganske vanskelig å forestille seg effektiv behandling med betydelige datamengder i R.
Resultatene av hastighetsmålinger på en bærbar Core i5 ser slik ut:
Benchmark for iteratoren
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indekser for treningssett
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indekser for valideringssett
val_ind <- ind[-train_ind]
rm(ind)
# Skaleringsfaktor
scale <- 0.5

# Målestasjon
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Parametere for benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 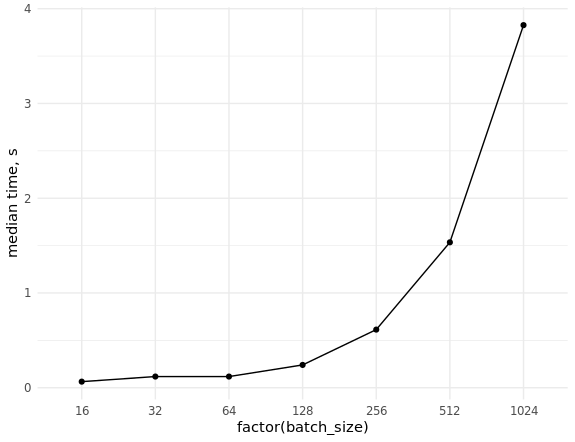
Hvis det er tilstrekkelig med RAM, kan man betydelig akselerere databasen ved å flytte den inn i RAM (32 GB er tilstrekkelig for vår oppgave). I Linux monteres som standard en del /dev/shm, som bruker opptil halvparten av RAM-volumet. Man kan også tildele mer ved å redigere /etc/fstab, slik at man får en oppføring som ser slik ut tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Husk å starte på nytt og sjekke resultatet ved hjelp av kommandoen df -h.
Iteratoren for testdata ser mye enklere ut, siden testdatasettet passer fullt ut i RAM:
Iterator for testdata
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Valg av modellarkitektur
Den første arkitekturen som ble brukt var , hvis egenskaper er diskutert i meldingen. Den er inkludert i standardpakken keras og er derfor tilgjengelig i den samme pakken for R. Men da man prøvde å bruke den med enfargede bilder, viste det seg å være merkelig: inngangstensoren må alltid ha dimensjonene (batch, høyde, bredde, 3), det vil si at antallet kanaler ikke kan endres. I Python finnes det ikke en slik begrensning, så vi skyndte oss å skrive vår egen implementering av denne arkitekturen, i samsvar med den originale artikkelen (uten dropout som finnes i Keras-varianten):
Mobilenet v1-arkitektur
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Ulempene med denne tilnærmingen er åpenbare. Man ønsker å teste mange modeller, men det er ikke ønskelig å skrive om hver arkitektur manuelt. Vi var også uten muligheten til å bruke vekt fra modeller som var forhåndstrent på ImageNet. Som vanlig hjalp det å studere dokumentasjonen. Funksjonen get_config() lar deg få en beskrivelse av modellen i et redigerbart format (base_model_conf$layers — en vanlig R-liste), og funksjonen from_config() utfører en omvendt konvertering til en modellobjekt:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Nå er det enkelt å skrive en universell funksjon for å hente hvilken som helst av modellene som leveres keras med vekter trent på imagenet eller uten dem:
Funksjon for å laste inn ferdige arkitekturer
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Sjekk argumentene
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Hent objektet fra keras-pakken
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Sjekk om objektet eksisterer i pakken
  if (is.null(model_fun)) {
    stop("Modellen ", shQuote(name), " ble ikke funnet.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Hvis bildet ikke er farge, endrer vi dimensjonen av inngangen
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Ved bruk av enkeltkanal bilder brukes ikke forhåndstrente vekter. Dette kunne vært løst: ved hjelp av funksjonen get_weights() å få modellens vekter som en liste av R-matriser, endre dimensjonen på det første elementet i listen (ved å ta en av fargekanalene eller gjennomsnittlig alle tre), og deretter laste vektene tilbake til modellen med funksjonen set_weights(). Vi la aldri til denne funksjonaliteten, fordi det allerede var klart på dette tidspunktet at det var mer produktivt å jobbe med fargebilder.
Vi utførte hoveddelen av eksperimentene ved bruk av mobilenet versjon 1 og 2, samt resnet34. I denne konkurransen presterte mer moderne arkitekturer, som SE-ResNeXt, godt. Dessverre var vi ikke i besittelse av klare implementeringer, og vi har ikke skrevet våre egne (men vi skal absolutt gjøre det).
5. Parametrisering av skriptene
For enkelhets skyld ble all koden for å starte trening utformet som et enkelt skript, parametrisert ved hjelp av på følgende måte:
doc <- '
Bruk:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [alternativer]

Alternativer:
  -h --help                   Vis denne meldingen.
  -l --list-models            Liste over tilgjengelige modeller.
  -m --model=          Navn på nevralt nettverksmodell [standard: mobilenet_v2].
  -b --batch-size=  Batches størrelse [standard: 32].
  -s --scale-factor=   Skaleringsfaktor [standard: 0.5].
  -c --color                  Bruk fargelinjer [standard: FALSE].
  -d --db-dir=          Sti til databasedirektør [standard: Sys.getenv("db_dir")].
  -r --validate-ratio= Valideringsprøveforhold [standard: 0.995].
  -n --n-gpu=         Antall GPU-er [standard: 1].
'
args <- docopt::docopt(doc)
Pakken docopt representerer en implementering for R. Med dette kan skriptene kjøres med enkle kommandoer som Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db eller ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, hvis filen train_nn.R er utførbar (denne kommandoen vil starte opplæring av modellen resnet50 på fargebilder av størrelsen 128x128 piksler, databasen må være i mappen /home/andrey/doodle_db). I listen kan læringsrate, type optimalisator og andre justerbare parametre legges til. Under forberedelse av publikasjonen fant vi ut at arkitekturen mobilenet_v2 i den nåværende versjonen keras i R er vanskelig å bruke på grunn av endringer som ikke er tatt i betraktning i R-pakken — vi venter på at de fikser det.
Denne tilnærmingen har betydelig akselerert eksperimentene med ulike modeller sammenlignet med mer tradisjonell kjøring av skriptene i RStudio (som et alternativ kan vi nevne pakken ). Men den største fordelen er muligheten til lett å administrere kjøringen av skriptene i Docker eller bare på serveren, uten å installere RStudio for det.
6. Dockerisering av skriptene
Vi brukte Docker for å sikre portabilitet av miljøet for modellopplæring mellom teammedlemmer og for rask distribusjon i skyen. Du kan begynne å bli kjent med dette relativt ukjente verktøyet for R-programmerere med en serie publikasjoner eller med .
Docker lar deg både lage egne bilder "fra bunnen av" og bruke andre bilder som grunnlag for å lage egne. Etter å ha analysert de tilgjengelige alternativene, kom vi til konklusjonen om at installasjonen av NVIDIA-drivere, CUDA+cuDNN og Python-biblioteker er en ganske omfattende del av bildet, derfor valgte vi å bruke det offisielle bildet som grunnlag. tensorflow/tensorflow:1.12.0-gpu, og la til nødvendige R-pakker.
Det endelige docker-filen ble slik:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
For enkelhets skyld ble de brukte pakkene lagt i variabler; hoveddelen av de skrevne skriptene kopieres inn i containerne under byggingen. Vi endret også kommandoskallet til /bin/bash for enklere bruk av innholdet /etc/os-release. Dette gjorde at vi unngikk å måtte spesifisere versjonen av OS i koden.
I tillegg ble et lite bash-skript skrevet for å tillate kjøring av containeren med forskjellige kommandoer. Dette kan være skripter for trening av nevronettverk, tidligere plassert inn i containeren, eller et kommandoskal for feilsøking og overvåking av containerens drift:
Skript for å starte containeren
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Hvis du kjører dette bash-skriptet uten parametere, vil et skript med standardverdier bli kalt inne i containeren; hvis det første posisjonsargumentet er "bash", vil containeren kjøre i interaktiv modus med kommandolinje. I alle andre tilfeller vil posisjonsargumentverdiene bli substituert: train_nn.R CMD="Rscript /app/train_nn.R $@" Det er verdt å nevne at katalogene med rådata og databasen, samt katalogen for lagring av trenede modeller, blir montert inn i containeren fra verts.systemet, noe som gjør at du får tilgang til resultatene av skripten uten unødvendige manipuleringer..
7. Bruk av flere GPU-er i Google Cloud
En av spesialitetene ved konkurransen var ganske støyende data (se headerbildet, lånt fra @Leigh.plt fra ODS-slack). Store batcher hjelper til med å bekjempe dette, og etter eksperimentene på en PC med 1 GPU bestemte vi oss for å lære hvordan man trener modeller på flere GPU-er i skyen. Vi brukte GoogleCloud (
et godt guide til grunnleggende arbeiddev/shm Den mest interessante delen av koden som håndterer bruken av flere GPU-er. Først opprettes modellen på CPU-en ved hjelp av en kontektsmanager, helt som i Python:.
with(tensorflow::tf$device("/cpu:0"), { model_cpu <- get_model( name = model_name, input_shape = input_shape, weights = weights, metrics =(top_3_categorical_accuracy, compile = FALSE ) })
Deretter kopieres den usammensatte (dette er viktig) modellen til det angitte antallet tilgjengelige GPU-er, og først etter det blir den kompilert:model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu) keras::compile( object = model, optimizer = keras::optimizer_adam(lr = 0.0004), loss = "categorical_crossentropy", metrics = c(top_3_categorical_accuracy) )
Den klassiske teknikken med å fryse alle lag bortsett fra det siste, lære opp det siste laget, deretter fryse opp og finjustere hele modellen for flere GPU-er, ble det ikke mulig å realisere.Vi fulgte treningen uten å bruke
tensorboard tensorboard, begrenset til å loggføre og lagre modeller med beskrivende navn etter hver epoke:
Callback-funksjoner
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. I stedet for konklusjon
En rekke problemer vi har støtt på har vi ikke klart å overvinne enda:
- i keras det finnes ingen innebygd funksjon for automatisk å finne optimal læringsrate (analog til
lr_finderi biblioteket fast.ai); med litt innsats kan man portere til R tredjepartsimplementeringer, for eksempel, ; - som en konsekvens av forrige punkt, har vi ikke klart å finne riktig læringsrate ved bruk av flere GPU-er;
- moderne nevrale nettverksarkitekturer mangler, spesielt de som er forhåndstrente på imagenet;
- det finnes ingen one cycle policy og diskriminerende læringsrater (cosine annealing på vår forespørsel ble , takk ).
Hva vi kunne lære av denne konkurransen:
- Selv med relativt lavkraftig maskinvare kan man jobbe smertefritt med betydelige (mye større enn minnet) datamengder. Pakken data.table sparer minne ved å bruke in-place modifikasjon av tabeller, noe som gjør at man unngår kopiering, og ved riktig bruk av dens muligheter viser den nesten alltid høyeste hastighet blant alle kjente verktøy for skriptspråk. Å lagre data i databaser gjør at man i mange tilfeller ikke engang trenger å tenke på å presse hele datasettet inn i minnet.
- Langsomme funksjoner i R kan erstattes med raske i C++ ved hjelp av pakken Rcpp. I tillegg, hvis man bruker RcppThread eller RcppParallel, får vi plattformuavhengige multitrådede implementeringer, så koden på R-nivå trenger ikke å parallelliseres.
- Pakken Rcpp kan brukes uten dype kunnskaper i C++, det nødvendige minimum er presentert . Hodefilene for en rekke kule C-biblioteker som xtensor er tilgjengelige på CRAN, så det dannes infrastruktur for å implementere prosjekter som integrerer klar, høyytelseskode i C++ i R. En ekstra fordel — syntaksutheving og statisk kodeanalysator for C++ i RStudio.
- docopt lar deg kjøre selvstendige skripter med parametere. Dette er praktisk for bruk på en ekstern server, inkludert under Docker. I RStudio er det upraktisk å gjennomføre langvarige eksperimenter med trening av nevrale nettverk, og selve installasjonen av IDE på serveren er ikke alltid berettiget.
- Docker gir ein kodeportabilitet og reproduksjon av resultat mellom utviklarar med ulike versjonar av OS og bibliotek, samt enkelheit i oppstart på serverar. Du kan starte heile pipelinen for trening med berre eitt kommando.
- Google Cloud er ein budsjettvennleg måte å eksperimentere med dyr maskinvare på, men det er viktig å velje konfigurasjonar med omhu.
- Det er veldig nyttig å måle utføringa til enkle kodebitar, særleg i kombinasjon med R og C++, og med pakken bench blir det også veldig enkelt.
Generelt har denne erfaringa vore veldig nyttig, og vi fortset til å jobbe med løysingane på nokre av dei nemnde problema.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish