

Noen selskaper, inkludert vår kunde, utvikler produkter gjennom et partnernettverk. For eksempel er store nettbutikker integrert med leveringsservice – du bestiller et produkt og får snart et sporingsnummer for pakken. Et annet eksempel er at du kjøper en forsikring eller billett til ekspresstoget sammen med flybilletten.
Dette gjøres ved hjelp av et API som må gis til partnerne via API Gateway. Denne oppgaven har vi løst. I denne artikkelen vil vi beskrive detaljene.
Gitt: et økosystem og et API-portal med et grensesnitt, hvor brukerne er registrert, får informasjon osv. Vi må lage en brukervennlig og pålitelig API Gateway. I prosessen måtte vi sikre
- registrering,
- kontroll av tilkoblinger til API,
- overvåking av hvordan brukerne bruker det endelige systemet,
- behandling av forretningsindikatorer.
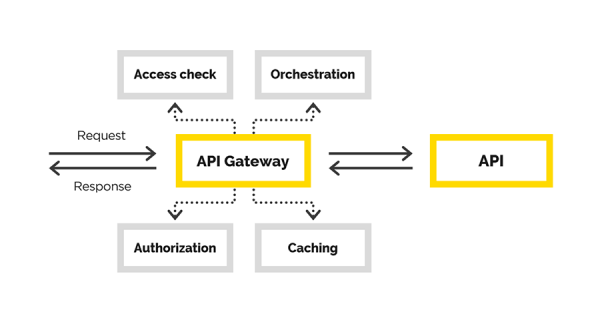
I artikkelen vil vi dele vår erfaring med å lage API Gateway, hvor vi løste følgende oppgaver:
- autentisering av brukeren,
- autorisering av brukeren,
- modifisering av den opprinnelige forespørselen,
- proxying av forespørselen,
- etterbehandling av svaret.
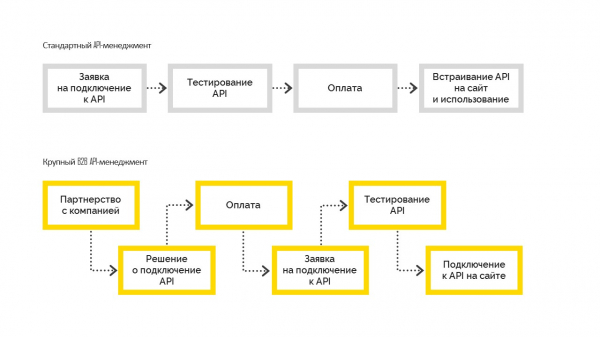
Det finnes to typer API-håndtering:
1. Standard, som fungerer på følgende måte. Før tilkoblingen tester brukeren mulighetene, deretter betaler han og integrerer på sin nettside. Dette brukes oftest av små og mellomstore bedrifter.
2. Stor B2B API Management, der selskapet først tar en forretningsbeslutning om tilkobling, blir partner med selskapskontrakt, før de kobles til API. Etter å ha ordnet alle formaliteter får selskapet testtilgang, gjennomgår testing og går i produksjon. Men dette er ikke mulig uten ledelsesvedtak om tilkobling.
Vår løsning
I denne delen vil vi fortelle om opprettelsen av API Gateway.
Sluttbrukerne av den opprettede API-gatewayen er partnere av vår kunde. For hver av dem har vi allerede lagret de nødvendige kontraktene. Vi må bare utvide funksjonaliteten ved å merke den gitte tilgangen til gatewayen. Dermed trengs en kontrollert prosess for tilkobling og forvaltning.
Selvfølgelig kunne vi valgt en allerede eksisterende løsning for API Management og opprettelse av API Gateway spesielt. For eksempel kunne dette vært. Dette passet oss ikke, fordi vi allerede hadde en API-portal og et stort økosystem bygget rundt den. Alle brukere var allerede registrert, de forsto allerede hvor og hvordan de kunne få den informasjonen de trengte. API-portalen hadde allerede de nødvendige grensesnittene, vi hadde bare behov for en API Gateway. Egentlig var det utviklingen av den vi begynte å fokusere på.
Det vi kaller API Gateway er en slags proxy. Her hadde vi igjen et valg – vi kunne skrive vår egen proxy, eller velge noe ferdig. I dette tilfellet valgte vi den andre veien og gikk for en kombinasjon av nginx+Lua. Hvorfor? Vi trengte pålitelig, testet programvare som støtter skalering. Vi ønsket ikke å sjekke både forretningslogikkens korrekthet og proxyens funksjonalitet etter implementasjonen.
Hver webserver har en behandlingspipeline for forespørselen. I tilfelle av nginx ser den slik ut:
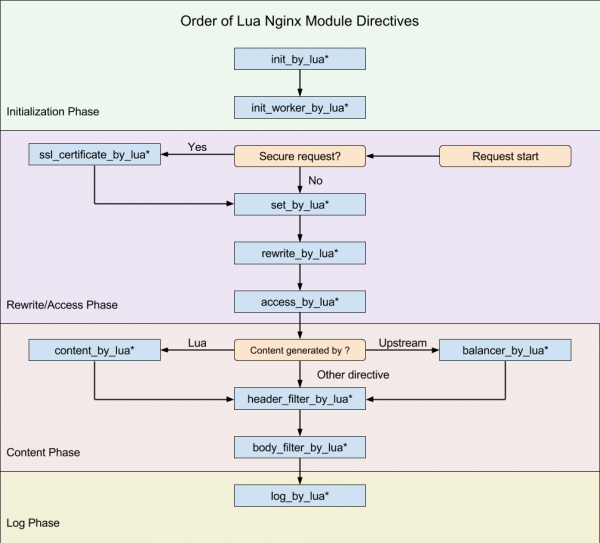
(skjema fra )
Målet vårt var å integrere oss i denne pipelinen på det punktet hvor vi kan modifisere den originale forespørselen.
Vi ønsker å lage en transparent proxy, slik at forespørselen forblir den samme som når den kom inn. Vi kontrollerer bare tilgangen til den endelige API-en, og hjelper forespørselen med å nå frem til den. Hvis forespørselen er feil, skal den endelige API-en vise feilen, ikke vi. Den eneste grunnen til at vi kan avvise en forespørsel er mangel på tilgang for klienten.
For nginx eksisterer det allerede En funksjon har blitt . Lua er et skriptspråk, det er svært lettvekts og enkelt å lære. Dermed implementerte vi den nødvendige logikken med hjelp av Lua.
Konfigurasjonen av nginx (analog med ruteapplikasjonen), der alt arbeidet utføres, er ganske forståelig. Den siste direktiven – post_action – er bemerkelsesverdig.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
La oss se hva som skjer i denne konfigurasjonen:
more_clear_input_headers – renser verdien angitt etter direktivet for overskrifter.
lua_need_request_body – regulerer om den originale forespørselens kropp skal leses før direktivene rewrite/access/access_by_lua utføres eller ikke. Som standard leser ikke nginx forespørselens kropp, og hvis du trenger tilgang til den, må denne direktiven settes til on.
rewrite_by_lua_file — sti for skrift, der beskriver logikken for å modifisere forespørselen
access_by_lua_file — sti for skriptet som inneholder logikken som sjekker om det er tilgang til ressursen.
proxy_pass — url-en som forespørselen vil bli proxyert til.
body_filter_by_lua_file — sti for skriptet som inneholder logikken for filtrering av forespørselen før den returneres til klienten.
Og til slutt, post_action — en offisielt udokumentert direktiv som kan brukes til å utføre flere handlinger etter at svaret er gitt til klienten.
Deretter skal vi forklare i rekkefølge hvordan vi løste våre oppgaver.
Autorisasjon/autentisering og modifisering av forespørselen
Autorisering
Vi bygde autorisasjonen og autentiseringen ved hjelp av tilgang basert på sertifikat. Det er et rotsertifikat. Hver ny kunde av kunden får sitt eget personlige sertifikat, som gir dem tilgang til API-en. Dette sertifikatet konfigureres i server-delen av nginx-innstillingene.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modifisering
Det kan stilles et rettferdig spørsmål: hva skal vi gjøre med sertifiserte kunder hvis vi plutselig ønsker å frakoble dem fra systemet? Skal vi ikke forny sertifikatene for alle de andre kundene?
Slik har vi smidig kommet til neste oppgave — modifisering av den opprinnelige forespørselen. Den opprinnelige forespørselen fra kunden er ikke gyldig for det endelige systemet. En av oppgavene er å legge til manglende deler i forespørselen for å gjøre den gyldig. Poenget er at de manglende dataene er forskjellige for hver kunde. Vi vet at kunden kommer til oss med et sertifikat, fra hvilket vi kan ta et fingeravtrykk og hente de nødvendige kundedataene fra databasen.
Hvis det på et tidspunkt blir nødvendig å frakoble kunden fra vår tjeneste, vil dataene deres forsvinne fra databasen, og de vil ikke kunne gjøre noe.
Håndtering av kundedata
Vi måtte sikre høy tilgjengelighet av løsningen, spesielt for hvordan vi henter kundedataene. Utfordringen er at den primære kilden til disse dataene er en tredjepartstjeneste som ikke garanterer pålitelig og tilstrekkelig høy hastighet.
Derfor måtte vi sikre høy tilgjengelighet for kundedataene. Som verktøy valgte vi , som gir oss:
- raskap for data,
- mulighet til å organisere en klynge av flere noder med replikerte data på forskjellige noder.
Vi fulgte den enkleste strategien for datalevering til cache:
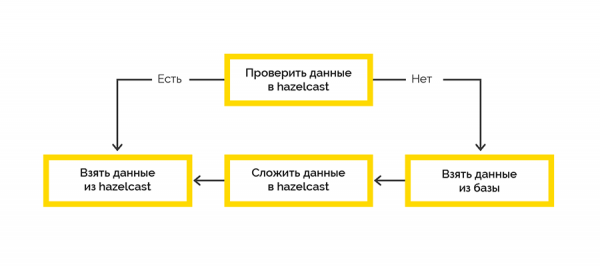
Samarbeid med det endelige systemet skjer innenfor sesjoner, og det er en grense for det maksimale antallet. Hvis kunden ikke har lukket sesjonen, må vi gjøre det.
Data om åpne sesjoner kommer fra det endelige systemet og behandles først på Lua-siden. Vi bestemte oss for å bruke Hazelcast for å lagre disse dataene med en jobb skrevet i .NET. Deretter sjekker vi regelmessig livsretten til åpne sesjoner og stenger utgåtte.
Tilgang til Hazelcast både fra Lua og .NET
Det finnes ingen Lua-klienter for å jobbe med Hazelcast, men Hazelcast har et REST API, som vi valgte å bruke. For .NET er det , som vi planla å bruke for å få tilgang til dataene fra Hazelcast på .NET-siden. Men slik gikk det ikke.
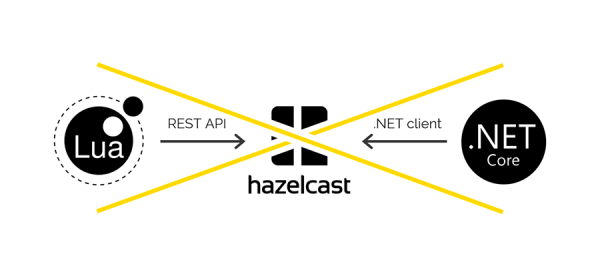
Ved lagring av data gjennom REST og uthenting via .NET-klienten brukes forskjellige serializator-deserializatorer. Derfor er det umulig å legge inn data via REST og hente dem ut via .NET-klienten og omvendt.
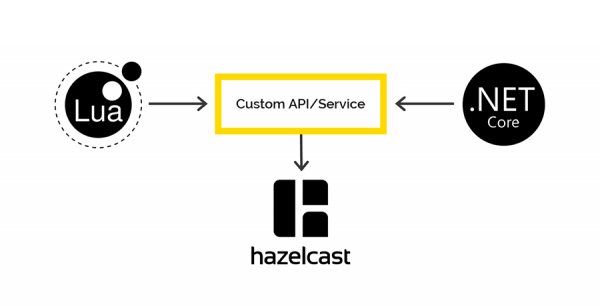
Hvis det er interesserte, kan vi fortelle mer om dette problemet i en egen artikkel. Spoiler — på diagrammet.
Logging og overvåking
Vår bedriftsstandard for logging via .NET — Serilog, alle logger havner til slutt i Elasticsearch, og analysen foregår via Kibana. Noe lignende ønsket vi å gjøre i dette tilfellet. Den eneste som ble funnet for å jobbe med Elastic på Lua, krasjet ved første require. Og vi brukte Fluentd.
— en open source-løsning for å gi et samlet lag av applikasjonslogging. Den lar oss samle logger fra ulike nivåer av applikasjonen, og deretter videresende dem til en enhetlig kilde.
API Gateway kjører i K8S, så vi bestemte oss for å legge til en container med fluentd i samme pod, for å skrive logger til den eksisterende åpne tcp-porten til fluentd.
Vi undersøkte også hvordan fluentd ville oppføre seg hvis den ikke hadde forbindelse med Elasticsearch. I løpet av to dager ble det kontinuerlig sendt forespørsel til gatewayen, logger ble sendt til fluentd, men IP-adressen til Elastic ble blokkert. Etter at forbindelsen ble gjenopprettet, slapp fluentd ut absolutt alle logger til Elastic.
Konklusjon
Den valgte tilnærmingen for implementering gjorde at vi klarte å levere et fullt fungerende produkt i produksjonsmiljøet på bare 2,5 måneder.
Hvis du noen gang må håndtere lignende ting, anbefaler vi først og fremst å tydelig forstå hvilken oppgave du løser og hvilke ressurser du allerede har. Vær oppmerksom på utfordringene med integrering med eksisterende API-styringssystemer.
Skjønn for deg selv hva nøyaktig du planlegger å utvikle — bare forretningslogikken for å behandle forespørslene eller, som det kan ha vært i vårt tilfelle, hele proxyen. Ikke glem at alt du gjør selv, må testes grundig etterpå.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish